Normalization 1NF→3NF — refactor TaskFlow tags thành junction table
1NF atomic value, 2NF no partial dependency, 3NF no transitive dependency. Codd 1970-1972. Pitfall over-normalize. TaskFlow refactor demo step-by-step — agnostic.
TL;DR: Normalization là quy trình tách bảng để loại bỏ dư thừa và anomaly. 1NF: mỗi cell một giá trị scalar (không list/array). 2NF: mọi non-key column phụ thuộc toàn bộ composite PK (không partial). 3NF: không transitive dependency (PK → A → B). Codd 1970-1972 chứng minh các dạng chuẩn này loại 4 anomaly: insertion, update, deletion, redundancy. Nhưng over-normalize (tách quan hệ 1:1 always-together) sinh JOIN overhead vô ích — chỉ tách khi có lợi ích thực (M:N, reuse, tách concern). Nguyên lý agnostic, đúng ở mọi RDBMS.
TaskFlow ban đầu lưu tags trong column tags kiểu chuỗi: tags = 'urgent,bug,api'. Khi cần filter "task có tag urgent", query tự nhiên nhất là:
SELECT * FROM tasks WHERE tags LIKE '%urgent%';
Hai vấn đề ngay lập tức: thứ nhất, query này scan toàn bảng — không dùng được index trên string LIKE với leading wildcard. Thứ hai, '%urgent%' match cả 'urgentcare', 'urgently' — false positive. Sau 6 tháng, product yêu cầu thêm "top 10 tag phổ biến nhất tuần này" — bạn phải parse chuỗi từng row trong application code.
Đây là vi phạm 1NF — Codd 1970 đã cảnh báo điều này. Bài này map 1NF→3NF với lý do cơ chế, refactor TaskFlow tags step-by-step, và 1 pitfall over-normalize quan trọng không kém.
1. Analogy — Sắp tủ hồ sơ
Hình dung bạn quản lý một tủ hồ sơ nhân viên:
- Trước normalize: mỗi ngăn chứa nhiều loại giấy tờ nhét lẫn lộn — hợp đồng, bằng cấp, lịch nghỉ phép, thông tin phòng ban — tất cả trong 1 folder. Tìm "ai có bằng thạc sĩ" phải mở từng ngăn, lật từng tờ.
- Sau 1NF: mỗi ngăn chứa đúng 1 loại tài liệu. Mỗi "slot" trong ngăn là 1 thông tin cụ thể, không phải danh sách nhét chung.
- Sau 2NF: mỗi ngăn phụ thuộc đúng cái mã ngăn của nó — không có tờ giấy "tên phòng ban" nằm trong ngăn nhân viên chỉ vì nhân viên đó thuộc phòng ban đó.
- Sau 3NF: không có chuỗi A → B → C dư thừa — "nhân viên → mã phòng ban → tên phòng ban" không lặp tên phòng ban ở mọi row nhân viên.
| Tủ hồ sơ | Database concept |
|---|---|
| 1 ngăn, 1 loại tài liệu | 1 cell, 1 giá trị scalar (1NF) |
| Mỗi tờ phụ thuộc đúng mã ngăn | Non-key column phụ thuộc toàn bộ PK (2NF) |
| Không chuỗi A→B→C nhồi nhét | Không transitive dependency qua non-key (3NF) |
| Tủ quá nhỏ, chia phòng riêng cho từng tờ | Over-normalize — overhead JOIN không cần thiết |
1NF: mỗi ô một thứ. 2NF: mỗi thứ phụ thuộc đúng khoá. 3NF: không có trung gian dư thừa giữa khoá và giá trị.
"Dư thừa" nghe trừu tượng, nên bắt đầu từ cái giá cụ thể. Một ô chứa ba giá trị làm ba câu hỏi bình thường về tag trở nên hoặc sai, hoặc phải đi đường vòng:
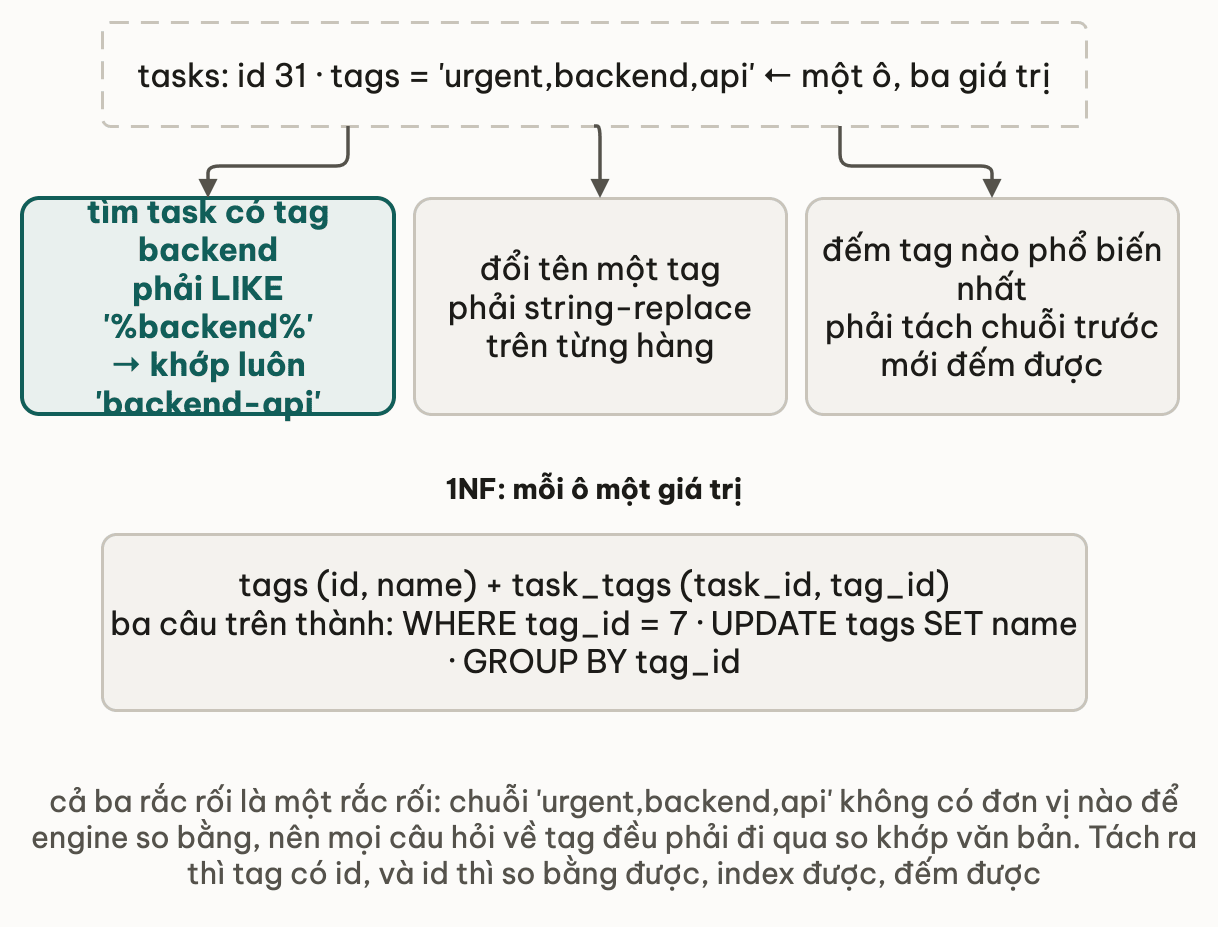
2. 1NF — atomic value
Định nghĩa: mỗi cell chứa 1 giá trị scalar — không phải list, array, hay struct nhét chung trong một column.
Vi phạm kinh điển — TaskFlow tags lưu dưới dạng chuỗi:
-- ANTI-PATTERN: 1NF violation
CREATE TABLE tasks (
  id    BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  title VARCHAR(500) NOT NULL,
  tags  VARCHAR(500)  -- 'urgent,bug,api' - LIST trong 1 cell
);

-- Hau qua 1: Filter slow + false positive
SELECT * FROM tasks WHERE tags LIKE '%urgent%';
-- Match ca 'urgentcare', 'urgently' -- false positive
-- LIKE voi leading wildcard khong dung duoc index -- seq scan

-- Hau qua 2: Update fragile
UPDATE tasks
SET tags = REPLACE(tags, 'urgent,', '')
WHERE tags LIKE '%urgent%';
-- Pattern khong xu ly duoc truong hop 'urgent' o dau, o cuoi, hoac la tag duy nhat

-- Hau qua 3: Aggregation bat kha thi trong SQL
-- "Top 10 tag pho bien nhat" -- phai parse string moi row trong app code
Fix 1NF — junction table:
-- 1NF: atomic value qua junction table
CREATE TABLE tags (
  id   BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name VARCHAR(50) UNIQUE NOT NULL
);

CREATE TABLE task_tags (
  task_id BIGINT NOT NULL REFERENCES tasks(id) ON DELETE CASCADE,
  tag_id  BIGINT NOT NULL REFERENCES tags(id)  ON DELETE CASCADE,
  PRIMARY KEY (task_id, tag_id)
);

-- Filter accurate + index-friendly
SELECT t.* FROM tasks t
JOIN task_tags tt ON t.id = tt.task_id
JOIN tags g       ON tt.tag_id = g.id
WHERE g.name = 'urgent';

-- Top 10 tag tuan nay -- trivial voi junction table
SELECT g.name, COUNT(*) AS task_count
FROM tags g
JOIN task_tags tt ON g.id = tt.tag_id
GROUP BY g.id, g.name
ORDER BY task_count DESC
LIMIT 10;
Trade-off: 1 query với JOIN thay 1 query LIKE. Performance: index trên junction và tags.name → nhanh hơn seq scan với LIKE. Semantics rõ hơn — tag là entity, không phải fragment trong chuỗi.
Note dialect — ARRAY column: một số engine hỗ trợ kiểu array kèm loại index cho phép tìm phần tử trong mảng hiệu quả. Về mặt lý thuyết đây vẫn vi phạm 1NF, nhưng nó có thể là viable choice ở vài trường hợp cụ thể (tags chỉ là label đơn giản, không bao giờ query độc lập). Khả năng này và cú pháp là dialect — tra tài liệu engine. Mặc định portable: normalize về junction table.
Thử ngẫmsau khi tách tags ra junction table, query đếm task theo tag nhanh hơn hẳn nhưng insert một task mới giờ cần thêm bước nào so với trước?
3. 2NF — no partial dependency on composite key
Pre-condition: 1NF đã đạt + table có composite primary key (PK gồm 2 column trở lên).
Định nghĩa: mọi non-key column phải phụ thuộc toàn bộ composite PK — không được phụ thuộc chỉ một phần (partial dependency).
Anti-pattern — order_items nhét thông tin product:
-- 2NF violation: PK la (order_id, product_id)
CREATE TABLE order_items (
  order_id     BIGINT,
  product_id   BIGINT,
  quantity     INT,
  product_name VARCHAR(200),    -- phu thuoc CHI product_id, khong phu thuoc order_id
  product_price DECIMAL(12,2),  -- phu thuoc CHI product_id
  PRIMARY KEY (order_id, product_id)
);

-- Hau qua:
-- 1. Update product_name -> phai update MOI row order_items co product nay
-- 2. Inconsistent: hai order khac nhau co the co product_name khac nhau (typo)
-- 3. Khong the insert product moi neu chua co order nao
Fix 2NF — tách products ra table riêng:
CREATE TABLE products (
  id    BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name  VARCHAR(200) NOT NULL,
  price DECIMAL(12,2) NOT NULL
);

CREATE TABLE order_items (
  order_id   BIGINT  REFERENCES orders(id),
  product_id BIGINT  REFERENCES products(id),
  quantity   INTEGER NOT NULL,
  PRIMARY KEY (order_id, product_id)
  -- product_name va product_price da o bang products
  -- moi column o day phu thuoc CA HAI order_id va product_id
);
Lưu ý production: trong e-commerce thực tế, order_items thường giữ thêm price_at_order DECIMAL(12,2) để snapshot giá lúc mua — vì giá có thể thay đổi sau này. Đây là denormalize có chủ đích, không phải vi phạm 2NF — Bài 04 — Denormalization tradeoff giải thích khi nào denormalize hợp lý.
4. 3NF — no transitive dependency
Pre-condition: 1NF + 2NF đã đạt.
Định nghĩa: non-key column không phụ thuộc gián tiếp qua một non-key column khác. Nếu có chain PK → A → B, thì B phải tách ra table riêng.
Anti-pattern — employees nhét thông tin department:
-- 3NF violation
CREATE TABLE employees (
  id                BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name              VARCHAR(200),
  department_id     BIGINT,
  department_name   VARCHAR(100),  -- phu thuoc department_id, khong phu thuoc id (transitive!)
  department_budget DECIMAL(15,2)  -- phu thuoc department_id
);

-- Chain: id -> department_id -> department_name
-- Hau qua:
-- 1. Doi ten department -> phai update MOI employee cua department do
-- 2. Xoa employee cuoi cung cua department -> mat thong tin department
-- 3. Them department moi -> phai co it nhat 1 employee (insertion anomaly)
Fix 3NF — tách departments ra table riêng:
CREATE TABLE departments (
  id     BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name   VARCHAR(100) NOT NULL,
  budget DECIMAL(15,2)
);

CREATE TABLE employees (
  id            BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name          VARCHAR(200) NOT NULL,
  department_id BIGINT REFERENCES departments(id)
  -- department_name va department_budget da o bang departments
);

-- Query join nhu binh thuong
SELECT e.name, d.name AS dept_name, d.budget
FROM employees e
JOIN departments d ON e.department_id = d.id;
Thử ngẫmnếu employees vẫn giữ cả department_id lẫn department_name, một báo cáo headcount chạy sai ở đâu khi tên phòng ban vừa đổi mà chỉ một vài row được update?
5. BCNF — một dòng
Boyce-Codd Normal Form là phiên bản strict hơn của 3NF: mọi functional dependency phải có vế trái là superkey. Vi phạm chỉ xảy ra khi table có overlapping candidate keys — rất hiếm trong schema thực tế. 99% trường hợp 3NF là đủ. BCNF tồn tại và có tên để bạn biết khi đọc tài liệu, không phải mục tiêu thường ngày.
6. 4 anomaly khi không normalize
| # | Anomaly | Mô tả | Ví dụ TaskFlow |
|---|---|---|---|
| 1 | Insertion | Không thể insert data mới nếu thiếu data liên quan | Không thể thêm product mới khi chưa có order nào |
| 2 | Update | Thay đổi 1 fact phải update nhiều row | Đổi tên department → update mọi employee row |
| 3 | Deletion | Xoá data này vô tình xoá luôn data khác | Xoá order cuối → mất thông tin product |
| 4 | Redundancy | Cùng 1 fact lặp lại ở nhiều row | Tên product lặp ở mọi order_item |
Mỗi anomaly là cost ẩn của denormalize ngẫu nhiên. Pattern cốt lõi: normalize đến 3NF → integrity tự nhiên, query cần JOIN thêm một chút nhưng đổi lại bảo đảm được toàn vẹn dữ liệu mà không cần trigger hay application logic bù đắp.
7. Pitfall — over-normalize
Normalize đến mức không cần thiết sinh ra JOIN overhead và schema phức tạp mà không cải thiện integrity. Quy tắc: chỉ tách khi có lợi ích thực sự — cardinality M:N, reuse, hoặc concern khác biệt rõ. Quan hệ 1:1 luôn đi cùng nhau thường nên giữ inline.
Ví dụ over-normalize — tách address thành bảng riêng cho users:
-- OVER-NORMALIZE: 1:1 relationship, address khong bao gio reuse
CREATE TABLE addresses (
  id      BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  street  VARCHAR(200),
  city    VARCHAR(100),
  country VARCHAR(100)
);

CREATE TABLE users (
  id         BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email      VARCHAR(254),
  address_id BIGINT REFERENCES addresses(id)  -- luon 1:1, khong co reuse
);

-- Hau qua:
-- 1. Moi query user phai JOIN addresses (overhead khong can thiet)
-- 2. Quan he 1:1, luon di cung nhau -> tach bang khong gain integrity
-- 3. Schema phuc tap hon can thiet -- onboarding kho hon
-- 4. DELETE user phai cleanup addresses rieng (hoac cascade)
-- BETTER: embed address inline khi 1:1 va always-together
CREATE TABLE users (
  id      BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email   VARCHAR(254),
  street  VARCHAR(200),
  city    VARCHAR(100),
  country VARCHAR(100)
);
Quy tắc thực chiến — chỉ tách bảng khi:
- Cardinality M:N hoặc 1:N có khả năng reuse: tags dùng chung cho nhiều task → junction table.
- Tách concern: dữ liệu nhạy cảm (payment info, PII) vào table riêng với permission khác.
- Query pattern khác biệt rõ: bảng hot (đọc nhiều) vs bảng cold (historical) → tách để tune index riêng.
Giữ inline khi quan hệ 1:1 và data luôn được đọc cùng nhau. Pattern này gọi là embedded value object trong DDD — không phải lười normalize, mà là normalize đúng mức.
Thử ngẫmusers và addresses ở đây là 1:1 always-together. Nếu mai này một user có thể có nhiều địa chỉ giao hàng, quyết định tách bảng ban đầu còn đúng không?
8. Applied — TaskFlow refactor tags chuỗi sang junction table
Migration step-by-step — không downtime, không mất data:
-- Step 1: tao bang tags + task_tags (CHUA drop column tags cu)
CREATE TABLE tags (
  id   BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name VARCHAR(50) UNIQUE NOT NULL
);

CREATE TABLE task_tags (
  task_id BIGINT NOT NULL REFERENCES tasks(id) ON DELETE CASCADE,
  tag_id  BIGINT NOT NULL REFERENCES tags(id)  ON DELETE CASCADE,
  PRIMARY KEY (task_id, tag_id)
);

-- Step 2: backfill du lieu tu cot tags chuoi
-- Tach chuoi 'urgent,bug' thanh nhieu row la viec phu thuoc engine:
--   moi engine co ham split/unnest rieng (dialect).
-- Portable nhat: doc tung row o app layer, split chuoi, INSERT lai.
-- Vi du minh hoa (pseudo, ham split la dialect):
--   for each task co tags:
--     for each name in split(task.tags, ','):
--       INSERT tag name neu chua co (bat unique violation neu trung)
--       INSERT (task.id, tag.id) vao task_tags

-- Step 3: verify count match
SELECT COUNT(*) FROM task_tags;
-- So sanh voi tong so tag tach ra tu cot chuoi (tinh o app layer).

-- Step 4: switch app code sang doc/ghi tu task_tags
-- (deploy app version moi truoc khi drop column)

-- Step 5: drop column cu (sau khi app code da switch hoan toan)
-- ALTER TABLE tasks DROP COLUMN tags;
-- (production: lam theo expand-contract pattern -- xem bai 06)
Tách một chuỗi CSV ('urgent,bug') thành nhiều row ngay trong SQL là tính năng dialect — mỗi engine có hàm split/table-function riêng. Để portable, đọc từng row ở app layer, split chuỗi bằng code, rồi INSERT lại. Logic refactor 1NF là phổ quát; chỉ cách tách chuỗi là khác nhau theo engine.
Bước nào cần cẩn thận nhất: Step 5 — DROP COLUMN là irreversible. Bài 06 — Schema migration giải thích expand-contract: giữ column cũ song song với junction table, double-write trong thời gian chuyển tiếp, chỉ drop sau khi verify đủ lâu không có rollback. Module 6 — Storage & indexing đi sâu về index trên junction table để query hiệu quả.
9. Deep Dive — Normalization
- Database System Concepts (Silberschatz, Korth, Sudarshan, 7th ed) — Ch.7 "Relational Database Design" — formal 1NF/2NF/3NF/BCNF với functional dependency theory, closure of attribute sets, và decomposition algorithm. Đây là tài liệu học thuật chuẩn nhất cho rigor lý thuyết.
- Codd 1972 — "Further Normalization of the Data Base Relational Model" — paper gốc giới thiệu 2NF và 3NF (1NF đã có trong paper 1970). Link có thể thay đổi — search "Codd 1972 normalization PDF" để tìm mirror.
Ghi chú: DSC Ch.7 cho rigor và practice problems — nên đọc khi cần hiểu formal proof của decomposition lossless. Codd 1972 cho lịch sử và intuition gốc — ngắn, đọc được trong 1 buổi, cho thấy tác giả suy nghĩ thế nào khi đặt ra định nghĩa ban đầu.
10. Liên hệ các bài khác
- Bài 01 — Data types: vì sao array/JSON nhồi nhiều giá trị vào một cell vi phạm 1NF — nền tảng cho phần này.
- Bài 02 — Constraints: FK và composite PK là công cụ chính khi tách bảng để chuẩn hoá.
- Bài 04 — Denormalization tradeoff: khi nào break 3NF có chủ đích để lấy read performance.
- Bài 06 — Schema migration: refactor 1NF (drop column cũ) trên bảng production cần expand-contract.
- Module 6 — Storage & indexing: index trên junction table để query JOIN hiệu quả.
11. Tóm tắt
- 1NF: mỗi cell 1 giá trị scalar — không nhét list, array, hay struct. Vi phạm điển hình: cột
tagskiểu chuỗi'urgent,bug'. - 2NF: pre-1NF + mọi non-key column phụ thuộc toàn bộ composite PK — không phụ thuộc partial.
- 3NF: pre-2NF + không có transitive dependency qua non-key column (
PK → A → Bchain). - BCNF: strict 3NF — vi phạm chỉ khi có overlapping candidate keys, hiếm gặp trong practice.
- 4 anomaly khi không normalize: insertion, update, deletion, redundancy — mỗi cái là cost ẩn phải trả bằng application logic hoặc inconsistent data.
- Pragmatic: 3NF + chấp nhận embed 1:1 always-together (DDD embedded value object) — không phải lười, mà tránh over-normalize vô ích.
- Tất cả là nguyên lý agnostic — đúng ở mọi RDBMS. Forward: Bài 04 — Denormalization tradeoff, Bài 06 — Schema migration.
12. Tự kiểm tra
- Q1Vì sao cột tags kiểu chuỗi 'urgent,bug' vi phạm 1NF? Hậu quả thực tế khi filter và aggregate?
- Q2Phân biệt 2NF vs 3NF. Cho ví dụ vi phạm mỗi cái với schema TaskFlow và cách fix.
- Q3Một số engine hỗ trợ array column kèm index tìm phần tử — vi phạm 1NF không? Khi nào array thực sự phù hợp?
- Q44 anomaly (insertion, update, deletion, redundancy) — cái nào nguy hiểm nhất trong production? Cho ví dụ cụ thể.
- Q5"Always normalize to 3NF" vs "pragmatic — denormalize khi cần read performance". Quan điểm nào đúng? Tradeoff thực sự là gì?
- Q6TaskFlow refactor cột tags chuỗi sang junction table: 4 bước migration. Bước nào nguy hiểm nhất và cách phòng ngừa downtime?
Bài tiếp theo: Denormalization tradeoff — khi nào break normalize có chủ đích
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên