Window functions intro — OVER + PARTITION BY giữ row + tính cross-row
Window = cửa sổ nhìn nhóm row liên quan, vẫn đứng tại 1 row. Khác GROUP BY collapse. 4 use case: ranking, aggregate over window, lag/lead, frame. WHERE rn=1 pitfall.
TL;DR: Window function = "cửa sổ nhìn nhóm" — tính metric cross-row (rank, aggregate, lag/lead) mà KHÔNG collapse row như GROUP BY. Cú pháp: func() OVER (PARTITION BY ... ORDER BY ...). Bug phổ biến: WHERE rn = 1 không hoạt động vì window function nằm trong SELECT (bước 5), WHERE chạy ở bước 2 — wrap subquery hoặc CTE. Window function là ANSI SQL chuẩn, hoạt động trên mọi RDBMS hiện đại (PostgreSQL, MySQL 8+, SQL Server, Oracle, SQLite 3.25+).
TaskFlow cần báo cáo: "task nào có due_at gần nhất trong từng project?" Câu truy vấn đầu tiên bạn thử dùng GROUP BY project_id — gom 30 task về 1 row per project, mất toàn bộ thông tin từng task. Bạn không thể giữ id, title, assignee_id vì chúng không nằm trong GROUP BY và không được aggregate.
Window function giải quyết bài toán này: giữ nguyên 30 row, thêm column rn tính từ thứ tự due_at trong từng project. Filter rn = 1 cho bạn đúng task muốn mà không mất chi tiết. Đây là pattern xuất hiện trong 79% job description analytics SQL — ranking per group, aggregate kết hợp so sánh cross-row, lag/lead giữa kỳ.
Bài này map khái niệm cửa sổ, cú pháp OVER, 4 use case cơ bản, và 1 pitfall mà hầu hết dev mới đều dính lần đầu.
1. Analogy — Cửa sổ nhìn xung quanh
Hãy tưởng tượng một bữa tiệc công ty: mọi người ngồi theo bàn (project). GROUP BY giống ban tổ chức gom mọi người thành từng bàn rồi chỉ báo cáo tổng số người mỗi bàn — bạn mất danh sách từng người. Window function giống mỗi người vẫn ngồi tại chỗ của mình, nhìn quanh bàn để biết mình đứng thứ mấy trong nhóm — identity vẫn giữ nguyên, thêm thông tin cross-row.
| Bữa tiệc | SQL |
|---|---|
| Ban tổ chức gom bàn, báo tổng số người | GROUP BY — collapse nhiều row thành 1 |
| Mỗi người ngồi tại chỗ, nhìn quanh bàn | Window function — giữ row, thêm cross-row metric |
| "Bàn A" thay vì từng tên | Aggregate result — mất individual identity |
| Rank trong bàn của mình | ROW_NUMBER() OVER (PARTITION BY project_id ORDER BY due_at) |
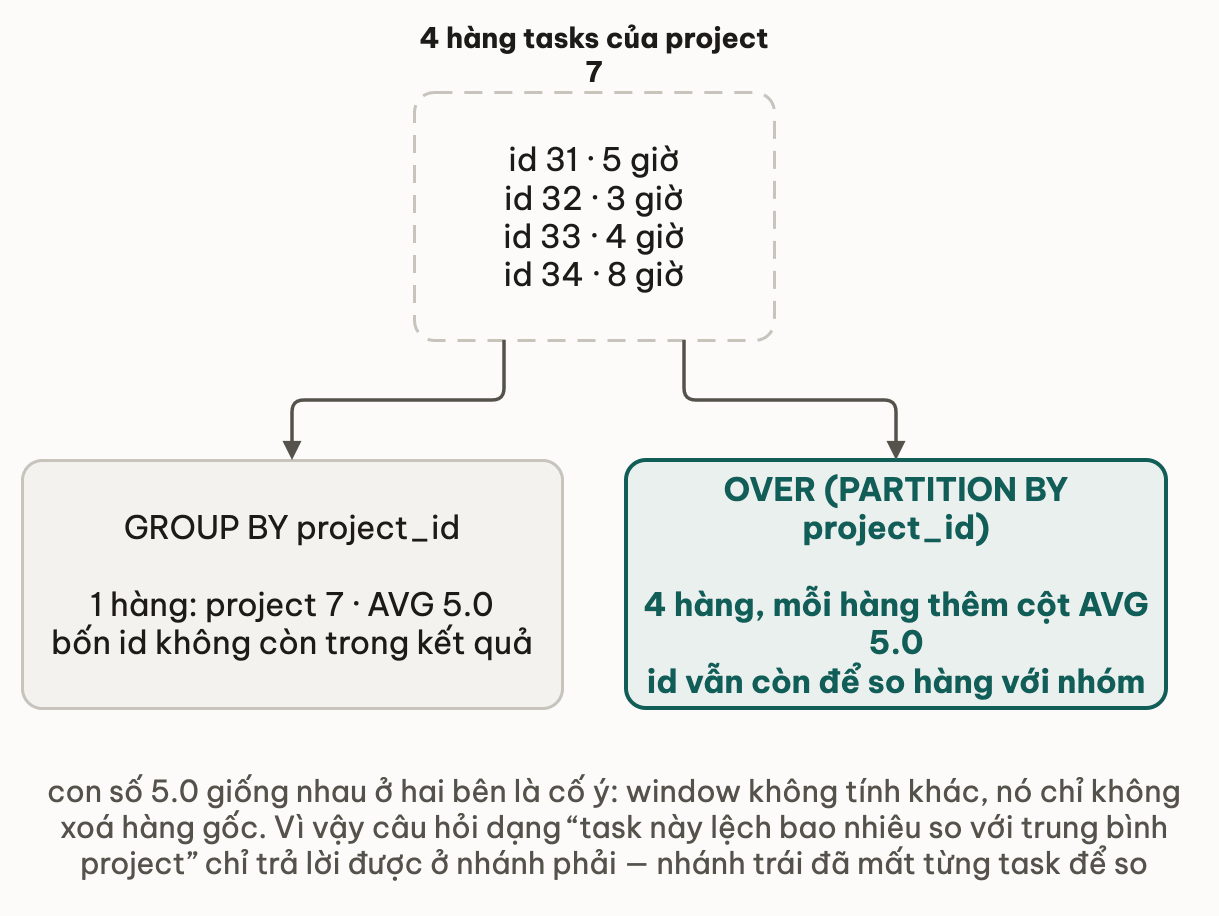
Window = "cửa sổ nhìn nhóm" — bạn vẫn đứng tại row của mình, nhưng thấy được thông tin của cả nhóm xung quanh. GROUP BY collapse nhóm thành 1 row. Window không collapse — mỗi row vẫn xuất hiện trong kết quả.
"Không collapse" nghe trừu tượng, nhưng nó đo được bằng số hàng đầu ra — cùng bốn hàng đầu vào, một bên trả về 1 hàng, một bên trả về 4:
2. Cú pháp + cơ chế
SELECT
  id,
  project_id,
  title,
  due_at,
  ROW_NUMBER() OVER (PARTITION BY project_id ORDER BY due_at) AS rn
FROM tasks;
Ba phần trong OVER(...):
| Phần | Vai trò | Ghi chú |
|---|---|---|
PARTITION BY project_id | Chia rows thành group theo project | Giống GROUP BY nhưng KHÔNG collapse |
ORDER BY due_at | Thứ tự trong từng window | Quyết định rank, lag/lead, frame |
| (frame clause) | Phạm vi rows tính trong window | Mặc định hoặc chỉ định — bài 7 deep dive |
Output minh họa:
id | project_id | title       | due_at     | rn
---+------------+-------------+------------+----
 1 |          1 | Deploy v1   | 2026-05-01 |  1
 2 |          1 | Fix auth    | 2026-05-03 |  2
 3 |          1 | Update docs | 2026-05-10 |  3
 4 |          2 | Mockup home | 2026-05-02 |  1
 5 |          2 | Logo design | 2026-05-05 |  2
Mỗi row vẫn xuất hiện đầy đủ. rn reset cho mỗi project_id vì PARTITION BY project_id. Task id=4 của project 2 có rn=1 độc lập với project 1.
3. So sánh window vs aggregate vs subquery
-- AGGREGATE: collapse, mat row chi tiet
SELECT project_id, AVG(EXTRACT(DAY FROM (updated_at - created_at)))
FROM tasks
GROUP BY project_id;
-- Output: 1 row per project, khong xem duoc task individual
-- WINDOW: giu row + add column cross-row
SELECT
  id,
  title,
  project_id,
  EXTRACT(DAY FROM (updated_at - created_at))              AS my_days,
  AVG(EXTRACT(DAY FROM (updated_at - created_at)))
    OVER (PARTITION BY project_id)                         AS project_avg
FROM tasks;
-- Output: moi row task + column project_avg tinh tren ca project
-- SUBQUERY: verbose hon, plan thuong cham hon voi bang lon
SELECT
  t.id,
  t.title,
  t.project_id,
  EXTRACT(DAY FROM (t.updated_at - t.created_at))          AS my_days,
  (SELECT AVG(EXTRACT(DAY FROM (updated_at - created_at)))
   FROM tasks
   WHERE project_id = t.project_id)                        AS project_avg
FROM tasks t;
-- Output: same result nhung correlated subquery chay lai cho moi row
Window là lựa chọn tốt nhất cho pattern "giữ row chi tiết + thêm cross-row metric". Subquery correlated đạt cùng kết quả nhưng thường chậm hơn với bảng lớn vì chạy lại cho mỗi row.
4. 4 use case — tổng quan
| # | Pattern | Function ví dụ | Use case |
|---|---|---|---|
| 1 | Ranking | ROW_NUMBER, RANK, DENSE_RANK | Top N per group, leaderboard |
| 2 | Aggregate over window | SUM/AVG/COUNT OVER | Row detail + group metric song song |
| 3 | Lag/Lead | LAG, LEAD | So sánh với row trước/sau |
| 4 | Frame (running/moving) | SUM OVER ROWS BETWEEN | Running total, moving average |
Bài tiếp theo (Module 3 bài 7 của khoá này) đi sâu cả 4 pattern với ví dụ thực chiến. Bài này focus intro + pattern 1 (ranking) + pattern 2 (aggregate over window) để xây nền.
Thử ngẫmreport "task due gần nhất per project" đổi yêu cầu thành "3 task due gần nhất per project". Trong bốn pattern ở bảng trên, bạn đụng đúng một pattern — nhưng đổi gì trong đó?
5. Pattern 1 — Ranking với ROW_NUMBER
-- "Task co due_at som nhat per project"
SELECT
  id,
  project_id,
  title,
  due_at,
  ROW_NUMBER() OVER (PARTITION BY project_id ORDER BY due_at) AS rn
FROM tasks;
-- rn=1 la task due som nhat trong project do
Filter rn = 1 cho top-1 per project. Nhưng WHERE rn = 1 trực tiếp báo lỗi — đây là pitfall quan trọng, xem section 6.
Ba hàm ranking hay dùng:
| Hàm | Tie handling | Ví dụ với tie |
|---|---|---|
ROW_NUMBER() | Luôn unique, tie break tùy ý | 1, 2, 3, 4 |
RANK() | Gap sau tie | 1, 2, 2, 4 |
DENSE_RANK() | Không gap sau tie | 1, 2, 2, 3 |
6. Pitfall — WHERE rn = 1 không hợp lệ
Window function nằm trong SELECT (bước 5 của logical order). WHERE chạy ở bước 2 — trước khi window được tính. Dùng WHERE rn = 1 sau ROW_NUMBER() OVER (...) AS rn sẽ báo column "rn" does not exist.
-- BUG: WHERE chay TRUOC SELECT (trong do chua window result)
SELECT
  id,
  project_id,
  title,
  ROW_NUMBER() OVER (PARTITION BY project_id ORDER BY due_at) AS rn
FROM tasks
WHERE rn = 1;
-- ERROR: column "rn" does not exist
Ba cách fix:
-- Fix 1: wrap subquery -- universal, moi dialect
SELECT * FROM (
  SELECT
    id,
    project_id,
    title,
    ROW_NUMBER() OVER (PARTITION BY project_id ORDER BY due_at) AS rn
  FROM tasks
) sub
WHERE rn = 1;
-- Fix 2: CTE (Module 8 cua khoa nay -- readable hon cho query phuc tap)
WITH ranked AS (
  SELECT
    id,
    project_id,
    title,
    ROW_NUMBER() OVER (PARTITION BY project_id ORDER BY due_at) AS rn
  FROM tasks
)
SELECT * FROM ranked WHERE rn = 1;
-- Fix 3: DISTINCT ON (PostgreSQL-only) -- ngan nhat cho top-1 per group
SELECT DISTINCT ON (project_id)
  id, project_id, title, due_at
FROM tasks
ORDER BY project_id, due_at;
-- Chi PostgreSQL. MySQL/SQL Server: dung subquery/CTE voi ROW_NUMBER (Fix 1/2)
DISTINCT ON là lựa chọn ngắn gọn nhất cho "top-1 per group" trong PostgreSQL — không portable sang MySQL/SQL Server. Window function (Fix 1/2) cần thiết khi muốn top-N (N vượt 1) hoặc khi cần giữ rank value trong kết quả, và là cách portable nhất.
Thử ngẫmbạn dùng Fix 3 (DISTINCT ON) cho một dashboard nội bộ. Sáu tháng sau PM yêu cầu "top 3 thay vì top 1". Chi phí đổi code lúc đó lớn cỡ nào so với nếu ban đầu chọn Fix 1?
7. Pattern 2 — Aggregate over window
-- Per task: so ngay hoan thanh cua task nay + trung binh cua project + tong cua assignee
SELECT
  id,
  title,
  EXTRACT(DAY FROM (updated_at - created_at))              AS my_days,
  AVG(EXTRACT(DAY FROM (updated_at - created_at)))
    OVER (PARTITION BY project_id)                         AS project_avg,
  SUM(EXTRACT(DAY FROM (updated_at - created_at)))
    OVER (PARTITION BY assignee_id)                        AS my_total_days
FROM tasks
WHERE status = 'done';
Hai window khác nhau (PARTITION BY project_id và PARTITION BY assignee_id) trong cùng một query hoàn toàn hợp lệ. PostgreSQL tính từng window function độc lập — mỗi OVER(...) định nghĩa một cửa sổ riêng.
8. Applied — TaskFlow leaderboard nâng cao
-- "Per user: so task done + rank trong project theo so task done"
SELECT
  u.id,
  u.name,
  t.project_id,
  COUNT(t.id) FILTER (WHERE t.status = 'done')           AS done_count,
  RANK() OVER (
    PARTITION BY t.project_id
    ORDER BY COUNT(t.id) FILTER (WHERE t.status = 'done') DESC
  )                                                        AS project_rank
FROM users u
LEFT JOIN tasks t ON t.assignee_id = u.id
GROUP BY u.id, u.name, t.project_id;
Điểm đáng chú ý: window function chạy sau GROUP BY trong logical order (GROUP BY là bước 3, window function nằm trong SELECT là bước 5). Vì vậy RANK() OVER (...) có thể dùng kết quả của COUNT(...) FILTER (...) — aggregate được tính xong trước khi window function đọc giá trị đó.
id | name    | project_id | done_count | project_rank
---+---------+------------+------------+--------------
 1 | An      |          1 |          8 |            1
 2 | Binh    |          1 |          5 |            2
 3 | Chi     |          1 |          5 |            2
 4 | An      |          2 |          3 |            1
RANK() tạo gap: project_rank = 4 không xuất hiện sau hai người rank 2. Dùng DENSE_RANK() nếu muốn liên tục không gap.
9. Deep Dive — Window functions
- Modern SQL — Window Functions — Markus Winand giải thích window function cross-vendor (PostgreSQL, MySQL 8+, SQL Server, Oracle, SQLite 3.25+): cú pháp OVER, PARTITION BY, frame clause. Agnostic, có bảng so sánh dialect.
- SQL Standard ISO/IEC 9075 — Window Functions — định nghĩa chuẩn ANSI SQL cho window function calls, frame clause grammar, và FILTER.
- Itzik Ben-Gan — "T-SQL Window Functions: For SQL Server and Azure SQL" (sách) — deep dive về frame clause, gap-and-island pattern. Viết cho SQL Server nhưng concept áp dụng cho mọi RDBMS tuân ANSI SQL.
Ghi chú: Modern SQL cho cross-vendor quick reference; ISO spec cho nguồn gốc chuẩn; Ben-Gan khi muốn master frame clause và advanced pattern như gap-and-island.
10. Tóm tắt
- Window function = "cửa sổ nhìn nhóm row liên quan" — KHÔNG collapse như GROUP BY, mỗi row vẫn xuất hiện trong kết quả.
- Cú pháp:
func() OVER (PARTITION BY ... ORDER BY ...)— PARTITION BY chia group, ORDER BY xác định thứ tự trong window. - 4 use case: ranking (
ROW_NUMBER/RANK/DENSE_RANK), aggregate over window (SUM/AVG/COUNT OVER), lag/lead so sánh row trước/sau, frame cho running total và moving average. WHEREkhông thấy window function result — wrap subquery hoặc CTE để filter theo column window.DISTINCT ON (col)là alternative ngắn gọn cho "top-1 per group" trong PostgreSQL (không portable). Window function + subquery/CTE là cách portable cho top-N và khi cần rank value.- Window function chạy sau GROUP BY trong logical order — có thể OVER trên aggregate result.
- Module 3 bài 7 của khoá này: rank/lag/running total — 4 pattern thực chiến. Module 4 của khoá này: CTE wrap pattern cho window filter.
11. Tự kiểm tra
- Q1Vì sao window function giữ row trong khi GROUP BY collapse? Khi nào dùng window, khi nào dùng GROUP BY?
- Q2Vì sao
WHERE rn = 1sauROW_NUMBER() OVER (...) AS rnbáo lỗi? Nêu 3 cách fix và tradeoff. - Q3Phân biệt
AVG(x) OVER (PARTITION BY p)vsSELECT AVG(x) FROM t GROUP BY p. Cho ví dụ output khác nhau. - Q4DISTINCT ON vs ROW_NUMBER + WHERE rn=1 — khi nào dùng cái nào?
- Q5Window function chạy ở vị trí nào trong SQL logical processing order? Điều này ảnh hưởng gì đến việc dùng window kết hợp GROUP BY?
- Q6TaskFlow cần '1 query trả về task due gần nhất per assignee, kèm median due (tính bằng ngày từ hôm nay) của toàn project đó'. Có thể viết 1 query không? Phác thảo approach.
Bài tiếp theo: Window rank/lag/running total — 4 pattern phổ biến nhất analytics
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên