Window functions nâng cao — Frame, NTILE, Gap-and-island
Frame clause ROWS/RANGE/GROUPS, NTILE, PERCENT_RANK/CUME_DIST, và gap-and-island cho streak analysis — viết analytics query phức tạp mà không chồng nhiều CTE.
TL;DR: Bốn pattern window function nâng cao, tất cả là cú pháp chuẩn SQL. Frame clause (ROWS / RANGE / GROUPS) kiểm soát chính xác cửa sổ tính: ROWS đếm theo row vật lý (deterministic), RANGE theo giá trị ORDER BY. Frame default đổi khi thêm ORDER BY — không khai báo frame thì có ORDER BY thành running total chứ không phải full partition (bug silent). NTILE(N) chia bucket gần đều; PERCENT_RANK / CUME_DIST cho vị trí tương đối 0-1; gap-and-island (day - ROW_NUMBER()) tìm chuỗi liên tục. Frame clause và các function này là ANSI SQL — ghi chú dialect khi mức hỗ trợ khác nhau (vd GROUPS mode mới hơn).
Module 3 của khoá này (join-aggregation-window) đã học ROW_NUMBER, RANK, DENSE_RANK, LAG, LEAD — 5 window function phổ biến nhất. Nhưng window functions còn 4 pattern nâng cao ít người biết mà xuất hiện thường xuyên trong analytics query thực chiến.
Sau bài này bạn sẽ viết được: running 7-day completion rate với frame clause chính xác, quartile phân tích cohort với NTILE, relative percentile với PERCENT_RANK/CUME_DIST, và quan trọng nhất — gap-and-island pattern để tìm streak liên tục mà không cần join phức tạp hay CTE chồng 4 cấp.
1. Analogy — Đọc nhật ký công ty
Hãy hình dung bạn đang đọc nhật ký vận hành của công ty — hàng nghìn trang, mỗi trang là 1 ngày, có entry được ghi mỗi khi có sự kiện.
| Hành động đọc nhật ký | SQL Pattern |
|---|---|
| Đánh số thứ tự từng trang | ROW_NUMBER() — Module 3 của khoá |
| Đọc 7 trang quanh trang hiện tại (cố định số trang) | Frame ROWS BETWEEN 6 PRECEDING AND CURRENT ROW |
| Đọc nhật ký 7 ngày quanh ngày hiện tại (cố định khoảng thời gian) | Frame RANGE BETWEEN INTERVAL '7 days' PRECEDING AND CURRENT ROW |
| Chia nhật ký thành 4 quý bằng nhau về số trang | NTILE(4) |
| Tính trang này nằm ở percentile thứ bao nhiêu | PERCENT_RANK() / CUME_DIST() |
| Tìm chuỗi ngày liên tiếp có entry / phát hiện ngày bị bỏ trống | Gap-and-island pattern |
Frame ROWS = cố định số trang (7 trang vật lý). Frame RANGE = cố định khoảng thời gian (7 ngày lịch, dù có ngày không có entry). NTILE = chia đều thành N nhóm. PERCENT_RANK/CUME_DIST = vị trí tương đối 0-1. Gap-and-island = tìm chuỗi liên tục bằng cách trừ row_number — đơn giản và hiệu quả.
2. Frame clause — ROWS vs RANGE vs GROUPS
Frame clause kiểm soát "cửa sổ" thực sự bao gồm những row nào cho mỗi phép tính. Chuẩn SQL định nghĩa 3 mode (ROWS và RANGE có ở hầu hết engine; GROUPS mới hơn, một số engine chưa hỗ trợ):
-- ROWS: physical row count -- luon dem theo so row vat ly
SELECT
  id,
  created_at,
  count(*) OVER (
    ORDER BY created_at
    ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
  ) AS last_7_rows
FROM tasks;
-- Luon tinh tren dung 7 row: 6 row truoc + row hien tai
-- Neu data co gap (nhay tu ngay 1 len ngay 10), van tinh tren 7 row vat ly

-- RANGE: value-based -- frame theo gia tri column ORDER BY
SELECT
  id,
  created_at,
  count(*) OVER (
    ORDER BY created_at
    RANGE BETWEEN INTERVAL '6 days' PRECEDING AND CURRENT ROW
  ) AS rolling_7d
FROM tasks;
-- Tinh tat ca row trong khoang 7 ngay lich, ke ca ngay gap (khong co row)
-- Neu 3 ngay lien tiep khong co task, rolling_7d van chi dem row thuc te co

-- GROUPS: peer group count (chuan SQL, engine moi ho tro)
SELECT
  id,
  score,
  sum(score) OVER (
    ORDER BY score
    GROUPS BETWEEN 1 PRECEDING AND 1 FOLLOWING
  ) AS group_sum
FROM rankings;
-- GROUPS dem theo nhom peer (cac row co cung gia tri ORDER BY la 1 nhom)
-- 1 PRECEDING = 1 nhom peer truoc, 1 FOLLOWING = 1 nhom peer sau
Bảng so sánh 3 mode:
| Mode | Offset theo | Khi data có gap ngày | Dùng khi |
|---|---|---|---|
ROWS | Số row vật lý | Có thể trải dài nhiều tuần nếu data thưa | Cần N data point gần nhất |
RANGE | Giá trị của ORDER BY column | Đúng semantic "7 ngày lịch" | Cần N ngày lịch gần nhất |
GROUPS | Số nhóm peer | Phụ thuộc distribution giá trị | Cần N nhóm giá trị gần nhất |
Thử ngẫmbạn cần "điểm trung bình của thí sinh cùng band điểm với thí sinh này, cộng band liền trên/dưới". Mode nào trong ba mode khớp đúng yêu cầu này?
3. ROWS và RANGE lệch nhau ở đâu
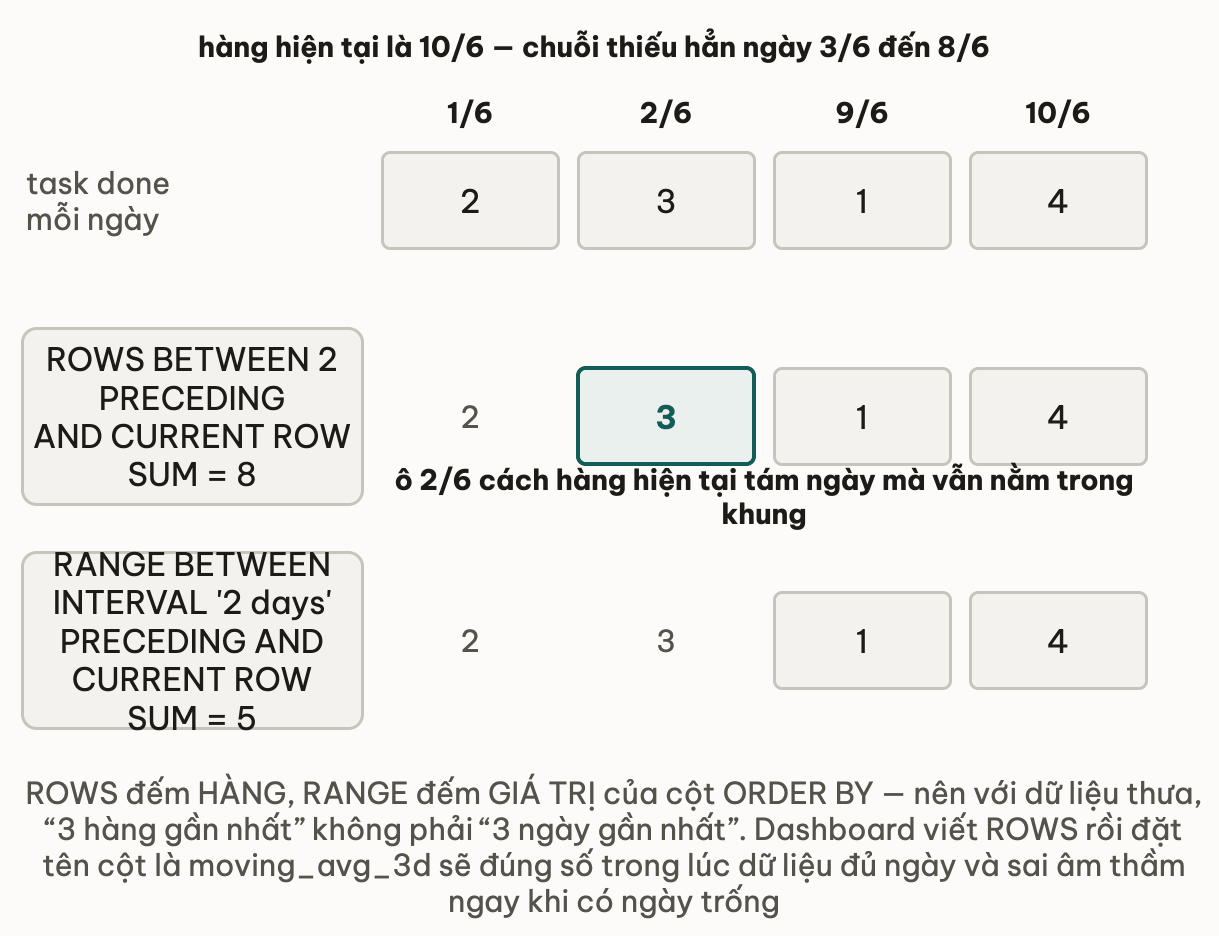
Với dữ liệu liên tục, hai mode cho cùng một tập hàng — nên khác biệt chỉ hiện ra khi chuỗi có lỗ. Bỏ hẳn ngày 3/6 đến 8/6 rồi đứng tại 10/6:
4. Frame default — pitfall thường gặp
Đây là bug silent phổ biến nhất khi dùng aggregate window function. Theo chuẩn SQL, frame default đổi tùy có ORDER BY hay không — đúng ở mọi RDBMS:
-- KHONG co ORDER BY trong window:
-- frame mac dinh = RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
-- -> full partition: moi row trong partition tra ve cung gia tri
SUM(amount) OVER ()
-- = tong toan bo bang (hay toan partition neu co PARTITION BY)

-- CO ORDER BY, KHONG khai bao frame:
-- frame mac dinh = RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
-- -> running total! KHONG phai full partition
SUM(amount) OVER (ORDER BY created_at)
-- Pitfall: nguoi viet tuong la "tong toan partition theo thu tu"
-- Thuc te: moi row nhan tong tich luy den row do (running total)
-- Query chay khong bao loi, ket qua sai silent

-- Force full partition KHI CO ORDER BY:
SUM(amount) OVER (
  ORDER BY created_at
  ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
)
-- Hoac: bo ORDER BY neu chi can full partition (khong can thu tu)
SUM(amount) OVER ()
Quy tắc thực chiến: luôn khai báo frame explicit khi dùng aggregate window function. Không để implicit default quyết định behavior.
5. NTILE — chia bucket gần đều
NTILE(N) chia các row trong partition thành N bucket có kích thước gần bằng nhau (bucket đầu có thể lớn hơn 1 nếu không chia hết).
-- Chia user thanh 4 quartile theo so task hoan thanh
SELECT
  user_id,
  completed_count,
  NTILE(4) OVER (ORDER BY completed_count DESC) AS quartile
FROM (
  SELECT
    assignee_id AS user_id,
    count(*)    AS completed_count
  FROM tasks
  WHERE status = 'done'
  GROUP BY assignee_id
) sub;
-- Quartile 1 = top 25% user (nhieu task done nhat)
-- Quartile 4 = bottom 25% user (it task done nhat)
-- NTILE(4) ORDER BY DESC -> quartile 1 la top performer
Use case phổ biến: percentile cohort (top/bottom 25%), A/B split (NTILE(2)), quartile distribution analysis. Lưu ý: NTILE phân phối gần đều nhưng không hoàn toàn đều — row dư phân vào các bucket đầu (10 row, NTILE(3): bucket 1 nhận 4 row, bucket 2-3 nhận 3 row).
6. PERCENT_RANK và CUME_DIST — vị trí tương đối 0-1
-- Vi tri tuong doi 0-1 cua moi row trong partition
SELECT
  user_id,
  completed_count,
  PERCENT_RANK() OVER (ORDER BY completed_count) AS pct_rank,
  CUME_DIST()    OVER (ORDER BY completed_count) AS cume_dist
FROM (
  SELECT assignee_id AS user_id, count(*) AS completed_count
  FROM tasks WHERE status = 'done'
  GROUP BY assignee_id
) sub;
-- pct_rank = 0 cho row co gia tri nho nhat, 1 cho gia tri lon nhat
-- cume_dist = % row co gia tri <= gia tri hien tai
Công thức:
PERCENT_RANK = (rank - 1) / (total_rows - 1)— row nhỏ nhất = 0, lớn nhất = 1. Partition 1 row →PERCENT_RANK = 0.CUME_DIST = count(rows <= current) / total_rows— luôn trong khoảng(0, 1], không bao giờ bằng 0.
| Function | Row nhỏ nhất | Row lớn nhất | Ý nghĩa thực tế |
|---|---|---|---|
PERCENT_RANK | 0.0 | 1.0 | "Row này đứng ở percentile thứ mấy" |
CUME_DIST | 1/total | 1.0 | "% rows có giá trị nhỏ hơn hoặc bằng row này" |
-- Practical: tim user o top 10% theo task completion
SELECT user_id, completed_count
FROM (
  SELECT
    assignee_id AS user_id,
    count(*) AS completed_count,
    PERCENT_RANK() OVER (ORDER BY count(*) DESC) AS pct_rank
  FROM tasks WHERE status = 'done'
  GROUP BY assignee_id
) sub
WHERE pct_rank <= 0.10;
-- pct_rank ORDER BY DESC -> pct_rank = 0 la top performer
-- pct_rank <= 0.10 = top 10%
Thử ngẫmdashboard cần hiển thị "user này vượt qua bao nhiêu % đồng nghiệp về completion rate". Bạn chọn PERCENT_RANK hay CUME_DIST, và vì sao?
7. Gap-and-island — pattern then chốt
Gap-and-island là kỹ thuật xác định chuỗi liên tiếp (island) bị ngắt quãng bởi khoảng trống (gap). Pattern cốt lõi: với các row liên tiếp theo ngày, ROW_NUMBER tăng cùng nhịp với ngày → hiệu day - row_number * 1 day = hằng số cho toàn bộ island.
Intuition: Ngày 1, 2, 3 → ROW_NUMBER 1, 2, 3 → day - rn * 1day = ngày 0 (hằng số). Khi gap xuất hiện (nhảy từ ngày 3 lên ngày 5), ngày tăng 2 nhưng ROW_NUMBER chỉ tăng 1 → hiệu thay đổi → grp mới.
-- "Longest streak ngay lien tuc co task completed per user"
WITH daily_completed AS (
  -- Buoc 1: 1 row per (user, day) -- loai duplicate trong ngay
  SELECT
    assignee_id,
    CAST(date_trunc('day', updated_at) AS DATE) AS day
  FROM tasks
  WHERE status = 'done'
  GROUP BY assignee_id, CAST(date_trunc('day', updated_at) AS DATE)
),
islands AS (
  -- Buoc 2: tinh group key -- hang so cho moi island
  SELECT
    assignee_id,
    day,
    -- KEY: row_number tang cung nhip voi day khi lien tuc
    -- -> hieu la hang so cho toan bo island
    day - CAST(ROW_NUMBER() OVER (
      PARTITION BY assignee_id ORDER BY day
    ) AS INT) * INTERVAL '1' DAY AS grp
  FROM daily_completed
)
-- Buoc 3: dem do dai moi island
SELECT
  assignee_id,
  count(*) AS streak_length,
  min(day) AS streak_start,
  max(day) AS streak_end
FROM islands
GROUP BY assignee_id, grp
ORDER BY streak_length DESC
LIMIT 10;
Use case: phát hiện ngày thiếu trong time series, chuỗi login / commit liên tiếp, vùng data liên tục trong sensor reading.
Nguyên lý gap-and-island (trừ một dãy tăng đều khỏi cột thứ tự để mọi phần tử liên tiếp ra cùng group key) là phổ quát — không phụ thuộc engine. Nhưng cú pháp date/interval trong ví dụ là dialect: INTERVAL '1 day', date_trunc(...), và cast ::date / ::int viết theo kiểu PostgreSQL. Engine khác dùng cú pháp riêng cho cùng ý: ví dụ ép kiểu chuẩn SQL là CAST(x AS date) thay cho x::date; MySQL có DATE(...) và INTERVAL 1 DAY; SQL Server có DATEADD/DATEDIFF. Với cột số nguyên (không phải ngày), bản gap-and-island còn đơn giản hơn: chỉ cần value - ROW_NUMBER() — không cần interval.
8. Window vs aggregate vs subquery — bảng quyết định
| Cần | Pattern phù hợp |
|---|---|
| Aggregate per group, mỗi group cho ra 1 row | GROUP BY |
| Aggregate per group, giữ row chi tiết + thêm aggregate column | Window function |
| Top N per group | LATERAL hoặc Window + filter (bài 1 của module này) |
| Running total / moving average | Window function với frame clause |
| Streak liên tục / detect gap | Gap-and-island (window + GROUP BY) |
| Chia bucket percentile | NTILE(N) window function |
| Vị trí tương đối trong distribution | PERCENT_RANK / CUME_DIST |
9. Pitfall — frame default và RANGE peer rows
Pitfall 1 — Frame default thay đổi khi thêm ORDER BY:
-- KHONG ORDER BY: full partition -- moi row cung gia tri
SUM(x) OVER (PARTITION BY p)

-- CO ORDER BY, KHONG frame: running total -- moi row khac nhau
SUM(x) OVER (PARTITION BY p ORDER BY date)
-- Bug silent: nom nhu "tong toan partition theo thu tu"
-- Thuc te: running total -- neu khong phai y muon, fix ngay

-- Fix: explicit frame
-- Full partition voi ORDER BY:
SUM(x) OVER (PARTITION BY p ORDER BY date
             ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING)
-- Running total ro rang:
SUM(x) OVER (PARTITION BY p ORDER BY date
             ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
Pitfall 2 — RANGE peer rows gây kết quả bất ngờ với duplicate timestamp:
-- Data: 3 row co cung created_at = '2026-01-01 10:00:00'
-- Frame RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW:
-- RANGE xem 3 row do la "peer group" (cung gia tri ORDER BY)
-- -> ca 3 row duoc include vao cung frame
-- -> running total cong ca 3 row vao cung 1 buoc
-- -> 3 row co cung cumulative value (khong phai "bac thang" tung row)

SUM(amount) OVER (ORDER BY created_at)  -- RANGE default
-- Row 1 (10:00): cum_sum = 100+200+300 = 600 (cong ca 3 peer)
-- Row 2 (10:00): cum_sum = 600 (same)
-- Row 3 (10:00): cum_sum = 600 (same)
-- Row 4 (11:00): cum_sum = 600 + row4

-- Fix: dung ROWS thay RANGE cho predictable per-row behavior
SUM(amount) OVER (ORDER BY created_at
                  ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
-- Row 1: 100, Row 2: 300, Row 3: 600, Row 4: 600 + row4
Quy tắc: Dùng ROWS khi cần hành vi deterministic per row vật lý. Chỉ dùng RANGE khi muốn semantic "giá trị trong khoảng" — và data phải sạch, không có duplicate trên ORDER BY column.
10. Applied — TaskFlow streak + cohort report
Query 1: Longest streak per user (gap-and-island thực chiến)
-- Dashboard: top 10 user co streak hoan thanh task dai nhat (90 ngay gan nhat)
WITH daily_completed AS (
  SELECT assignee_id,
         CAST(date_trunc('day', updated_at) AS DATE) AS day
  FROM tasks
  WHERE status = 'done'
    AND updated_at >= now() - INTERVAL '90 days'
  GROUP BY assignee_id, CAST(date_trunc('day', updated_at) AS DATE)
),
islands AS (
  SELECT assignee_id, day,
         day - CAST(ROW_NUMBER() OVER (
           PARTITION BY assignee_id ORDER BY day
         ) AS INT) * INTERVAL '1' DAY AS grp
  FROM daily_completed
)
SELECT
  assignee_id,
  count(*)    AS streak_length,
  min(day)    AS streak_start,
  max(day)    AS streak_end,
  CASE WHEN max(day) >= current_date - 1 THEN true ELSE false END AS is_active
FROM islands
GROUP BY assignee_id, grp
ORDER BY streak_length DESC
LIMIT 10;
Query 2: User activity cohort với NTILE
-- Quartile report: phan loai user theo muc do hoat dong
WITH user_stats AS (
  SELECT
    assignee_id,
    count(*) FILTER (WHERE status = 'done') AS done_count,
    CAST(count(*) FILTER (WHERE status = 'done') AS FLOAT)
      / nullif(count(*), 0)                 AS completion_rate
  FROM tasks
  WHERE created_at >= now() - INTERVAL '30 days'
  GROUP BY assignee_id
)
SELECT
  activity_quartile,
  count(*)                            AS user_count,
  round(avg(done_count))              AS avg_done,
  round(CAST(avg(completion_rate) AS NUMERIC), 3) AS avg_rate
FROM (
  SELECT
    assignee_id, done_count, completion_rate,
    NTILE(4) OVER (ORDER BY done_count DESC) AS activity_quartile,
    PERCENT_RANK() OVER (ORDER BY completion_rate) AS rate_pct_rank
  FROM user_stats
) cohort
GROUP BY activity_quartile
ORDER BY activity_quartile;
-- Q1 = top 25% most active, Q4 = bottom 25%
-- Dung cho cohort analysis, onboarding funnel, churn risk model
11. Deep Dive
- Markus Winand — "Window Functions" (modern-sql.com) — giải thích
OVER,PARTITION BY, và frame clause (ROWS/RANGE/GROUPS) theo chuẩn SQL, kèm bảng mức hỗ trợ qua các engine. Nguồn agnostic tốt nhất để hiểu frame default behavior không gắn engine. - Itzik Ben-Gan — "T-SQL Window Functions" (book) — sách classic về window pattern. Viết cho SQL Server nhưng concept frame clause, gap-and-island, islands-with-counts là chuẩn SQL, áp dụng trực tiếp cho mọi RDBMS. Chapter gap-and-island là canonical reference cho kỹ thuật này.
- Tài liệu engine bạn dùng cho: mức hỗ trợ
GROUPSmode vàEXCLUDE(CURRENT ROW / GROUP / TIES) — các option này mới và chưa phổ cập đều — cùng cú pháp date/interval và cast (vddate_trunc,INTERVAL,::date) khác nhau giữa dialect khi viết gap-and-island.
12. Tóm tắt
- Frame
ROWSđếm theo row vật lý — predictable, deterministic per row. FrameRANGEdùng giá trị của ORDER BY column — đúng semantic khoảng thời gian nhưng có thể bất ngờ với duplicate value. FrameGROUPS(chuẩn SQL, engine mới hỗ trợ) đếm theo peer group. - Frame default thay đổi với ORDER BY: không có ORDER BY → full partition; có ORDER BY + không khai báo frame →
RANGE UNBOUNDED PRECEDING TO CURRENT ROW(running total, không phải full partition). Luôn khai báo frame explicit để tránh bug silent. NTILE(N)chia partition thành N bucket gần đều — bucket 1 là top performer khi ORDER BY DESC. Dùng cho percentile cohort, A/B split, quartile analysis.PERCENT_RANK=(rank - 1) / (total - 1)— 0 cho nhỏ nhất, 1 cho lớn nhất.CUME_DIST=count(rows <= current) / total— luôn trong(0, 1].- Gap-and-island pattern:
day - ROW_NUMBER() * INTERVAL '1 day'= hằng số cho chuỗi ngày liên tiếp → GROUP BY giá trị đó để tách từng island. Dùng cho streak analysis, missing date detection, consecutive event grouping. - Bảng quyết định: GROUP BY khi cần collapse row; window khi cần giữ row chi tiết + thêm aggregate;
NTILE/PERCENT_RANKkhi cần relative position; gap-and-island khi cần streak/consecutive sequence. - Combine 3 pattern trong 1 query (
NTILE+PERCENT_RANK+ gap-and-island) cho analytics dashboard đầy đủ — không cần CTE chồng 4 cấp hay subquery phức tạp.
13. Tự kiểm tra
- Q1Frame ROWS BETWEEN 6 PRECEDING AND CURRENT ROW vs RANGE BETWEEN INTERVAL '6 days' PRECEDING AND CURRENT ROW — kết quả khác nhau như thế nào khi data có gap ngày? Khi nào dùng cái nào?
- Q2Vì sao SUM(x) OVER (ORDER BY date) không phải full partition sum? Bug gì có thể xảy ra và fix như thế nào?
- Q3NTILE(4) ORDER BY done_count DESC trả quartile 1, 2, 3, 4. Quartile 1 là top hay bottom? Điều gì xảy ra khi số row không chia hết cho 4?
- Q4PERCENT_RANK và CUME_DIST khác nhau như thế nào? Row nhỏ nhất và lớn nhất trong partition cho giá trị gì với mỗi function?
- Q5Giải thích tại sao day - ROW_NUMBER() * INTERVAL '1 day' cho cùng giá trị hằng số với chuỗi ngày liên tiếp. Khi có gap, giá trị đó thay đổi như thế nào?
- Q6RANGE peer rows gây kết quả bất ngờ khi nào? Cho ví dụ cụ thể và cách fix.
- Q7TaskFlow cần dashboard: 'Với mỗi user, tìm streak hiện tại (chuỗi ngày liên tiếp gần nhất có task done) và xếp quartile theo total task done trong 30 ngày'. Phác thảo query dùng gap-and-island + NTILE.
Bài tiếp theo: Set operations — UNION / INTERSECT / EXCEPT
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên