UPSERT — INSERT hoặc UPDATE khi key trùng
INSERT nếu chưa có, UPDATE nếu key trùng — idempotent write trong một câu atomic. Race insert-or-update và landscape dialect: ON CONFLICT, ON DUPLICATE KEY, MERGE.
TL;DR: UPSERT = "INSERT nếu key chưa tồn tại, UPDATE nếu đã tồn tại" — giải bài idempotent write (giao một thao tác nhiều lần vẫn cho cùng kết quả) trong một câu lệnh atomic per row, thay vì try/catch quanh INSERT trong app. Vấn đề gốc là race insert-or-update: hai luồng cùng kiểm tra rồi cùng INSERT thì luồng sau crash unique constraint, còn pattern SELECT-rồi-UPDATE thì mất update. UPSERT đẩy cả "kiểm tra tồn tại" và "ghi" vào một statement để engine khoá row và đảm bảo atomicity. SQL không có một cú pháp UPSERT chung: chuẩn SQL dùng MERGE (xem bài 06), PostgreSQL/SQLite dùng INSERT ... ON CONFLICT, MySQL dùng INSERT ... ON DUPLICATE KEY UPDATE. Bài này dạy nguyên lý + đọc landscape dialect; cú pháp MERGE chi tiết để dành bài 06.
Webhook giao event webhook_evt_abc123 lần đầu — INSERT thành công. Network timeout, client retry — INSERT lần hai crash vì unique constraint. Bạn có thể try/catch trong app rồi nuốt lỗi. Nhưng phải phân biệt "unique violation lành tính do retry" với "lỗi thật" — dễ sai, và mỗi đường dẫn lỗi là một nhánh code phải test. Cách sạch hơn: một câu SQL làm cả hai việc — INSERT nếu chưa có, UPDATE (hoặc bỏ qua) nếu có. Đó là UPSERT.
Bài này trả lời: vì sao cần UPSERT (idempotency, tránh race), nguyên lý bên dưới khiến nó atomic, và landscape dialect — mỗi RDBMS hiện thực UPSERT một kiểu, nên đây là vùng dễ vấp khi viết SQL portable.
1. Analogy — notification dedupe trên mobile
Hãy nghĩ đến push notification. Mạng yếu, server gửi cùng một notification 2 lần. Đây là at-least-once delivery: hệ thống đảm bảo giao ít nhất một lần, nhưng không đảm bảo đúng một lần — nên duplicate là chuyện bình thường, không phải bug.
| Hành vi điện thoại | SQL tương đương |
|---|---|
| Hiển thị 2 notification giống hệt nhau | INSERT lần 2 không có UPSERT → crash hoặc tạo duplicate |
| Phát hiện notification ID đã xử lý → bỏ qua | UPSERT kiểu "bỏ qua khi trùng" (DO NOTHING) |
| Cập nhật nội dung notification nếu đã hiển thị | UPSERT kiểu "update khi trùng" (DO UPDATE / ON DUPLICATE KEY UPDATE) |
| Notification ID là "khoá" để nhận dạng duplicate | Column trong UNIQUE constraint hoặc PRIMARY KEY |
UPSERT = "U" của UPDATE + INSERT. Cần một khoá nhận dạng (UNIQUE/PK) để engine biết "row này đã tồn tại chưa". Khi trùng khoá, bạn chọn một trong hai hành vi: bỏ qua (idempotent, không đổi gì) hoặc merge (ghi đè giá trị mới). Toàn bộ xảy ra trong một câu lệnh — đó là điểm mấu chốt giúp nó atomic.
2. Vấn đề — vì sao cần UPSERT (idempotency + race)
TaskFlow nhận comment từ external API qua webhook. Network at-least-once: cùng một event có thể giao 2 lần. Ta thêm cột external_id để nhận dạng nguồn và đặt unique constraint trên (task_id, external_id):
-- Setup: them external_id de track source cua comment (cu phap chuan SQL)
ALTER TABLE comments ADD COLUMN external_id VARCHAR(255);
ALTER TABLE comments ADD CONSTRAINT uq_comment_external
  UNIQUE (task_id, external_id);

-- Webhook delivery lan 1:
INSERT INTO comments (task_id, user_id, body, external_id)
VALUES (42, 5, 'Hello', 'webhook_001');
-- OK

-- Webhook delivery lan 2 (network timeout, client retry):
INSERT INTO comments (task_id, user_id, body, external_id)
VALUES (42, 5, 'Hello', 'webhook_001');
-- ERROR: vi pham unique constraint uq_comment_external
-- (task_id, external_id) = (42, webhook_001) da ton tai
Có hai cách "thủ công" để xử lý, cả hai đều có vấn đề:
Cách thủ công 1 — try/catch trong app: bắt unique violation rồi bỏ qua. Vấn đề: phải phân biệt unique violation "lành tính" (retry) với "lỗi thật", và logic này rải ở mọi nơi gọi INSERT.
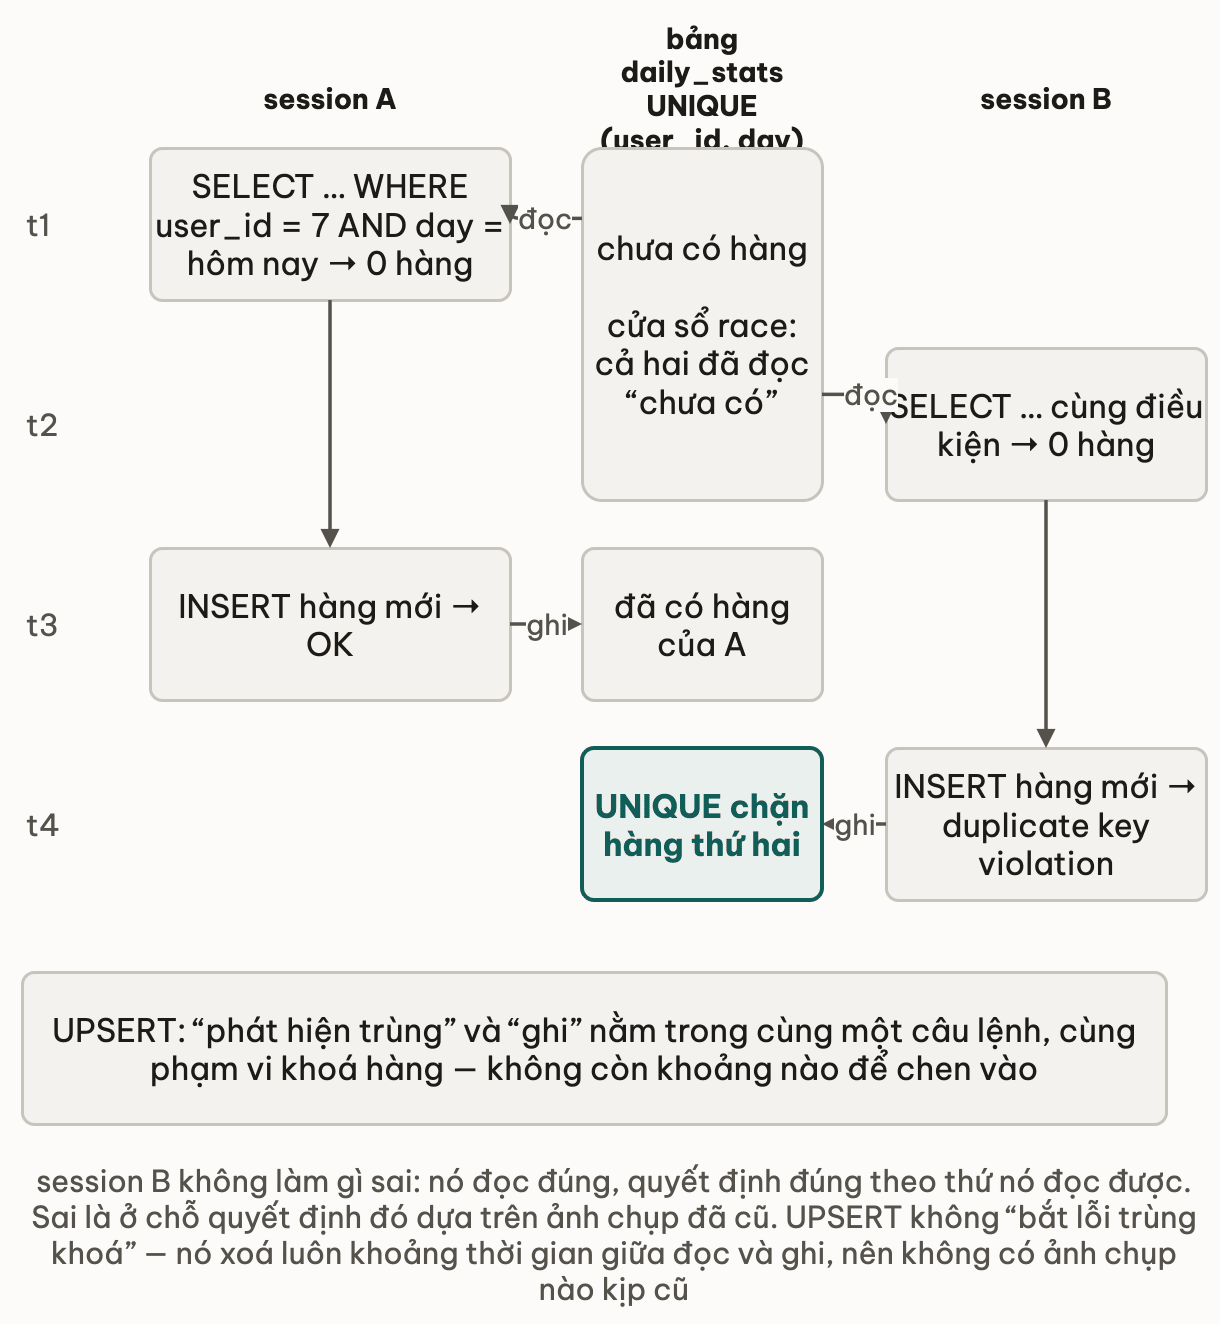
Cách thủ công 2 — SELECT rồi quyết định INSERT/UPDATE: kiểm tra row tồn tại chưa, nếu chưa thì INSERT, nếu rồi thì UPDATE. Vấn đề là race condition:
Session A: SELECT ... WHERE external_id='webhook_001'  -> khong co
Session B: SELECT ... WHERE external_id='webhook_001'  -> khong co (cung luc)
Session A: INSERT ...                                   -> OK
Session B: INSERT ...                                   -> CRASH unique violation
-- Hoac voi counter: ca hai doc gia tri cu -> mot update bi mat (lost update)
Khoảng thời gian giữa SELECT và INSERT/UPDATE là một cửa sổ race — hai session cùng quyết định dựa trên ảnh chụp cũ. Đây chính là vấn đề UPSERT giải: gộp "kiểm tra tồn tại" và "ghi" vào một câu lệnh để engine khoá row và xử lý atomic, đóng cửa sổ race.
Thử ngẫmTaskFlow ghi log thanh toán qua webhook, không dùng UPSERT mà dùng transaction SELECT ... FOR UPDATE rồi INSERT. Cách này có đóng được cửa sổ race giống UPSERT không?
3. Nguyên lý — vì sao một câu UPSERT lại atomic
Điểm cốt lõi không phải cú pháp mà là một statement = một đơn vị atomic per row. Khi engine thực thi UPSERT:
- Engine cố INSERT row mới.
- Nếu phát hiện vi phạm UNIQUE/PK (đã có row cùng khoá), nó không crash mà chuyển sang hành vi bạn khai báo: bỏ qua, hoặc update row đang tồn tại.
- Bước "phát hiện trùng" và "ghi" nằm trong cùng phạm vi khoá row — không có cửa sổ cho session khác chen vào giữa.
So với pattern SELECT-rồi-INSERT của app: ở đó "đọc" và "ghi" là hai lượt round-trip riêng, giữa chúng row có thể bị session khác thay đổi. UPSERT loại bỏ khoảng trống đó.
UPSERT đảm bảo atomic cho từng row — counter view_count = view_count + 1 trong UPSERT là an toàn với concurrent write. Nhưng nếu logic của bạn cần đọc nhiều row, tính toán, rồi ghi (ví dụ "tính lại tổng rồi cập nhật"), một UPSERT đơn không bao trùm được — đó là việc của transaction với isolation level phù hợp (Module 7 của khoá: transactions-va-consistency).
4. Hai hành vi khi trùng khoá — bỏ qua vs merge
Mọi dialect UPSERT đều cho hai lựa chọn khi gặp khoá trùng. Nguyên lý giống nhau, cú pháp khác nhau (mục 5).
Hành vi A — bỏ qua (idempotent, "ensure exists"): chỉ cần đảm bảo "row tồn tại", không cần cập nhật nếu đã có. Idempotent webhook handler là use case kinh điển: giao 1 lần hay 10 lần đều an toàn, DB chỉ giữ 1 bản, không lỗi.
Hành vi B — merge (ghi đè giá trị mới): khi trùng khoá, cập nhật row đang tồn tại bằng giá trị input. Dùng cho "sync giá trị mới nhất" hoặc counter increment.
-- Y tuong (PostgreSQL/SQLite syntax):
-- Hanh vi A -- bo qua khi trung:
INSERT INTO comments (task_id, user_id, body, external_id)
VALUES (42, 5, 'Hello', 'webhook_001')
ON CONFLICT (task_id, external_id) DO NOTHING;

-- Hanh vi B -- merge gia tri moi khi trung:
INSERT INTO comments (task_id, user_id, body, external_id)
VALUES (42, 5, 'Updated body', 'webhook_001')
ON CONFLICT (task_id, external_id) DO UPDATE
SET body = EXCLUDED.body;
-- EXCLUDED.<col> = gia tri ban dinh INSERT (input bi tu choi vi trung)
EXCLUDED (trong dialect PostgreSQL/SQLite) là "row đáng lẽ được INSERT" — các giá trị bạn truyền vào VALUES(...). MySQL biểu đạt ý tương đương bằng cú pháp khác (mục 5). Để truy cập giá trị hiện tại của row trong bảng, dùng tên bảng: comments.body.
UPSERT cần một khoá nhận dạng trùng — và đó phải là UNIQUE constraint hoặc PRIMARY KEY. Nó không kích hoạt trên CHECK constraint hay foreign key violation: nếu input vi phạm CHECK (price > 0), UPSERT vẫn crash bình thường vì đó không phải "khoá trùng". Đây là nguyên lý chung mọi dialect; muốn xử lý conflict trên ràng buộc khác phải validate trước hoặc dùng MERGE với điều kiện tường minh.
5. Landscape dialect — cùng ý tưởng, ba cú pháp
Đây là điểm khiến UPSERT đáng học kỹ: không có cú pháp UPSERT chung giữa các RDBMS. Cùng một bài toán, ba cách viết khác nhau.
-- ============ PostgreSQL / SQLite ============
-- INSERT ... ON CONFLICT (<cols>) DO NOTHING | DO UPDATE
INSERT INTO products (sku, name, price)
VALUES ('SKU-1', 'Widget', 9.99)
ON CONFLICT (sku) DO UPDATE
  SET name  = EXCLUDED.name,
      price = EXCLUDED.price;
-- EXCLUDED = row dinh insert; products.<col> = row hien tai trong bang


-- ============ MySQL / MariaDB ============
-- INSERT ... ON DUPLICATE KEY UPDATE
INSERT INTO products (sku, name, price)
VALUES ('SKU-1', 'Widget', 9.99)
ON DUPLICATE KEY UPDATE
  name  = VALUES(name),      -- VALUES(col): gia tri input (MySQL cu)
  price = VALUES(price);
-- MySQL 8.0.19+ khuyen dung alias thay cho VALUES():
-- INSERT ... AS new ON DUPLICATE KEY UPDATE name = new.name, ...


-- ============ Chuan SQL (Oracle, SQL Server, Db2, PG 15+, MySQL 8.0.31+) ============
-- MERGE -- xem bai 06 cua module nay de biet cu phap day du
MERGE INTO products t
USING (SELECT 'SKU-1' AS sku, 'Widget' AS name, 9.99 AS price) s
  ON t.sku = s.sku
WHEN MATCHED THEN
  UPDATE SET name = s.name, price = s.price
WHEN NOT MATCHED THEN
  INSERT (sku, name, price) VALUES (s.sku, s.name, s.price);
Ba khác biệt cần nhớ (không thiên vị engine nào — đây là bản đồ để định hướng):
| Khía cạnh | ON CONFLICT (PostgreSQL/SQLite) | ON DUPLICATE KEY UPDATE (MySQL) | MERGE (chuẩn SQL) |
|---|---|---|---|
| Chỉ định khoá trùng | Tường minh (cols) hoặc tên constraint | Ngầm — bất kỳ UNIQUE/PK nào bị trùng | Điều kiện ON tuỳ ý |
| Tham chiếu input | EXCLUDED.<col> | VALUES(col) / alias (MySQL 8.0.19+) | s.<col> (source) |
| Hành vi "bỏ qua" | DO NOTHING | ON DUPLICATE KEY UPDATE col = col (no-op) | WHEN MATCHED THEN ... (bỏ clause) |
| DELETE khi trùng? | Không | Không | Có (WHEN MATCHED THEN DELETE) |
| Nhiều rule điều kiện? | Một action | Một action | Nhiều WHEN (xem bài 06) |
ON CONFLICT (sku) của PostgreSQL chỉ kích hoạt khi trùng đúng khoá sku bạn chỉ định. Còn ON DUPLICATE KEY UPDATE của MySQL kích hoạt khi trùng bất kỳ UNIQUE/PK nào trên bảng. Nếu bảng có 2 unique key (vd sku và barcode), một INSERT trùng barcode cũng trigger UPDATE — có thể update nhầm row bạn không định. Khi viết portable, ý thức rõ "mình đang dedupe theo khoá nào" và thiết kế constraint cho khớp ý định.
6. MERGE — cách chuẩn, nhưng cân nhắc khi nào dùng
MERGE (chuẩn SQL:2003) là cách chuẩn hoá cho bài toán insert-hoặc-update, và mạnh hơn UPSERT đơn: nó cho nhiều WHEN clause, điều kiện join tuỳ ý, và cả DELETE. Nhưng "chuẩn và mạnh hơn" không có nghĩa "luôn nên dùng".
| Nên dùng | Khi nào |
|---|---|
UPSERT đơn (ON CONFLICT / ON DUPLICATE KEY) | Bài toán đơn giản "insert hoặc update theo 1 khoá" — ngắn gọn, đủ cho ~90% trường hợp ingestion idempotent |
MERGE | Cần đồng thời INSERT + UPDATE + DELETE, hoặc nhiều rule điều kiện (vd ETL multi-rule sync, slowly-changing dimension) |
Quy tắc thực tế: bắt đầu bằng UPSERT đơn; chỉ chuyển sang MERGE khi thực sự cần DELETE hoặc nhiều rule. MERGE còn có những cạm bẫy riêng (duplicate source gây lỗi, concurrent serialization) — toàn bộ cú pháp WHEN, demo ETL, và pitfall của MERGE được mổ kỹ ở bài 06 — MERGE statement. Bài này cố ý không lặp lại deep-dive đó; ở đây MERGE chỉ là một góc của landscape để bạn biết nó tồn tại và đứng ở đâu.
7. Applied — 3 pattern thường gặp
-- 1) Idempotent webhook handler -- "ensure exists", bo qua khi trung
--    PostgreSQL/SQLite:
INSERT INTO events (external_id, payload, received_at)
VALUES ('evt_001', '{}', CURRENT_TIMESTAMP)
ON CONFLICT (external_id) DO NOTHING;
--    MySQL tuong duong: INSERT IGNORE INTO events (...) VALUES (...);
--    hoac ON DUPLICATE KEY UPDATE external_id = external_id;
-- Giao 10 lan hay 1 lan, DB chi giu 1 ban -- idempotent


-- 2) Counter increment atomic -- merge, doc-ghi trong 1 statement
--    PostgreSQL/SQLite:
INSERT INTO page_views (page, view_count)
VALUES ('/dashboard', 1)
ON CONFLICT (page) DO UPDATE
  SET view_count = page_views.view_count + 1;
--    MySQL: ON DUPLICATE KEY UPDATE view_count = view_count + 1;
-- Atomic per row -- khong co race giua 2 concurrent request,
-- khong can SELECT-then-UPDATE


-- 3) Sync gia tri moi nhat tu external source -- merge co dieu kien
--    Chi ghi khi gia tri thuc su thay doi (giam write thua):
INSERT INTO products (sku, name, price)
VALUES ('SKU-1', 'Widget', 9.99)
ON CONFLICT (sku) DO UPDATE
  SET name = EXCLUDED.name, price = EXCLUDED.price
WHERE products.price IS DISTINCT FROM EXCLUDED.price
   OR products.name  IS DISTINCT FROM EXCLUDED.name;
-- IS DISTINCT FROM xu ly NULL dung: NULL IS DISTINCT FROM 'x' = TRUE,
-- NULL IS DISTINCT FROM NULL = FALSE -- tranh bug "!= NULL = UNKNOWN"
Một số engine cho lấy lại row vừa ghi ngay trong câu UPSERT: PostgreSQL/SQLite có RETURNING, MySQL 8.0.21+ có cú pháp riêng hạn chế hơn. RETURNING không thuộc chuẩn SQL cốt lõi — đừng phụ thuộc khi viết portable. Khi cần biết "vừa insert hay update", cách portable nhất là so sánh created_at = updated_at (bằng nhau → vừa tạo) thay vì dựa vào system column hay clause đặc thù engine.
8. Pitfall — 3 lỗi phổ biến
Pitfall 1 — Tưởng UPSERT bắt mọi loại lỗi. UPSERT chỉ xử lý trùng UNIQUE/PRIMARY KEY. CHECK violation, foreign-key violation, hay type error vẫn crash như thường. Đừng dùng UPSERT thay cho input validation.
-- CHECK (price > 0); UPSERT KHONG cuu duoc:
INSERT INTO products (sku, price) VALUES ('SKU-1', -5)
ON CONFLICT (sku) DO NOTHING;
-- ERROR: vi pham check constraint -- ON CONFLICT chi match UNIQUE/PK
-- Fix: validate input truoc, hoac MERGE voi dieu kien tuong minh
Pitfall 2 — SELECT-then-UPDATE thay cho UPSERT (race / lost update). Tách "đọc" và "ghi" thành hai round-trip mở ra cửa sổ race:
Session A: SELECT view_count -> 100
Session B: SELECT view_count -> 100
Session A: UPDATE SET view_count = 101
Session B: UPDATE SET view_count = 101   <- mat 1 increment (lost update)
Fix: giữ toàn bộ compute trong một UPSERT statement (view_count = view_count + 1) — atomic per row.
Pitfall 3 — Giả định cú pháp portable. Code dùng ON CONFLICT sẽ không chạy trên MySQL; code dùng ON DUPLICATE KEY UPDATE không chạy trên PostgreSQL. Cú pháp UPSERT là vùng dialect rõ rệt nhất trong SQL hằng ngày. Nếu cần portable: hoặc dùng MERGE (engine có hỗ trợ), hoặc tách lớp truy cập dữ liệu theo engine, hoặc dùng query builder/ORM trừu tượng hoá cú pháp.
9. Deep Dive
- Markus Winand — "ON CONFLICT / UPSERT" (modern-sql.com) — so sánh agnostic các cách viết UPSERT (
MERGEchuẩn,ON CONFLICT,ON DUPLICATE KEY) với bảng mức hỗ trợ qua engine. Nguồn tốt nhất để thấy "cùng bài toán, ba cú pháp" một cách trung lập. - Wikipedia — "Merge (SQL)" — tóm tắt lịch sử
MERGEtrong SQL:2003 và cách từng RDBMS hiện thực UPSERT (gồmREPLACE,INSERT OR REPLACE,ON DUPLICATE KEY). Bối cảnh tốt để hiểu vì sao landscape phân mảnh. - Tài liệu engine bạn dùng cho cú pháp + semantic chính xác: PostgreSQL/SQLite
INSERT ... ON CONFLICT, MySQLINSERT ... ON DUPLICATE KEY UPDATE(và khác biệtVALUES()vs alias), hoặcMERGEcủa Oracle/SQL Server/Db2 — đối chiếu khi triển khai trên engine cụ thể.
10. Tóm tắt
- UPSERT = INSERT nếu chưa có, UPDATE (hoặc bỏ qua) nếu trùng khoá. Giải bài idempotent write trong một câu lệnh, không cần
try/catchquanh INSERT trong app. - Vấn đề gốc là race insert-or-update: pattern SELECT-rồi-INSERT/UPDATE có cửa sổ race giữa đọc và ghi → crash unique hoặc lost update. UPSERT gộp "kiểm tra trùng" và "ghi" vào một statement, atomic per row.
- Atomic per row, không phải multi-row compute: counter increment trong UPSERT là an toàn concurrent; logic đọc-nhiều-row-rồi-ghi cần transaction (Module 7).
- Chỉ match UNIQUE / PRIMARY KEY — không kích hoạt trên CHECK/FK violation. UPSERT không thay được input validation.
- Hai hành vi khi trùng: bỏ qua (idempotent "ensure exists") hoặc merge (ghi đè giá trị mới). Dùng
IS DISTINCT FROMđể chỉ ghi khi giá trị thực sự đổi (xử lý NULL đúng). - Landscape dialect (không thiên vị): chuẩn SQL =
MERGE; PostgreSQL/SQLite =INSERT ... ON CONFLICT ... DO UPDATE; MySQL =INSERT ... ON DUPLICATE KEY UPDATE. Cú pháp không portable — đây là vùng dễ vấp nhất khi đổi engine. - MERGE là cách chuẩn và mạnh hơn (đa rule + DELETE) nhưng chỉ cần khi thật sự phải DELETE hoặc nhiều rule — bắt đầu bằng UPSERT đơn. Deep-dive cú pháp MERGE ở bài 06.
11. Liên hệ các bài khác
- Bài 06 — MERGE statement: cách chuẩn SQL cho insert-hoặc-update, mạnh hơn UPSERT đơn (đa
WHENclause + DELETE). Đọc khi bài toán vượt "1 khoá, 1 action" — ETL multi-rule sync, slowly-changing dimension. - Bài 01 — Subquery, CTE, LATERAL: UPSERT thường nhận data từ
INSERT ... SELECT(sync nhiều row một lần) — kết hợp với CTE để chuẩn bị/dedupe source trước khi ghi. - Bài 07 — Mini-challenge: burndown chart: dùng UPSERT để refresh snapshot incremental idempotent — cron chạy lại nhiều lần vẫn cho kết quả đúng.
- Isolation level và 4 anomaly: UPSERT atomic per row; khi cần atomic cho logic đọc-nhiều-row-rồi-ghi, đó là việc của transaction + isolation level — bài đó giải thích lost update, write skew và cách từng level ngăn (hoặc không ngăn) chúng.
12. Tự kiểm tra
- Q1Vì sao pattern SELECT-rồi-INSERT trong app code có race condition, còn UPSERT thì không? Mô tả cơ chế khiến UPSERT atomic.
- Q2Cùng bài toán 'insert sản phẩm, nếu trùng sku thì cập nhật giá', viết bằng dialect PostgreSQL và dialect MySQL. Vì sao không thể copy code này giữa hai engine?
- Q3MERGE là cách chuẩn SQL và mạnh hơn UPSERT đơn. Vậy vì sao bài này khuyên 'bắt đầu bằng UPSERT đơn, chỉ chuyển sang MERGE khi cần'? Khi nào thật sự cần MERGE?
- Q4Trong pattern sync 'chỉ ghi khi giá trị thực sự thay đổi', vì sao dùng `IS DISTINCT FROM` thay cho `!=`? Cho ví dụ với NULL.
- Q5UPSERT chỉ kích hoạt trên trùng UNIQUE/PRIMARY KEY. Một INSERT vi phạm `CHECK (price > 0)` thì UPSERT làm gì? Hệ quả thiết kế là gì?
- Q6MySQL `ON DUPLICATE KEY UPDATE` và PostgreSQL `ON CONFLICT (sku)` khác nhau ở cách xác định 'khoá trùng' như thế nào? Vì sao khác biệt này có thể gây update nhầm row?
Bài tiếp theo: MERGE statement — insert/update/delete trong một câu lệnh
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên