SELECT — projection + alias, vì sao SELECT * chậm gấp 17 lần
Projection ở executor layer + network/serialization overhead. Cú pháp column list, expression, alias. Vì sao Prisma select() và Spring @Query đều chọn explicit column.
TL;DR: SELECT * trả về mọi column của row; SELECT id, title chỉ trả về hai column. Cùng một row được tìm qua index lookup, sự khác biệt về tốc độ không nằm ở disk I/O mà nằm ở hai bước sau: serialize từng cell sang binary protocol và gửi qua network. Column ít = byte ít = nhanh hơn. Bốn lý do production code luôn dùng explicit column list: schema fragile, N+1 amplification, covering index miss, sensitive data leak.
Cùng query trên bảng tasks 100k row của TaskFlow — SELECT * FROM tasks WHERE id=42 mất 200ms. SELECT id, title FROM tasks WHERE id=42 mất 12ms. Cùng một row được trả về, khác ở chỗ query chọn bao nhiêu column — chênh nhau 17 lần. Nếu disk I/O không phải nguyên nhân (cả hai query đều tìm đúng một row bằng primary key index), thì vì sao?
Bài này giải thích cơ chế projection diễn ra ở executor layer, cost thực sự nằm ở network và serialization, cú pháp đầy đủ của SELECT (column list, expression, alias), và vì sao mọi ORM — Prisma, Spring Data JPA, SQLAlchemy — đều đặt explicit column là best practice.
1. Analogy — Lấy hàng từ kho
Hình dung kho hàng với mỗi sản phẩm được đóng trong thùng lớn gồm 50 ngăn. Bạn chỉ cần lấy 2 món: nhãn sản phẩm và giá. Có hai cách:
Cách A: Lấy cả thùng ra xe tải, chở về kho phân phối, mở ra, lấy 2 món cần, bỏ 48 món còn lại.
Cách B: Mở thùng tại chỗ, lấy đúng 2 món, để lại 48 món trong kho.
Cách A tốn xe tải to hơn, tốn thời gian bốc dỡ, tốn không gian tạm chứa — dù kết quả cuối cùng giống nhau.
| Lấy hàng từ kho | SELECT |
|---|---|
| Lấy cả thùng (mọi món) | SELECT * |
| Chỉ lấy 2 món cần | SELECT id, title |
| Tốn xe tải lớn hơn | Network bandwidth — nhiều byte hơn trên dây |
| Tốn thời gian bốc dỡ tại kho phân phối | Serialization — database convert mọi cell sang binary protocol |
| Khó kiểm hàng khi danh sách thay đổi | App fragile khi schema thêm column mới |
| Nhận đồ trộn lẫn — phải phân loại sau | Deserialize tất cả rồi app mới biết cần gì |
| Chuẩn bị danh sách trước khi vào kho | Explicit column list = predictable cost |
SELECT * = lấy cả thùng. SELECT id, title = lấy đúng 2 món. Cost không nằm ở việc tìm thùng (disk I/O) — cost nằm ở chở thùng về (network) và phân loại lại (serialization).
2. Cơ chế projection — diễn ra ở đâu
Hệ quản trị xử lý query theo pipeline. Với SELECT id, title FROM tasks WHERE id=42:
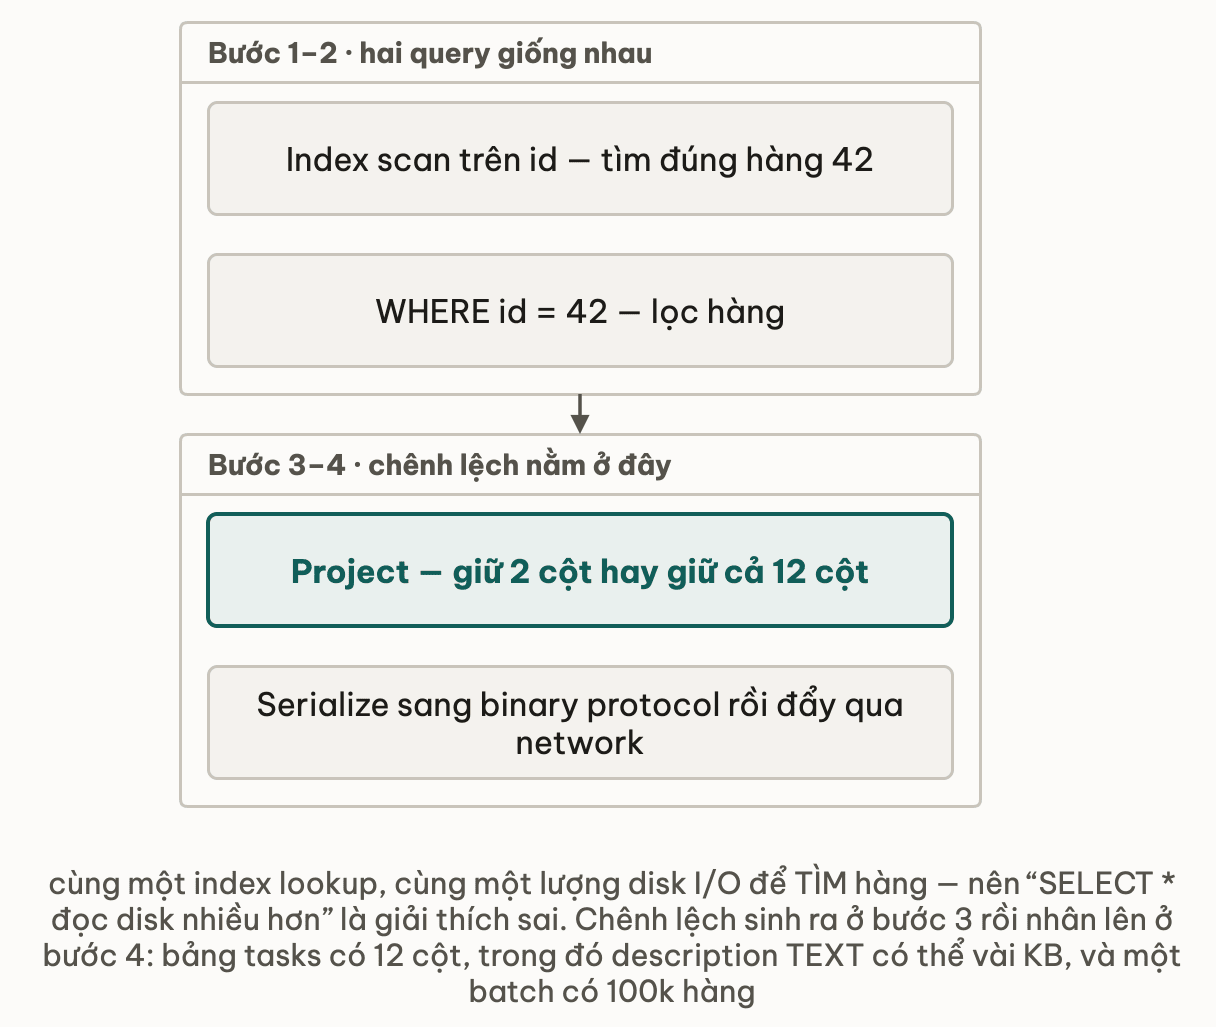
Projection diễn ra ở bước 3 — sau khi scan và filter xong. Vì vậy:
SELECT *vàSELECT id, titleđọc cùng lượng disk I/O để tìm row (cùng index lookup trênid).- Sự khác biệt nằm ở bước 3 và 4: project giữ bao nhiêu column → serialize bao nhiêu byte → gửi bao nhiêu qua network.
Với bảng tasks có 12 column (bao gồm description TEXT có thể chứa vài KB), SELECT * có thể trả về row nặng hơn SELECT id, title hàng chục lần. Multiply với 100k row trong một batch query — chênh lệch rõ ràng.
Hầu hết hệ quản trị cung cấp công cụ xem kế hoạch thực thi (execution plan) để kiểm tra số byte trung bình mỗi row (width) được trả về — ví dụ EXPLAIN trong SQL Server / PostgreSQL, EXPLAIN hoặc DESCRIBE trong MySQL. Bài Module 6 — Storage & indexing sẽ giới thiệu cách đọc execution plan.
Thử ngẫmbảng tasks của bạn thêm cột attachments_blob nặng vài trăm KB. Query cũ dùng SELECT * chậm đi ở bước nào trong bốn bước trên, và bước tìm row bằng index có bị ảnh hưởng không?
3. Cú pháp đầy đủ
-- 1. Column list explicit (best practice cho app code)
SELECT id, title, status FROM tasks;

-- 2. Toan bo column -- dung cho exploration, khong dung trong app code
SELECT * FROM tasks;

-- 3. Expression trong SELECT -- tinh toan gia tri tu column
SELECT
    id,
    UPPER(title)                                        AS title_upper,
    EXTRACT(EPOCH FROM (CURRENT_TIMESTAMP - created_at)) AS age_seconds,
    CASE WHEN status = 'done' THEN 1 ELSE 0 END         AS is_done_int
FROM tasks;

-- 4. Alias -- doi ten column trong output
SELECT
    id          AS task_id,
    title       AS "Tieu de"   -- quote khi alias co space hoac trung keyword
FROM tasks;

-- 5. SELECT khong tu table -- constant query, ham utility
SELECT 1 + 1 AS sum, CURRENT_TIMESTAMP AS current_time;
Column trong SELECT list có thể là:
- Tên column trực tiếp:
id,title - Expression:
UPPER(title),salary * 12,CASE WHEN status = 'done' THEN 1 ELSE 0 END - Constant:
1,'hello',true - Function call:
CURRENT_TIMESTAMP,LENGTH(title),COALESCE(assignee_id, 0)
4. Alias — quy tắc và pitfall
Alias với AS:
SELECT
    id          AS task_id,          -- doi ten column trong output
    title       AS task_title,
    status      AS current_status
FROM tasks;
AS là optional — SELECT id task_id cũng hoạt động — nhưng nên viết explicit để code dễ đọc.
Quote alias khi cần:
SELECT
    title       AS "Tieu de cong viec",  -- co space -> phai quote
    status      AS "order"               -- 'order' la keyword -> nen quote
FROM tasks;
Alias không được quote: hầu hết hệ quản trị tự lowercase (TaskId thành taskid). Alias được quote: preserve case chính xác.
Alias không dùng được trong WHERE cùng query:
-- SAI: alias annual_salary chua ton tai khi WHERE duoc tinh
SELECT salary * 12 AS annual_salary
FROM employees
WHERE annual_salary > 100000;
-- ERROR: column "annual_salary" does not exist
Lý do: thứ tự xử lý của SQL engine là FROM → WHERE → SELECT → ORDER BY. Alias trong SELECT chỉ tồn tại sau khi SELECT clause được evaluate — tức là sau khi WHERE đã chạy xong. Hai cách fix:
-- Fix 1: lap lai expression trong WHERE
SELECT salary * 12 AS annual_salary
FROM employees
WHERE salary * 12 > 100000;

-- Fix 2: wrap subquery (hoac CTE -- Module 4 cua khoa nay)
SELECT *
FROM (
    SELECT *, salary * 12 AS annual_salary FROM employees
) sub
WHERE annual_salary > 100000;
WHERE annual_salary > 100000 sau SELECT salary * 12 AS annual_salary luôn báo lỗi "column does not exist". SQL engine chạy WHERE trước SELECT — alias chưa tồn tại tại thời điểm WHERE được evaluate. Fix: lặp lại expression trong WHERE, hoặc dùng subquery/CTE.
Thử ngẫmORDER BY annual_salary (thay vì WHERE) trên cùng câu SELECT có báo lỗi tương tự không? Thứ tự xử lý FROM → WHERE → SELECT → ORDER BY trả lời câu này thế nào?
5. Vì sao SELECT * có hại trong production
Bốn lý do thực tế:
1. Schema fragile:
-- Schema hom nay: users(id, email, name, created_at)
SELECT * FROM users;  -- tra ve 4 column

-- Sau khi DBA them column: users(id, email, name, created_at, last_login_at, is_active, ...)
SELECT * FROM users;  -- dot nhien tra ve 7 column
-- App code parse theo thu tu column truoc -> parse sai hoac broken
Explicit column list không bị ảnh hưởng khi schema thêm column — chỉ trả về đúng những gì đã khai báo.
2. N+1 amplification:
Với lazy load ORM + SELECT *, mỗi entity fetch 50 column thay vì 5 column cần dùng. Multiply với 1000 entity trong một request — memory và network sử dụng gấp 10 lần không cần thiết.
3. Covering index miss:
Khi tất cả column cần thiết đã có trong index (covering index), hệ quản trị có thể trả về kết quả từ index mà không cần đọc bảng chính. SELECT * phá vỡ optimization này vì index không bao giờ chứa mọi column — database phải hit bảng mỗi row. Module 6 — Storage & indexing sẽ phân tích covering index chi tiết.
4. Sensitive data leak:
SELECT * FROM users trả về cả password_hash, reset_token, payment_info — dù API endpoint chỉ cần id và email. Nếu code serialize toàn bộ query result thành JSON response, sensitive column bị expose mà không ai để ý. Explicit column list là lớp bảo vệ đầu tiên, đơn giản nhất.
6. Khi nào SELECT * vẫn ổn
SELECT * không phải lúc nào cũng sai — context quyết định:
| Context | SELECT * có ổn không? | Lý do |
|---|---|---|
Ad-hoc exploration trong SQL client (LIMIT 5) | Ổn | Không phải app code |
| Migration script chuyển full table | Ổn | Cần tất cả column để copy |
| Backup script | Ổn | Export toàn bộ dữ liệu |
| View definition | Thường ổn | View là alias, không phải app code |
| Production app code (REST API, service) | Không ổn | Schema fragile + performance + security |
| ORM findMany() không có select | Không ổn | Tương đương SELECT * |
Pattern ngắn gọn: production app code = explicit column. SQL client/migration/exploration = SELECT * ổn.
Thử ngẫmview active_tasks của bạn định nghĩa bằng SELECT *, rồi một service khác query lại SELECT * FROM active_tasks trong route handler. View còn nằm ở hàng "thường ổn" nữa không?
7. Applied — ORM convention
Lý do explicit column là best practice lan rộng sang mọi ORM:
Prisma:
// KHONG tot -- tuong duong SELECT *
const tasks = await prisma.task.findMany();

// Tot -- explicit column, type-safe, generated types match
const tasks = await prisma.task.findMany({
  select: {
    id: true,
    title: true,
    status: true,
  },
});
// tasks co kieu: { id: bigint; title: string; status: string }[]
Prisma select generate type narrowed — TypeScript biết chính xác những field nào có trong kết quả. Thêm select: { passwordHash: true } thì type tự xuất hiện — không thêm thì không có trong type, không thể truy cập nhầm.
Spring Data JPA:
// JPQL explicit column -- DTO projection
@Query("SELECT u.id, u.email FROM User u WHERE u.isActive = true")
List<Object[]> findActiveUserProjection();

// Hoac dung DTO projection interface (Spring Data 2.x+)
public interface UserSummary {
    Long getId();
    String getEmail();
}
List<UserSummary> findByIsActive(boolean isActive);
node-postgres:
// Explicit column -- an toan va ro rang ve intent
const { rows } = await pool.query(
  'SELECT id, title, status FROM tasks WHERE assignee_id = $1',
  [userId]
);
SQLAlchemy:
# Explicit column projection
results = session.query(User.id, User.email).filter(User.is_active == True).all()
# Khong: session.query(User).all()  -- equivalent SELECT *
Mọi ORM đều có cơ chế explicit projection vì lý do giống nhau: giảm byte truyền qua wire, tránh schema fragile, và tránh leak dữ liệu nhạy cảm qua serialization tự động.
8. Deep Dive — SELECT execution
- SQL SELECT statement — Wikipedia overview — cú pháp SELECT đầy đủ theo chuẩn ANSI SQL, projection rules, và so sánh hành vi giữa các hệ quản trị. Đọc phần "Syntax" và "Column aliases".
- Use The Index, Luke — "Index-Only Scan" — giải thích tại sao
SELECT *phá vỡ covering index optimization và index-only scan. Agnostic giữa các RDBMS. Đọc khi học Module 6 — Storage & indexing để thấy connection rõ hơn. - PostgreSQL Documentation — Frontend/Backend Protocol — chi tiết format binary wire protocol của PostgreSQL, cách mỗi column được serialize. Đây là tài liệu engine-specific; đọc khi muốn hiểu sâu tại sao số byte per row ảnh hưởng đến latency trên PostgreSQL — không bắt buộc cho phần lớn ứng dụng.
Ghi chú: Wikipedia cho cú pháp chuẩn agnostic; Use The Index Luke cho perf rationale; PG protocol chỉ khi dùng PostgreSQL và muốn deep optimization.
9. Liên hệ các bài khác
- Bài 02 — WHERE + NULL three-valued logic: WHERE clause lọc row trước khi projection diễn ra — hiểu thứ tự xử lý (FROM → WHERE → SELECT) giải thích vì sao alias không dùng được trong WHERE.
- Bài 03 — ORDER BY + pagination: sau khi projection, số column ảnh hưởng đến chi phí serialize mỗi page — explicit column đặc biệt quan trọng khi fetch nhiều page.
- Module 6 — Storage & indexing: covering index — khi mọi column cần thiết đã có trong index, hệ quản trị không cần đọc bảng chính;
SELECT *phá vỡ optimization này. - Module 4 — SQL nâng cao: CTE là cách portable để dùng alias trong WHERE — pattern fix thứ hai cho pitfall alias.
10. Tóm tắt
- Projection chạy ở executor layer — sau scan và WHERE filter, trước serialize/network.
- Cost chính nằm ở network và serialization, không phải disk I/O — lý do
SELECT *vsSELECT id, titlechênh nhiều dù cùng row. - Cú pháp SELECT: column list, expression (UPPER, EXTRACT, cast), alias với
AS(quote khi có space hoặc reserved word). - Alias không dùng được trong WHERE cùng query — alias chưa tồn tại khi WHERE được evaluate. Fix: lặp lại expression hoặc dùng subquery/CTE.
SELECT *có 4 vấn đề production: schema fragile, N+1 amplification, covering index miss, sensitive data leak.SELECT *ổn trong: SQL client exploration, migration script, backup, view definition — không phải app code.- Mọi ORM đều reflect tư duy này: Prisma
select:{}, Spring DTO projection, SQLAlchemyquery(Model.col). - Forward links: Module 6 — Storage & indexing (covering index) + Module 4 — Subquery & CTE (subquery/CTE) của khoá này.
11. Tự kiểm tra
- Q1Vì sao SELECT * chậm hơn SELECT id, title dù cả hai đều tìm đúng một row bằng index lookup — disk I/O không tăng nhiều?
- Q2Phân biệt 4 trường hợp SELECT * ổn và ít nhất 4 trường hợp không ổn. Cho ví dụ cụ thể với TaskFlow.
- Q3Bạn viết `SELECT salary * 12 AS annual_salary FROM employees WHERE annual_salary > 100000` — error. Vì sao? Hai cách fix?
- Q4Prisma `select: { id: true, email: true }` thay vì `findMany()` tiết kiệm gì cụ thể? Đo bằng cách nào trong dự án thực?
- Q5Schema thay đổi: thêm column `last_login_at` vào bảng `users`. App code cũ `SELECT * FROM users` và `SELECT id, email FROM users` — cái nào bị ảnh hưởng và bị ảnh hưởng thế nào?
Bài tiếp theo: WHERE + NULL three-valued logic
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên