DISTINCT vs GROUP BY — cùng plan, khác intent
Cùng plan, khác intent: DISTINCT để dedupe, GROUP BY để aggregate. DISTINCT ON (PostgreSQL) giải 'top N per group' gọn; window function là alternative portable.
Hai query trả về cùng kết quả: SELECT DISTINCT user_id FROM tasks và SELECT user_id FROM tasks GROUP BY user_id. Chạy EXPLAIN cho cả hai — plan giống hệt: HashAggregate. Vậy khác gì nhau?
Bài này chỉ ra sự khác biệt là semantic intent chứ không phải hiệu năng, giải thích khi nào nên chọn cái nào, và giới thiệu DISTINCT ON — cú pháp PostgreSQL-specific giải bài "top N per group" trong một dòng mà không cần window function (kèm alternative portable cho các engine khác).
1. Analogy — "lấy danh sách" vs "gom nhóm để đếm"
Hình dung bảng chấm công: mỗi nhân viên có nhiều dòng ứng với nhiều ngày làm việc. Bạn cần hai thứ khác nhau:
Yêu cầu A: "Cho tôi danh sách nhân viên đã từng chấm công." Intent: loại bỏ trùng lặp.
Yêu cầu B: "Cho tôi số ngày làm việc của mỗi nhân viên." Intent: gom nhóm để tính tổng hợp.
| Bảng chấm công | SQL |
|---|---|
| Danh sách nhân viên không trùng | SELECT DISTINCT user_id |
| Số ngày làm mỗi nhân viên | SELECT user_id, COUNT(*) |
| Intent: dedupe | DISTINCT |
| Intent: aggregate | GROUP BY |
| Cùng kết quả khi chỉ lấy column group | Plan giống nhau: HashAggregate |
| Khác nhau khi cần tổng hợp | DISTINCT không làm được COUNT/SUM/AVG |
DISTINCT = "tôi chỉ muốn dedupe". GROUP BY = "tôi muốn gom nhóm để tính gì đó". Khi chỉ cần danh sách không trùng — DISTINCT nói lên intent rõ hơn. Khi cần số liệu tổng hợp — GROUP BY là lựa chọn duy nhất.
2. Cơ chế — DISTINCT vs GROUP BY
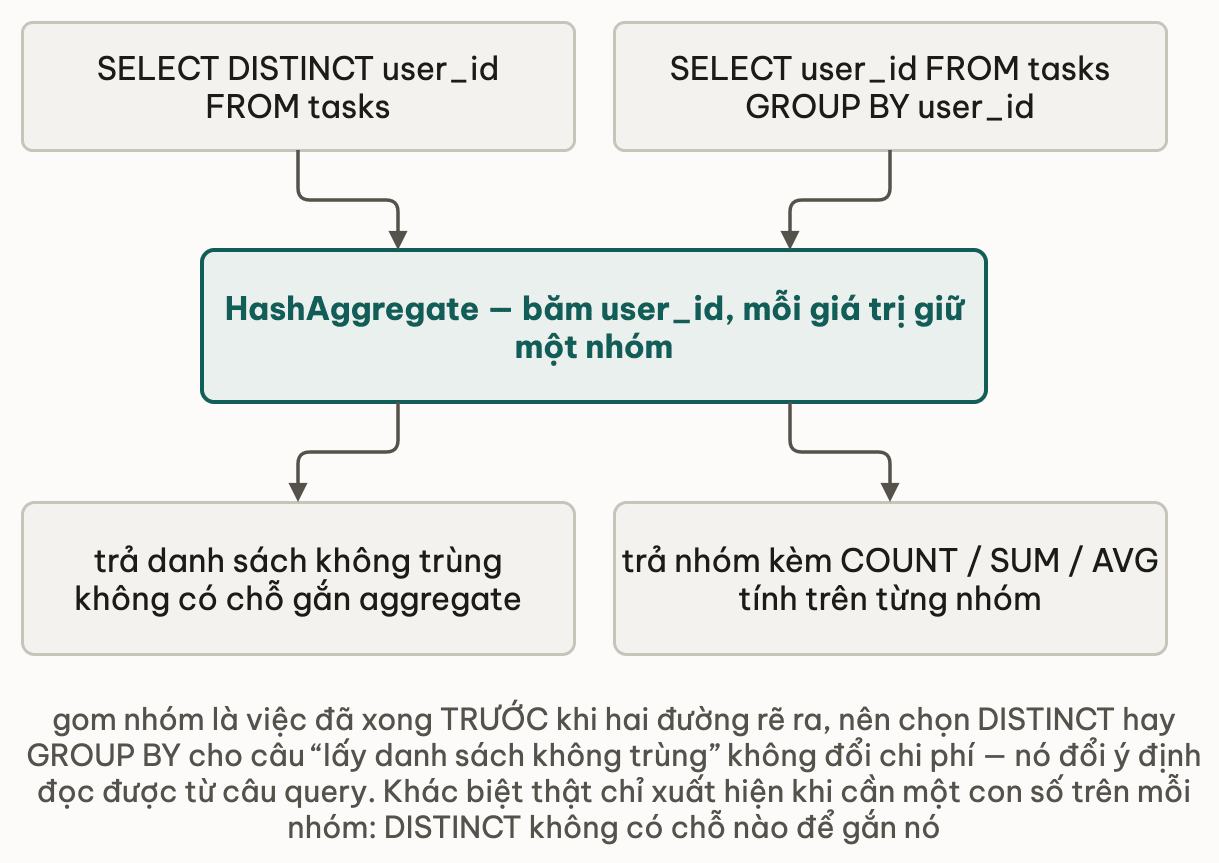
Hai câu query đi hai đường ở tầng cú pháp, nhưng ở tầng thực thi chúng gặp nhau tại đúng một node — và chỉ rẽ đôi ở bước cuối:
3. Cùng plan, khác intent
-- Ca hai query tra ve ket qua giong het nhau
SELECT DISTINCT user_id FROM tasks;
SELECT user_id FROM tasks GROUP BY user_id;
Khi xem execution plan của cả hai query (dùng EXPLAIN hoặc công cụ tương đương trên engine của bạn), plan thường giống hệt nhau — hệ quản trị biến DISTINCT col thành cùng một phép toán gom nhóm với GROUP BY col. Ví dụ trên PostgreSQL:
-- Ca hai deu cho plan: HashAggregate (Group Key: user_id) -> Seq Scan
EXPLAIN SELECT DISTINCT user_id FROM tasks;
EXPLAIN SELECT user_id FROM tasks GROUP BY user_id;
-- Cost giong nhau -- chi khac semantic intent khi doc code
Hệ quản trị nhận ra rằng dedupe (loại trùng) và group-then-return-key là cùng một phép toán — cả hai đều cần gom các row có cùng giá trị lại và giữ một đại diện. Cost giống nhau, execution plan giống nhau.
Sự khác biệt nằm ở readability và extensibility:
- Dùng
DISTINCTkhi chỉ cần dedupe một hoặc vài column — intent rõ ràng cho người đọc code. - Dùng
GROUP BYkhi cần aggregate (COUNT,SUM,AVG) hoặc filter sau aggregate (HAVING).
Demo bắt buộc dùng GROUP BY khi thêm aggregate:
-- DISTINCT khong the lam duoc dieu nay
SELECT user_id, COUNT(*) AS task_count FROM tasks GROUP BY user_id;

-- Loi neu co gang them aggregate vao DISTINCT
-- ERROR: aggregate functions are not allowed in DISTINCT ON expressions
Thử ngẫmmột PR review thấy đồng nghiệp đổi GROUP BY user_id sang DISTINCT user_id mà vẫn giữ nguyên COUNT(*) trong SELECT. Code đó chạy được không, và nếu không thì lỗi rơi vào lúc nào?
4. DISTINCT ON — cú pháp PostgreSQL cho "top N per group"
Bài toán: "lấy task gần nhất của mỗi user". Giải pháp portable là window function (Module 3 — JOIN, aggregation & window sẽ đi sâu). Với PostgreSQL, có cách ngắn hơn: DISTINCT ON.
-- Lay task moi nhat cho moi user
SELECT DISTINCT ON (assignee_id) *
FROM tasks
WHERE assignee_id IS NOT NULL
ORDER BY assignee_id, created_at DESC;
Cú pháp: DISTINCT ON (col1, col2) * giữ lại row đầu tiên trong mỗi nhóm unique theo col1, col2 — theo thứ tự ORDER BY quyết định row nào là "đầu tiên".
Quan trọng: column trong DISTINCT ON (...) phải là leftmost prefix của ORDER BY. Nếu DISTINCT ON (assignee_id) thì ORDER BY phải bắt đầu bằng assignee_id.
Tương đương với window function (verbose hơn nhiều):
-- Window function equivalent -- dai hon nhung portable sang MySQL/SQLite
SELECT * FROM (
  SELECT *,
    ROW_NUMBER() OVER (PARTITION BY assignee_id ORDER BY created_at DESC) AS rn
  FROM tasks
  WHERE assignee_id IS NOT NULL
) sub
WHERE rn = 1;
DISTINCT ON ngắn hơn và planner thường tối ưu tốt hơn cho case đơn giản vì có thể tận dụng composite index trên (assignee_id, created_at DESC).
Hạn chế: DISTINCT ON chỉ có trong PostgreSQL. MySQL, SQLite, SQL Server không hỗ trợ — phải dùng window function khi cần portable.
5. Pitfall — DISTINCT * trên large table
SELECT DISTINCT * FROM tasks phải sort hoặc hash toàn bộ bảng để tìm duplicate — chi phí O(N log N). Trên bảng 5 triệu row, query này mất nhiều giây. Quan trọng hơn: khi bạn thấy mình cần DISTINCT *, đó thường là dấu hiệu JOIN sai tạo ra Cartesian product thay vì vấn đề thực sự cần dedupe.
Ví dụ anti-pattern kinh điển:
-- ANTI-PATTERN: dung DISTINCT de hide JOIN bug
-- Implicit cross join: moi user ghep voi moi task -> duplicate
SELECT DISTINCT u.*
FROM users u, tasks t
WHERE u.id = t.assignee_id;

-- FIX: explicit JOIN, khong can DISTINCT
SELECT u.*
FROM users u
INNER JOIN tasks t ON u.id = t.assignee_id;
-- Van co the co duplicate neu user co nhieu task -- can DISTINCT hoac GROUP BY dung nghia
-- Fix hoan chinh:
SELECT DISTINCT u.*
FROM users u
INNER JOIN tasks t ON u.id = t.assignee_id;
-- Hoac:
SELECT u.* FROM users u WHERE EXISTS (
  SELECT 1 FROM tasks t WHERE t.assignee_id = u.id
);
Nguyên tắc: nếu bạn đang thêm DISTINCT để "fix" duplicate trong kết quả, hãy hỏi tại sao có duplicate trước — thường là JOIN condition thiếu hoặc sai.
Thử ngẫmTaskFlow deploy production đang có SELECT DISTINCT u.* sau users, tasks implicit join, và nó "chạy đúng" bao lâu nay. Điều gì khiến bạn vẫn nên sửa thay vì để yên?
6. GROUP BY — strict mode theo SQL chuẩn
SQL chuẩn (và hầu hết RDBMS hiện đại) yêu cầu mọi column trong SELECT list phải nằm trong GROUP BY clause hoặc được bọc trong aggregate function. MySQL trước 5.7 không enforce rule này — một nguồn gây bug khi migrate.
-- ERROR theo SQL chuan (PostgreSQL, SQL Server, SQLite strict mode...)
SELECT user_id, title FROM tasks GROUP BY user_id;
-- ERROR: column "tasks.title" must appear in the GROUP BY clause
--        or be used in an aggregate function

-- Fix 1: them title vao GROUP BY
SELECT user_id, title FROM tasks GROUP BY user_id, title;

-- Fix 2: dung aggregate function
-- STRING_AGG (PostgreSQL, SQL Server 2017+) hoac GROUP_CONCAT (MySQL/SQLite)
SELECT user_id, STRING_AGG(title, ', ') AS all_titles FROM tasks GROUP BY user_id;
MySQL trước 5.7 chạy thành công câu query lỗi trên nhưng trả về giá trị title ngẫu nhiên (không xác định row nào được chọn) — silent bug khó phát hiện. Hệ quản trị tuân thủ strict mode sẽ fail ngay tại parse time, đây là hành vi đúng đắn hơn.
Module 3 — JOIN, aggregation & window của khoá này sẽ đi sâu vào GROUP BY kết hợp HAVING và các visibility rule của aggregate.
7. Applied — TaskFlow scenarios
Ba tình huống thực tế cho thấy khi nào chọn gì:
-- Scenario 1: list user da tung comment trong project X
-- DISTINCT phu hop: chi can dedupe, khong can count
SELECT DISTINCT u.id, u.name
FROM users u
JOIN comments c ON c.user_id = u.id
JOIN tasks t ON t.id = c.task_id
WHERE t.project_id = 5;

-- Scenario 2: count so comment moi user trong project X
-- GROUP BY bat buoc: can aggregate COUNT
SELECT u.name, COUNT(c.id) AS comment_count
FROM users u
JOIN comments c ON c.user_id = u.id
JOIN tasks t ON t.id = c.task_id
WHERE t.project_id = 5
GROUP BY u.id, u.name
ORDER BY comment_count DESC;

-- Scenario 3: lay comment moi nhat cua moi user trong project X
-- DISTINCT ON elegant: top 1 per group
SELECT DISTINCT ON (user_id) user_id, body, created_at
FROM comments
WHERE task_id IN (SELECT id FROM tasks WHERE project_id = 5)
ORDER BY user_id, created_at DESC;
8. Deep Dive — DISTINCT semantics
- Use The Index, Luke — "Avoiding the DISTINCT Keyword" — tại sao
DISTINCT *thường là dấu hiệu JOIN sai và cách fix đúng. Agnostic giữa các RDBMS. - Modern SQL — Greatest-N-Per-Group — so sánh các pattern "top N per group": window function (portable),
DISTINCT ON(PostgreSQL), lateral join (PostgreSQL/MySQL 8+). Đọc khi cần chọn approach phù hợp với engine của bạn. - PostgreSQL Documentation 7.3.3 "DISTINCT" — cú pháp chính thức của
DISTINCTvàDISTINCT ONtrên PostgreSQL, bao gồm rule vềORDER BYprefix. Tham khảo khi dùng PostgreSQL.
Ghi chú: Use The Index Luke cho agnostic intuition về DISTINCT. Modern SQL cho cross-vendor pattern so sánh. PG docs khi cần cú pháp DISTINCT ON chính xác.
9. Liên hệ các bài khác
- Bài 02 — WHERE + NULL three-valued logic: NULL trong GROUP BY column — rows có giá trị NULL được gom thành một nhóm riêng, cùng nguyên lý NULL không bằng nhau.
- Bài 03 — ORDER BY + pagination: stable sort cần tiebreaker — cùng nguyên lý với GROUP BY cần xác định rõ column nào được chọn trong nhóm.
- Bài 05 — Pattern matching: DISTINCT thường xuất hiện cùng WHERE có LIKE — biết khi nào dùng DISTINCT vs EXISTS để tránh Cartesian product.
- Module 3 — JOIN, aggregation & window: GROUP BY + HAVING, window function thay thế DISTINCT ON khi cần portable — mở rộng trực tiếp từ bài này.
10. Tóm tắt
DISTINCTvàGROUP BYcó cùng plan (HashAggregate) khi chỉ dedupe một column — khác biệt là semantic intent, không phải performance.- Dùng
DISTINCTkhi chỉ cần danh sách không trùng, không cần tổng hợp số liệu — intent rõ ràng hơn cho người đọc code. - Dùng
GROUP BYkhi cần aggregate (COUNT,SUM,AVG) hoặc filter quaHAVING. DISTINCT ON (col)là PG-specific — giữ row đầu tiên mỗi nhóm theoORDER BY, giải bài "top N per group" ngắn gọn mà không cần window function. Column trongDISTINCT ONphải là leftmost prefix củaORDER BY.DISTINCT *thường là dấu hiệu JOIN sai — debug nguyên nhân duplicate thay vì patch bằngDISTINCT.- SQL strict mode: mọi column trong
SELECTphải nằm trongGROUP BYhoặc aggregate (SQL chuẩn, PostgreSQL, SQL Server, SQLite strict) — MySQL trước 5.7 lax, port sang engine strict sẽ fail. - Forward link: Module 3 — JOIN, aggregation & window sẽ đi sâu vào
GROUP BY+HAVING+ aggregate visibility rules, và window function thay thếDISTINCT ONkhi cần portable.
11. Tự kiểm tra
- Q1Vì sao query planner biến `SELECT DISTINCT col FROM table` thành cùng một phép toán gom nhóm như `GROUP BY col`? Implication gì về performance khi chọn giữa hai cách?
- Q2Phân biệt khi nào dùng DISTINCT vs GROUP BY. Cho 2 ví dụ TaskFlow cho mỗi loại.
- Q3Query
SELECT DISTINCT u.* FROM users u, tasks t WHERE u.id = t.assignee_idcó thể trả về duplicate dù có DISTINCT. Vì sao? Fix thế nào? - Q4Query
SELECT DISTINCT ON (assignee_id) * FROM tasks ORDER BY assignee_id, created_at DESC— tại sao column trong DISTINCT ON phải xuất hiện ở vị trí leftmost trong ORDER BY? - Q5Code MySQL `SELECT user_id, title FROM tasks GROUP BY user_id` chạy OK. Port sang engine strict (PostgreSQL, SQL Server) → error. Giải thích tại sao MySQL cho phép, engine strict không?
Bài tiếp theo: Pattern matching — vì sao LIKE '%x' kill index
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên