Thuật toán JOIN — nested loop, hash, merge
Một câu JOIN khai báo chạy bằng một trong ba thuật toán: nested loop, hash join, merge join. Cơ chế, độ phức tạp và khi nào planner chọn cái nào — nguyên lý agnostic.
TL;DR: Khi bạn viết JOIN, bạn chỉ khai báo điều kiện ghép — database tự chọn thuật toán thực thi. Có ba thuật toán chuẩn, phổ quát cho mọi RDBMS. Nested loop join: với mỗi dòng bảng ngoài, dò bảng trong; rẻ khi một bảng nhỏ hoặc bảng trong có index, đắt khi cả hai lớn (chi phí O(n*m)). Hash join: dựng bảng băm từ bảng nhỏ hơn rồi quét bảng kia dò vào; tối ưu cho điều kiện bằng nhau (equi-join) trên bảng lớn, không cần sort. Merge join: nếu cả hai input đã sắp xếp theo cột join, quét song song một lượt; tối ưu khi input sẵn sorted hoặc cần kết quả có thứ tự. Optimizer chọn cái rẻ nhất dựa trên kích thước bảng, index sẵn có và điều kiện join — đây là một quyết định lớn trong giai đoạn plan.
Một báo cáo join hai bảng orders (5 triệu dòng) và customers (200 nghìn dòng) chạy 40 giây. Dev thêm index lên cột join, chạy lại — vẫn 38 giây. Họ bối rối: index không giúp gì cho join sao? Vấn đề không nằm ở index mà ở thuật toán join optimizer chọn: với hai bảng lớn ghép theo điều kiện bằng nhau, nested loop (cần index) không phải lựa chọn tốt — hash join mới là. Sau khi optimizer chuyển sang hash join (nhờ đủ bộ nhớ làm việc), câu chạy còn 3 giây.
Mọi điều kiện JOIN đều giống nhau ở mức cú pháp, nhưng dưới nắp database có ba cách hoàn toàn khác để thực hiện. Hiểu ba thuật toán này giải thích vì sao cùng một join lúc nhanh lúc chậm, vì sao thêm index đôi khi vô ích, và vì sao tăng bộ nhớ lại cứu được query. Bài này mổ cơ chế từng thuật toán, độ phức tạp, và logic optimizer dùng để chọn — tất cả agnostic.
1. Analogy — Ba cách ghép hai chồng hồ sơ
Bạn có hai chồng hồ sơ cần ghép: chồng A (đơn hàng) và chồng B (khách hàng), ghép theo mã khách. Có ba cách:
- Cách quét lặp: cầm từng tờ ở chồng A, lật cả chồng B tìm tờ khớp mã. Nếu chồng B nhỏ (hoặc có thẻ phân loại để nhảy thẳng tới mã cần) thì nhanh; nếu cả hai chồng dày thì lật đi lật lại mệt nhoài.
- Cách lập bảng tra: dồn chồng nhỏ hơn (B) vào một hộp chia ngăn theo mã khách (mỗi ngăn một mã). Rồi cầm từng tờ A, nhìn mã, thò tay đúng ngăn lấy tờ B khớp — không phải lật cả chồng. Lập hộp tốn công ban đầu nhưng tra cực nhanh sau đó.
- Cách trộn đã xếp: nếu cả hai chồng đã được sắp theo mã khách, bạn đặt hai chồng cạnh nhau, đi từ trên xuống một lượt, hai ngón tay trượt song song, gặp mã bằng nhau thì ghép. Chỉ một lượt quét — nhưng đòi hỏi cả hai phải sắp trước.
| Ghép hồ sơ | Thuật toán join | Điều kiện thắng |
|---|---|---|
| Quét lặp từng tờ A qua cả chồng B | Nested loop | Một chồng nhỏ, hoặc có thẻ phân loại (index) |
| Dồn chồng nhỏ vào hộp chia ngăn rồi tra | Hash join | Ghép theo mã bằng nhau, hai chồng lớn |
| Trộn hai chồng đã xếp, trượt song song | Merge join | Cả hai đã sắp theo mã join |
Nested loop = lật từng tờ qua cả chồng kia (nhỏ/có index mới đáng). Hash = lập hộp chia ngăn rồi tra (lớn, ghép bằng nhau). Merge = trộn hai chồng đã xếp, một lượt (input sẵn sorted).
2. Nested loop join — dò từng dòng
Nested loop join là thuật toán đơn giản nhất, đúng như tên: hai vòng lặp lồng nhau. Vòng ngoài đi qua từng dòng của bảng ngoài (outer); với mỗi dòng đó, vòng trong tìm các dòng khớp trong bảng trong (inner).
for each row r_outer in OUTER:
    for each row r_inner in INNER:
        if join_condition(r_outer, r_inner):
            output (r_outer, r_inner)
// Time: O(n * m)   -- n = |OUTER|, m = |INNER|
Bản ngây thơ này có chi phí O(n*m) — với hai bảng mỗi bên 1 triệu dòng là một nghìn tỉ phép so sánh, không khả thi. Nhưng nested loop có một biến thể cực mạnh: index nested loop. Nếu bảng trong có index trên cột join, vòng trong không quét cả bảng mà nhảy thẳng tới dòng khớp qua index — chi phí mỗi lần tra giảm từ O(m) xuống O(log m):
for each row r_outer in OUTER:
    matches <- INNER_INDEX.lookup(r_outer.join_key)   -- tra index thay vi quet
    for each r_inner in matches:
        output (r_outer, r_inner)
// Time: O(n * log m)   -- nho index tren INNER
Đây là lý do nested loop thắng khi bảng ngoài nhỏ (ít vòng lặp ngoài) và bảng trong có index trên cột join. Mỗi dòng ngoài chỉ tốn một lần tra index. Nhưng nếu bảng ngoài lớn và không có index trên bảng trong, nested loop trở thành thảm hoạ O(n*m) — chính tình huống đầu bài.
Khi không có index, một số engine dùng block nested loop: nạp từng khối (block) lớn của bảng ngoài vào bộ nhớ rồi quét bảng trong một lần cho cả khối, thay vì quét lại bảng trong cho từng dòng. Vẫn O(n*m) về so sánh nhưng giảm mạnh số lần đọc đĩa của bảng trong — một bước tối ưu I/O, không đổi độ phức tạp tiệm cận.
3. Hash join — dựng bảng băm rồi dò
Hash join giải bài toán "hai bảng lớn, không index" mà nested loop bó tay. Nó chạy hai pha:
- Pha build (dựng): chọn bảng nhỏ hơn (sau khi áp điều kiện lọc), đọc toàn bộ, băm cột join của mỗi dòng và đặt dòng vào một bảng băm (hash table) trong bộ nhớ — khoá là giá trị cột join.
- Pha probe (dò): quét bảng lớn hơn, với mỗi dòng băm cột join rồi tra thẳng vào bảng băm để lấy các dòng khớp.
-- Pha build: bang nho hon vao hash table
H <- empty hash table
for each row s in SMALLER:
    H.insert(hash(s.join_key), s)

-- Pha probe: quet bang lon, tra hash table
for each row r in LARGER:
    for each s in H.get(hash(r.join_key)):
        if r.join_key = s.join_key:        -- xac nhan (tranh hash collision)
            output (r, s)
// Time: O(n + m)   -- moi bang quet 1 luot
Đặt cạnh nested loop trên cùng cặp bảng, toàn bộ khác biệt gói trong một dấu phép tính:
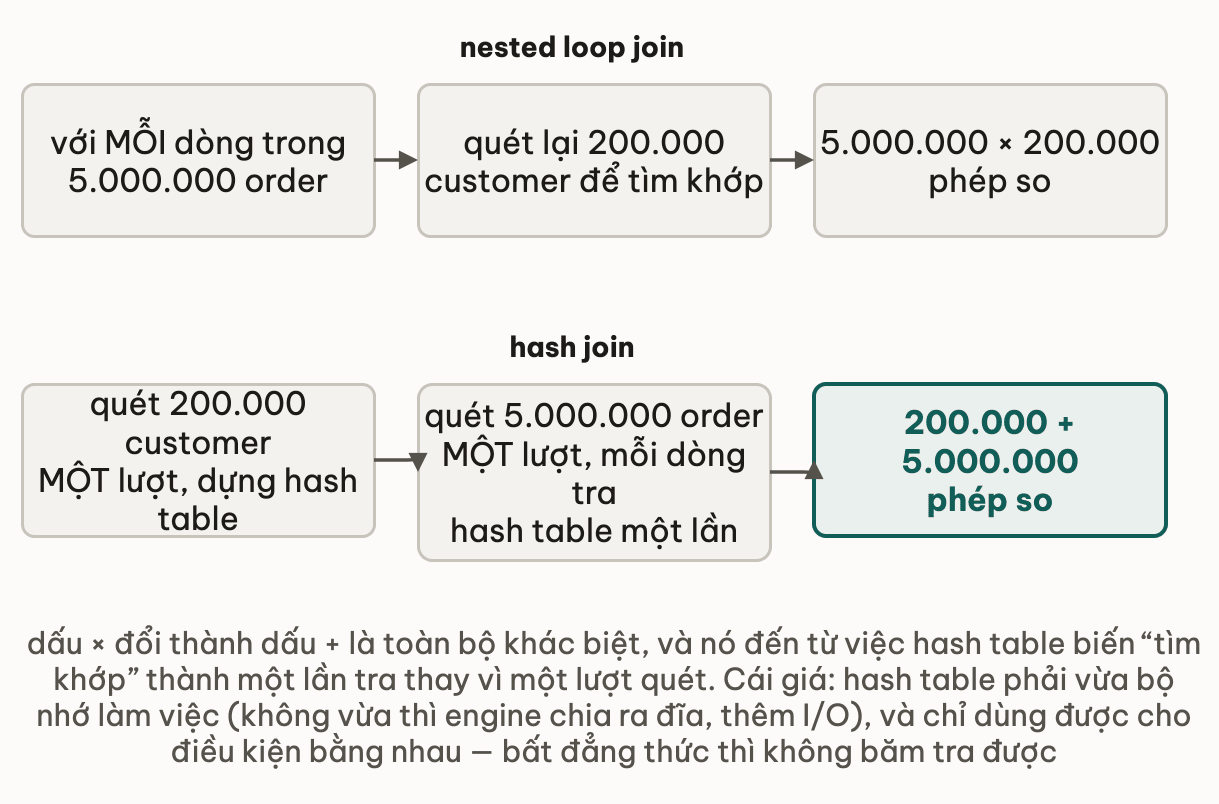
Chi phí chỉ O(n+m) — mỗi bảng quét đúng một lượt — vượt xa O(n*m) của nested loop khi cả hai lớn. Đổi lại, hash join có hai ràng buộc:
- Chỉ cho equi-join. Bảng băm tra theo giá trị bằng nhau, nên hash join chỉ áp dụng cho điều kiện kiểu
a.x = b.y(equi-join). Điều kiện bất đẳng thức (a.x > b.y,BETWEEN) không băm tra được. - Tốn bộ nhớ. Bảng băm phải vừa bộ nhớ làm việc. Nếu bảng build quá lớn, engine phải chia nhỏ ra đĩa (grace/hybrid hash join) — vẫn chạy nhưng thêm I/O. Đầu bài: câu chỉ nhanh sau khi đủ bộ nhớ cho hash table.
Hash join không cần input sắp xếp và không cần index — đó là vũ khí chính cho join hai bảng lớn theo điều kiện bằng nhau.
Thử ngẫmbảng build của hash join lớn hơn RAM khả dụng trên server. Engine chuyển sang grace/hybrid hash join để chạy tiếp. Điều gì xảy ra với độ phức tạp O(n+m) lý tưởng ban đầu?
4. Merge join — trộn hai dòng đã sắp xếp
Merge join (sort-merge join) khai thác dữ liệu đã được sắp xếp theo cột join. Nó đặt hai con trỏ ở đầu hai bảng đã sort, rồi trượt song song: con trỏ nào trỏ vào giá trị nhỏ hơn thì tiến lên; khi hai giá trị bằng nhau thì xuất kết quả.
-- Gia dinh: ca hai da sort theo join_key
i <- 0; j <- 0
while i < |A| and j < |B|:
    if A[i].key = B[j].key:
        output (A[i], B[j]); tien con tro phu hop
    else if A[i].key < B[j].key:
        i <- i + 1            -- A nho hon, A tien
    else:
        j <- j + 1            -- B nho hon, B tien
// Time (da sort):   O(n + m)
// Time (phai sort): O(n log n + m log m)
Khi cả hai input đã sorted, merge join chỉ tốn O(n+m) — một lượt quét song song, không bảng băm, ít bộ nhớ. Vấn đề là chi phí sắp xếp: nếu phải sort cả hai trước, thêm O(n log n + m log m), có thể đắt hơn hash join.
Vậy khi nào merge join thắng? Khi dữ liệu vốn đã sắp xếp — nhờ index theo đúng cột join, hoặc nhờ một toán tử phía dưới (ví dụ một merge join khác) đã trả ra thứ tự đó. Optimizer gọi tính chất này là "interesting order": nó có thể cố ý chọn một bước trước đó sinh ra thứ tự hữu ích, để bước join sau dùng merge mà không phải sort lại. Merge join cũng có lợi khi query cần kết quả ORDER BY đúng cột join — vì kết quả merge ra đã sorted sẵn.
Khác hash join, merge join xử lý được cả điều kiện phạm vi (>=, <=) trong một số trường hợp, vì nó so sánh thứ tự chứ không chỉ bằng nhau.
5. So sánh — optimizer chọn thuật toán nào
Cả ba cho cùng kết quả; optimizer chấm chi phí rồi chọn. Bảng tổng hợp điều kiện áp dụng:
| Tiêu chí | Nested loop | Hash join | Merge join |
|---|---|---|---|
| Độ phức tạp tốt nhất | O(n*log m) (có index) | O(n+m) | O(n+m) (đã sort) |
| Độ phức tạp xấu nhất | O(n*m) (không index) | O(n+m) + tràn đĩa | O(n log n + m log m) (phải sort) |
| Loại điều kiện | Mọi điều kiện | Chỉ equi-join (=) | Equi + phạm vi (theo thứ tự) |
| Cần index | Lý tưởng có index bảng trong | Không | Không (nhưng index sorted giúp) |
| Cần sort | Không | Không | Có (trừ khi input sẵn sorted) |
| Tốn bộ nhớ | Thấp | Cao (hash table) | Trung bình (buffer sort) |
| Thắng khi | Bảng ngoài nhỏ, bảng trong có index | Hai bảng lớn, equi-join, không sort | Input sẵn sorted, hoặc cần kết quả có thứ tự |
Logic chọn (đơn giản hoá):
- Một bảng nhỏ và bảng kia có index trên cột join → nested loop (index nested loop) thường rẻ nhất.
- Hai bảng lớn, điều kiện bằng nhau, đủ bộ nhớ → hash join.
- Input đã sorted (qua index), hoặc query cần kết quả theo thứ tự cột join → merge join.
Index tăng tốc index nested loop và giúp merge join khỏi sort. Nhưng nếu optimizer đã chọn hash join (vì hai bảng lớn, equi-join), thêm index trên cột join thường không đổi gì — hash join không dùng index. Đó là lý do đầu bài: thêm index vô ích, thứ cần là đủ bộ nhớ cho hash table. Bài học: tối ưu join phải nhìn thuật toán optimizer chọn (qua EXPLAIN), không chỉ phản xạ "thêm index".
Thử ngẫmmột query JOIN hai bảng lớn rồi ORDER BY đúng cột join. Team thấy plan dùng merge join dù dữ liệu chưa sẵn sorted — có phải optimizer chọn nhầm không?
6. Pitfall — ép join sai thuật toán
Cách viết điều kiện join và lọc ảnh hưởng trực tiếp thuật toán optimizer chọn:
- Join trên biểu thức biến đổi cột (
ON UPPER(a.code) = b.code) → mất khả năng dùng index cho nested loop và khó hash đúng → optimizer rơi về plan đắt. Giữ điều kiện join chạm thẳng cột thô. - Join điều kiện bất đẳng thức trên bảng lớn (
ON a.start < b.end) → hash join không áp dụng (chỉ equi-join), buộc nested loopO(n*m)hoặc merge. Nếu phải làm, cân nhắc thu nhỏ một phía bằng điều kiện lọc selective trước. - Quên lọc trước khi join → bảng "nhỏ hơn" trong hash join thực ra vẫn khổng lồ vì chưa áp
WHERE. Đẩy điều kiện lọc xuống sớm (database thường tự làm qua predicate pushdown, nhưng viết rõ giúp ước lượng đúng).
-- WRONG: bien doi cot trong dieu kien join -> mat index, plan dat
SELECT * FROM orders o
JOIN customers c ON UPPER(o.cust_code) = c.code;

-- DUNG: join cham thang cot tho (chuan hoa du lieu khi luu)
SELECT * FROM orders o
JOIN customers c ON o.cust_code = c.code;

-- DUNG: loc selective truoc khi join de thu nho mot phia
SELECT * FROM orders o
JOIN customers c ON o.cust_code = c.code
WHERE o.created_at >= '2026-01-01';   -- thu nho 'orders' truoc khi join
Quy tắc: muốn optimizer chọn thuật toán tốt, cho nó điều kiện equi-join sạch (chạm cột thô) và lọc selective sớm. Khi nghi sai thuật toán, đọc plan bằng EXPLAIN để thấy nested loop / hash / merge thực tế.
7. 📚 Deep Dive
- Wikipedia — Nested loop join — bản ngây thơ
O(|R||S|), block nested loop, và index nested loop hạ xuốngO(|R| log |S|). - Wikipedia — Hash join — pha build/probe, ràng buộc equi-join, và ba biến thể classic / grace / hybrid khi bảng băm tràn bộ nhớ.
- Wikipedia — Sort-merge join — chi phí
O(Pr+Ps)khi đã sort vsO(Pr log Pr + Ps log Ps)khi phải sort, và khái niệm "interesting order". - Designing Data-Intensive Applications (Kleppmann) — Chương 3 — join trong context xử lý truy vấn, vì sao kích thước bảng + bộ nhớ quyết định thuật toán.
Ghi chú: Ba trang Wikipedia cho định nghĩa thuật toán + độ phức tạp chính xác, trung lập engine. DDIA đặt chúng vào bức tranh optimizer lớn hơn. Đọc xong, sang bài 03 để hiểu optimizer ước lượng chi phí thế nào để chọn giữa ba thuật toán này.
8. Liên hệ các bài khác
- Bài 01 — Từ SQL đến kế hoạch thực thi: node Join nằm trong cây toán tử; bài này giải thích node đó chạy bằng thuật toán nào.
- Bài 03 — Cost model & cardinality: optimizer ước lượng kích thước mỗi bảng (cardinality) để chọn nested loop / hash / merge — ước lượng sai dẫn tới chọn nhầm thuật toán.
- Module 6 — Tại sao cần index: index nested loop và merge join dựa trực tiếp trên index — hiểu index trước khi hiểu vì sao nó tăng tốc join.
- Module 3 — INNER JOIN: cú pháp JOIN khai báo mà ba thuật toán ở đây thực thi bên dưới.
- Module 3 — GROUP BY & HAVING: aggregate thường nằm trên đỉnh cây join — thứ tự join ảnh hưởng số dòng phải gom nhóm.
9. Tóm tắt
- Một câu
JOINchỉ khai báo điều kiện ghép; optimizer chọn một trong ba thuật toán thực thi. - Nested loop: vòng lặp lồng nhau,
O(n*m)bản ngây thơ, hạ xuốngO(n*log m)khi bảng trong có index — thắng khi bảng ngoài nhỏ + bảng trong có index. - Hash join: dựng bảng băm từ bảng nhỏ rồi dò bảng lớn,
O(n+m), chỉ cho equi-join, tốn bộ nhớ — thắng khi hai bảng lớn ghép bằng nhau, không cần sort/index. - Merge join: trộn hai input đã sorted một lượt,
O(n+m)nếu sẵn sorted (thêm chi phí sort nếu chưa) — thắng khi input sẵn sorted hoặc query cần kết quả theo thứ tự. - Thêm index chỉ giúp index nested loop và merge join; không giúp hash join — nên tối ưu join phải nhìn thuật toán thực tế qua
EXPLAIN, không phản xạ "thêm index". - Điều kiện join nên là equi-join sạch (chạm cột thô) + lọc selective sớm để optimizer chọn được thuật toán tốt.
10. Tự kiểm tra
- Q1Nested loop join bản ngây thơ có chi phí O(n*m), thường quá đắt. Biến thể nào cứu nó, và khi đó chi phí giảm còn bao nhiêu, trong điều kiện gì?
- Q2Mô tả hai pha của hash join. Vì sao nó chỉ áp dụng cho equi-join mà không xử lý được điều kiện bất đẳng thức?
- Q3Merge join có chi phí O(n+m) khi input đã sorted — rất rẻ. Vậy vì sao optimizer không luôn chọn merge join?
- Q4Hai bảng lớn join theo điều kiện bằng nhau chạy 40 giây. Dev thêm index lên cột join nhưng vẫn 38 giây. Giải thích vì sao index không giúp, và cái gì mới giúp.
- Q5Một bảng nhỏ (1000 dòng) join với bảng lớn (10 triệu dòng) đã có index trên cột join. Optimizer nên chọn thuật toán nào, và vì sao rẻ hơn hash join ở đây?
- Q6Vì sao viết điều kiện join dạng ON UPPER(a.code) = b.code lại khiến optimizer rơi vào plan đắt?
Bài tiếp theo: Cost model & cardinality — vì sao planner chọn sai
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên