Tuning toolbox — 6 tier fix từ rẻ đến đắt
Sau khi diagnose được bad plan, bạn áp fix theo thứ tự từ rẻ đến đắt: rewrite query, ANALYZE, thêm index, tăng statistics_target, materialized view, rồi restructure.
TL;DR: Biết plan tệ vì sao rồi thì fix theo thang sáu tier, từ rẻ đến đắt, và chỉ leo tier khi tier dưới không đủ: rewrite query (miễn phí), ANALYZE (vài giây), thêm index (storage và write cost), tăng statistics_target (planning time), materialized view (data trễ đến lần refresh), cuối cùng mới restructure schema (migration, downtime). Phần lớn vấn đề dừng ở ba tier đầu. Mỗi index thêm là một khoản thuế trên mọi lần ghi (write cost); materialized view chỉ tươi đến lần REFRESH cuối; pg_hint_plan ép plan cứng là băng dán tạm, không phải giải pháp.
Bài anti-pattern đã cho bạn diagnose được planner đang chọn sai và vì sao. Bước tiếp theo là fix, nhưng không phải vấn đề nào cũng cần thêm index hay thiết kế lại schema. Có một thang sáu cấp từ rẻ đến đắt; luôn thử từ dưới lên.
1. Analogy — tăng tốc xe
Xe chạy chậm, bạn không bắt đầu bằng thiết kế lại động cơ. Thử theo thứ tự từ rẻ đến đắt:
| Tier | Xe | PostgreSQL | Chi phí |
|---|---|---|---|
| 1 | Đổi route GPS | Rewrite query | 0 |
| 2 | Cập nhật bản đồ offline | ANALYZE | Vài giây |
| 3 | Mở thêm làn đường | Thêm index | Storage + write cost |
| 4 | Gắn thêm sensor lưu lượng | Tăng statistics_target | Planning time |
| 5 | Xây bãi đỗ gần trung tâm | Materialized view | Storage + data trễ |
| 6 | Thiết kế lại mạng đường | Restructure schema | Migration + downtime |
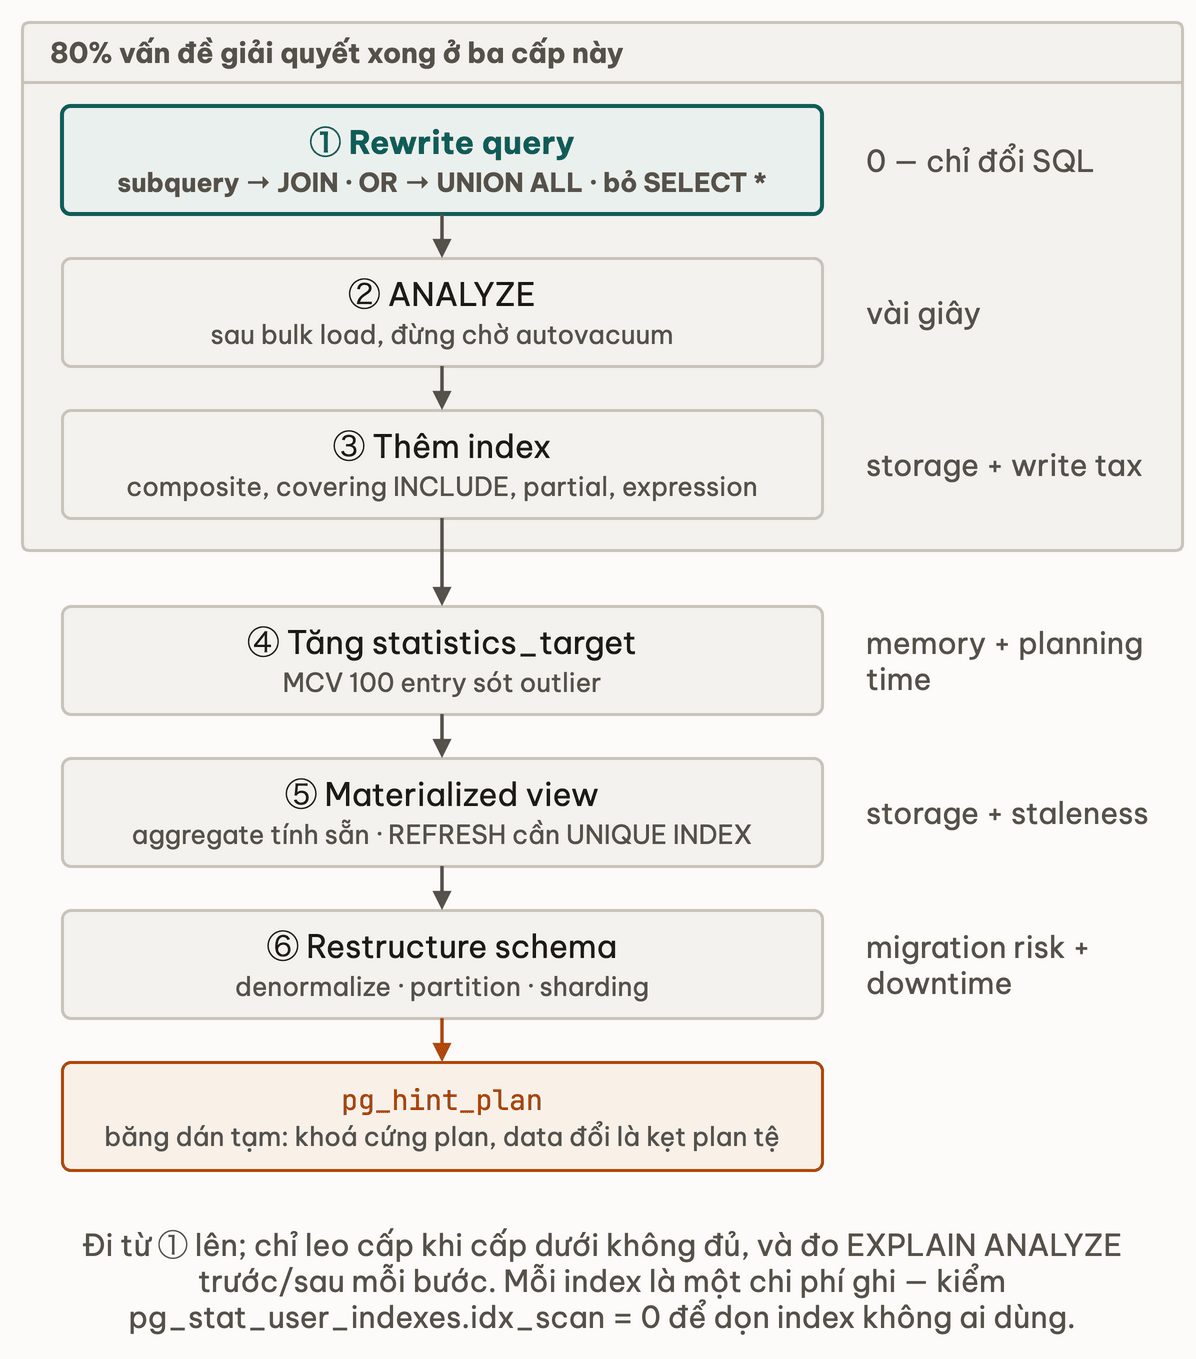
2. Tier 1 — rewrite query
Chi phí 0, chỉ thay SQL. Ba rewrite gặp nhiều nhất:
-- Correlated subquery chay lai moi row outer -> JOIN de planner dung Hash Join
SELECT * FROM users u
WHERE EXISTS (SELECT 1 FROM tasks t WHERE t.assignee_id = u.id AND t.status = 'doing');
-- ->
SELECT DISTINCT u.* FROM users u JOIN tasks t ON t.assignee_id = u.id WHERE t.status = 'doing';

-- OR chan index -> UNION ALL, moi nhanh dung index rieng (bai 05, Pattern 3)
SELECT * FROM tasks WHERE assignee_id = 5 OR project_id = 10;
-- ->
SELECT * FROM tasks WHERE assignee_id = 5
UNION ALL
SELECT * FROM tasks WHERE project_id = 10 AND assignee_id != 5;

-- SELECT * bat buoc fetch heap -> chi lay cot can, mo duong cho Index Only Scan
SELECT id, title, due_at FROM tasks WHERE assignee_id = 5 AND status = 'todo';
3. Tier 2 — ANALYZE
Chi phí vài giây cho bảng 10 triệu row, vì ANALYZE chỉ lấy mẫu. Planner quyết định theo statistics của lần ANALYZE cuối; sau bulk load, statistics lag và ước tính sai (bài statistics).
SELECT relname, last_analyze, last_autoanalyze, n_mod_since_analyze
FROM pg_stat_user_tables WHERE relname = 'tasks';
-- n_mod_since_analyze lon -> stats co kha nang cu

ANALYZE tasks;
-- Truoc: planner doan 0.5 row -> chon Nested Loop sai
-- Sau:   doan ~200 row -> chon Index Scan dung
Autovacuum chỉ ANALYZE khi số row bị sửa vượt 50 + 0.1 × n_live_tup, bảng 1 triệu row là hơn 100.000 row, và có thể lag 10–30 phút sau bulk load. Cách autovacuum lên lịch và tune cho bảng heavy-update ở bài VACUUM & dead tuple.
4. Tier 3 — thêm index
Chi phí: storage, và mỗi INSERT/UPDATE/DELETE phải cập nhật index. Bốn dạng index dùng nhiều nhất trong tuning, chi tiết ở composite index và specialized index:
-- Composite: equality truoc, range sau
CREATE INDEX idx_tasks_dashboard ON tasks(assignee_id, status, due_at);
-- Covering: INCLUDE cot chi de cover SELECT -> Index Only Scan
CREATE INDEX idx_tasks_cover ON tasks(assignee_id, status) INCLUDE (due_at, title);
-- Partial: chi index hot row, index nho hon, maintenance nhe hon
CREATE INDEX idx_tasks_active ON tasks(due_at) WHERE status != 'archived';
-- Expression: cho ham boc cot (bai 05, Pattern 1)
CREATE INDEX idx_users_email_lower ON users(LOWER(email));
Ghép ba dạng đầu cho query dashboard WHERE assignee_id = 5 AND status != 'archived' ORDER BY due_at LIMIT 20:
Với index (assignee_id, due_at) INCLUDE (title) WHERE status != 'archived', plan sau khi tạo index còn node Sort không, và Heap Fetches sẽ là bao nhiêu nếu vừa ANALYZE mà chưa VACUUM?
-- Before: Seq Scan + Sort, Execution Time ~1800 ms
CREATE INDEX idx_tasks_active_assignee
ON tasks(assignee_id, due_at) INCLUDE (title)
WHERE status != 'archived';
VACUUM ANALYZE tasks;
-- After: Index Only Scan, khong con node Sort (index da theo due_at),
--        Heap Fetches: 0 nho VACUUM cap nhat visibility map, ~1.5 ms
Index đã xếp theo due_at nên ORDER BY … LIMIT 20 chỉ đọc 20 entry đầu. Heap Fetches: 0 cần visibility map tươi: chỉ ANALYZE thì VM chưa có bit all-visible và Heap Fetches xấp xỉ số row trả về (~20), như bài scan strategies đã chỉ; phải VACUUM.
5. Tier 4 — tăng statistics_target
Chi phí: ANALYZE chậm hơn, planning time tăng nhẹ. Dùng khi đã ANALYZE mà ước tính vẫn sai cho giá trị hiếm: cột phân bố lệch (10% assignee chiếm 80% task) mà MCV 100 entry không bắt được.
ALTER TABLE tasks ALTER COLUMN assignee_id SET STATISTICS 1000;
ANALYZE tasks;   -- BAT BUOC chay lai sau khi doi target

-- Toan cuc: ALTER SYSTEM ghi vao postgresql.auto.conf, can reload + ANALYZE
ALTER SYSTEM SET default_statistics_target = 500;
SELECT pg_reload_conf();
ANALYZE;
Chỉ tăng cho cột trong WHERE của query quan trọng; tăng toàn cục làm mọi ANALYZE chậm 3–5 lần.
Thử ngẫmassignee_id vừa tăng statistics_target lên 1000 và ANALYZE lại, nhưng bảng có 50 cột khác cũng đang default 100. Việc tăng riêng một cột có ảnh hưởng gì đến 49 cột còn lại không?
6. Tier 5 — khi nào materialized view đáng giá staleness?
Chi phí: storage và data trễ đến lần refresh kế. Đổi lại, query analytics đọc kết quả tính sẵn thay vì aggregate cả bảng mỗi lần. Hợp dashboard "tổng task per project per month", không hợp số dư tài khoản hay tồn kho.
CREATE MATERIALIZED VIEW mv_task_monthly AS
SELECT project_id, date_trunc('month', created_at) AS month,
       count(*) AS task_count,
       count(*) FILTER (WHERE status = 'done') AS done_count
FROM tasks
GROUP BY project_id, date_trunc('month', created_at);

-- UNIQUE INDEX bat buoc de REFRESH CONCURRENTLY; thieu no, REFRESH thuong
-- lock MV va block moi SELECT trong luc refresh
CREATE UNIQUE INDEX ON mv_task_monthly(project_id, month);
REFRESH MATERIALIZED VIEW CONCURRENTLY mv_task_monthly;

SELECT * FROM mv_task_monthly WHERE project_id = 1 ORDER BY month;
-- ~0.8 ms (Index Scan) thay vi ~480 ms aggregate 1M row
Tradeoff phải nói rõ với client: data trong MV chỉ tươi đến lần REFRESH cuối, API contract cần ghi "dashboard cập nhật mỗi 5 phút". Lịch refresh và theo dõi MV thuộc module Observability của khoá PostgreSQL — Advanced & Scale (đang xây).
Thử ngẫmjob REFRESH CONCURRENTLY của mv_task_monthly bị lỗi và không chạy suốt 3 ngày. Dashboard có báo lỗi hay chỉ lặng lẽ hiển thị số cũ?
7. Tier 6 — restructure schema (last resort)
Chi phí cao: migration script, backfill, dual-write window, rollback plan. Chỉ khi năm tier trên không đủ.
- Denormalize: pre-join vào wide table cho hot path analytics (embed sẵn
project_name,assignee_name), chỉ khi read lấn át write; tradeoff ở bài denormalization của khoá SQL & Database. - Partition
taskstheo date range để queryWHERE created_at >= '2026-01-01'chỉ quét partition 2026; đáng khi bảng trên 100 triệu row và query hay lọc theo ngày. - Sharding khi một node không đủ throughput; phức tạp nhất vì cross-shard join.
Partition và sharding thuộc module Scaling của khoá PostgreSQL — Advanced & Scale (đang xây).
8. pg_hint_plan — băng dán tạm
Extension (ngoài core) cho ghi hint inline để ép planner: /*+ HashJoin(t u) IndexScan(t idx_tasks_assignee) */ SELECT …. Hữu ích khi planner cứ chọn sai mà chưa sửa được bằng năm tier trên trong thời gian ngắn. Hint khoá plan cứng, nên khi phân bố data đổi mà hint không đổi, bạn kẹt với plan tệ hơn trước.
Index write cost. Bảng có 5 index thì mỗi UPDATE có thể phải sửa cả 5, INSERT throughput trên workload write-heavy giảm 40–60%. Audit định kỳ:
SELECT indexname, idx_scan FROM pg_stat_user_indexes
WHERE tablename = 'tasks' AND idx_scan = 0;   -- chua bao gio duoc dung -> can nhac DROP
GUC đổi mà chưa có hiệu lực. SET chỉ ảnh hưởng session; ALTER SYSTEM ghi vào postgresql.auto.conf và cần SELECT pg_reload_conf(); riêng shared_buffers và vài GUC khác cần restart. Đổi statistics_target xong còn phải ANALYZE.
Thử ngẫmmột hint pg_hint_plan ép HashJoin đã nằm im trong code 8 tháng. Data đã tăng 10 lần từ lúc viết hint đó. Hint này đang giúp hay đang cản planner?
9. Applied — TaskFlow dashboard: hai tier cho hai nhu cầu
Baseline: đếm task theo status cho một assignee, 125 ms trên 1 triệu row.
EXPLAIN ANALYZE
SELECT status, count(*) FROM tasks
WHERE assignee_id = 5 AND status != 'archived' GROUP BY status;
-- Seq Scan on tasks  Filter: ((assignee_id = 5) AND (status <> 'archived'))
--   Rows Removed by Filter: ~987000
-- Execution Time: ~125 ms

-- Tier 3: partial index tren dung hai cot
CREATE INDEX idx_tasks_status_count ON tasks(assignee_id, status) WHERE status != 'archived';
ANALYZE tasks;
-- Index Only Scan using idx_tasks_status_count  Index Cond: (assignee_id = 5)  Heap Fetches: 0
-- Execution Time: ~2 ms  (~62x)

-- Tier 5: precompute cho man hinh analytics chap nhan tre
CREATE MATERIALIZED VIEW mv_user_status_count AS
SELECT assignee_id, status, count(*) AS task_count
FROM tasks WHERE status != 'archived' GROUP BY assignee_id, status;
CREATE UNIQUE INDEX ON mv_user_status_count(assignee_id, status);
-- SELECT * FROM mv_user_status_count WHERE assignee_id = 5;  ~0.3 ms  (~400x)
| Fix | Tier | Trước | Sau | Tỷ lệ |
|---|---|---|---|---|
| Partial covering index | 3 | 125 ms | 2 ms | 62× |
| Materialized view | 5 | 125 ms | 0,3 ms | 400× |
Tier 1 và 2 đã áp trước (query viết đúng, ANALYZE đã chạy sau bulk load). Hai fix trên không thay nhau: index cho màn hình cần real-time, MV cho màn hình analytics chịu được trễ 5 phút.
10. Deep Dive
- PostgreSQL Wiki — Performance Optimization — tổng hợp GUC tuning, index strategy, vacuum, EXPLAIN. Điểm bắt đầu khi gặp vấn đề hiệu năng cụ thể.
- PostgreSQL Documentation — REFRESH MATERIALIZED VIEW — điều kiện của
CONCURRENTLY(UNIQUE INDEX, không dùngWITH NO DATA) và hành vi lock. - PostgreSQL 14 Internals — Egor Rogov, Part IV — Query Execution (chương về cost estimation và index) — free PDF, cơ chế bên dưới mỗi quyết định của planner.
11. Liên hệ các bài khác
- 5 anti-pattern — diagnose trước, toolbox sau; Tier 1 rewrite chính là fix của Pattern 1 và 3.
- Statistics & cost model — Tier 2 và 4 đều là thao tác lên statistics; đọc để biết vì sao ANALYZE thường đủ.
- Specialized index: GIN, BRIN, partial — partial index ở Tier 3 và write cost của mỗi loại.
- Denormalization tradeoff (khoá SQL & Database) — Tier 6 đầu tiên và cái giá của nó.
- Mini-challenge dashboard 2 s → 50 ms — áp thang này lên dataset 5 triệu row.
12. Tóm tắt
- Checklist trước khi thêm index: query có rewrite được không →
last_analyzebao giờ → EXPLAIN sauANALYZEđã đổi chưa. Vẫn chậm mới sang Tier 3. - Con số:
ANALYZEvài giây cho 10 triệu row; 5 index có thể giảm INSERT throughput 40–60%; MV đọc ~0,8 ms thay ~480 ms aggregate. pg_hint_plandùng có ngày hết hạn: ghi lại lý do và ngày, xoá khi root cause đã sửa.
13. Tự kiểm tra
- Q1Query
WHERE assignee_id = 5 AND status = 'doing'chạy 800ms trên 1M row dù đã có index(assignee_id). Trước khi thêm composite index, bạn sẽ thử những bước nào theo thứ tự tier? Tại sao thứ tự đó đúng? - Q2Bạn tạo 6 index trên bảng
tasksđể cover mọi query pattern. 1 tháng sau INSERT throughput giảm 55%. Diagnose và fix như thế nào? - Q3EXPLAIN ANALYZE vẫn cho
rows=500000 actual rows=120dù đã chạy ANALYZE. Tier tiếp theo nên thử là gì? Giải thích cơ chế. - Q4Tại sao
REFRESH MATERIALIZED VIEW CONCURRENTLYbắt buộc cần UNIQUE INDEX? Điều gì xảy ra nếu không có? - Q5Dashboard analytics đang dùng Materialized View refresh mỗi 5 phút. Product team yêu cầu một số metric cần real-time (ví dụ số task đang 'doing' của team). Bạn sẽ thiết kế solution như thế nào? Không được xoá MV cũ.
Bài tiếp theo: Mini-challenge — Dashboard 2,1 s → 50 ms trên 5 triệu task
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
5 anti-pattern khiến planner chọn plan tệ
Bài tiếpMini-challenge — Dashboard 2,1 s → 50 ms trên 5 triệu task
Thảo luận & góp ý
Hỏi đáp về bài này