Join algorithms — Nested Loop, Hash Join, Merge Join
PostgreSQL ghép bảng bằng Nested Loop, Hash Join hoặc Merge Join; bài dạy đọc plan để biết planner chọn đúng thuật toán chưa và vì sao.
TL;DR: PostgreSQL có ba cách ghép hai bảng. Nested Loop chạy lại inner cho mỗi row outer: nhanh khi outer nhỏ và inner có index, trả row đầu ngay nên hợp query có LIMIT. Hash Join xây hash table từ bảng nhỏ trong work_mem rồi quét bảng lớn một lần để tra, không cần index hay thứ tự; hash table tràn work_mem thì spill thành nhiều Batches. Merge Join kéo hai stream đã sort như khoá kéo, tốn rất ít RAM. Planner chọn theo ước tính rows; ước tính sai làm nó chọn Nested Loop cho outer một triệu row, và đó là lúc query chậm gấp trăm lần.
Cùng một câu SELECT u.name, count(t.id) FROM users u JOIN tasks t ON t.assignee_id = u.id GROUP BY u.id trên 1 triệu task: Hash Join chạy 450 ms; Nested Loop mất khoảng 20 phút nếu tasks không có index trên assignee_id. Cùng query, cùng data, chỉ khác thuật toán. Biết khi nào planner chọn sai là phần lớn kỹ năng query tuning.
1. Analogy — ghép tên trong hai danh sách
Danh sách A có 10.000 nhân viên, danh sách B có 1 triệu task, cần ghép theo employee_id. Ba thư ký làm ba cách:
| Cách làm của thư ký | Join algorithm | Đặc điểm |
|---|---|---|
| Đọc từng tên trong A, mỗi tên lại lật B để tìm | Nested Loop | O(A × B); tốt khi B có mục lục (index) để lật nhanh |
| Chép A thành từ điển tra nhanh, rồi quét B một lượt tra từng dòng | Hash Join | O(A + B); cần RAM giữ từ điển, không cần thứ tự |
Sort cả hai theo employee_id, đi song song như khoá kéo | Merge Join | O(A + B) sau khi đã sort; sort thêm nếu chưa |
Nested Loop = vòng lặp lồng nhau. Hash Join = xây từ điển rồi tra. Merge Join = khoá kéo hai danh sách đã sort. Không cái nào luôn tốt nhất.
2. Nested Loop — khi nào nhanh nhất, khi nào thành thảm hoạ?
Nested Loop không build cấu trúc, không sort: với mỗi row outer, probe inner. Ưu điểm lớn là streaming: row đầu tiên được trả ngay khi ghép được, không phải đợi xử lý hết inner, nên query có LIMIT thường thấy Nested Loop.
EXPLAIN ANALYZE
SELECT u.name, t.title
FROM users u JOIN tasks t ON t.assignee_id = u.id
WHERE u.id < 100;
Nested Loop  (cost=0.42..1500.00 rows=200 width=64)
             (actual time=0.025..2.500 rows=180 loops=1)
  ->  Index Scan using users_pkey on users u  (cost=0.28..8.30 rows=99 width=40)
                                              (actual time=0.010..0.080 rows=99 loops=1)
        Index Cond: (id < 100)
  ->  Index Scan using idx_tasks_assignee on tasks t
                                              (cost=0.42..15.00 rows=2 width=32)
                                              (actual time=0.018..0.024 rows=2 loops=99)
        Index Cond: (assignee_id = u.id)
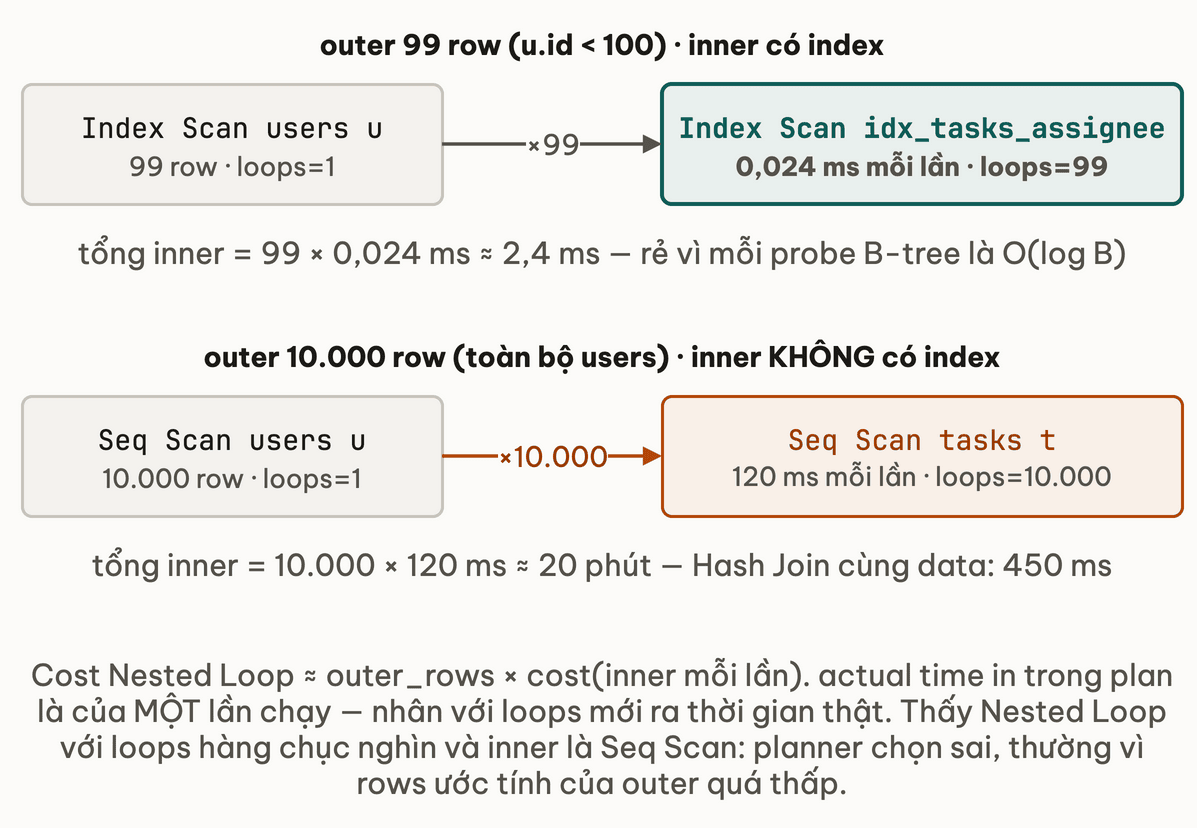
loops=99 trên inner: Index Scan vào tasks chạy 99 lần, một lần cho mỗi row từ users. actual time=0.018..0.024 là của một lần chạy (như bài 01 đã nhắc), tổng inner là 99 × 0,024 ≈ 2,4 ms: outer nhỏ và mỗi probe là một lần đi B-tree, O(log B).
Đổi hai thừa số là thành thảm hoạ. Outer là toàn bộ users (10.000 row) và tasks không có index trên assignee_id: mỗi probe là một Seq Scan 1 triệu row, khoảng 120 ms. Tổng inner = 10.000 × 120 ms = 1.200 giây, xấp xỉ 20 phút; Hash Join cùng data 450 ms, chênh ~2.700 lần. Ngay cả khi inner có index, outer 1 triệu row với mỗi probe 0,024 ms cũng cộng thành 24 giây, trong khi Hash Join cùng data xong trong khoảng nửa giây.
3. Hash Join — build từ bảng nhỏ, probe bằng bảng lớn
Hash Join có hai pha: build xây hash table từ một bảng, probe quét bảng còn lại và tra theo equality. Không cần index hay thứ tự, chỉ cần equi-join (=) và đủ work_mem (RAM cấp cho một thao tác sort/hash, mặc định 4 MB, giải thích ở mục 6).
Query dưới ghép users (10.000 row) với tasks (1 triệu row). Planner sẽ build hash table từ bảng nào, và node Hash sẽ nằm dưới Seq Scan của bảng nào trong plan? Quyết định rồi mới đọc.
EXPLAIN ANALYZE
SELECT u.name, count(t.id)
FROM users u JOIN tasks t ON t.assignee_id = u.id
GROUP BY u.id, u.name;
HashAggregate  (cost=25000.00..25200.00 rows=10000 width=48)
               (actual time=480.000..485.000 rows=10000 loops=1)
  Group Key: u.id, u.name
  ->  Hash Join  (cost=350.00..18000.00 rows=1000000 width=32)
                 (actual time=0.500..450.000 rows=950000 loops=1)
        Hash Cond: (t.assignee_id = u.id)
        ->  Seq Scan on tasks t  (cost=0.00..14000.00 rows=1000000 width=16)
                                 (actual time=0.020..120.000 rows=1000000 loops=1)
        ->  Hash  (cost=225.00..225.00 rows=10000 width=24)
                  (actual time=0.420..0.420 rows=10000 loops=1)
              Buckets: 16384  Batches: 1  Memory Usage: 480kB
              ->  Seq Scan on users u  (cost=0.00..225.00 rows=10000 width=24)
Plan text xếp Hash dưới Seq Scan on tasks, nhưng bảng được hash là users: node Hash bọc lấy bảng build, 10.000 row thành hash table 480 kB. tasks ở nhánh trên là phía probe, quét một lần. Batches: 1 nghĩa là hash table vừa work_mem, mọi probe xảy ra trong RAM.
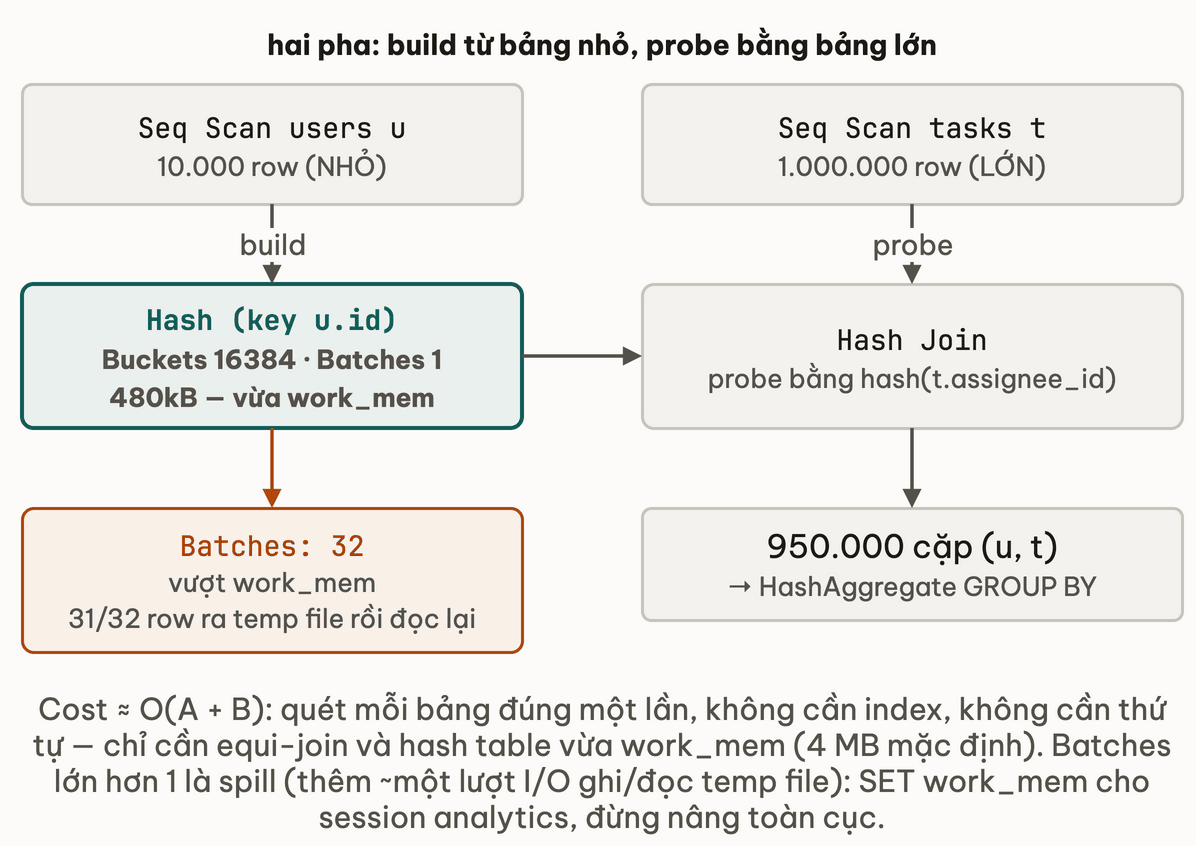
Khi hash table không vừa work_mem: Batches lớn hơn 1. Với bảng build 5 triệu row, plan in đại loại:
->  Hash  (cost=62500.00..62500.00 rows=5000000 width=24)
      Buckets: 8192  Batches: 32  Memory Usage: 4096kB
PostgreSQL chia cả hai phía thành 32 lô theo giá trị hash: lô đầu xử lý ngay, row build và row probe của 31 lô còn lại ghi ra temp file rồi từng lô được đọc lại để join. Phía probe vẫn chỉ quét nguồn một lần; cái giá là gần như toàn bộ dữ liệu phải ghi ra rồi đọc vào thêm một lượt. Thấy Batches lớn thì tăng work_mem cho session đó.
Thử ngẫmHash Join build từ users 10.000 dòng rồi probe bằng tasks 1 triệu dòng. Nếu đổi vai, build từ tasks và probe bằng users, điều gì tệ đi trước tiên?
4. Merge Join — hai stream đã sort, đi như khoá kéo
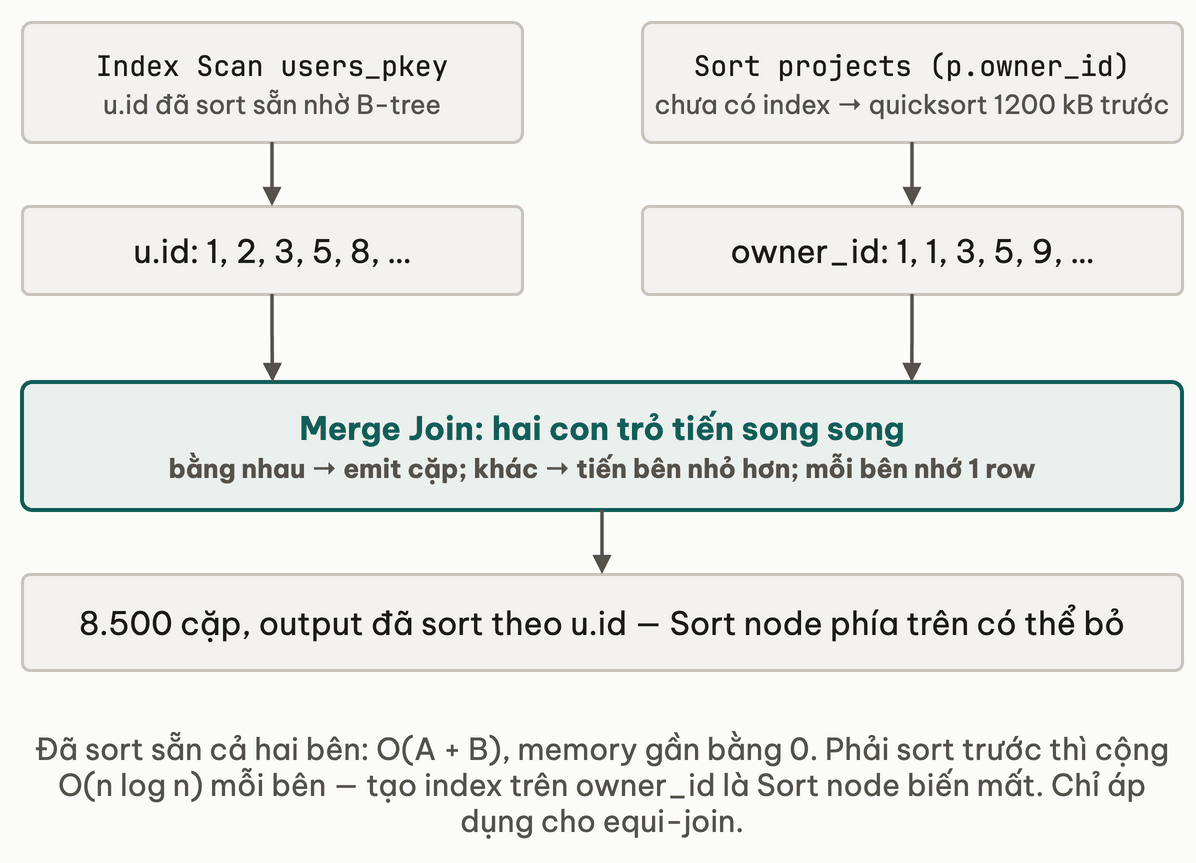
Merge Join cần cả hai input sort theo cột join. Hai con trỏ tiến song song: key bằng nhau thì emit cặp, khác nhau thì tiến con trỏ bên nhỏ hơn. Không hash table, RAM chỉ vài row mỗi bên.
EXPLAIN ANALYZE
SELECT u.name, p.name AS project_name
FROM users u JOIN projects p ON p.owner_id = u.id;
Merge Join  (cost=2500.00..4800.00 rows=8500 width=48)
            (actual time=0.080..15.000 rows=8500 loops=1)
  Merge Cond: (u.id = p.owner_id)
  ->  Index Scan using users_pkey on users u
                        (actual time=0.015..2.500 rows=10000 loops=1)
  ->  Sort  (actual time=0.060..0.800 rows=10000 loops=1)
        Sort Key: p.owner_id
        Sort Method: quicksort  Memory: 1200kB
        ->  Seq Scan on projects p  (actual time=0.010..0.180 rows=10000 loops=1)
users đi qua Index Scan using users_pkey nên đã sort theo u.id; B-tree trả row theo thứ tự key là tính chất giải thích ở bài B-tree internals. projects chưa có index trên owner_id nên phải qua node Sort. Tạo CREATE INDEX ON projects(owner_id) thì node Sort biến mất. Output của Merge Join cũng đã sort theo cột join, nên planner bỏ được node Sort phía trên nếu query ORDER BY đúng cột đó.
5. Chọn algorithm theo tình huống
| Tình huống | Algorithm | Lý do |
|---|---|---|
| Outer nhỏ (dưới 1000 row) + inner có index | Nested Loop | Mỗi probe O(log B) |
| LIMIT 10 sau JOIN | Nested Loop | Streaming, trả row đầu sớm |
| Cả hai bảng lớn, không có index phù hợp, hoặc GROUP BY sau JOIN | Hash Join | O(A+B), không cần index hay thứ tự |
| Cả hai bảng đã sort theo cột join, hoặc kết quả cần sort theo cột đó | Merge Join | O(A+B) thuần, RAM gần 0, bỏ được node Sort |
Nested Loop với loops hàng chục nghìn và inner là Seq Scan là dấu hiệu planner chọn sai; root cause thường là ước tính rows (bài statistics).
Thử ngẫmquery analytics của bạn chạy Hash Join với Batches: 16 trên connection pool OLTP dùng chung work_mem 4MB. Tăng work_mem lên 256MB ngay trên pool đó có an toàn không?
6. work_mem — hash table trong RAM hay spill ra disk
work_mem cấp cho mỗi thao tác, không phải mỗi query hay mỗi connection: một query có 3 node Sort và 2 Hash có thể dùng tới 5 lần work_mem.
SHOW work_mem;                   -- 4MB mac dinh, thap cho analytics
SET work_mem = '64MB';           -- cho session hien tai
SET LOCAL work_mem = '256MB';    -- chi trong transaction hien tai
Dấu hiệu spill: Hash Join in Batches: 32 Memory Usage: 4096kB; node Sort in Sort Method: external merge Disk: 12000kB thay vì quicksort Memory: …. Sort trên disk chậm hơn in-memory 5–20 lần tuỳ I/O.
Pool OLTP giữ 4 MB mặc định để tổng RAM dự đoán được; session analytics thì SET work_mem riêng. Nâng toàn cục lên 256 MB với 100 connection × vài thao tác là hàng chục GB RAM tiềm năng, đủ để OOM.
7. Force algorithm để debug
PostgreSQL cho tắt từng thuật toán để ép planner chọn cái còn lại. Công cụ debug, không dùng trong production.
SET enable_hashjoin = off;   -- tat Hash Join
SET enable_mergejoin = off;  -- tat Merge Join -> planner buoc dung Nested Loop
EXPLAIN ANALYZE SELECT ... ;  -- so sanh actual time voi plan mac dinh
RESET enable_hashjoin;
RESET enable_mergejoin;
Thuật toán bị force mà nhanh hơn thì planner đang chọn sai, và việc cần làm là sửa root cause (ANALYZE, extended statistics, index), không phải giữ enable_* = off trong code.
Thử ngẫmbạn set enable_hashjoin = off để so sánh Nested Loop, thấy nó chậm hơn hẳn, rồi quên RESET trước khi thoát session. Session tiếp theo dùng chung connection pool sẽ bị ảnh hưởng gì?
8. Pitfall — ước tính rows sai kéo theo Nested Loop
Detect: so rows ước tính với actual rows ở node outer. Fix: ANALYZE table;, và CREATE STATISTICS … ON col1, col2 FROM table; nếu ước tính sai đến từ hai cột tương quan.
9. Applied — TaskFlow 4-table JOIN analytics
Query đếm task per user per project (10.000 users, 500 projects, 1 triệu tasks):
SELECT u.name, p.name AS project, count(t.id) AS task_count
FROM users u
JOIN project_members pm ON pm.user_id = u.id
JOIN projects p ON p.id = pm.project_id
LEFT JOIN tasks t ON t.assignee_id = u.id AND t.project_id = p.id
GROUP BY u.id, u.name, p.id, p.name;
HashAggregate  (actual time=2100.000..2150.000 rows=45000 loops=1)
  Batches: 4  Memory Usage: 4096kB
  ->  Hash Right Join  (actual time=850.000..1980.000 rows=980000 loops=1)
        Hash Cond: ((t.assignee_id = u.id) AND (t.project_id = p.id))
        ->  Seq Scan on tasks t  (actual time=0.020..120.000 rows=1000000 loops=1)
        ->  Hash  (rows=48000)  Batches: 1  Memory Usage: 3200kB
              ->  Hash Join  (actual time=15.000..45.000 rows=48000 loops=1)
                    Hash Cond: (pm.project_id = p.id)
                    ->  Hash Join  (actual time=1.500..12.000 rows=48000 loops=1)
                          Hash Cond: (pm.user_id = u.id)
                          ->  Seq Scan on project_members pm  (rows=50000 loops=1)
                          ->  Hash  (rows=10000)  Batches: 1  Memory Usage: 480kB
                                ->  Seq Scan on users u
                    ->  Hash  (rows=500)  Batches: 1  Memory Usage: 32kB
                          ->  Seq Scan on projects p
Execution Time: 2180.000 ms
Đọc từ trong ra: hai Hash Join trong cùng ra 48.000 cặp (user, project) trong 45 ms. Hash Right Join build hash từ 48.000 cặp đó (node Hash bọc phía build, 3,2 MB) và probe bằng 1 triệu tasks; "Right" vì phía được giữ nguyên của LEFT JOIN lại nằm ở nhánh build. Node chạy từ 850 ms tới 1.980 ms, tức 1.130 ms (~1,1 giây), đắt nhất cây. HashAggregate in Batches: 4, aggregate cũng đang spill. Hai fix theo thứ tự: SET work_mem = '64MB' cho session analytics để HashAggregate về Batches: 1; rồi CREATE INDEX ON tasks(assignee_id, project_id) để planner có thêm lựa chọn cho nhánh tasks.
10. Deep Dive
- PostgreSQL 14 Internals — Egor Rogov, Part IV — Query Execution (chương về join method) — free PDF, implementation cả ba thuật toán trong executor, gồm hybrid hash join khi spill.
- CMU 15-445 Database Systems — lecture 11 — Joins — pseudocode và cost analysis, nền tảng CS trước khi đọc Rogov.
- Database Management Systems — Ramakrishnan & Gehrke — textbook kinh điển về sort-merge join và grace hash join.
11. Liên hệ các bài khác
- Join algorithms (nguyên lý) (khoá SQL & Database) — ba thuật toán ở mức DBMS tổng quát; bài này là cách chúng hiện ra trong plan PostgreSQL.
- B-tree internals — vì sao Index Scan trả row đã sort, thứ Merge Join tận dụng.
- Hash function — cấu trúc đứng sau pha build của Hash Join.
- Tuning toolbox — thứ tự fix khi bắt được node join đắt.
12. Tóm tắt
- Checklist khi plan có JOIN: node nào
actual timelớn nhất →Batchescó lớn hơn 1 →loopscủa inner Nested Loop nhân với actual time →rowsước tính vs thực tế ở outer. - Hash Join
Batcheslớn:SET work_memcho session analytics, không nâng toàn cục. enable_hashjoin = offchỉ để so sánh; luônRESET, và fix root cause bằngANALYZE/index.
13. Tự kiểm tra
- Q1Giải thích cơ chế của Hash Join: build phase và probe phase làm gì? Vì sao Hash Join chọn build hash table từ bảng nhỏ hơn thay vì bảng lớn hơn?
- Q2Hash Join in
Batches: 16 Memory Usage: 4096kB. Dòng đó cho biết gì về performance? Giải thích cơ chế spill và cách fix. - Q3Khi nào Merge Join nhanh hơn Hash Join dù cả hai có complexity O(A+B)? Điều kiện cụ thể để Merge Join đạt O(A+B) thuần mà không cần sort cost?
- Q4Query có
SET enable_hashjoin = off; SET enable_mergejoin = off;và sau đó chạy chậm 100x. Tại sao? Đây có phải fix cho production không? - Q5Query
SELECT * FROM a JOIN b ON a.id = b.a_id LIMIT 10— planner chọn Nested Loop dù cả hai bảng đều lớn (1 triệu row). Đây có phải lựa chọn đúng không? Giải thích cơ chế.
Bài tiếp theo: Statistics & cost model — planner ước tính row count như thế nào
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Scan strategies — vì sao có index vẫn Seq Scan
Bài tiếpStatistics & cost model — planner ước tính row count như thế nào
Thảo luận & góp ý
Hỏi đáp về bài này