GIN, BRIN, partial, expression — chọn index theo workload
B-tree không index được JSONB, phình 2 GB trên bảng audit và bó tay với LOWER(email); bài dạy khi nào chọn GIN, BRIN, partial hay expression index thay B-tree.
TL;DR: B-tree là index mặc định và đủ cho đa số cột, nhưng có ba tình huống nó bó tay. Cột đa giá trị (JSONB, array, tsvector) cần GIN (inverted index tra ngược từ giá trị về row), đổi lại ghi chậm hơn B-tree 5–10 lần. Bảng append-only khổng lồ như audit log cần BRIN, chỉ lưu min/max mỗi dải 128 page nên nhỏ hơn B-tree hàng nghìn lần, với điều kiện dữ liệu ghi theo đúng thứ tự cột (correlation gần 1). Chỉ một phần row được query thì partial index với WHERE lúc tạo; query có hàm trên cột như LOWER(email) thì expression index lưu sẵn kết quả hàm, hàm phải immutable.
TaskFlow lưu tag và priority trong cột metadata JSONB. Query WHERE metadata @> '{"priority":"high"}' Seq Scan 2 triệu row dù đã có index, vì index đó là B-tree và B-tree không nhìn vào bên trong JSONB. Cùng lúc, bảng task_history 100 triệu row audit append-only có B-tree trên event_at nặng 2 GB, chiếm buffer cache và làm chậm range scan. Và bảng users có query WHERE LOWER(email) = '[email protected]' bỏ qua B-tree vì có hàm trên cột. Ba vấn đề, ba loại index khác nhau. Bài này map từng loại vào cơ chế bên trong và vào TaskFlow.
1. Analogy — đồ nghề khác cho việc khác
Thợ sửa xe không dùng búa để vặn ốc. B-tree là cái búa: equality, range và sort chiếm phần lớn query thật, nên đa số cột chỉ cần nó. Bốn loại còn lại là dụng cụ chuyên dụng, chỉ lấy ra khi việc thật sự khác.
| Đồ nghề | Index | Dùng khi |
|---|---|---|
| Búa | B-tree | Scalar equality, range, sort |
| Nhíp gắp nhiều thứ | GIN | Array, JSONB, tsvector: dữ liệu đa phần tử |
| Thước cuộn | BRIN | Time-series append-only lớn: quét dải |
| Bút highlight | Partial | Chỉ index subset row thoả WHERE |
| Nhãn dán ghi chú | Expression | Hàm trên cột |
2. Sáu loại index PostgreSQL
CREATE INDEX không khai USING là B-tree. Cột "write cost" lấy chi phí ghi B-tree ở bài trước làm mốc 1x:
| Type | Best for | Internal | Write cost |
|---|---|---|---|
| B-tree | Equality, range, sort | Balanced multi-way tree | 1x |
| Hash | Equality only | Hash table | ~1x, ít dùng |
| GiST | Geometric, range type, FTS | Generalized search tree | 2–3x |
| GIN | Array, JSONB, FTS | Inverted index | 5–10x |
| BRIN | Append-only time-series | Block-range min/max | ~0.1x |
| SP-GiST | Quadtree, k-d tree | Space-partitioned tree | 2–3x |
Bài này đi sâu GIN và BRIN, cộng hai "biến thể" partial và expression áp được lên mọi loại. GiST và SP-GiST để lại cho lúc bạn gặp geometry hoặc range type.
3. GIN — vì sao B-tree không index được JSONB?
B-tree index theo hướng row → key: mỗi entry là một giá trị scalar của một row. JSONB là một tập key/value nên không có một giá trị nào để B-tree so sánh. GIN (Generalized Inverted Index) đảo chiều, giống search engine: index theo hướng element → danh sách row chứa element đó.
CREATE TABLE tasks_v2 (
  id         BIGSERIAL PRIMARY KEY,
  title      TEXT NOT NULL,
  metadata   JSONB
);

-- Mac dinh operator class jsonb_ops
CREATE INDEX idx_tasks_metadata ON tasks_v2 USING GIN (metadata);
-- jsonb_path_ops: nho hon, chi ho tro @>
CREATE INDEX idx_tasks_metadata_path ON tasks_v2 USING GIN (metadata jsonb_path_ops);

SELECT * FROM tasks_v2 WHERE metadata @> '{"priority":"high"}';
-- Plan: Bitmap Index Scan on idx_tasks_metadata -> Bitmap Heap Scan
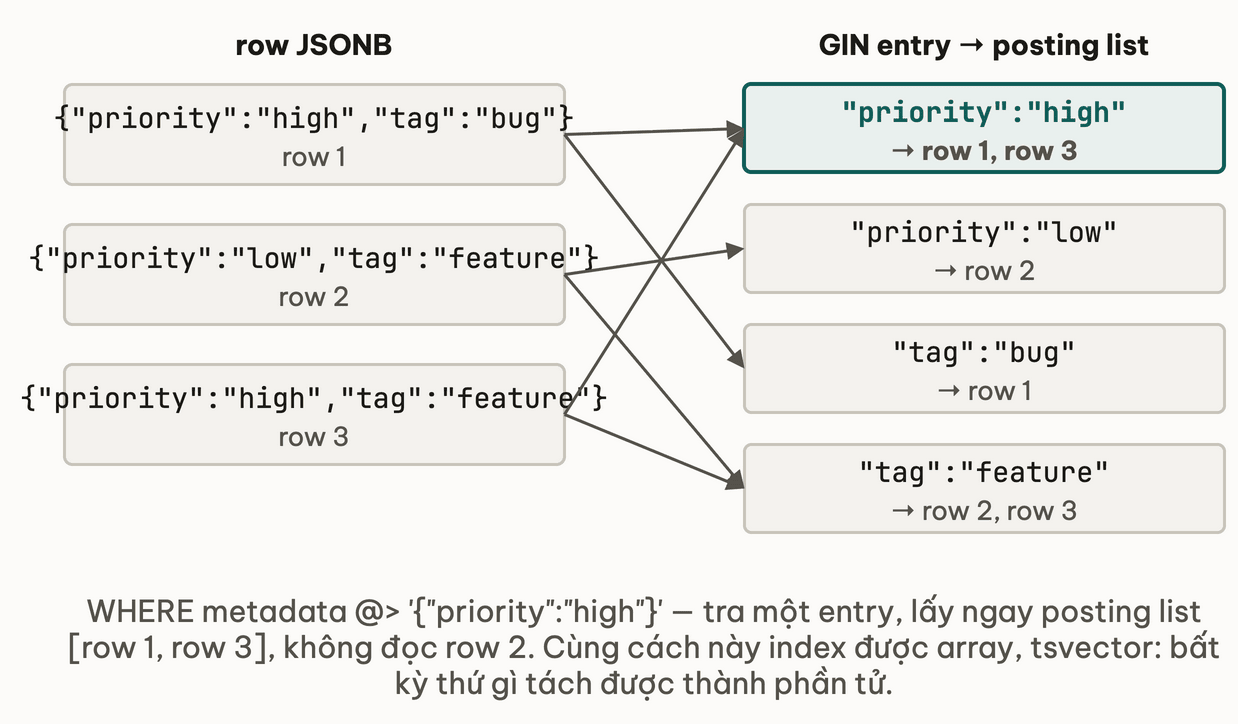
Query @> '{"priority":"high"}' tra entry priority:high, nhận posting list [row1, row3], fetch heap đúng hai row. Giá phải trả: mỗi INSERT/UPDATE phải cập nhật posting list của từng element trong document, nên ghi chậm hơn B-tree 5–10 lần và index lớn hơn 2–3 lần.
jsonb_ops (mặc định) index key và value riêng lẻ, hỗ trợ @>, ?, ?|, ?&. jsonb_path_ops chỉ index cặp key+value đã hash, nhỏ và nhanh hơn cho @> nhưng không hỗ trợ ? (kiểm tra key tồn tại). Chỉ dùng containment thì chọn jsonb_path_ops. Chi tiết operator class, pending list và bulk load ở GIN index cho JSONB; GIN cho full-text tiếng Việt ở Full-text search tiếng Việt.
Thử ngẫmidx_tasks_metadata dùng jsonb_ops mặc định nhưng team chỉ bao giờ query bằng toán tử @>. Đổi sang jsonb_path_ops có mất khả năng gì đang dùng không?
4. BRIN — index 1 MB cho bảng 100 triệu row
BRIN (Block Range Index) chia heap thành các dải 128 page (~1 MB) và chỉ lưu min/max của cột trong mỗi dải.
-- task_history: audit append-only, 100 trieu row
CREATE TABLE task_history (
  id        BIGSERIAL PRIMARY KEY,
  task_id   BIGINT NOT NULL,
  action    TEXT NOT NULL,
  event_at  TIMESTAMPTZ DEFAULT NOW(),
  payload   JSONB
);

CREATE INDEX idx_task_history_event_at ON task_history USING BRIN (event_at);

SELECT pg_size_pretty(pg_relation_size('idx_task_history_event_at'));
-- ~1 MB (B-tree cung cot: ~2 GB)
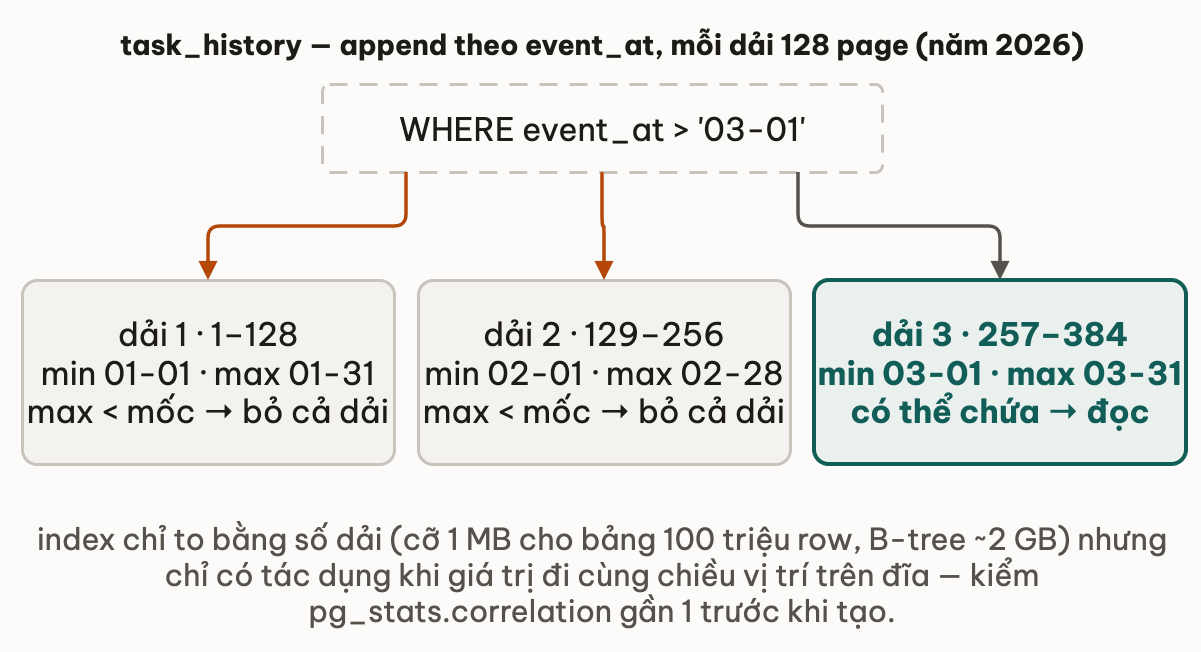
BRIN không trỏ tới row; nó chỉ loại những dải chắc chắn không chứa row thoả điều kiện, rồi quét toàn bộ các dải còn lại. Cách này chỉ có ích khi dữ liệu nằm trên đĩa theo đúng thứ tự cột, tức correlation trong pg_stats gần 1:
SELECT tablename, attname, correlation FROM pg_stats
WHERE tablename = 'task_history' AND attname = 'event_at';
-- correlation = 0.99 -> append-only theo thoi gian -> BRIN loai duoc hau het dai

SELECT tablename, attname, correlation FROM pg_stats
WHERE tablename = 'tasks' AND attname = 'created_at';
-- correlation = 0.45 -> UPDATE da xao tron thu tu vat ly -> moi dai deu co the chua row
Correlation gần 0 thì min/max của mỗi dải phủ gần hết miền giá trị, BRIN không loại được dải nào, kết quả không khác Seq Scan. Cách planner đọc correlation để định giá index nằm ở Statistics và cost model; blog Có index vẫn Seq Scan kể một ca thật đúng lỗi này.
5. Partial index — chỉ index phần row cần
Thêm WHERE vào CREATE INDEX để chỉ index row thoả điều kiện. Index nhỏ hơn, build và maintain rẻ hơn, nhưng planner chỉ dùng khi WHERE của query bao hàm điều kiện đó.
Trước khi đọc plan bên dưới: query thứ hai thiếu điều kiện status. Bạn đoán planner có dám dùng idx_tasks_active_due không?
-- Chi index task chua hoan thanh (todo/doing ~50% du lieu)
CREATE INDEX idx_tasks_active_due ON tasks(due_at)
WHERE status IN ('todo', 'doing');

SELECT * FROM tasks WHERE status IN ('todo', 'doing') AND due_at > NOW();
-- Plan: Index Scan on idx_tasks_active_due

SELECT * FROM tasks WHERE due_at > NOW();
-- Plan: Seq Scan -- index khong chua row done/archived nen khong dam dung
Ba pattern hay gặp: soft delete WHERE deleted_at IS NULL (95% row), CMS WHERE published = true (10% row), và active task (assignee_id, due_at) WHERE status IN ('todo', 'doing'). Đáng làm khi subset đủ nhỏ (dưới 50%) và điều kiện đó có mặt trong phần lớn query; subset dưới 1% thì index quá nhỏ để đổi lấy sự phức tạp.
Thử ngẫmidx_tasks_active_due chỉ index task chưa hoàn thành, nhưng một job nightly chạy WHERE due_at > NOW() mà không kèm điều kiện status. Job đó có dùng được index này không?
6. Expression index — index kết quả hàm
B-tree trên email lưu giá trị gốc, còn query so sánh LOWER(email), hai thứ khác nhau nên planner không dùng index. Expression index lưu sẵn kết quả hàm:
SELECT * FROM users WHERE LOWER(email) = '[email protected]';
-- Plan: Seq Scan (B-tree tren email luu gia tri goc)

CREATE INDEX idx_users_email_lower ON users(LOWER(email));
-- Cung query -> Index Scan on idx_users_email_lower

-- Cac dang khac
CREATE INDEX idx_tasks_created_day ON tasks(date_trunc('day', created_at));
CREATE INDEX idx_tasks_priority    ON tasks((metadata->>'priority'));

-- Ket hop INCLUDE de Index Only Scan
CREATE INDEX idx_users_email_cover ON users(LOWER(email)) INCLUDE (id, display_name);
Điều kiện bắt buộc: biểu thức phải immutable, cùng input luôn cho cùng output, vì giá trị được tính một lần lúc ghi và so sánh lại lúc query. CREATE INDEX ON tasks((created_at - NOW())) bị từ chối ngay với ERROR: functions in index expression must be marked IMMUTABLE.
Thử ngẫmidx_users_email_lower đã tồn tại nhưng một query mới lại viết WHERE email = '[email protected]' thay vì LOWER(email). Planner còn dùng được index đó không?
7. Chọn index theo workload
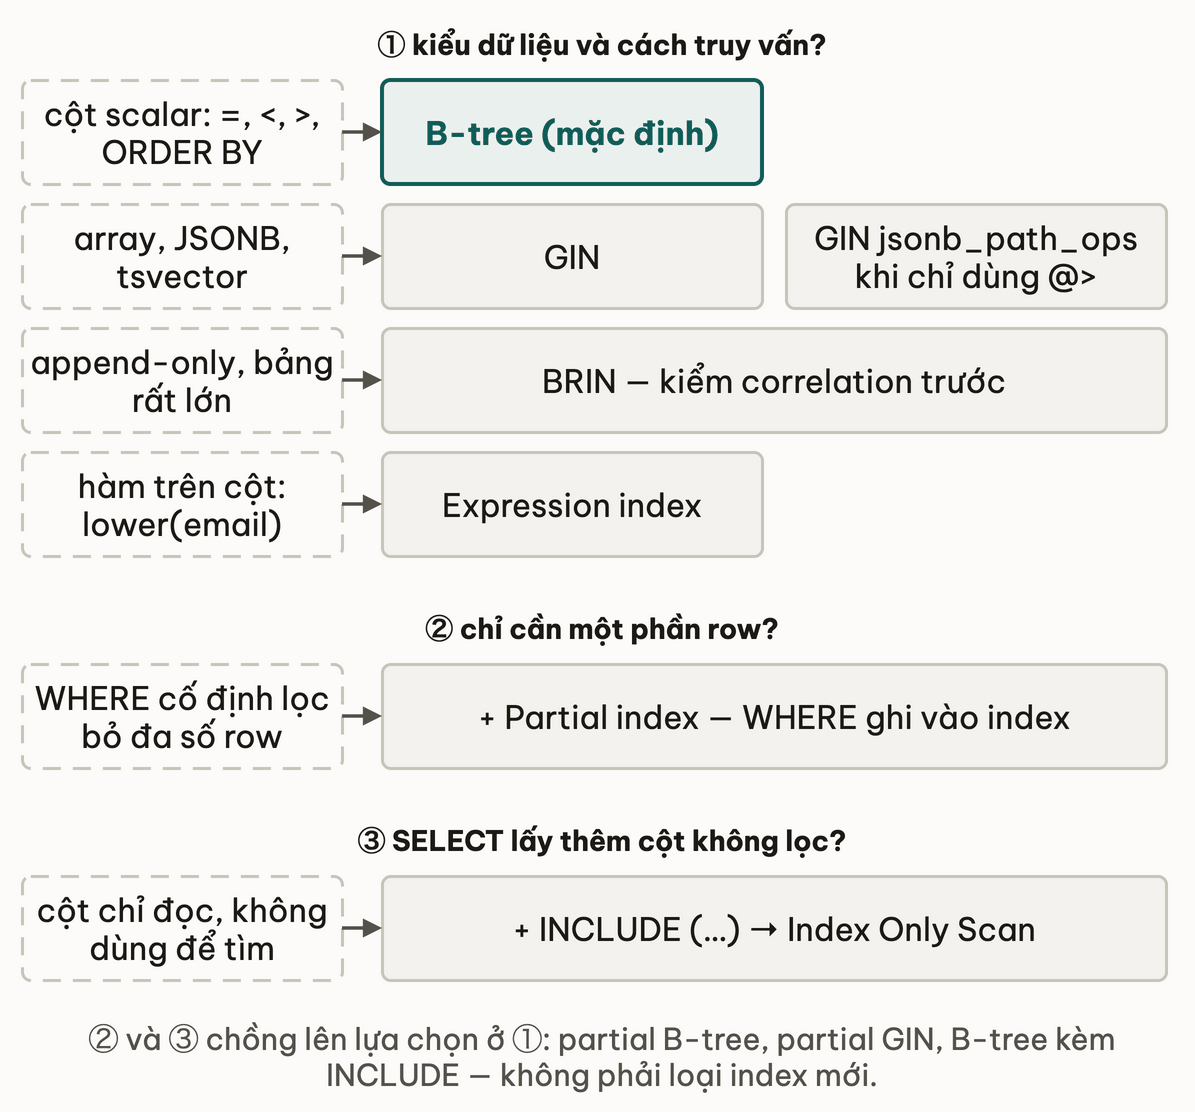
Partial và INCLUDE là hai lớp chồng được lên mọi loại: USING GIN (metadata) WHERE status IN ('todo','doing') là partial GIN; (LOWER(email)) WHERE verified = true là expression + partial.
8. Pitfall — ba cách dùng sai
GIN cho cột scalar (USING GIN (status)) trả 5–10x write cost mà equality không nhanh hơn B-tree. BRIN cho bảng nhiều UPDATE (tasks(created_at)) vô dụng vì thứ tự vật lý đã xáo, kiểm tra correlation trước, dưới 0,7 thì dùng B-tree. Partial index cho điều kiện hiếm (WHERE status = 'archived' chiếm 0,1% row) quá nhỏ để có ích và query hiếm khi khớp. Luôn đo bằng EXPLAIN (ANALYZE, BUFFERS) trước khi giữ index.
9. Applied — kế hoạch index cho TaskFlow
| Cột / pattern | Index | Lý do |
|---|---|---|
tasks.id (PK) | B-tree (tự tạo) | Scalar equality |
tasks(assignee_id, status, due_at) | B-tree composite | Equality + range, bài 03 |
tasks.metadata containment @> | GIN jsonb_path_ops | Đa giá trị, chỉ cần @> |
tasks.body_tsv (FTS) | GIN | Inverted token cho full-text |
task_history(event_at) | BRIN | Append-only, correlation ≈ 1 |
tasks(due_at) WHERE status IN ('todo','doing') | Partial B-tree | Bớt ~50% entry, đúng filter dashboard |
users(LOWER(email)) | Expression B-tree | Hàm trên cột, immutable |
Sau khi tạo, xác nhận planner thật sự chọn index bằng EXPLAIN (ANALYZE, BUFFERS) cho từng query đại diện: GIN và BRIN xuất hiện dưới dạng Bitmap Index Scan, partial và expression dưới dạng Index Scan on <tên index>.
10. Deep Dive — Specialized indexes
- PostgreSQL Documentation — "Index Types" — catalog chính thức 6 loại index, operator class, khi nào dùng từng loại.
- PostgreSQL Documentation — "Partial Indexes" — use case, cách planner khớp điều kiện partial với WHERE của query.
- Crunchy Data — "Postgres Indexes for Newbies" — decision guide ngắn với ví dụ thật cho từng loại index.
- PostgreSQL 14 Internals — Egor Rogov, Part V, GIN — free PDF: posting list, pending list, vacuum interaction của GIN.
11. Liên hệ các bài khác
- B-tree internals — mốc 1x write cost mà bảng ở mục 2 so với; đọc lại để thấy GIN 5–10x nghĩa là gì trên page split.
- GIN index cho JSONB — mổ sâu
jsonb_opsvsjsonb_path_ops, pending list và cách bulk load; tiếp nối mục 3. - Statistics và cost model —
pg_stats.correlationmà BRIN sống chết vào được planner tính và dùng ra sao. - Có index vẫn Seq Scan — ca thật: index có đó nhưng correlation thấp nên planner bỏ; đúng bẫy BRIN ở mục 4.
- Hash function và Bloom filter — CTDL đứng sau hash index và
jsonb_path_ops; bloom filter là ý tưởng cùng họ với "loại nhanh, không bao giờ bỏ sót" của BRIN.
12. Tóm tắt
- Thấy
@>hoặc?trên JSONB chạy Seq Scan: tạo GIN, chọnjsonb_path_opsnếu chỉ dùng@>. - Bảng append-only trên 10 triệu row query theo thời gian: thử BRIN trước, xác nhận
correlationtrên 0,9 trongpg_stats. - Query luôn kèm một điều kiện cố định và điều kiện đó lọc còn dưới 50% row: partial index, nhớ đưa đúng điều kiện vào mọi query muốn hưởng.
- Hàm trên cột trong WHERE: expression index với đúng biểu thức đó, hàm phải immutable.
- Sau mỗi lần tạo:
EXPLAIN (ANALYZE, BUFFERS)phải hiện tên index; không hiện thì index đang trả write cost mà không ai dùng.
Bài tiếp theo là mini-challenge: seed 1 triệu task rồi đưa dashboard từ 2,1 giây xuống dưới 50 ms qua bốn phiên bản index.
13. Tự kiểm tra
- Q1Vì sao GIN write chậm hơn B-tree 5–10x? Giải thích cơ chế cập nhật inverted list khi INSERT một row mới.
- Q2BRIN index nhỏ hơn B-tree hàng nghìn lần. Tradeoff cụ thể là gì? Khi nào BRIN trở nên vô dụng?
- Q3Phân biệt partial index và WHERE clause trong query thông thường. Khi nào partial index đáng tạo?
- Q4Expression index yêu cầu function phải immutable. Vì sao? Cho 1 ví dụ function không immutable và hậu quả nếu PG cho phép.
- Q5TaskFlow có query containment
metadata @> '{"priority":"high"}'chạy 1000 lần/phút. Chọn GIN jsonb_path_ops hay jsonb_ops? Giải thích tradeoff.
Bài tiếp theo: Mini-challenge dashboard tuning 2.1s → 50ms
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Composite index ordering — leftmost prefix và INCLUDE
Bài tiếpMini-challenge — TaskFlow dashboard 2.1s → 50ms
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này