GIN index cho JSONB — jsonb_ops vs jsonb_path_ops, partial GIN
@> trên 5 triệu row không index là Seq Scan hơn 3 giây. GIN tra ngược từ phần tử về row; bài so hai operator class, partial GIN, pending list và giá phải trả khi ghi.
TL;DR: B-tree so sánh cả giá trị theo thứ tự, nên không trả lời được "document nào chứa cặp key-value này". GIN (Generalized Inverted Index) lưu ngược lại: từ mỗi key và value tới danh sách row chứa nó, nên @> chỉ cần tra vài entry rồi giao danh sách. Có hai operator class: jsonb_ops (mặc định) tách key và value thành entry riêng, hỗ trợ cả ?, ?|, ?&; jsonb_path_ops băm cả đường dẫn thành một entry, index nhỏ hơn và @> nhanh hơn, nhưng không hỗ trợ ba operator hỏi key. Giá phải trả là ghi: mỗi INSERT cập nhật nhiều entry, GIN đỡ bằng pending list, và index nào không ai dùng thì pg_stat_user_indexes sẽ chỉ ra để bạn drop.
WHERE task_metadata @> '{"priority":"high"}' trên bảng tasks 5 triệu row, không có index, chạy Seq Scan và mất hơn 3 giây. Thêm B-tree trên cột JSONB? B-tree không biết cách so sánh containment. Cần một loại index khác.
Khoá PostgreSQL Internals đã giới thiệu GIN ở mức tổng quan cùng BRIN, partial và expression index. Bài này đi sâu vào GIN riêng cho JSONB: hai operator class, tradeoff về size và tốc độ ghi, partial GIN cho subset nóng, và các pitfall khi bảng production ghi nhiều.
1. Analogy — mục lục sách và bảng tra chủ đề
| Tra cứu | Tương đương index | Cách hoạt động |
|---|---|---|
| Mục lục chính (trang → chủ đề) | B-tree | Sort theo key, binary search tìm chính xác |
| Bảng tra chủ đề ("từ khoá → các trang chứa từ") | GIN | Mỗi element → danh sách trang/row chứa nó |
| Tìm chương có từ "index" | GIN containment @> | Tra "index" trong bảng chủ đề → nhận list row |
B-tree là mục lục theo thứ tự: nhanh cho tìm chính xác và range có sort. GIN là bảng tra "từ khoá → các trang chứa từ", trả lời câu hỏi "document nào chứa element X?". JSONB containment (@>) đúng là câu hỏi đó, bài toán GIN sinh ra để giải.
2. Vấn đề — @> trên 5M row không có index
TaskFlow mở rộng: bảng tasks 5 triệu row, mỗi row có task_metadata JSONB với priority, labels, estimate.
CREATE TABLE tasks (
  id            BIGSERIAL PRIMARY KEY,
  project_id    BIGINT NOT NULL,
  title         TEXT NOT NULL,
  status        TEXT NOT NULL DEFAULT 'todo',
  task_metadata JSONB NOT NULL DEFAULT '{}',
  created_at    TIMESTAMPTZ NOT NULL DEFAULT now()
);
-- task_metadata vi du:
-- {"priority": "high", "labels": ["deploy", "prod"], "estimate": {"hours": 4}}
-- {"priority": "low",  "labels": ["docs"],           "compliance_tag": "GDPR"}

EXPLAIN ANALYZE
SELECT * FROM tasks
WHERE task_metadata @> '{"priority":"high"}';
Seq Scan on tasks  (cost=0.00..198432.00 rows=5000 width=256)
                   (actual time=0.042..3127.451 rows=486234 loops=1)
  Filter: (task_metadata @> '{"priority": "high"}'::jsonb)
  Rows Removed by Filter: 4513766
Execution Time: 3189.204 ms
PostgreSQL đọc cả 5 triệu row, evaluate @> từng row. B-tree không giúp được vì nó không tách JSONB thành từng cặp key-value để index.
3. GIN tra ngược từ phần tử về row như thế nào?
GIN lưu mapping ngược: từng element (key, value) trong JSONB → danh sách CTID (row identifier) của các row chứa element đó. Đây chính là cấu trúc đã tách sẵn mà bài 01 nói chỉ JSONB có.
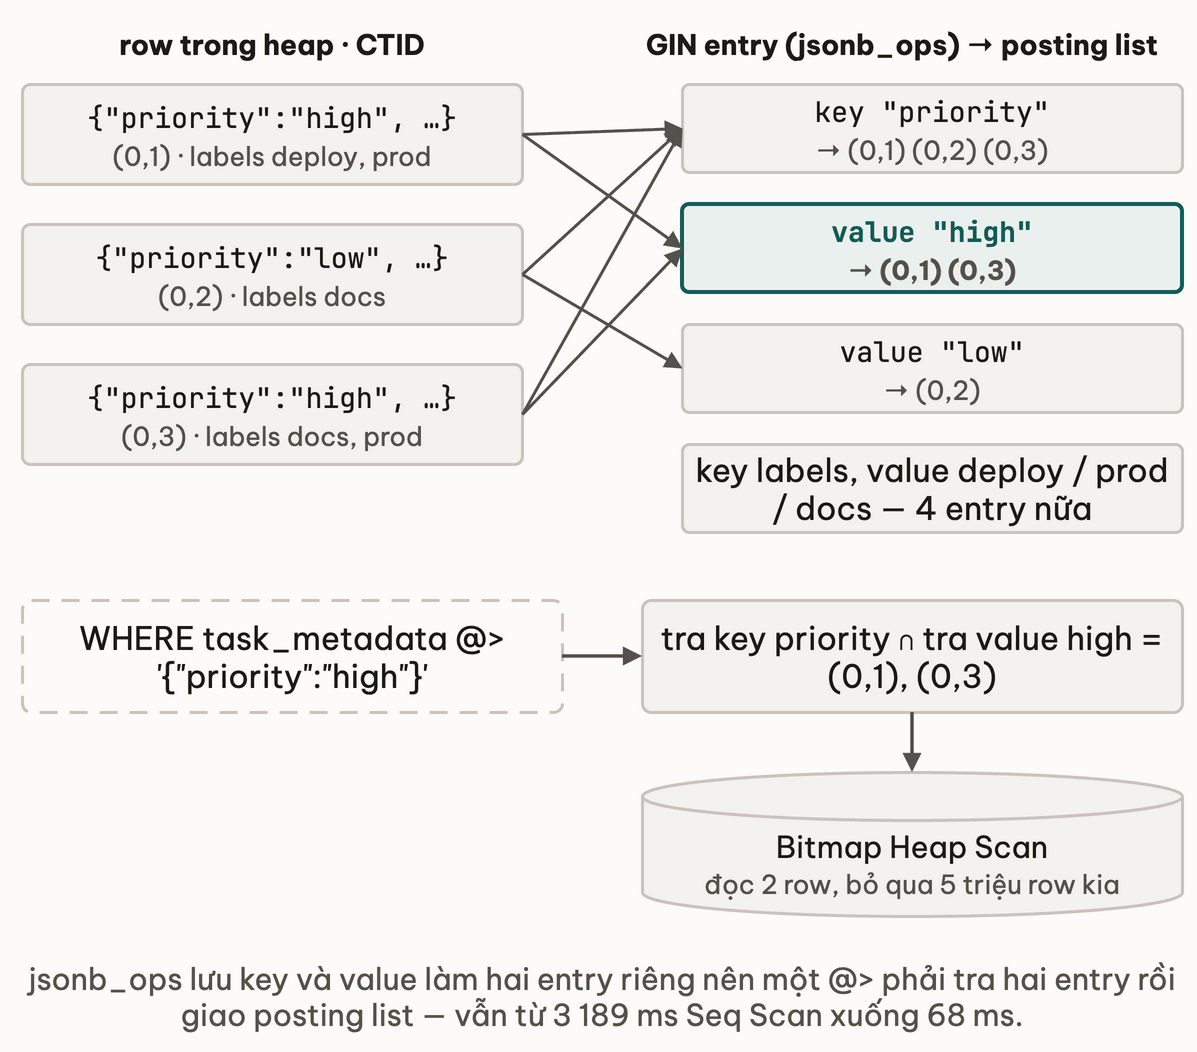
Kết quả query sau khi có GIN index:
Bitmap Heap Scan on tasks  (cost=312.45..8934.12 rows=486234 width=256)
                            (actual time=12.341..45.892 rows=486234 loops=1)
  Recheck Cond: (task_metadata @> '{"priority": "high"}'::jsonb)
  ->  Bitmap Index Scan on idx_tasks_metadata_full
        (actual time=11.203..11.203 rows=486234 loops=1)
        Index Cond: (task_metadata @> '{"priority": "high"}'::jsonb)
Execution Time: 68.547 ms
Từ 3189 ms xuống 68 ms trong demo này. Bitmap Index Scan (khoá Internals — scan strategies) build bitmap vị trí row từ GIN, rồi Bitmap Heap Scan đọc heap page theo thứ tự tuần tự.
Thử ngẫmEXPLAIN ANALYZE trước GIN báo 3189.204 ms, sau khi thêm index còn 68.547 ms. Chênh lệch đó đến từ việc PG bỏ qua bước nào, không phải từ CPU nhanh hơn?
4. jsonb_ops hay jsonb_path_ops — khi nào chọn cái nào?
PostgreSQL có hai operator class cho GIN trên JSONB:
-- jsonb_ops: mac dinh khi khong khai bao
-- Index moi key VA moi value RIENG LE
CREATE INDEX idx_tasks_metadata_full
ON tasks USING gin(task_metadata);

-- jsonb_path_ops: phai khai bao tuong minh
-- Chi index hash cua ca duong dan (key + value chuoi voi nhau)
CREATE INDEX idx_tasks_metadata_path
ON tasks USING gin(task_metadata jsonb_path_ops);
| Aspect | jsonb_ops (mặc định) | jsonb_path_ops |
|---|---|---|
| Index size | Lớn hơn | Nhỏ hơn rõ rệt (ít entry hơn) |
| Tốc độ ghi | Chậm hơn | Nhanh hơn (ít entry hơn) |
@> containment | Nhanh | Nhanh hơn (tra hash) |
?, ?|, ?& (hỏi key) | Hỗ trợ | Không hỗ trợ |
JSONPath @?, @@ | Hỗ trợ | Hỗ trợ (không có accessor .*, .**) |
| Use case chính | Cần hỏi key tồn tại | Chỉ dùng @> (phổ biến nhất) |
Vì sao jsonb_path_ops nhỏ hơn và nhanh hơn cho @>: thay vì lưu key "priority" và value "high" thành hai entry riêng, nó lưu hash của đường dẫn priority → high thành một entry. Ít entry hơn, index nhỏ hơn, fit cache tốt hơn, và mỗi @> là một lần tra hash thay vì hai lần tra rồi giao.
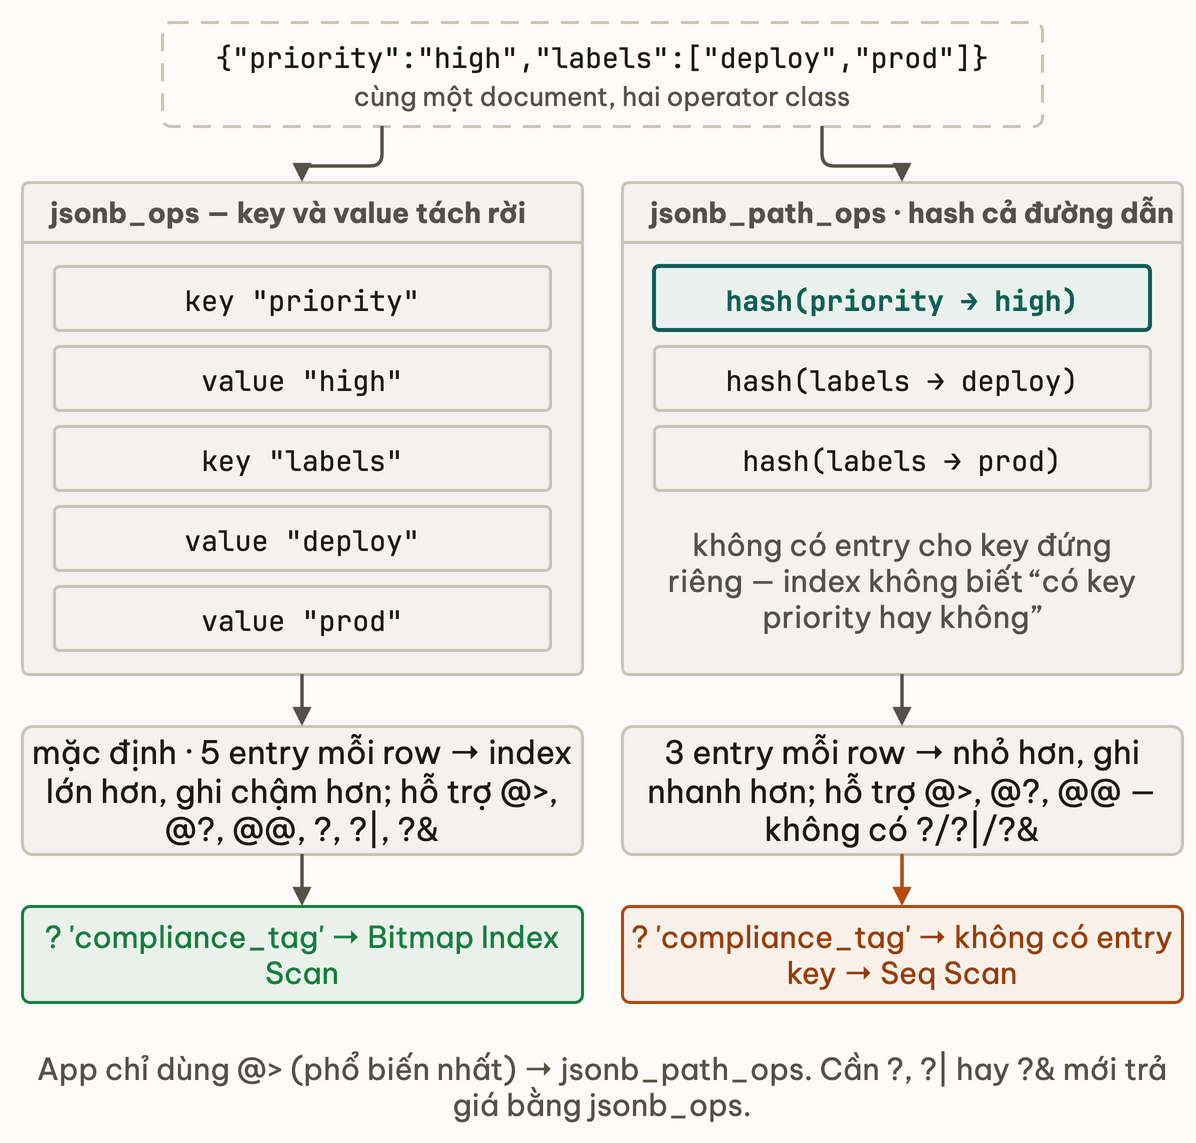
Trước khi đọc output dưới, hãy đoán: bảng chỉ có index jsonb_path_ops, câu WHERE task_metadata ? 'compliance_tag' sẽ dùng index hay Seq Scan?
-- 1) Containment @> -> ca 2 index deu dung duoc
EXPLAIN (COSTS OFF)
SELECT * FROM tasks WHERE task_metadata @> '{"priority":"high"}';
-- Bitmap Index Scan on idx_tasks_metadata_path

-- 2) Key exists ? -> CHI jsonb_ops
EXPLAIN (COSTS OFF)
SELECT * FROM tasks WHERE task_metadata ? 'compliance_tag';
-- Bitmap Index Scan on idx_tasks_metadata_full
-- (Neu chi co jsonb_path_ops: Seq Scan)

-- 3) JSONPath @@ -> ca 2 index deu dung duoc
EXPLAIN (COSTS OFF)
SELECT * FROM tasks WHERE task_metadata @@ '$.estimate.hours > 5';
-- Bitmap Index Scan (jsonb_ops hoac jsonb_path_ops)
Index jsonb_path_ops không có entry cho key đứng riêng, nên nó không biết "row nào có key compliance_tag", và planner bỏ qua nó. App chỉ dùng @> thì chọn jsonb_path_ops; cần ?, ?|, ?& mới trả giá bằng jsonb_ops.
5. Partial GIN và expression GIN — index đúng subset
Partial index thêm WHERE vào CREATE INDEX, chỉ index row thoả điều kiện. Kết hợp với GIN: index nhỏ hơn, nhanh hơn cho subset nóng.
-- Chi index task co key 'priority'
CREATE INDEX idx_tasks_metadata_priority
ON tasks USING gin(task_metadata)
WHERE task_metadata ? 'priority';

-- Query phai mang dieu kien khop de planner dung partial index
SELECT * FROM tasks
WHERE task_metadata @> '{"priority":"high"}'
  AND task_metadata ? 'priority';
-- Bitmap Index Scan on idx_tasks_metadata_priority

-- Expression GIN: chi index sub-document labels
CREATE INDEX idx_tasks_labels
ON tasks USING gin((task_metadata -> 'labels'));

SELECT * FROM tasks
WHERE task_metadata -> 'labels' @> '["prod"]';
-- Bitmap Index Scan on idx_tasks_labels

-- Ket hop: partial (chi high priority) + jsonb_path_ops (chi @>)
CREATE INDEX idx_tasks_metadata_hot
ON tasks USING gin(task_metadata jsonb_path_ops)
WHERE task_metadata @> '{"priority":"high"}';
Expression GIN chỉ đáng khi query theo labels là workload chính. Với partial index, query phải lặp lại đúng điều kiện WHERE của index, nếu không planner không chứng minh được index cover đủ row.
6. Pitfall — write tax, JSON thay vì JSONB, pending list
Pitfall 1 — GIN ghi chậm hơn B-tree, và index thừa vẫn tính tiền:
Một row JSONB có 6 cặp key-value là 6 lần cập nhật posting list mỗi INSERT, so với một lần của B-tree. Bảng ghi nhiều mà mang 3–4 GIN index thì INSERT chậm đi thấy rõ. Đo trên bảng của bạn thay vì tin hệ số, và audit index không ai dùng:
-- idx_scan = 0 sau 7 ngay -> co the drop
SELECT indexname, idx_scan, pg_size_pretty(pg_relation_size(indexrelid)) AS size
FROM pg_stat_user_indexes
WHERE relname = 'tasks' AND indexname LIKE '%metadata%';
Pitfall 2 — GIN chỉ index được JSONB, không phải JSON:
CREATE INDEX bad_idx ON tasks USING gin(settings);
-- ERROR: data type json has no default operator class for access method "gin"

-- FIX: migrate column sang JSONB truoc
ALTER TABLE tasks ALTER COLUMN settings TYPE JSONB USING settings::jsonb;
CREATE INDEX idx_tasks_settings ON tasks USING gin(settings jsonb_path_ops);
Pitfall 3 — pending list làm INSERT nhanh nhưng search chậm dần:
GIN có cơ chế pending list (fastupdate, bật mặc định): INSERT ghi entry vào một danh sách tạm chưa sort thay vì chèn ngay vào cây chính. Entry được dồn vào cây khi VACUUM/autovacuum chạy, khi bạn gọi gin_clean_pending_list(), hoặc khi danh sách vượt gin_pending_list_limit (mặc định 4MB); ở trường hợp cuối, chính backend đang INSERT phải làm việc dọn đó nên câu INSERT ấy chậm đột ngột. Row vừa insert vẫn tìm thấy ngay, vì mỗi search phải quét cả pending list; danh sách càng dài thì search càng chậm.
-- Xem pending list dang to bao nhieu (extension pgstattuple)
CREATE EXTENSION IF NOT EXISTS pgstattuple;
SELECT pending_pages, pending_tuples
FROM pgstatginindex('idx_tasks_metadata_full');

-- Tang nguong cho bang ghi theo dot (per index)
ALTER INDEX idx_tasks_metadata_full SET (gin_pending_list_limit = 65536);  -- kB

-- Don pending list vao cay chinh ngay (khong cho autovacuum)
SELECT gin_clean_pending_list('idx_tasks_metadata_full'::regclass);
Thử ngẫmbảng audit_logs ghi 200 record/giây đều đặn, không burst, và autovacuum chạy thưa. Tăng gin_pending_list_limit lên 64MB làm search nhanh hơn hay chậm hơn, và vì sao?
7. Applied — product catalog filter theo attribute
Use case kiểu e-commerce: attribute khác nhau theo category, filter @> là query chính.
CREATE TABLE products (
  id         BIGSERIAL PRIMARY KEY,
  name       TEXT NOT NULL,
  category   TEXT NOT NULL,
  price      NUMERIC(10,2) NOT NULL,
  attributes JSONB NOT NULL DEFAULT '{}'
  -- {"color":"red","size":"M","tags":["sale","new"]}
  -- {"screen_size":"15.6","ram_gb":16,"brand":"Dell"}
);

CREATE INDEX idx_products_attr
ON products USING gin(attributes jsonb_path_ops);

-- Multi-attribute + B-tree tren cot khac
SELECT id, name, price
FROM products
WHERE attributes @> '{"color":"red","size":"M"}'
  AND category = 'fashion'
  AND price < 500000;
-- Plan: BitmapAnd giua Bitmap Index Scan (GIN) va Bitmap Index Scan (B-tree)
8. Bulk load — tắt GIN khi insert hàng loạt
GIN ghi posting list cho mỗi key-value trong mỗi row, nên bulk INSERT với GIN đang sống chậm hơn nhiều so với insert xong rồi build index một lần.
DROP INDEX idx_tasks_metadata_full;

COPY tasks (project_id, title, status, task_metadata)
FROM '/path/to/tasks_export.csv' WITH (FORMAT csv, HEADER true);

-- GIN build dung nhieu RAM hon B-tree
SET maintenance_work_mem = '1GB';  -- mac dinh 64MB
CREATE INDEX idx_tasks_metadata_full
ON tasks USING gin(task_metadata jsonb_path_ops);
RESET maintenance_work_mem;

VACUUM ANALYZE tasks;
Không drop được index (bảng đang có traffic) thì nâng gin_pending_list_limit cho riêng index đó trong đợt import, rồi gọi gin_clean_pending_list() khi xong.
9. Deep Dive
- PostgreSQL Documentation — "GIN Indexes": cấu trúc GIN, operator class API,
fastupdate, vacuum. Mục GIN Fast Update Technique nói rõ pending list được dọn khi nào và vì sao search phải quét cả nó. - PostgreSQL Documentation — "jsonb Indexing": định nghĩa chính thức
jsonb_opsvàjsonb_path_opshỗ trợ operator nào. - PostgreSQL 14 Internals — Egor Rogov, Part V: PDF miễn phí từ Postgres Pro; phần GIN giải thích posting list, pending list và merge chi tiết hơn docs.
10. Liên hệ các bài khác
- Bài 02 — JSONB operators: operator bạn viết trong WHERE quyết định operator class ở đây;
?cầnjsonb_ops,@>chạy với cả hai. - Bài 05 — Full-text search: cùng một GIN, đổi element từ key-value sang lexeme của
tsvector. - Bài 07 — Mini-challenge: GIN jsonb_path_ops gộp với GIN tsvector và B-tree bằng BitmapAnd trong một query.
- Scan strategies (khoá Internals): đọc Bitmap Index Scan và Recheck Cond trong plan của bài này.
- VACUUM và dead tuple (khoá Internals): autovacuum cũng là thứ dọn pending list của GIN, nên chỉnh autovacuum ảnh hưởng thẳng tới search.
11. Tóm tắt
- Trước khi gõ
CREATE INDEX, grep code tìm?,?|,?&trên cột đó: không có thìjsonb_path_ops, có thìjsonb_ops(hoặc hai index, một cho@>nóng). - Query không dùng partial index? Kiểm tra WHERE của query có lặp lại đúng điều kiện WHERE của index không.
- INSERT thỉnh thoảng chậm đột ngột trên bảng có GIN: xem
pgstatginindex(), nânggin_pending_list_limitper index hoặc để autovacuum dọn thường hơn. - Trước import lớn: drop GIN,
maintenance_work_mem = '1GB', build lại sau, rồiVACUUM ANALYZE. - Mỗi tháng chạy
pg_stat_user_indexes: GIN cóidx_scan = 0là đang trả tiền ghi cho không ai cả.
12. Tự kiểm tra
- Q1Tại sao B-tree không dùng được cho `WHERE task_metadata @> '{"priority":"high"}'` dù cột có B-tree? Giải thích cơ chế bên trong.
- Q2App có 3 pattern trên task_metadata: (1) `@> '{"priority":"high"}'`, (2) `? 'compliance_tag'`, (3) `@@ '$.estimate.hours > 5'`. Tạo index nào? Một index duy nhất có đủ không?
- Q3GIN có pending list: INSERT ghi vào đó trước, sau mới dồn vào cây chính. Điều này ảnh hưởng gì tới search và tới INSERT? Khi nào nên tăng `gin_pending_list_limit`?
- Q4Partial GIN với `WHERE task_metadata ? 'priority'` khác gì full GIN? Khi nào nó nhỏ hơn đáng kể mà vẫn cover query cần?
- Q5Sau 6 tháng, bảng tasks có 3 GIN index trên task_metadata và INSERT throughput giảm rõ. Diagnose và quyết định drop index nào như thế nào?
Bài tiếp theo: Hybrid schema pattern — column cứng + JSONB flexible
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên