pgvector — semantic search với embedding và HNSW trong PostgreSQL
Keyword search so chữ, không so nghĩa: 'fix payment bug' không ra 'resolve checkout error'. Bài dựng semantic search với pgvector, cosine distance và HNSW.
TL;DR: Full-text search so token, nên "fix payment bug" và "resolve checkout error" không bao giờ gặp nhau dù cùng nghĩa. Embedding model biến mỗi câu thành một vector, câu gần nghĩa thì vector gần nhau, và pgvector cho PostgreSQL lưu rồi sắp xếp theo khoảng cách đó; với text dùng cosine distance (<=>). Không index thì mỗi query tính khoảng cách với mọi row; HNSW (pgvector từ 0.5.0) dựng graph nhiều tầng để duyệt tới hàng xóm gần nhất mà không quét bảng, đổi lại kết quả là xấp xỉ, và khi thêm WHERE thì filter chạy sau index, có thể trả ít row hơn LIMIT. Model dùng lúc index phải là model dùng lúc hỏi.
User gõ "fix payment bug" vào TaskFlow. Trong database không có task nào mang đúng cụm đó; task thật tên "resolve checkout error". Keyword search trả về rỗng.
Đây không phải bug trong search implementation, mà là giới hạn căn bản của keyword search: nó so khớp ký tự, không so khớp ý nghĩa. Hai câu trên cùng ý mà không chung từ nào ngoài stopword. Embedding và vector similarity lấp khoảng trống đó, và với HNSW (pgvector 0.5.0, 2023) PostgreSQL làm được nhanh ngay trong database, không cần Pinecone hay Weaviate riêng.
1. Analogy — tìm bài hát tương tự
Tìm "bài hát tên có chữ love" là keyword search: Spotify trả mọi bài có "love" trong tên và bỏ qua "Someone Like You" dù cùng cảm xúc. Tìm "bài có cảm xúc giống bài này" là embedding search: hệ thống so mood, tempo, chủ đề lời, rồi trả bài gần nhất trong không gian đặc trưng đó.
| Tìm nhạc | Tương đương SQL |
|---|---|
| Tìm theo tên bài | WHERE title ILIKE '%love%' hoặc FTS (bài 05) |
| Tìm theo cảm xúc/ý nghĩa | ORDER BY embedding <=> $query_vector LIMIT 5 |
| Danh sách "bài tương tự" đã tính sẵn | HNSW graph nối mỗi vector với hàng xóm gần nhất |
| Đổi sang hệ gợi ý khác (Spotify → Apple) | Đổi embedding model, phải re-embed toàn bộ |
Keyword search so chữ. Embedding search so nghĩa. HNSW là graph "bài này liên kết với bài kia", duyệt graph để tìm nhanh. pgvector đưa cả ba vào PostgreSQL.
2. Embedding — text thành vector
Embedding model là neural network nhận một đoạn text và trả một mảng float có số chiều cố định:
"fix payment bug"        → [0.0234, -0.0156, 0.0892, ..., -0.0341]  (1536 float)
"resolve checkout error" → [0.0228, -0.0149, 0.0887, ..., -0.0338]  (1536 float)
"bake chocolate cake"    → [-0.1203, 0.0892, -0.0445, ..., 0.1123]  (1536 float)
Hai câu đầu có vector gần nhau; câu thứ ba thuộc domain khác, khoảng cách lớn. Vì sao hai câu khác từ lại gần nhau trong không gian vector là chuyện của khoá AI Core: Embedding — không gian nghĩa. Bài này dùng embedding như hộp đen.
| Model | Số chiều | Ghi chú |
|---|---|---|
| OpenAI text-embedding-3-small | 1536 | API, hỗ trợ cắt bớt chiều qua tham số dimensions |
| nomic-embed-text (Ollama) | 768 | Chạy local, privacy |
| all-MiniLM-L6-v2 (sentence-transformers) | 384 | Nhẹ, local |
Số chiều là thuộc tính của model. Cột trong PostgreSQL phải khai đúng số chiều của model bạn sẽ dùng.
3. pgvector — setup và schema
CREATE EXTENSION IF NOT EXISTS vector;

-- 1536 = text-embedding-3-small; 768 = nomic-embed-text; 384 = all-MiniLM-L6-v2
ALTER TABLE tasks ADD COLUMN embedding vector(1536);
-- NULL ban dau, fill sau khi goi embedding API
vector(1536) lưu 1536 float 4 byte. PostgreSQL kiểm tra số chiều lúc insert: đưa vector 768 chiều vào cột vector(1536) là lỗi ngay.
4. Vì sao text embedding dùng cosine distance thay vì L2?
pgvector có ba operator đo khoảng cách:
| Operator | Distance | Use case |
|---|---|---|
<-> | L2 (Euclidean): căn bậc hai tổng bình phương hiệu | Không gian hình học, image embedding |
<=> | Cosine distance = 1 − cosine similarity | Text embedding |
<#> | Negative inner product | Vector đã normalize, nhanh hơn cosine một chút |
Cosine chỉ đo góc giữa hai vector, không đo độ dài. "fix bug" và "fix bug fix bug fix bug" cùng nghĩa, cosine similarity cao, L2 lại khác vì vector dài hơn. Text embedding thường được normalize về unit sphere, nên inner product và cosine cho cùng thứ tự; cosine distance rõ nghĩa hơn khi đọc (Cosine similarity — khoá AI Core).
-- $1 = embedding cua "fix payment bug", tinh o app layer
SELECT id, title, embedding <=> $1 AS distance   -- 0 = giong het, 2 = nguoc nhau
FROM tasks
WHERE embedding IS NOT NULL
ORDER BY embedding <=> $1
LIMIT 5;

-- id=42  "resolve checkout error"    distance=0.0523
-- id=87  "payment gateway timeout"   distance=0.1034
-- id=156 "stripe webhook failing"    distance=0.1489
-- id=203 "billing service down"      distance=0.1892
-- id=318 "fix auth bug"              distance=0.2103
Ngưỡng "đủ giống" phụ thuộc model và dữ liệu; hãy lấy vài chục cặp thật, xem distance của chúng rồi mới chọn ngưỡng, thay vì tin một hằng số.
Thử ngẫm"fix auth bug" đứng thứ 5 với distance 0.2103 cho query "fix payment bug". Với ngưỡng bạn định chọn, task này nên xuất hiện hay bị lọc, và bạn kiểm chứng bằng dữ liệu nào?
5. HNSW tìm hàng xóm gần nhất mà không quét bảng như thế nào?
Không index, ORDER BY embedding <=> $1 tính khoảng cách với mọi row: 1 triệu task là 1 triệu phép tính vector. HNSW (Hierarchical Navigable Small World, pgvector từ 0.5.0, 2023) dựng sẵn một graph nhiều tầng:
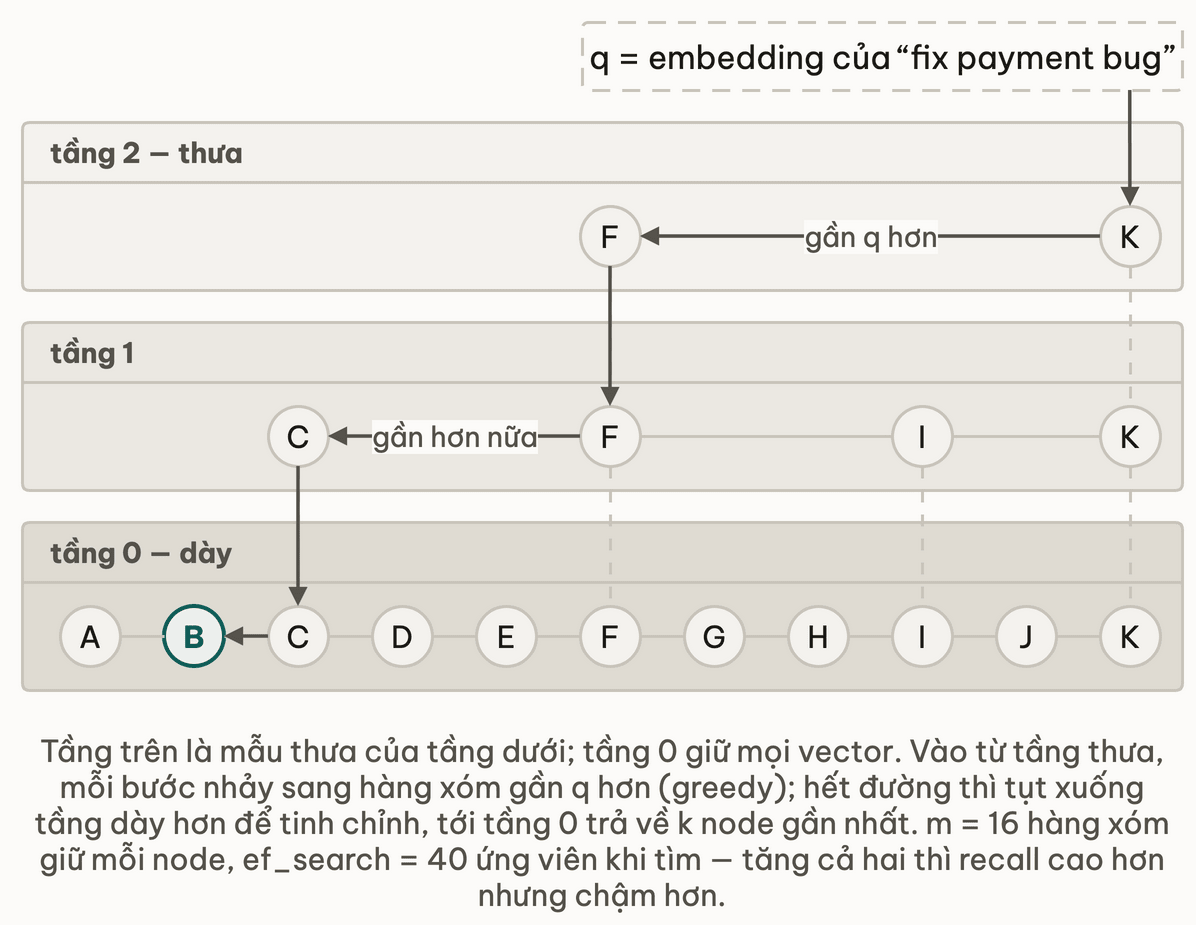
Tầng trên thưa, mỗi node nối với node "giống toàn cục" để nhảy nhanh tới đúng vùng; tầng 0 chứa mọi vector nối với hàng xóm gần nhất để tinh chỉnh. Query vào từ tầng trên cùng, mỗi bước đi về node gần query hơn, hết đường thì tụt xuống tầng dưới, tới tầng 0 trả về k node gần nhất.
CREATE INDEX idx_tasks_embedding
ON tasks USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
-- m: so hang xom moi node giu (mac dinh 16); tang -> recall tot hon, index lon, build cham
-- ef_construction: candidate list khi build (mac dinh 64); tang -> recall tot hon, build cham

-- Luc query: candidate list khi tim (mac dinh 40); tang -> recall tot hon, cham hon
SET hnsw.ef_search = 100;
| Metric | HNSW | IVFFlat |
|---|---|---|
| Tốc độ query, recall | Cao hơn | Thấp hơn |
| Build time | Chậm hơn | Nhanh hơn |
| Cần dữ liệu trước khi build | Không | Có (để chia cluster) |
Query-heavy, vài triệu vector, chọn HNSW. Cần build nhanh trên dataset rất lớn hoặc chấp nhận recall thấp hơn thì IVFFlat.
Thử ngẫmTaskFlow sắp bulk-import 8 triệu task cũ trong một đêm rồi mới bật search. Build HNSW ngay lúc import hay đợi xong rồi build, và vì sao?
6. Workflow end-to-end — từ tạo task đến "find similar"
App tính embedding, PostgreSQL chỉ lưu và so; database không tự gọi API embedding.
# App layer (Python, openai SDK)
def embed_task(task_id: int, title: str, description: str):
    text = f"{title}. {description}" if description else title
    response = openai.embeddings.create(input=text, model="text-embedding-3-small")
    embedding = response.data[0].embedding          # 1536 float
    conn.execute("UPDATE tasks SET embedding = %s WHERE id = %s", (embedding, task_id))
Backfill cho task đã có: lặp SELECT id, title, description FROM tasks WHERE embedding IS NULL ORDER BY id LIMIT 100, gọi API theo batch, UPDATE, tới khi hết. Chạy offline, không cần real-time.
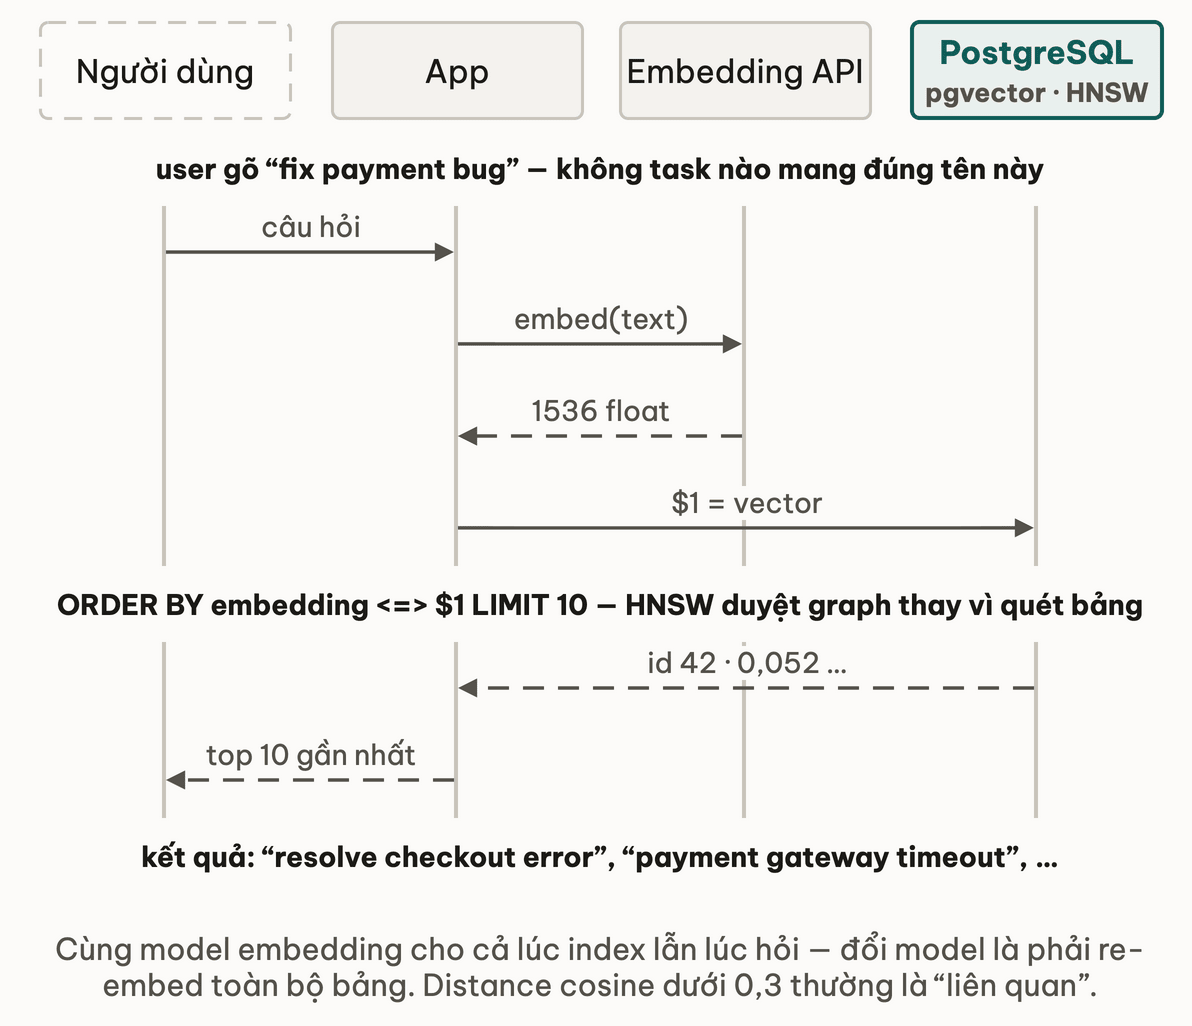
Query "find similar" scope theo project. Trước khi chạy, hãy đoán: project này chiếm khoảng 10% bảng, HNSW đã có, câu dưới trả về đủ 10 row không?
-- $1 = embedding cua cau user go, $2 = project_id
SELECT t.id, t.title, t.status, (embedding <=> $1) AS distance
FROM tasks t
WHERE t.project_id = $2
  AND t.embedding IS NOT NULL
ORDER BY embedding <=> $1
LIMIT 10;
Thường là ít hơn 10. Với index xấp xỉ, filter chạy sau khi index trả ef_search ứng viên gần nhất (mặc định 40); project chiếm 10% bảng thì trung bình chỉ ~4 trong 40 ứng viên qua được filter. Ba cách chữa: tăng hnsw.ef_search; bật iterative scan (pgvector 0.8.0+, SET hnsw.iterative_scan = relaxed_order) để index tự quét thêm tới khi đủ; hoặc partial HNSW index cho project lớn. EXPLAIN ANALYZE phải thấy Index Scan using idx_tasks_embedding; thấy Seq Scan là index chưa được dùng.
7. Text-to-SQL — teaser
Embedding search lo "tìm nội dung tương tự". Một AI feature khác cùng họ là Text-to-SQL: người dùng hỏi "top 10 người hoàn thành nhiều task nhất tháng trước", LLM nhận schema DDL cộng vài cặp câu hỏi/SQL mẫu và sinh ra câu SELECT. Nó sống ở app layer, không phải trong PostgreSQL; phần database chỉ có một việc: cho LLM một role read-only trên allowlist bảng và chạy mọi câu nó sinh trong BEGIN READ ONLY với statement_timeout. Cách ghép LLM với retrieval nằm ở RAG pipeline — khoá AI Core.
8. Pitfall — storage, model consistency, hybrid
Pitfall 1 — storage:
1536 float × 4 byte = 6 KB mỗi row; 1 triệu task là 6 GB riêng cột embedding, chưa kể HNSW index cỡ tương đương (tuỳ m). Hai cách giảm: halfvec (pgvector 0.7.0+) lưu float 2 byte, còn 3 KB/row; hoặc cắt bớt chiều ở phía model (dimensions=256 với text-embedding-3-small). Binary quantization (bit, cũng từ 0.7.0) nhỏ hơn nữa nhưng lossy, hợp làm bước lọc thô rồi re-rank bằng vector đầy đủ.
ALTER TABLE tasks ADD COLUMN embedding_half halfvec(1536);
Pitfall 2 — model consistency và giới hạn chiều:
Index bằng text-embedding-3-small (1536) thì mọi query phải embed bằng đúng model đó. Đổi sang model 3072 chiều là đổi type cột và re-embed cả bảng; và HNSW trên vector chỉ nhận tối đa 2.000 chiều, vượt thì phải dùng halfvec (tối đa 4.000). Encode model vào tên cột để không nhầm:
ALTER TABLE tasks ADD COLUMN embedding_te3s_1536 vector(1536);
-- doi model: them cot moi, khong sua cot cu
Pitfall 3 — vector search có thể miss exact match:
User gõ đúng tên task "JIRA-1234" hay jargon nội bộ mà embedding model không biết; vector search rank thấp, FTS lại bắt được ngay. pgvector không có hybrid search sẵn: bạn tự ghép FTS top-N và vector top-N rồi rerank bằng CTE. Mẫu đầy đủ ở bài 07, phần Bonus.
9. Deep Dive
- pgvector — GitHub: README là tài liệu chính, có mục HNSW (tham số
m,ef_construction,ef_search), Iterative Index Scans, Half-Precision Vectors và Hybrid Search; CHANGELOG ghi HNSW từ 0.5.0,halfvectừ 0.7.0, iterative scan từ 0.8.0. - Crunchy Data — HNSW Indexes with Postgres and pgvector: hướng dẫn production về tuning
m/ef_constructionvà so sánh HNSW với IVFFlat. - LangChain — SQLDatabaseToolkit: API reference cho toolkit Text-to-SQL, nếu bạn muốn thử nhanh phần section 7 với một framework.
10. Liên hệ các bài khác
- Bài 05 — Full-text search: FTS so token, bài này so nghĩa; hai thứ bổ sung nhau trong hybrid search.
- Bài 07 — Mini-challenge: HNSW cộng FTS cộng JSONB trong một search box, kèm hybrid rerank.
- Semantic vs keyword (khoá AI Core): khi nào semantic search thắng và khi nào thua keyword.
- RAG pipeline (khoá AI Core): pgvector là bước retrieval; phần app-layer ghép LLM ở đó.
- Cache line và locality (khoá CS Memory): vì sao 6 KB mỗi vector và graph HNSW nằm ngoài cache là chuyện đáng bận tâm.
11. Tóm tắt
- Bật semantic search cần bốn thứ:
CREATE EXTENSION vector, cộtvector(n)đúng số chiều model, HNSW vớivector_cosine_ops, và app tính embedding cho cả lúc ghi lẫn lúc hỏi. - Query có filter trả thiếu row: tăng
hnsw.ef_search, bậthnsw.iterative_scan(0.8.0+), hoặc partial index. - Tính storage trước: 4 byte × số chiều × số row, nhân đôi cho index;
halfvec(0.7.0+) chia đôi. - HNSW trên
vectortối đa 2.000 chiều; model 3072 chiều cầnhalfvec.
12. Tự kiểm tra
- Q1Tại sao full-text search không giải được semantic gap? Cho ví dụ TaskFlow mà FTS vẫn miss dù đã stem.
- Q2Tại sao cosine distance thường được chọn cho text embedding thay vì L2? Khi nào L2 hợp hơn?
- Q3Giải thích `m` và `ef_construction` của HNSW. Muốn recall tốt hơn, chấp nhận index lớn hơn và build chậm hơn, chỉnh gì?
- Q4Query `WHERE project_id = $2 ORDER BY embedding <=> $1 LIMIT 10` trả về 4 row dù project có hàng nghìn task. Vì sao, và sửa thế nào?
- Q5TaskFlow có 5 triệu task với embedding 1536 chiều. Ước tính storage và đề xuất cách giảm.
Bài tiếp theo: Mini-challenge — TaskFlow advanced search (FTS + JSONB + vector)
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên