Semantic search vs keyword search
Tìm theo nghĩa mạnh khi diễn đạt khác nhau, nhưng thua trắng trước mã lỗi, tên riêng, số hiệu phiên bản. Biết trước truy vấn nào sẽ hỏng — và khi nào cần hybrid.
TL;DR: Semantic search mạnh khi hai câu diễn đạt khác nhau mà cùng nghĩa (bài 01), nhưng trượt hẳn trước định danh chính xác: mã lỗi, tên endpoint, số phiên bản, số hoá đơn. Lý do nằm ở gốc. Những chuỗi đó không có khái niệm "gần nghĩa", chỉ có trùng hoặc không trùng, trong khi semantic lại đi tìm thứ nghe giống. Keyword search (BM25, xếp hạng theo tần suất và độ hiếm của từ khoá) khớp CHUỖI CHÍNH XÁC nên thắng ở loại truy vấn này. Hybrid chạy song song cả hai đường rồi gộp điểm, lấy được thế mạnh của cả hai thay vì phải chọn một.
Nhóm nghỉ phép ở bài 01 mừng ra mặt vì semantic search cuối cùng cũng tìm ra tài liệu HR dù nhân viên gõ khác hẳn từ khoá. Được đà, họ mở rộng cùng công cụ đó sang toàn bộ tài liệu kỹ thuật nội bộ: runbook, API doc, changelog. Tuần đầu, một kỹ sư gõ "mã lỗi ERR-PAYMENT-4023 là gì", mong ra đúng trang runbook xử lý mã đó. Hệ thống trả về một bài hướng dẫn cấu hình cổng thanh toán, không nhắc tới mã lỗi nào, mà điểm similarity vẫn cao vì cả hai đoạn đều "nói về thanh toán". Vài ngày sau, truy vấn "/api/v2/transfers dùng để làm gì" lại trả về tài liệu của /api/v2/withdrawals, một endpoint khác hẳn, chỉ chung cụm "chuyển khoản".
Cùng một công cụ vừa thắng đậm ở bài 01, giờ hỏng liên tiếp. Bài này giải thích vì sao, và quan trọng hơn, giúp bạn đoán trước loại truy vấn nào sẽ hỏng thay vì đợi người dùng report bug.
Bạn đã thấy tokenizer cắt một chuỗi lạ (số, mã, ký hiệu) thành nhiều mảnh subword theo quy tắc thống kê, không theo quy luật ngữ nghĩa nào. Bài này dùng lại đúng cơ chế đó: một mã lỗi bị cắt vụn thành các mảnh token rời rạc trước khi vào embedding, nên model không coi nó là MỘT đơn vị định danh. Nó chỉ thấy vài mảnh chữ và số.
1. Analogy: danh bạ điện thoại, mô tả mập mờ và số gọi chính xác
Bạn nhớ mang máng "anh nào bên vận hành, tên có chữ Minh, hay gọi lúc nửa đêm". Mô tả mập mờ vậy mà đồng nghiệp vẫn đoán ra đúng người, dù mỗi người kể một kiểu. Nhưng khi cần BẤM một số điện thoại thì chẳng có "số gần đúng" nào dùng được: bấm sai một chữ số cuối là bạn gọi trúng một người lạ hoắc, không phải "gần đúng người cần gọi" mà SAI HẲN.
| Đời thường | Tìm kiếm |
|---|---|
| Mô tả mập mờ ("anh gì bên vận hành") | Truy vấn diễn đạt tự do, không chứa định danh |
| Nhiều người đoán đúng ý dù khác cách nói | Semantic search: khớp theo nghĩa |
| Số điện thoại phải đúng từng chữ số | Mã lỗi, endpoint, version phải khớp đúng từng ký tự |
| Sai 1 chữ số là gọi nhầm người khác hẳn | Sai 1 ký tự là ra tài liệu khác hẳn |
Mô tả thì mập mờ vẫn ra đúng người; số điện thoại thì không có "gần đúng", chỉ có đúng hoặc gọi nhầm.
Analogy hỏng ở chỗ số điện thoại luôn là 10 chữ số cùng một khuôn, còn định danh trong hệ thống thật đủ hình dạng (chữ, số, gạch ngang, dấu chấm). Nhưng tính chất "không có gần đúng, chỉ có trùng hoặc sai" thì giữ nguyên.
2. Truy vấn nào sẽ hỏng?
Năm truy vấn dưới đây sẽ đi vào một hệ semantic search đã index toàn bộ tài liệu kỹ thuật nội bộ. Với mỗi truy vấn, đoán xem semantic search có trả về đúng tài liệu không. Viết "Được" hoặc "Hỏng" cho từng dòng trước khi đọc tiếp:
- "cách xử lý khi thanh toán bị treo"
- "mã lỗi
ERR-PAYMENT-4023là gì" - "endpoint nào xử lý chuyển tiền giữa hai tài khoản"
- "
/api/v2/transfersdùng để làm gì" - "phiên bản
v2.3.1sửa lỗi gì"
3. Vì sao ranh giới là "có định danh", không phải "chủ đề"?
Đối chiếu với dự đoán của bạn: câu 1 và 3 semantic làm tốt, câu 2, 4, 5 hỏng. Để ý câu 3 và câu 4 hỏi cùng một endpoint, chỉ khác cách hỏi. Ranh giới của cả bài nằm đúng ở đó. Câu 3 diễn đạt tự nhiên, không chứa chuỗi định danh, đúng bài toán semantic được huấn luyện để giải, giống ca "xin nghỉ phép năm" ở bài 01. Câu 4 chứa nguyên văn /api/v2/transfers, một chuỗi định danh literal, và semantic gãy ở chỗ đó.
Nhắc lại từ bài 01: không gian nghĩa được học bằng cách kéo gần các cặp mà dữ liệu huấn luyện coi là liên quan. Nhưng ERR-PAYMENT-4023 và ERR-PAYMENT-4024 không phải hai cách diễn đạt của cùng một ý. Chúng là hai khoá tra cứu độc lập, có thể trỏ tới hai lỗi chẳng liên quan gì nhau. Chưa tập huấn luyện nào dạy model "hai mã liền số thì cùng nghĩa", vì bản thân chúng không mang nghĩa để học. Vị trí của chúng trong không gian vector chỉ là hệ quả ngẫu nhiên của việc tokenizer cắt chúng ra sao, chẳng nói lên gì về việc hai mã có liên quan hay không.
embed("ERR-PAYMENT-4023 timeout khi goi cong thanh toan")
    -> tokenizer cat thanh cac manh subword: ["ERR", "-", "PAY", "MENT", "-", "402", "3", ...]
    -> embedding gop cac manh do lai thanh MOT vector chu de "thanh toan"
-- Doi 4023 thanh 4024, ranh gioi cat subword co the doi khac hoan toan
-- => khoang cach vector giua hai ma KHONG phan anh dang tin cay "cung loi hay khac loi"
Điểm cosine similarity (bài 02) vẫn tính ra một con số hợp lệ cho cặp (câu hỏi, tài liệu) chứa mã lỗi. Chỉ là con số đó đo thứ semantic đã học (chủ đề "thanh toán"), trong khi thứ bạn cần là khớp đúng khoá tra cứu.
Thử ngẫmmã đơn hàng dạng ORD-2024-8871 được dán vào một ô tìm kiếm ngữ nghĩa thay vì tra cứu chính xác. Theo cơ chế bài này, kết quả có đáng tin không, và vì sao?
4. Vì sao keyword/BM25 thắng ở đây?
BM25 (Best Matching 25) là thuật toán xếp hạng cho tìm kiếm từ khoá. Nó chấm điểm một tài liệu theo tần suất từ khoá xuất hiện trong tài liệu đó (term frequency) và độ hiếm của từ khoá trên toàn tập (inverse document frequency): từ càng hiếm mà xuất hiện càng nhiều lần, tài liệu càng được chấm cao. BM25 không đo "gần nghĩa", nó đo sự có mặt của đúng chuỗi/token.
Khi ERR-PAYMENT-4023 xuất hiện y nguyên trong một trang runbook, BM25 tìm ra ngay: điểm phụ thuộc vào chuyện mã đó có mặt hay không, chứ không vào chuyện trang đó "nghe có liên quan". Đây là mặt trái của điểm yếu keyword ở bài 01, khi "xin nghỉ phép năm" và "đăng ký ngày nghỉ" không chung từ khoá nên keyword tìm ra rỗng. Hai công cụ mạnh yếu ngược nhau: keyword hụt ở những câu cùng ý mà khác chữ, semantic hụt ở chuỗi định danh vốn không có "gần nghĩa".
Thử ngẫmô tìm kiếm nội bộ vừa nhận câu hỏi tự nhiên vừa nhận mã lỗi dán thẳng từ log. Chỉ được triển khai một công cụ trong hai: bạn ưu tiên bên nào, và đánh đổi gì?
5. Hybrid hoạt động thế nào?
Hybrid search là chạy song song hai công cụ độc lập trên cùng truy vấn, rồi gộp hai danh sách kết quả thành một bảng xếp hạng duy nhất:
function hybridSearch(query, docs):
    semanticResults <- semanticSearch(embed(query), docs)    -- xep hang theo cosine similarity
    keywordResults  <- keywordSearch(query, docs)             -- xep hang theo BM25 (khop tu khoa)
    combined <- mergeScores(semanticResults, keywordResults)  -- cong diem hoac gop theo thu hang
    return topK(combined)
// Time: O(chi phi hai duong tim kiem cong lai)  Space: O(so tai lieu ung vien)
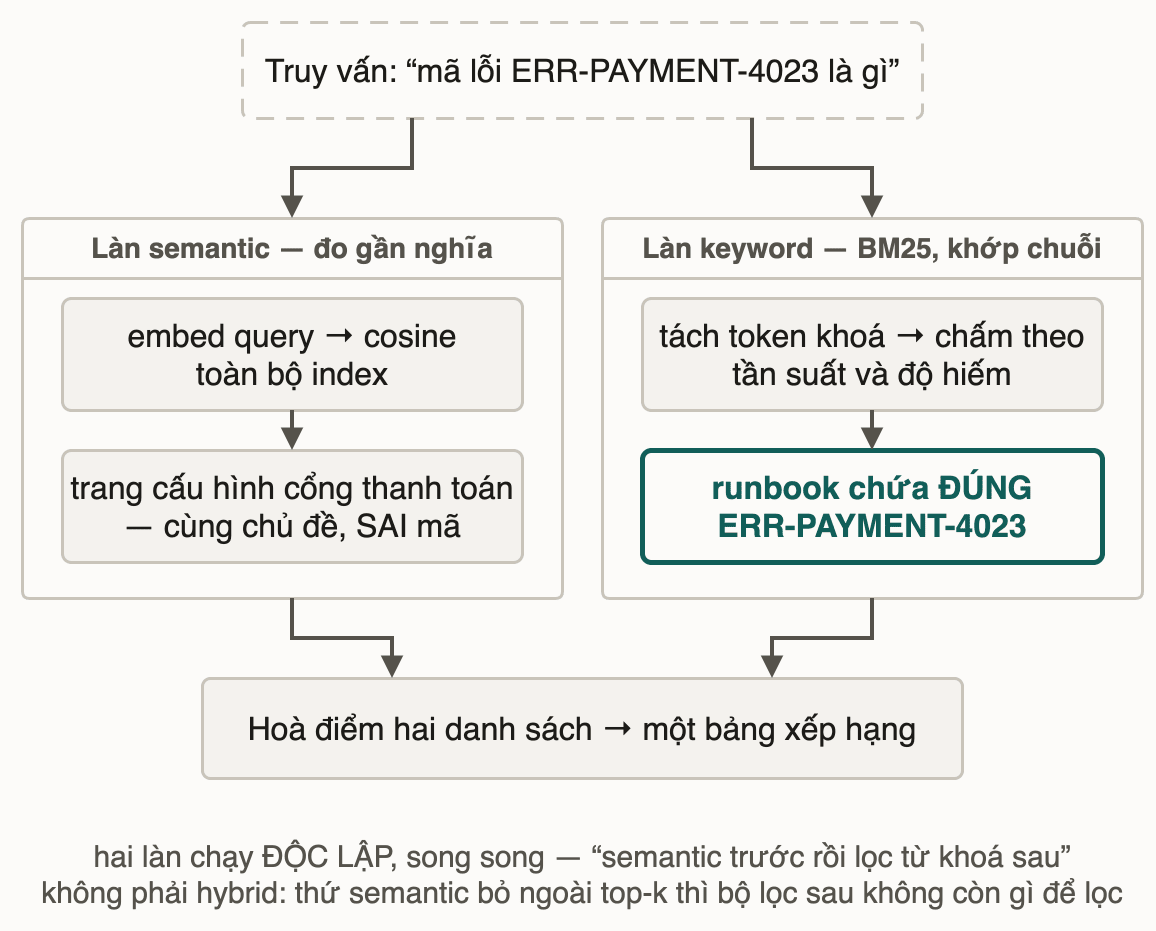
Hybrid giúp được bao nhiêu thì tuỳ tỉ lệ truy vấn chứa định danh trong domain của bạn, nên không có một con số "tăng recall X%" dùng chung. Chiều hướng thì rõ: trên tập truy vấn lẫn mã lỗi, endpoint, số phiên bản, hybrid thường vượt vector thuần rõ rệt, vì đường keyword bắt được đúng những gì đường semantic bỏ lỡ. Còn với truy vấn thuần diễn đạt tự nhiên, phần đóng góp của keyword gần như bằng không. Muốn biết con số cho hệ của mình thì đo trên truy vấn thật.
6. Pitfall tổng hợp
❌ Nhầm 1: coi hybrid là "semantic trước, lọc từ khoá sau".
✅ Lọc sau chỉ chạy trên kết quả semantic đã trả về. Nếu semantic không đưa ERR-PAYMENT-4023 vào top-k ban đầu, bộ lọc phía sau không còn gì để lọc. Hybrid đúng nghĩa chạy BM25 độc lập, song song, không phụ thuộc semantic có tìm thấy trước hay không.
❌ Nhầm 2: nghĩ thêm hybrid là xong.
✅ Trọng số gộp điểm giữa hai đường không có công thức mặc định đúng cho mọi domain. Hệ nhiều mã định danh (banking, DevOps) cần nghiêng về keyword hơn hệ tài liệu thuần văn bản (HR, chính sách nội bộ).
7. 📚 Deep Dive
- Muennighoff et al. — MTEB: Massive Text Embedding Benchmark (2022): cùng nguồn đã dẫn ở bài 01. Các task của benchmark đo tương đồng nghĩa và truy hồi theo chủ đề; không task nào đo "khớp định danh chính xác", đúng khoảng trống bài này nói tới.
Ghi chú: nguồn đối chiếu ngày 2026-07-23. Lập luận cơ chế trong bài suy ra từ tính chất embedding ở bài 01 và cơ chế subword ở module Cỗ máy LLM.
8. Liên hệ các bài khác
- Bài 01 — Embedding, không gian nghĩa: nguồn của "gần nghĩa", vì sao semantic mạnh ở diễn đạt khác nhau, và chính giới hạn đó gây ra thất bại ở bài này.
- Bài 02 — Cosine similarity: phép đo "gần" vẫn ra điểm số hợp lệ, chỉ là đo sai thứ cần đo khi truy vấn chứa định danh.
- Bài 04 — Chunking: cách cắt tài liệu ảnh hưởng cả semantic lẫn keyword, theo hai kiểu khác nhau.
- Bài 06 — RAG failure modes: retrieval chọn nhầm tài liệu (như ca
ERR-PAYMENT-4023đầu bài) là gốc của một loại hỏng cụ thể trong RAG. - Tokenization: cơ chế subword đứng sau việc định danh "vỡ vụn" trước khi vào embedding.
- Full-text search tiếng Việt (khoá PostgreSQL — Advanced & Scale): dựng nhánh keyword ngay trong PostgreSQL bằng
tsvectorvà GIN; nhánh semantic ở bài pgvector ngay sau đó.
9. Tóm tắt
- Câu 3 và câu 4 hỏi cùng một endpoint: hỏi tự nhiên thì semantic đúng, dán
/api/v2/transfersthì semantic hỏng. Ranh giới là cách hỏi, không phải chủ đề. ERR-PAYMENT-4023và4024đứng gần hay xa nhau trong không gian vector chỉ tuỳ tokenizer cắt ra sao, không nói gì về hai lỗi.- Hybrid phải chạy BM25 độc lập, song song; "semantic trước rồi lọc từ khoá" để lọt mất đúng tài liệu cần tìm.
- Trọng số gộp điểm và mức lợi của hybrid đều phải đo trên truy vấn thật của domain bạn.
10. Tự kiểm tra
- Q1Câu 'endpoint nào xử lý chuyển tiền giữa hai tài khoản' semantic trả đúng, còn '/api/v2/transfers dùng để làm gì' lại hỏng, dù cùng hỏi về một endpoint. Vì sao?
- Q2Một đồng nghiệp nói: 'mã lỗi ERR-PAYMENT-4023 và ERR-PAYMENT-4024 chắc gần giống nhau vì số liền nhau.' Dùng cơ chế tokenization và embedding để phản biện.
- Q3Vì sao nói keyword/BM25 và semantic search mạnh yếu ngược nhau? Điều đó giải thích gì về việc mỗi bên thắng đúng chỗ bên kia thua?
- Q4BM25 chấm điểm một tài liệu dựa trên điều gì? Vì sao cơ chế đó không bị 'lừa' bởi việc hai chuỗi định danh trông giống nhau?
- Q5Vì sao hybrid search chạy 'semantic trước rồi lọc từ khoá sau' không phải là hybrid đúng nghĩa?
- Q6Cho truy vấn 'cách reset mật khẩu khi quên email đăng ký': dự đoán semantic hay keyword sẽ thắng, và giải thích vì sao.
Bài tiếp theo: Chunking
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này