Tổng quan: Embedding, tìm kiếm & RAG
Bản đồ module: từ vector nghĩa tới quyết định kiến trúc. Prerequisite: module Cỗ máy LLM (đặc biệt bài tokenization).
TL;DR: Module này trả lời một câu hỏi rất cụ thể: làm sao để AI trả lời dựa trên tài liệu của bạn, thay vì chỉ dựa trên thứ nó đã học sẵn. Đường đi qua bốn cơ chế nối tiếp nhau: embedding biến văn bản thành vector nghĩa, cosine similarity đo "gần" bằng góc giữa hai vector, chunking cắt tài liệu dài thành đoạn vừa đủ trước khi tìm, và RAG ghép việc tìm (retrieve) với việc sinh câu trả lời (generate). Có điều "gần nghĩa" không phải lúc nào cũng là thứ cần: có loại truy vấn nó trượt hẳn, và đưa đúng đoạn tài liệu vào vẫn chưa chắc model dùng đúng. Module kết bằng một quyết định kiến trúc thật, không phải bài tập lý thuyết.
Vì sao module này tồn tại
Sếp bạn thấy demo chatbot LLM trả lời trôi chảy, rồi hỏi một câu tưởng đơn giản: "cho nó trả lời dựa trên tài liệu công ty mình được không?" Câu đó vỡ ngay thành ba câu nhỏ hơn. Làm sao để hệ thống "hiểu" một đoạn tài liệu đủ để so với câu hỏi của người dùng, khi hai câu có thể diễn đạt khác hẳn mà cùng một ý? Với hàng nghìn trang tài liệu, làm sao tìm đúng vài đoạn liên quan nhất thay vì nhét cả kho vào mỗi câu hỏi? Và tìm được đoạn rồi, làm sao ghép nó với model sinh văn bản để ra câu trả lời mạch lạc, có nguồn, chứ không phải model tự bịa?
Ba câu hỏi đó ứng với ba tầng của module: embedding trả lời câu đầu, chunking + tìm kiếm trả lời câu hai, RAG trả lời câu ba. Nhưng module không dừng ở "dựng được RAG là xong". Chuyện hay gặp hơn nhiều là RAG chọn nhầm đoạn, hoặc chọn đúng đoạn mà vẫn sinh sai. Lại có những bài toán nghe y hệt "chatbot hỏi đáp trên tài liệu" mà đáp án đúng là không cần RAG chút nào. Học xong module, bạn biết cả lúc nên dùng lẫn lúc nên thôi, thứ mà người ra quyết định kiến trúc cần hơn nhiều so với biết mỗi cách dựng.
Sau module này bạn sẽ
- Explain embedding ánh xạ văn bản thành vector trong không gian nghĩa, và vì sao chất lượng phụ thuộc task chứ không phụ thuộc kích thước
- Predict các truy vấn mà semantic search thua keyword search và khi nào cần hybrid
- Trace pipeline RAG từ query tới câu trả lời qua embed → retrieve → context → generate
- Diagnose một hệ RAG hỏng ở retrieval hay generation theo taxonomy bốn failure mode
- Justify lựa chọn prompt-only vs RAG vs fine-tune cho use case cụ thể, kèm rủi ro và chi phí
Lộ trình module
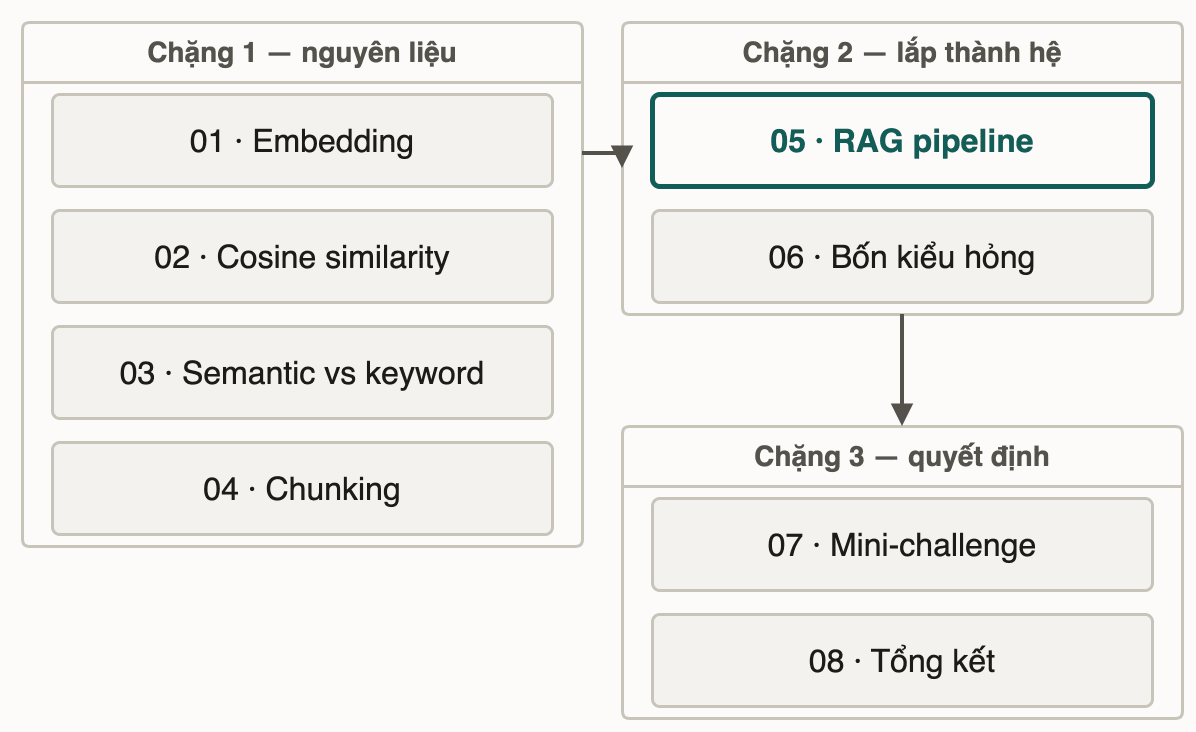
Tám bài đi theo một chuỗi phụ thuộc chặt, bài sau dùng lại khái niệm của bài ngay trước. Bài 01 dựng nền: embedding là gì, và vì sao "model nào tốt nhất" là câu hỏi đặt sai. Bài 02 định nghĩa chính xác chữ "gần" mà bài 01 dùng, tức cosine similarity, cùng lý do điểm cao chưa chắc đúng ý người dùng. Bài 03 lật ngược thế mạnh đó: với mã lỗi, tên endpoint, số phiên bản, "gần nghĩa" thua khớp từ khoá, và hybrid ăn được cả hai. Bài 04 xử lý một giới hạn khác của embedding: tài liệu dài phải cắt thành chunk trước khi tìm, và cắt sai theo hướng nào cũng hỏng.
Bốn bài đầu là nguyên liệu. Bài 05 lắp chúng thành một pipeline RAG hoàn chỉnh và trace đủ năm bước từ câu hỏi tới câu trả lời. Bài 06 đối diện thực tế: pipeline chạy trơn tru chưa chắc ra kết quả đúng, và bốn failure mode có tên gọi chuẩn giúp bạn chẩn đoán thay vì đoán mò. Bài 07 là capstone: ba bài toán nghe giống hệt nhau, bạn tự chọn kiến trúc, và có ca đáp án đúng là bỏ RAG hẳn. Bài 08 gom lại thành cheat sheet và tự đánh giá theo đúng năm outcome ở trên.
Yêu cầu trước khi bắt đầu
- Module Cỗ máy LLM, đặc biệt bài Tokenization (dùng lại ở bài 01, 03, 07) và bài Context window (dùng lại ở bài 04).
- Không cần cài công cụ hay môi trường gì thêm: cả module chỉ dùng pseudocode để minh hoạ cơ chế, không có bài lab code chạy được.
Time budget
| Bài | Nội dung | Thời gian |
|---|---|---|
| 01 | Embedding: không gian của nghĩa | 13 phút |
| 02 | Cosine similarity | 11 phút |
| 03 | Semantic vs keyword search | 12 phút |
| 04 | Chunking | 12 phút |
| 05 | RAG pipeline | 13 phút |
| 06 | Bốn kiểu hỏng của RAG | 13 phút |
| 07 | Mini-challenge: chọn kiến trúc | 20 phút |
| 08 | Tổng kết module | 6 phút |
Tổng khoảng 1h40: 1h20 đọc (bài 01–06, 08) cộng 20 phút lab (bài 07).
Cách học module này hiệu quả
- Đừng nhảy cóc. Bài 03 dựa vào cơ chế đã dựng ở bài 01, bài 06 dựa vào pipeline trace ở bài 05; đọc lệch thứ tự thì phần lớn "vì sao" trong bài sẽ trống.
- Gặp callout "Thử đoán" thì viết dự đoán ra trước khi đọc tiếp. Module dùng mẫu này thường xuyên, và phần giải thích ngay sau chỉ có tác dụng khi bạn đã tự đoán.
- Đến bài 06, tự phân loại ticket khó nhất trước khi đọc đáp án. Ba bước "đáp án có trong kho không, có được retrieve không, rồi mới hỏi generation" chỉ nhớ được khi bạn tự chạy qua một lần.
- Ở bài 07, viết hẳn câu trả lời cho cả ba ticket rồi mới cuộn xuống lời giải. Mini-challenge này chấm bằng lập luận, không có một đáp án đúng tuyệt đối.
- Nếu một khái niệm nghe quen quen (context window, subword tokenization), mở
Recallgắn trong bài ra đọc thay vì đoán. Vài dòng ôn thường quyết định bạn hiểu đúng hay hiểu lệch phần còn lại.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng kết: Transformer & attention
Bài tiếpEmbedding — không gian của nghĩa
Thảo luận & góp ý
Hỏi đáp về bài này