Tổng quan: Cỗ máy LLM
Bản đồ module và nền tối thiểu: model là hàm học từ dữ liệu, train khác inference, output là phân phối xác suất. Rồi sáu mảnh của cỗ máy sinh văn bản.
TL;DR: Module này tháo đúng một cỗ máy: LLM sinh văn bản bằng cách lặp một vòng gồm tokenize, nhìn context, tính phân phối xác suất cho token kế tiếp, chọn (sample) một token, decode, nối vào chuỗi rồi lặp lại. Sáu bài concept lần lượt đi qua từng mảnh của vòng lặp đó: bước dự đoán, đơn vị token, giới hạn context, cách chọn (sampling/temperature), vì sao chat model cư xử khác base model, và vì sao hallucination là hệ quả của cơ chế chứ không phải bug ngẫu nhiên. Học xong, bạn đọc một log lỗi LLM và chỉ ra được tầng nào hỏng thay vì đoán mò.
Vì sao cần hiểu cơ chế thay vì nhớ mẹo?
Bạn dùng LLM qua API mỗi ngày: chatbot hỗ trợ, sinh mô tả sản phẩm, tóm tắt tài liệu. Rồi những sự cố khó hiểu xuất hiện. Hoá đơn API tăng gần gấp đôi dự tính dù nội dung tiếng Việt không đổi nhiều. Bot được dặn một yêu cầu ở tin nhắn đầu, tới tin nhắn bốn mươi thì coi như chưa từng nghe. Temperature vặn lên "cho sinh động" lại ra câu rời rạc, lạc đề, chen chữ lạ. Hỏi cùng một câu ba lần trong ba phiên riêng thì nhận về ba đáp án khác hẳn nhau, một trong ba còn kèm chi tiết nghe rất thật nhưng hoàn toàn bịa.
Người ta hay gắn mỗi sự cố với một lời giải thích riêng: "chắc prompt chưa đủ tốt", "chắc hôm nay model tệ", "chắc phải đổi model xịn hơn". Thật ra cả bốn sự cố đều bắt nguồn từ một cơ chế: model dự đoán token kế tiếp, lặp đi lặp lại, và vòng lặp đó không có bước nào kiểm tra sự thật hay ghi nhớ dài hạn. Nắm được cơ chế thì bạn khỏi phải nhớ bốn lời giải thích rời rạc, vì tự suy ra được cả bốn, và đoán trước được cả sự cố thứ năm chưa từng gặp.
Nếu bạn vào thẳng module này, chưa học Module 1 (Bản đồ AI) hay Module 2 (Não nhân tạo vừa đủ), thì ba điều sau là đủ để không lạc ở bài 01:
- Model là một hàm học được từ dữ liệu. Hàng tỷ tham số (trọng số) được chỉnh dần qua quá trình train, chứ không phải một tập luật if-else do người viết tay.
- Train khác inference. Train là lúc trọng số được học: chạy một lần, tốn nhiều thời gian và tài nguyên. Inference là mỗi lần bạn gọi API: trọng số đã cố định, model chỉ tính toán trên đầu vào mới. Cả module này nói về inference.
- Output của model là một phân phối xác suất, không phải một câu trả lời tính sẵn. Bài 01 lần theo đúng bước này, mảnh đầu tiên và quan trọng nhất.
Sau module này bạn sẽ
- Trace vòng lặp sinh văn bản của LLM: tokenize → context → dự đoán phân phối → sample → decode
- Explain vì sao model xử lý token thay vì ký tự, và hệ quả với tiếng Việt, code và chi phí API
- Predict hành vi model khi context window tràn và khi temperature/top-p thay đổi
- Distinguish base model vs chat model qua vai trò của SFT và RLHF
- Diagnose hallucination từ cơ chế next-token thay vì coi nó là bug ngẫu nhiên
Lộ trình module
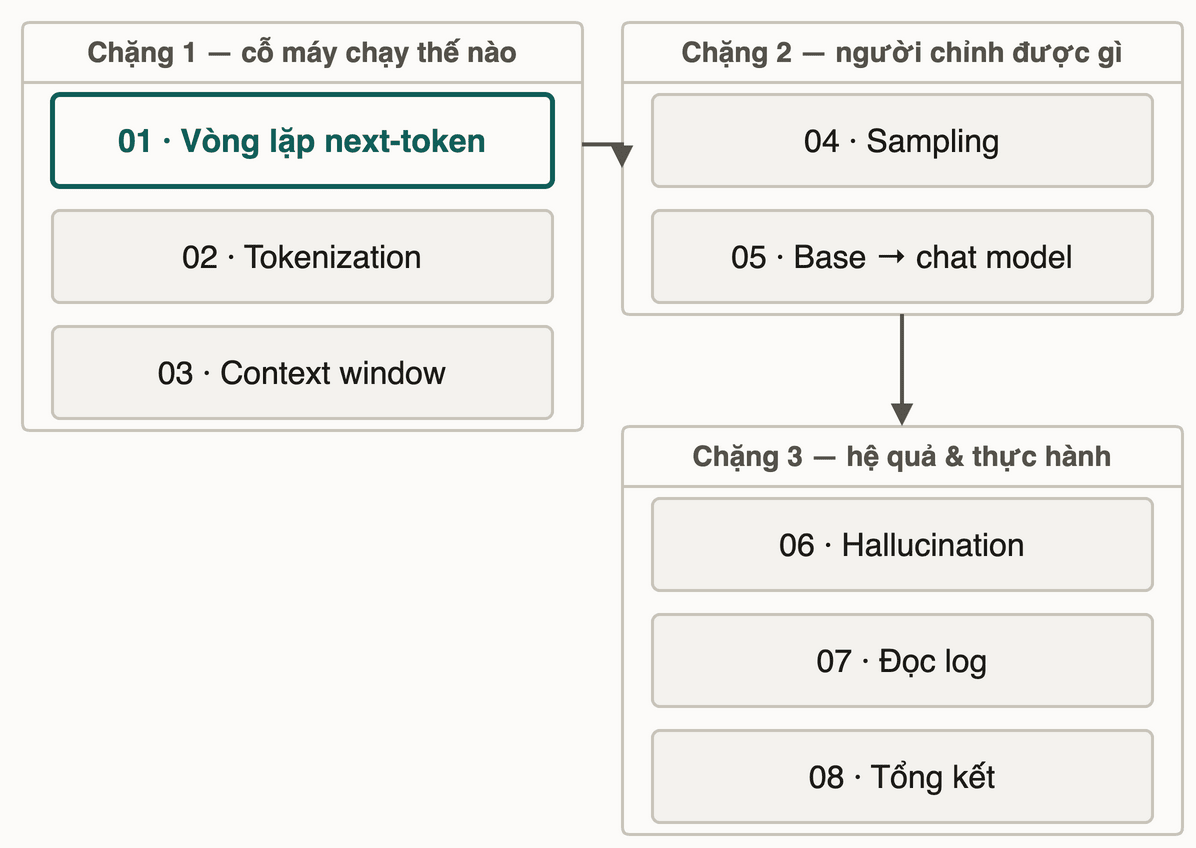
Sáu bài concept (01–06) xếp theo thứ tự phụ thuộc, không đảo được. Bài 01 dựng vòng lặp autoregressive, nền cho mọi bài sau. Bài 02 nói rõ đơn vị model xử lý (token), thứ cần biết trước khi bàn tới context window (đo bằng token) hay chi phí API (tính theo token). Bài 03 trả lời câu hỏi "toàn bộ token đứng trước" mà bài 01 nhắc tới thì lớn được tới đâu: đó là context window. Bài 04 đi vào bước "chọn" mà bài 01 mới nêu tên chứ chưa giải thích: sampling, temperature, top-p. Hết bài 04 là bạn có đủ cơ chế sinh văn bản thô.
Bài 05 rẽ sang trục khác. Cơ chế vẫn vậy, nhưng huấn luyện thêm (SFT rồi RLHF) đổi hành vi model ra sao: vì sao chat model biết dừng, biết trả lời thẳng, còn base model chỉ viết tiếp theo thống kê. Bài 06 gom ba bài 01, 03, 04 lại để giải thích hallucination: không phải bug, mà là thứ tất yếu xảy ra khi dữ liệu train lẫn context đều không cho model căn cứ.
Bài 07 là mini-challenge, không dạy khái niệm mới. Nó đưa ba log sự cố dựng theo tình huống hay gặp, bắt bạn tự chẩn đoán cơ chế gây ra từng cái bằng bốn công cụ vừa học (tokenization, context, sampling, hallucination) trước khi xem lời giải. Đây là chỗ kiểm tra bạn hiểu cơ chế hay chỉ nhớ tên. Bài 08 gói mọi thứ vào một cheat sheet và phần tự đánh giá theo năm learning outcome ở trên.
Yêu cầu trước khi bắt đầu
- Không bắt buộc học Module 1 hay Module 2 trước: module này tự đứng được, phần nền tối thiểu ở trên là đủ. Có thời gian thì hai module đó cho trực giác sâu hơn về "học từ dữ liệu" và "trọng số", hai thứ bài 05 có nhắc lại.
- Đã dùng chatbot AI hoặc gọi LLM API (ChatGPT, Claude, Gemini...) ít nhất vài lần, vì nhiều ví dụ giả định bạn đã thấy model cư xử ra sao trong thực tế.
- Không cần biết code ML, không cần Python. Pseudocode trong bài đọc được bằng logic lập trình thông thường, không gắn với ngôn ngữ nào.
Time budget
| Bài | Chủ đề | Thời lượng |
|---|---|---|
| 00 | Tổng quan (bài này) | ~5 phút |
| 01 | Dự đoán token kế tiếp | ~12 phút |
| 02 | Tokenization | ~13 phút |
| 03 | Context window | ~12 phút |
| 04 | Sampling: temperature & top-p | ~11 phút |
| 05 | Từ base model đến chat model | ~11 phút |
| 06 | Hallucination | ~13 phút |
| 07 | Mini-challenge: đọc log ba sự cố | ~15 phút |
| 08 | Tổng kết & cheat sheet | ~6 phút |
| Tổng | ~1 giờ 38 phút |
Cách học module này hiệu quả
- Làm nghiêm túc mọi ô "Thử đoán". Gần như bài nào cũng dừng lại bắt bạn viết dự đoán trước khi đọc giải thích. Bỏ bước này là bỏ luôn công cụ kiểm tra xem bạn đã hiểu cơ chế đủ để đoán, hay mới chỉ nhớ chữ.
- Đừng học bài 06 tách rời. Hallucination chỉ trọn nghĩa khi bạn đã nắm bài 01 (không có bước fact-check), bài 03 (context thiếu thông tin) và bài 04 (temperature làm phân phối phẳng). Ba bài đó là nguyên liệu trực tiếp của bài 06.
- Bài 07 là lúc kiểm tra thật. Chẩn đoán sai một log thì đừng đoán tiếp, quay lại đúng bài tương ứng (02/03/04/06) đọc lại phần cơ chế rồi mới xem lời giải.
Bài tiếp theo: Dự đoán token kế tiếp — vòng lặp sinh văn bản
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng kết Não nhân tạo vừa đủ: cheat sheet và tự đánh giá
Bài tiếpDự đoán token kế tiếp — vòng lặp sinh văn bản
Thảo luận & góp ý
Hỏi đáp về bài này