Mini-challenge: đọc log ba sự cố LLM
Ba log dựng theo sự cố hay gặp: bot đếm chữ sai, bot quên yêu cầu đầu hội thoại, bot trả lời loạn. Tự chẩn đoán cơ chế gây ra từng sự cố trước khi xem lời giải.
TL;DR: Ba báo cáo lỗi từ log request/response LLM đều mang cùng một nhãn vô dụng: "bot trả lời sai". Nhưng log gốc luôn có dấu vết định lượng (độ dài chuỗi, số token, tham số sampling), và mỗi sự cố để lại một kiểu dấu vết khác nhau. Bài này đưa bạn log thô để tự chẩn đoán cơ chế gây ra từng sự cố trước khi xem lời giải. Kỹ năng cần luyện là đọc ra dấu vết, không phải đoán từ triệu chứng bề mặt.
Ba log dưới đây được dựng lại theo những sự cố hay gặp khi đưa LLM vào sản phẩm nội bộ; tên ticket, tên service và con số là minh hoạ, không phải log của một hệ thống cụ thể.
Bạn là kỹ sư trực on-call tuần này cho ba sản phẩm nội bộ, cả ba cùng gọi một model LLM qua API. Sáng thứ Ba, kênh giám sát dồn về ba báo cáo lỗi cùng lúc. Người báo đầu tiên viết đúng một câu: "Bot trả lời sai, xem log giúp." Hai người còn lại viết y hệt, chỉ đổi tên bot.
Ba câu "bot trả lời sai" nghe giống hệt nhau, nhưng mở log ra thì mỗi log lộ ra một nguyên nhân khác. Việc của bạn chưa phải là sửa code, mà là đọc đúng log, tìm đúng con số và chỉ ra đúng cơ chế trước khi đề xuất cách sửa.
🎯 Đề bài — ba log, một buổi trực
Với mỗi log dưới đây, hãy tự trả lời trước khi đọc phần Gợi ý hay Lời giải: cơ chế nào gây ra sự cố, dữ kiện cụ thể nào trong log chứng minh điều đó, và hướng sửa hợp lý là gì.
Log 1 — Trợ lý rút gọn tiêu đề sản phẩm
[QA log — bot rút gọn tiêu đề sản phẩm, ticket #PROD-118]

Request gửi cho model:
  "Rút gọn tiêu đề sau còn tối đa 40 ký tự, giữ nguyên ý nghĩa chính:
  'Bàn phím cơ không dây RGB chống nước dành cho game thủ chuyên nghiệp'"

Response của model:
  "Bàn phím cơ RGB không dây chống nước gaming"
  (model tự thêm dòng cuối: "Độ dài: 40 ký tự — đạt yêu cầu.")

QA đếm lại thủ công (bôi đen chuỗi, xem bộ đếm ký tự của trình soạn thảo):
  43 ký tự thật. Tiêu đề bị cắt xén khi hiển thị trên thẻ sản phẩm.

Ghi chú của QA, sau khi thử thêm vài tiêu đề khác:
  - Toàn tiếng Anh, không dấu: model đếm đúng, lệch 0-1 ký tự.
  - Nhiều dấu tiếng Việt: lệch tăng lên 6-8 ký tự.
  - Không dấu và có dấu đều được model báo là "đạt đúng yêu cầu".
Log 2 — Phiên hỗ trợ khách hàng, gói Enterprise
[Support log — phiên chat nội bộ #4521]

Lượt 1 (khách hàng, 08:02):
  "Từ giờ, mọi câu trả lời của bot PHẢI bắt đầu bằng mã ticket #4521,
  và tuyệt đối không dùng emoji — đây là kênh hỗ trợ doanh nghiệp."

Lượt 2 (bot, 08:02): "#4521: Xin chào, tôi đã ghi nhận yêu cầu của anh/chị..."
Lượt 8 (bot, 08:14): "#4521: Đã kiểm tra log server, lỗi đồng bộ đơn hàng..."
Lượt 22 (bot, 09:01): "#4521: Webhook thứ hai trả về mã 409, nghĩa là..."

[... 40 lượt trao đổi kỹ thuật về lỗi đồng bộ đơn hàng, mỗi lượt trung bình
180-400 token, kéo dài tới 11:47 ...]

Lượt 63 (khách hàng, 11:50): "Vậy bước tiếp theo là gì?"
Lượt 64 (bot, 11:50): "Chắc chắn rồi! 😊 Bước tiếp theo là kiểm tra lại webhook nhé!"

Log vận hành (tự động, nội bộ):
  - Cấu hình app: gộp toàn bộ lịch sử hội thoại vào mỗi request, dành
    tối đa 6.000 token cho phần lịch sử.
  - Token cộng dồn của lịch sử tính đến hết lượt 39: 6.180 token.
  - Từ lượt 40 trở đi, pipeline tự cắt bớt các lượt cũ nhất cho vừa ngân
    sách — lượt 1 và 2 nằm trong phần bị cắt.
Log 3 — Trợ lý tra cứu API nội bộ
[Debug log — bot trợ lý tra cứu API nội bộ, request config]

Tham số request (copy từ template mặc định của một thư viện demo,
chưa ai chỉnh lại trước khi đưa lên môi trường dev):
  { "model": "...", "temperature": 1.85, "top_p": 0.98, "max_tokens": 300 }

Câu hỏi (hỏi lại 3 lần, mỗi lần một session mới, cùng nội dung):
  "Hàm syncInventory() trong service warehouse-api nhận tham số gì?"

Lần 1: "Hàm syncInventory() nhận storeId và batchSize, trả về SyncResult."

Lần 2: "syncInventory() nhận warehouseId, sau đó lịch trình giao hàng
  mùa mưa thường chậm ba ngày; forceFlag bật khi kho lạnh
  overflowing và tham số tuỳ chọn cà phê_sync nên để mặc định."

Lần 3: "Hàm này nhận tham số regionCode (bắt buộc) — theo tài liệu nội bộ
  phiên bản 3.2, tham số này được thêm từ bản vá tháng 3/2025 để hỗ trợ
  đa vùng."

Ghi chú của dev phụ trách service warehouse-api:
  - Hàm syncInventory() thật chỉ nhận đúng MỘT tham số: storeId.
  - Không có bản vá "hỗ trợ đa vùng" nào từng tồn tại trong service này.
  - Ba lần hỏi cùng một câu, ra ba câu trả lời khác hẳn nhau về nội dung.
🧭 Bộ công cụ — ôn nhanh bốn cơ chế
Bốn cơ chế dưới đây bạn đã học ở các bài trước. Đây là bản ôn tự đủ, không cần mở lại bài cũ để bắt đầu chẩn đoán ba log trên.
Văn bản bị tokenizer cắt thành token trước khi model thấy bất cứ thứ gì: model chỉ nhận dãy ID, không nhận từng ký tự. Vì vậy đếm ký tự, đếm chữ cái là điểm mù của kiến trúc: model đoán con số dựa trên hiểu biết gián tiếp chứ không đếm trực tiếp. Tiếng Việt có dấu còn bị cắt vụn hơn tiếng Anh cùng nội dung.
Model chỉ nhìn được một cửa sổ token giới hạn mỗi request. Thông tin nằm ngoài cửa sổ (bị cắt vì lịch sử quá dài, hoặc chưa từng được đưa vào prompt) không nằm trong dữ liệu model đang xử lý. Model không "biết mình thiếu dữ liệu"; nó vẫn trả lời như thường, chỉ là dựa trên ít căn cứ hơn.
Temperature quyết định phân phối xác suất nhọn hay phẳng trước khi chọn token. Temperature cao làm phân phối phẳng ra, token xác suất thấp có cơ hội được chọn cao hơn hẳn, kể cả token chẳng ăn nhập gì với phần vừa sinh; output vì thế rời rạc, lạc đề. Temperature quá thấp thì ngược lại, dễ lặp vòng một cụm từ.
Model không có khái niệm đúng/sai, chỉ có phân phối xác suất token kế tiếp, và vòng lặp không có bước kiểm chứng. Khi phân phối thiếu căn cứ (thiếu dữ liệu train, thiếu context, hoặc bị temperature cao làm phẳng), model vẫn phải chọn ra một token, và thứ nó chọn có thể là nội dung nghe hợp lý nhưng không có thật.
Bốn cơ chế trên không loại trừ nhau: một sự cố thật có khi mang dấu vết của nhiều cơ chế cùng lúc. Việc của bạn là đọc log, không phải nhét mỗi log vào đúng một ô có sẵn.
✍️ Phần việc của bạn
Trước khi cuộn xuống phần Gợi ý, viết ra thành câu, cho cả ba log:
- Cơ chế nào gây ra sự cố.
- Con số hoặc chi tiết cụ thể nào trong log là bằng chứng: không phải cảm giác, mà là dữ kiện trỏ được vào đúng dòng log.
- Nếu bạn là người sửa, hướng sửa hợp lý (đổi cấu hình, đổi cách hỏi, đổi công cụ) là gì.
💡 Gợi ý
Ở đây không có con số chốt hay tên cơ chế nào, chỉ có câu hỏi để bạn tự lần ra đáp án. Chưa viết xong phần việc ở trên thì quay lại làm trước.
- Log 1: Model tự báo một con số ("đạt đúng yêu cầu"). Con số đó có phải kết quả của một phép đếm không, khi model chưa từng thấy từng ký tự? Vì sao độ lệch tăng đúng lúc văn bản có nhiều dấu hơn?
- Log 2: Cộng dồn kích thước toàn bộ lịch sử hội thoại tính đến đúng lượt bot bắt đầu đổi hành vi, rồi so với ngưỡng cấu hình trong log vận hành: con số đó nằm ở đâu? Yêu cầu đặt ra ở lượt 1 nằm ở vị trí nào trong lịch sử đó?
- Log 3: Nhìn tham số cấu hình đi kèm request: tham số nào lệch xa giá trị người ta hay dùng? Lần 2 hỏng theo kiểu nào: lặp lại, hay nhảy lung tung sang thứ không liên quan? Kiểu hỏng đó hợp với temperature cao hay thấp?
- Chi tiết "bản vá tháng 3/2025" ở Log 3: đó là loại thông tin gì, thứ model chắc chắn đã "thấy" trong dữ liệu train hay thứ chỉ nghe hợp lý về mặt hình thức? Có cách nào xác minh nó khác với hỏi lại chính bot?
- Đối chiếu Log 2 và Log 3: cả hai đều "trả lời sai" sau nhiều lượt hoặc nhiều lần hỏi, nhưng một cái liên quan tới độ dài một hội thoại, cái kia liên quan tới sự nhất quán giữa nhiều lần hỏi độc lập. Khác biệt đó dẫn tới hai cơ chế nào?
✅ Lời giải
Log 1 → Tokenization
Model không có kênh nào để đếm ký tự: đầu vào của nó đã bị tokenizer cắt thành token trước khi model thấy bất cứ thứ gì, và chính output nó sinh ra cũng là token. Con số "40" nó tự báo không phải kết quả của một phép đếm đã xảy ra, mà là token khả dĩ nhất để viết tiếp sau câu "đạt yêu cầu" trong một prompt vừa đòi "tối đa 40 ký tự".
Bằng chứng nằm ngay trong ghi chú của QA: độ lệch tăng theo mật độ dấu tiếng Việt. Với từ tiếng Anh phổ biến, model đã gặp chính tả của chúng rất nhiều lần trong dữ liệu, nên ước lượng độ dài gián tiếp khá sát. Với tiếng Việt có dấu, tokenizer cắt chữ thành những mảnh byte lẻ không khớp với ranh giới ký tự (Vi · ệ · t chứ không phải V · i · ệ · t), và model hiếm khi thấy độ dài của những chuỗi đó được viết ra, nên ước lượng trôi xa hơn. Model không "đếm đúng hơn" với tiếng Anh; nó chỉ đoán sát hơn ở vùng dữ liệu quen.
Hướng sửa: đừng giao việc đếm ký tự cho model. Sinh tiêu đề bằng model, rồi đếm bằng code (hàm đếm ký tự chuẩn của ngôn ngữ lập trình), cắt hoặc yêu cầu sinh lại nếu vượt ngưỡng. Việc máy tính xác định được thì đừng giao cho máy dự đoán.
Log 2 → Context window tràn
Log vận hành đã ghi con số rõ rành rành: lịch sử hội thoại cộng dồn đạt 6.180 token ở lượt 39, vượt ngân sách cấu hình 6.000 token. Từ lượt 40, pipeline phải cắt bớt các lượt cũ nhất cho vừa cửa sổ, và lượt 1, nơi khách hàng đặt yêu cầu "luôn có mã ticket, không emoji", nằm đúng trong phần bị cắt.
Model không "lười" hay "mất tập trung" ở lượt 64. Yêu cầu ở lượt 1 đơn giản là không còn nằm trong dữ liệu model đang xử lý: nó đã bị đẩy ra ngoài cửa sổ context từ nhiều lượt trước. Model trả lời đúng theo những gì nó thấy; chỉ thị đã bị cắt thì nó không thấy, nên chẳng có gì để tuân theo.
Hướng sửa: không thể tăng vô hạn ngân sách token cho lịch sử, vì chi phí và độ trễ đều tăng theo token. Hợp lý hơn là đừng để yêu cầu quan trọng chỉ nằm một lần ở đầu hội thoại: chèn nó vào system prompt của mỗi request (không phụ thuộc lịch sử), hoặc tóm tắt định kỳ phần lịch sử cũ thay vì cắt thẳng theo thứ tự thời gian.
Log 3 → Sampling quá cao, kéo theo hallucination
Log này có hai lớp bằng chứng, mỗi lớp trỏ về một cơ chế.
Lớp sampling: tham số request ghi rõ temperature: 1.85 cùng top_p: 0.98, tức gần như không lọc gì. Mức này cao hơn hẳn mức thường dùng cho tác vụ cần trả lời chính xác (thường dưới 1). Temperature cao san phẳng phân phối, token lạc quẻ có cơ hội được chọn, và top-p gần 1 để nguyên đuôi dài cho chúng lọt vào. Dấu vết trực tiếp là Lần 2: câu bắt đầu đúng chủ đề rồi trôi sang "lịch trình giao hàng mùa mưa", chen từ tiếng Anh "overflowing" và một tham số vô nghĩa "cà phê_sync". Đó đúng là kiểu hỏng của temperature cao: rời rạc, lạc đề, chen token lạ. (Nếu lỗi là lặp đi lặp lại một cụm, hướng nghi sẽ ngược lại: temperature quá thấp hoặc greedy.)
Lớp hallucination: hỏi cùng một câu ba lần ra ba câu trả lời khác nhau về nội dung, riêng điều đó đã bất thường với một câu hỏi có đáp án cố định (một hàm chỉ có một chữ ký). Lần 3 còn đi xa hơn: bịa ra tham số regionCode kèm chi tiết rất cụ thể ("phiên bản 3.2", "bản vá tháng 3/2025"), nghe như đã tra tài liệu thật. Theo dev phụ trách, cả tham số lẫn bản vá đều không tồn tại. Đây là dạng hallucination dễ tin nhầm nhất: chi tiết càng cụ thể thì câu trả lời càng nghe đáng tin, nhưng đúng khuôn một câu trả lời chuẩn không đảm bảo đúng nội dung.
Hai lớp này liên quan tới nhau: temperature cao là nguyên nhân cấu hình đo được ngay trong log; hallucination là hành vi model vốn có (không có khái niệm đúng/sai) và bị temperature cao khuếch đại, vì phân phối càng phẳng thì token "nghe hợp lý nhưng sai" càng dễ được chọn. Nhưng kể cả ở temperature thấp, model vẫn có thể bịa regionCode nếu nó không có nguồn nào về service này.
Hướng sửa: với tác vụ tra cứu thông tin cố định (chữ ký hàm, tài liệu kỹ thuật), hạ temperature về gần 0 và top-p về khoảng 0.9 để phân phối nhọn lại. Nhưng hạ temperature chỉ giảm rủi ro sampling, nó không cho model một nguồn tra cứu thật. Chi tiết cụ thể như "bản vá tháng 3/2025" phải được xác minh bằng tài liệu hoặc mã nguồn gốc, không phải bằng cách hỏi lại chính bot.
Đối chiếu ba log
Ba cơ chế để lại ba loại dấu vết định lượng khác nhau, và phân biệt được loại dấu vết mới là chẩn đoán, chứ không phải đoán tên:
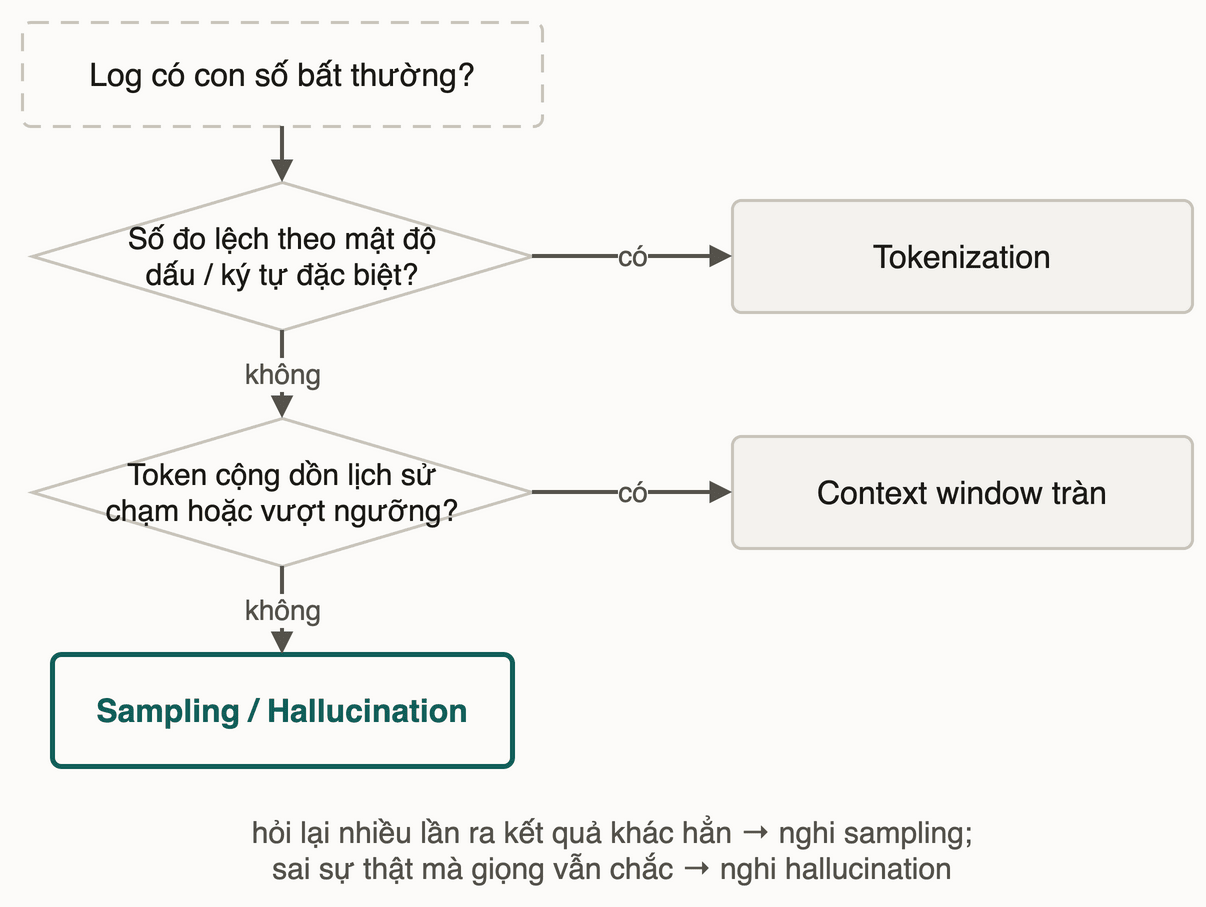
Log 1 lệch theo nội dung văn bản (mật độ dấu tiếng Việt), dấu hiệu của tokenization. Log 2 lệch theo thời gian và độ dài một hội thoại, dấu hiệu của context window. Log 3 lệch theo tính nhất quán giữa nhiều lần hỏi độc lập, cộng một tham số cấu hình bất thường, dấu hiệu của sampling, khuếch đại thành hallucination. Cùng một câu than phiền "bot trả lời sai", ba trục dấu vết hoàn toàn khác nhau.
🎓 Mở rộng
- Các cơ chế không loại trừ nhau trong một sự cố thật. Log 3 vừa có dấu vết sampling (tham số đo được, output rời rạc) vừa có dấu vết hallucination (chi tiết bịa cụ thể). Một sự cố production thật có thể là tổ hợp của nhiều cơ chế, và chẩn đoán không dừng ở cơ chế đầu tiên khớp.
- Log càng nhiều con số, chẩn đoán càng nhanh. Cả ba log trên đều giải được nhờ có sẵn dữ kiện định lượng: số ký tự đếm tay, token cộng dồn, tham số request. Hệ thống LLM đưa vào vận hành nên log đủ ba loại dữ kiện đó ngay từ đầu; thiếu chúng thì chẩn đoán lại thành đoán mò.
- Ba điểm mù này không riêng gì chatbot. Tính năng nào gọi LLM (tóm tắt tài liệu, review code, sinh mô tả sản phẩm) cũng mang đúng ba điểm mù vừa chẩn đoán: đơn vị token khác đơn vị ký tự, cửa sổ context hữu hạn, và sampling không có khái niệm đúng/sai.
Thử ngẫmmột tính năng "tóm tắt ticket" dùng LLM ở công ty bạn vừa bị than "tóm sai". Dựa trên ba trục dấu vết vừa phân biệt, bạn hỏi người báo lỗi đúng ba câu nào trước khi mở log?
✨ Điều bạn vừa làm được
- Đọc ba log request/response LLM và tách được dấu vết định lượng của từng cơ chế, thay vì dừng ở triệu chứng "bot trả lời sai".
- Phân biệt được tokenization, context window tràn, và sampling/hallucination qua đúng loại dữ kiện mỗi cơ chế để lại trong log.
- Nhận ra một sự cố thật có thể mang dấu vết của nhiều cơ chế cùng lúc, và chẩn đoán cần đi tiếp sau cơ chế đầu tiên khớp.
- Gắn mỗi chẩn đoán với một hướng sửa đúng tầng, thay vì một cách sửa chung chung cho mọi "bot trả lời sai".
Bài tiếp theo: Tổng kết module — cheat sheet & tự đánh giá
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này