Dự đoán token kế tiếp — vòng lặp sinh văn bản
LLM không tra cứu, không suy luận theo luật: nó dự đoán mảnh văn bản kế tiếp, lặp đi lặp lại. Mọi hành vi khác đều là hệ quả của vòng lặp này.
TL;DR: LLM không có "bộ não" chứa sẵn câu trả lời, cũng không có tập luật suy luận riêng cho từng loại yêu cầu. Nó chỉ làm một việc, lặp đi lặp lại: nhìn toàn bộ mảnh văn bản (token) đã có, tính ra một phân phối xác suất cho mảnh kế tiếp, chọn một mảnh từ phân phối đó, nối vào cuối, rồi lặp lại cho mảnh sau. Viết thơ, giải thích lỗi, trả lời câu hỏi đều chạy qua đúng vòng lặp này; khác nhau chỉ ở những token đã có trong đầu vào, không ở cơ chế xử lý bên trong.
Bạn mở một trợ lý AI, gõ "viết cho tôi một khổ thơ về mùa thu", nhận lại vài dòng có vần có điệu. Dòng tiếp theo, bạn dán một stack trace và hỏi "lỗi này do đâu?", nhận lại một đoạn giải thích kỹ thuật mạch lạc, đúng thuật ngữ. Hai câu trả lời khác hẳn nhau về giọng lẫn nội dung, nên dễ nghĩ bên trong chắc có một bộ định tuyến: nhận ra "đây là yêu cầu sáng tác" thì bật một chế độ, nhận ra "đây là debug" thì bật chế độ khác.
Không có bộ định tuyến nào cả, cũng chẳng có "chế độ thơ ca" hay "chế độ kỹ thuật" nào cài sẵn. Khổ thơ lẫn lời giải thích lỗi đều do đúng một vòng lặp sinh ra, chạy lại y hệt hàng trăm lần: dự đoán một token, nối vào, lặp lại. Bài này lần theo vòng lặp đó từng bước, vì mọi bài sau trong module đều dựng trên nó.
Trong pha inference, trọng số đã đóng băng: model chạy mỗi lần có request và không trọng số nào bị ghi đè. Vòng lặp của bài này chạy trọn trong pha đó. Mỗi token sinh ra là một lượt tính với cùng bộ trọng số cố định, nên model không "học" thêm gì từ chính câu nó đang viết. Thứ thay đổi giữa các bước chỉ là chuỗi token đầu vào, dài thêm một mảnh sau mỗi vòng.
1. Analogy: bàn phím gợi ý từ trên điện thoại
Gõ vài chữ trên bàn phím điện thoại, phía trên phím hiện ra 1-3 từ gợi ý cho từ tiếp theo, dựa trên vài từ bạn vừa gõ. Bạn chạm chọn một gợi ý, bàn phím lại hiện gợi ý mới cho từ sau đó. LLM làm đúng việc này, chỉ khác về quy mô và về chuyện ai bấm chọn.
| Bàn phím gợi ý từ | LLM |
|---|---|
| Gợi ý dựa trên vài từ gần nhất bạn vừa gõ | Dự đoán dựa trên toàn bộ chuỗi token đã có, có thể hàng nghìn token trước đó (context window, bài 03) |
| Bạn tự tay chạm chọn 1 gợi ý | Model tự "chọn" 1 token từ phân phối xác suất (cơ chế chọn ở bài 04) |
| Gợi ý dừng khi bạn ngừng gõ | Vòng lặp tự dừng khi model sinh ra token báo kết thúc, hoặc chạm giới hạn độ dài |
| Gợi ý chỉ 1-3 lựa chọn hiện ra | Phân phối trải trên toàn bộ vocabulary: hàng chục nghìn token khả dĩ, phần lớn mang xác suất gần bằng không |
LLM là bàn phím gợi ý từ, nhưng nhìn xa hơn (toàn bộ ngữ cảnh chứ không chỉ vài từ gần nhất) và tự lặp lại việc chọn gợi ý rồi gõ tiếp hàng trăm lần, không cần bạn chạm tay.
2. Vòng lặp autoregressive chạy từng bước ra sao?
Dân ML gọi cách chạy ở trên là autoregressive: đầu ra của bước trước (token vừa sinh) trở thành một phần đầu vào của bước sau. Ngoài chuỗi token nó đang nhìn, model không giữ bộ nhớ ẩn nào khác, nên mọi thứ nó "biết" về cuộc hội thoại đều nằm trong chuỗi đó.
Đọc câu sau và tự viết ra từ bạn nghĩ sẽ đứng kế tiếp, trước khi đọc phần giải thích bên dưới: "Hôm nay trời rất ___"
Bạn vừa làm đúng việc model làm ở mỗi bước, trừ một điểm: model không chọn một mảnh duy nhất mà tính xác suất cho mọi mảnh trong vocabulary cùng lúc. Với câu trên, xác suất dồn vào nhóm mảnh hợp chủ đề thời tiết như "đẹp", "nóng", "lạnh", "mưa", và gần như bằng không cho mảnh lạc chủ đề như "compile". (Các mảnh này thực ra là token sub-word, không phải lúc nào cũng trọn một từ; bài 02 nói rõ.) Đó là phân phối xác suất: một bảng gán một con số cho từng token khả dĩ, không phải một câu trả lời "đúng" duy nhất tính sẵn.
Bước kế tiếp, chọn đúng một token từ bảng xác suất đó, gọi là sampling và là chủ đề bài 04. Bài này chỉ cần nắm: có một bước chọn, và bước đó không tất định 100% (token có xác suất cao nhất chưa chắc lần nào cũng được chọn).
Viết lại toàn bộ vòng lặp thành các bước:
input <- danh sách token của prompt ban đầu
while chưa gặp token báo kết thúc VÀ chưa chạm giới hạn độ dài:
    phan_phoi <- model(input)          -- xác suất cho MỌI token trong vocabulary
    token_moi <- chon_tu(phan_phoi)     -- cách chọn: bài 04 (sampling)
    input <- input + [token_moi]        -- nối token vừa chọn vào cuối
    hien_thi(token_moi)                 -- đây là "chữ chạy" bạn thấy khi model stream
-- Kết thúc: input chứa toàn bộ chuỗi, kể cả phần model vừa sinh
Mỗi vòng while chỉ sinh đúng một token. Câu trả lời dài trăm từ là hàng trăm lần chạy lại y hệt vòng lặp trên, không có bước nào "viết cả đoạn" một lúc.
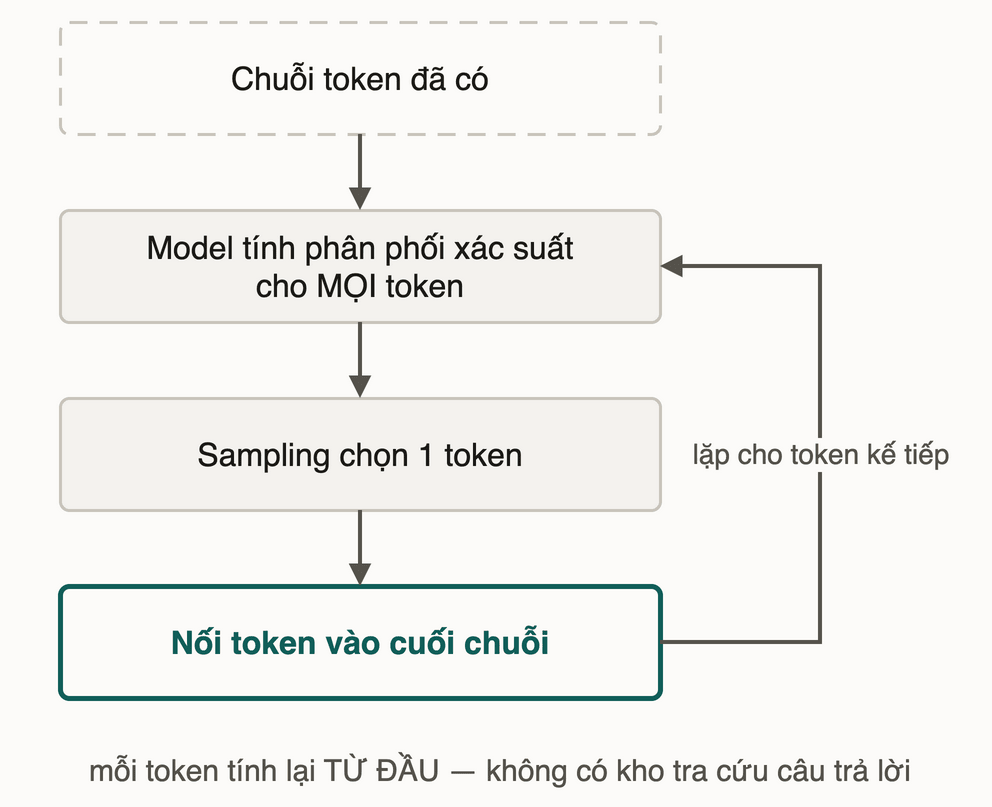
3. Vì sao cùng một model viết được cả thơ lẫn giải thích lỗi code?
Quay lại nghịch lý đầu bài. input trong vòng lặp trên không chỉ chứa câu hỏi vừa gõ: nó chứa cả system prompt, lịch sử hội thoại và câu hỏi hiện tại, nối liền thành một chuỗi token duy nhất. Yêu cầu "viết thơ" và yêu cầu "giải thích lỗi" chỉ là hai chuỗi input khác nhau đưa vào cùng một hàm model(input). Trong vòng lặp không có bước nào kiểm tra "đây là loại yêu cầu gì" rồi rẽ sang cơ chế khác. Phân phối xác suất ở mỗi bước tự nghiêng về từ hợp ngữ cảnh, chỉ vì ngữ cảnh đó đã nằm sẵn trong input.
Model cũng không "tra cứu": nó không có kho lưu sẵn "câu trả lời cho câu hỏi X" để lấy ra. Mỗi token được tính lại từ đầu, bằng cách áp thống kê học được lúc train lên đúng chuỗi input hiện tại. Hỏi lại cùng một câu với ngữ cảnh y hệt thì phép tính phân phối chạy lại y hệt và ra đúng bảng xác suất cũ; câu trả lời vẫn có thể khác vì bước chọn ngẫu nhiên, chứ không phải vì model nhớ hay quên gì. model(input) là một hàm áp lên input, không phải bảng tra cứu.
Thử ngẫmhỏi lại đúng một câu y hệt cho một LLM hai lần, trong hai cuộc trò chuyện mới tinh không có lịch sử gì khác. Model có "nhớ" đã trả lời câu đó lần trước không, và vì sao?
4. Pitfall tổng hợp
❌ Nhầm 1: nghĩ model "tra cứu" câu trả lời có sẵn, giống công cụ tìm kiếm.
✅ Model không lưu nguyên văn câu trả lời cho từng câu hỏi. Ở mỗi bước nó tính lại phân phối xác suất từ đầu, dựa trên pattern thống kê học được lúc train (hàng tỷ tham số), không phải một chỉ mục tra cứu lúc chạy.
❌ Nhầm 2: nghĩ có "chế độ suy luận logic" riêng, khác "chế độ viết văn", và model tự chuyển qua lại.
✅ Không có bộ chuyển chế độ nào. Một vòng lặp chạy cho mọi loại yêu cầu; khác biệt nằm ở token ngữ cảnh trong input, không ở cơ chế bên trong.
❌ Nhầm 3: nghĩ model "biết trước" cả câu trả lời rồi in ra dần, như hiệu ứng gõ chữ giả lập trong giao diện.
✅ Model sinh tuần tự thật, từng token một. Ở token thứ n, nó chưa "biết" token thứ n+5 là gì: token đó chỉ được tính sau, dựa trên chuỗi đã dài thêm 1 token. Vì thế model đôi khi tự mâu thuẫn giữa chừng một câu trả lời dài: không có bản nháp hoàn chỉnh nào được viết sẵn trước khi sinh chữ đầu tiên.
5. 📚 Deep Dive
Paper chính chủ:
- Brown et al. — Language Models are Few-Shot Learners (arXiv:2005.14165): nơi ý tưởng dự đoán next-token được đẩy lên quy mô hàng trăm tỷ tham số (GPT-3) và trình bày có hệ thống. Đọc để thấy vòng lặp đơn giản trong bài này đứng sau những hệ thống lớn thế nào; bài này không tóm tắt kết quả số của paper.
Ghi chú: bài này thuần cơ chế, không đo số liệu thực nghiệm nào. Mọi ví dụ (câu thời tiết, khổ thơ, stack trace) là minh hoạ định tính cho vòng lặp, không phải kết quả đo từ một model cụ thể.
6. Liên hệ các bài khác
- Bài 02 — Tokenization: bài này gọi tạm đơn vị là "mảnh"; bài 02 nói rõ đó là token và tokenizer cắt nó ra sao.
- Bài 04 — Sampling & temperature: đi sâu vào bước "chọn 1 token từ phân phối" mà bài này mới nêu tên.
- Bài 06 — Hallucination: hệ quả của việc model sinh tuần tự, không "biết trước" toàn cục, nên đôi khi tự tin sai suốt cả câu trả lời.
7. Tóm tắt
- Mỗi vòng lặp sinh đúng một token; câu trả lời trăm từ là hàng trăm vòng, không có bước nào viết cả đoạn.
inputgồm system prompt, lịch sử và câu hỏi nối thành một chuỗi, nên "đổi chế độ" thực chất chỉ là đổi input.- Cùng input thì cùng bảng xác suất; câu trả lời khác nhau giữa các lần hỏi là do bước chọn, không phải do model nhớ hay quên.
- Model không có bản nháp trước, đó là gốc của hiện tượng tự mâu thuẫn giữa chừng (bài 06 đi tiếp).
8. Tự kiểm tra
- Q1Mô tả vòng lặp autoregressive bằng lời của bạn: model nhận gì ở mỗi bước, xuất ra gì, và làm gì với thứ xuất ra đó trước khi sang bước kế tiếp?
- Q2Đồng nghiệp của bạn nói: "Chắc bên trong model có bộ định tuyến, nhận diện câu hỏi kỹ thuật thì bật chế độ suy luận logic, câu hỏi sáng tác thì bật chế độ viết văn." Đâu là chỗ sai trong lập luận này?
- Q3Vì sao nói output của mỗi bước là một phân phối xác suất, chứ không phải một token duy nhất được tính sẵn? Và bước 'chọn 1 token từ phân phối đó' thuộc về bài nào?
- Q4Model sinh văn bản tuần tự, từng token một, không viết trước cả câu rồi in ra. Hệ quả quan sát được của điều này là gì, và vì sao đây không phải một bug ngẫu nhiên?
- Q5Bàn phím gợi ý từ trên điện thoại và LLM cùng dựa trên một ý tưởng: dự đoán từ/token kế tiếp. Nêu hai khác biệt chính khiến LLM mạnh hơn hẳn, dù cùng gốc ý tưởng.
Bài tiếp theo: Tokenization — vì sao model không thấy ký tự
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này