Sampling — temperature và top-p
Temperature không phải nút chỉnh độ thông minh. Nó điều chỉnh cách chọn token từ phân phối xác suất — và đoán được output đổi thế nào khi vặn nó.
TL;DR: Temperature không phải "nút chỉnh độ thông minh". Nó chỉnh độ nhọn của phân phối xác suất token kế tiếp (bài 01), trước khi một token được chọn. T thấp bóp phân phối nhọn về token khả dĩ nhất, gần như greedy: nhất quán, nhưng cứng nhắc và dễ rơi vào vòng lặp một cụm từ. T cao san phẳng phân phối nên token hiếm cũng có cửa: đa dạng hơn, nhưng dễ rời rạc, lạc đề, chen chữ lạ. top-p (nucleus sampling) là một núm khác hẳn: nó không đổi hình dạng mà cắt tập ứng viên, chỉ giữ nhóm token nhỏ nhất có tổng xác suất từ p trở lên. Hai núm độc lập nhau.
Đội dev nội bộ một ngân hàng chạy UAT hai bot cùng lúc. Bot FAQ tra chính sách để T bằng 0 "cho an toàn, khỏi bịa": tester hỏi một ý bằng năm cách, cả năm lần bot trả gần như nguyên văn một câu, câu dài thì có lúc lặp đi lặp lại. Bot soạn thông báo nội bộ để T gần 2 "cho sinh động" thì sinh câu rời rạc, đang nói lịch nghỉ lễ chen sang chuyện khác, xen cả từ tiếng Anh lạc lõng.
Hai đội đều nghĩ mình đang vặn "độ thông minh của AI", tức đặt sai câu hỏi ngay từ đầu: temperature không đổi những gì model biết, nó chỉ đổi cách model chọn giữa các khả năng đã tính sẵn.
Bài 01: mỗi bước, model tính ra một phân phối xác suất trên toàn vocabulary cho token kế tiếp, chưa chọn thẳng một token. Bài này đi vào đúng bước chọn đó: chọn theo quy tắc nào, và bạn vặn được gì.
1. Analogy: vòng quay may mắn ở hội chợ
Một gian hàng hội chợ có vòng quay trúng thưởng: phần thưởng "hot" vẽ miếng to, phần thưởng ít ai màng vẽ miếng bé tí, kim dừng ở đâu ăn giải đó.
Ban tổ chức có hai cách can thiệp trước khi bạn quay:
| Hội chợ | Sampling |
|---|---|
| Vẽ lại tỉ lệ các miếng: thu nhỏ hết mọi miếng trừ miếng to nhất, hoặc san đều các miếng | Temperature scale logits trước softmax, đổi độ nhọn của phân phối |
| Gỡ hẳn những miếng bé tí khỏi mặt vòng trước khi quay | top-p giữ tập nhỏ nhất có tổng xác suất đạt ngưỡng p, loại đuôi dài |
| Quay đúng một lần, ra đúng một kết quả | Sample ra đúng một token |
| Vòng gốc chưa chỉnh gì vẫn có sẵn tỉ lệ miếng | Phân phối xác suất gốc do model tính ra (bài 01) |
Temperature vẽ lại tỉ lệ miếng trên cùng một vòng quay. top-p gỡ bớt miếng trước khi quay. Hai việc khác nhau, làm cùng lúc được.
2. Hai núm vặn tác động lên phân phối ra sao?
Cùng một prompt, cùng model. Hạ temperature xuống gần 0 rồi chạy lại nhiều lần: output có giống nhau không? Vặn temperature lên rất cao: token hiếm xuất hiện nhiều hơn hay ít hơn? top-p bằng 1.0 so với 0.5: tập token có thể chọn thay đổi thế nào? Viết dự đoán ra trước khi đọc tiếp.
Toàn cảnh một bước sinh token, nối tiếp từ chỗ bài 01 dừng lại:
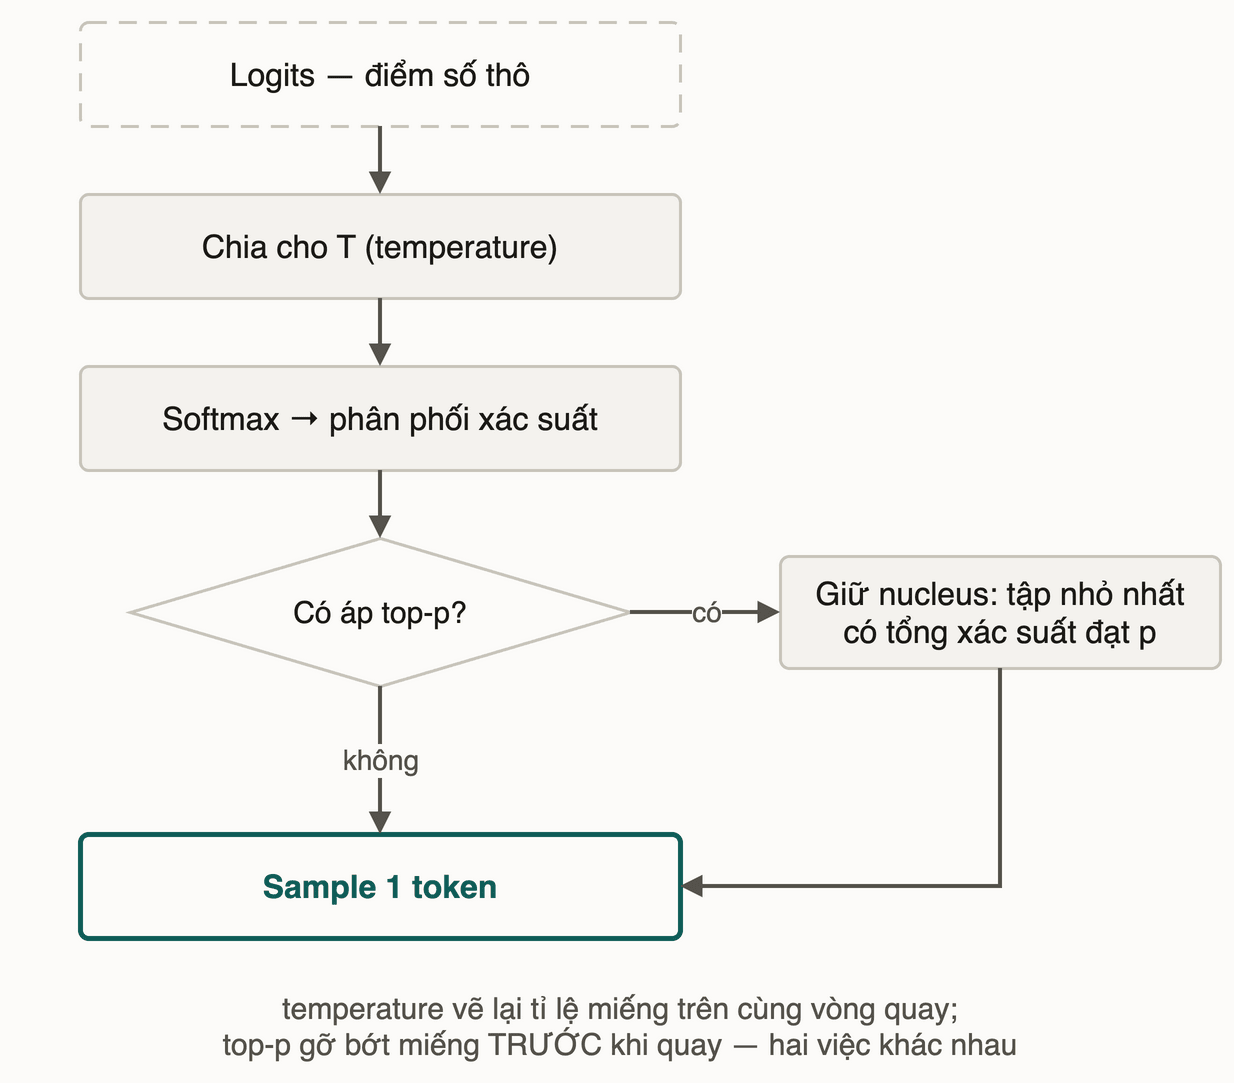
Chia cho T và lọc top-p là hai núm độc lập; mục 3 và 4 đi vào từng núm.
3. Temperature làm gì với logits?
Model không tính thẳng ra xác suất. Nó tính ra logits: điểm số thô cho từng token trong vocabulary, số nào cũng được, cộng lại chưa bằng 1. Softmax biến logits thành xác suất: token điểm cao hơn thì xác suất cao hơn, và tổng toàn bộ luôn bằng 1.
T (temperature) chia vào logits trước khi đưa qua softmax:
-- z là logits thô model tính ra, T là temperature
function chon_token_tiep_theo(z[], T):
    for i in z:
        z_scaled[i] <- z[i] / T      -- T nhỏ hơn 1: khoảng cách giãn ra; T lớn hơn 1: co lại
    xac_suat <- softmax(z_scaled)    -- chuẩn hoá, tổng = 1
    return sample(xac_suat)          -- bốc thăm theo trọng số xác suất
Chia cho một số nhỏ hơn 1 làm khoảng cách giữa các logits giãn ra: token vốn điểm cao càng bỏ xa phần còn lại, phân phối nhọn hơn. Chia cho một số lớn hơn 1 làm khoảng cách co lại: các token gần bằng nhau hơn, phân phối phẳng hơn.
Ví dụ minh hoạ (logits giả định cho bốn token tiếp theo của "Hôm nay trời...", tính bằng đúng công thức trên, không phải số đo từ model thật):
| Token | Logits gốc | Xác suất, T = 1 | Xác suất, T = 0.5 | Xác suất, T = 2 |
|---|---|---|---|---|
| đẹp | 2.0 | 0.505 | 0.694 | 0.379 |
| nắng | 1.5 | 0.306 | 0.255 | 0.295 |
| mưa | 0.5 | 0.113 | 0.035 | 0.179 |
| lạnh | 0.1 | 0.076 | 0.016 | 0.147 |
Đọc bảng: ở T = 0.5, "đẹp" chiếm gần 70%. Ở T = 2, "lạnh" nhảy từ 7.6% lên gần 15% dù vẫn là token kém hợp lý nhất. Với vocabulary thật hàng chục nghìn token, cả nghìn token lạc quẻ cùng được nâng lên một chút, cộng lại thì cơ hội bốc trúng một token lạc quẻ không còn nhỏ, và mỗi token như vậy kéo câu sau lệch thêm: đó là bot thông báo đầu bài. Bot FAQ (T gần 0) thì lần nào cũng chọn token điểm cao nhất, nên câu trả lời đúc từ một khuôn và cụm từ đã có xác suất cao dễ tự kéo chính nó lặp lại.
Thử ngẫmtăng độ tương phản một tấm ảnh làm vùng sáng sáng hơn, vùng tối tối hơn; giảm tương phản làm mọi vùng nhoè về cùng một sắc xám. Temperature thấp và cao ứng với chỉnh tương phản theo chiều nào?
4. top-p cắt tập ứng viên như thế nào?
top-p (nucleus sampling) giải quyết một vấn đề khác: mỗi token trong "đuôi dài" xác suất thấp chỉ chiếm một mẩu bé, nhưng cộng cả đuôi lại vẫn đáng kể, và T cao chỉ làm đuôi đó dày thêm. Holtzman và cộng sự (The Curious Case of Neural Text Degeneration, arXiv:1904.09751) chỉ ra hai cách văn bản "thoái hoá": chọn kiểu greedy thì dễ lặp vòng, còn sample thẳng từ toàn bộ phân phối thì thỉnh thoảng bốc trúng một token lạc quẻ trong đuôi, và một token đó đủ kéo câu sau trôi đi rời rạc.
Cách chữa của họ: đừng cho đuôi dài cơ hội được bốc thăm ngay từ đầu.
-- xac_suat[] đã sắp xếp giảm dần, p là ngưỡng top-p
function loc_nucleus(xac_suat[], p):
    tong <- 0
    nucleus <- {}
    for token, xs in xac_suat:
        if tong đạt ngưỡng p: break     -- đủ ngưỡng thì dừng, không nhận thêm
        nucleus.add(token)
        tong <- tong + xs
    return chuan_hoa_lai(nucleus)        -- chuẩn hoá lại để tổng = 1 trong tập con
Áp vào đúng phân phối gốc (T = 1) ở mục 3:
| Ngưỡng p | Token còn trong nucleus | Token bị loại |
|---|---|---|
| p = 0.9 | đẹp, nắng, mưa (cộng dồn 0.924) | lạnh (0.076) |
| p = 0.5 | đẹp (một mình đã 0.505) | nắng, mưa, lạnh |
| p = 1.0 | cả bốn — không loại gì | — |
Điểm mấu chốt: top-p không đổi tỉ lệ giữa các token còn lại như temperature, nó chỉ quyết định token nào còn đứng trong vòng quay. Ở p = 0.5, dù T = 1 (chưa chỉnh nhọn hay phẳng gì), kết quả luôn là "đẹp": riêng "đẹp" đã chạm ngưỡng 0.5, ba token còn lại bị gạch tên trước khi quay, chỉ còn đúng một ứng viên.
5. Vặn cả hai cùng lúc thì output đổi thế nào?
Nhớ lại dự đoán ở mục 2. Ghép temperature và top-p vào một bảng quyết định:
| Cấu hình | Hình dạng phân phối sau xử lý | Hành vi kỳ vọng | Ca ở đầu bài |
|---|---|---|---|
| T thấp (gần 0), top-p mặc định cao | Rất nhọn | Nhất quán, gần-greedy, cứng nhắc, dễ lặp vòng | Bot FAQ — đúng lý do đọc như kịch bản dựng sẵn |
| T vừa (khoảng 0.7–1), top-p vừa (khoảng 0.9) | Cân bằng | Đa dạng vừa phải, vẫn mạch lạc | Cấu hình khởi điểm hợp lý cho đa số use case |
| T cao (trên 1.5), top-p cao (gần 1) | Rất phẳng, đuôi dài còn nguyên | Đa dạng cao, dễ bốc trúng token lạc quẻ: rời rạc, lạc đề, chen chữ lạ | Bot thông báo nội bộ — đúng lý do câu trôi đi rời rạc |
| T bất kỳ, top-p thấp (khoảng 0.1–0.3) | Tập ứng viên bị siết chặt | Gần-greedy trong dải T hay dùng (0–2) | Để T cao mà top-p quá thấp thì temperature gần như mất tác dụng |
Hai đội đầu bài không cần đổi model hay viết lại prompt, họ cần vặn đúng chỗ. Bot FAQ muốn bớt cứng nhắc thì nới T lên một chút thay vì giữ 0 tuyệt đối. Bot thông báo muốn bớt rời rạc thì hạ cả T lẫn top-p, không chỉ một trong hai.
6. Pitfall tổng hợp
❌ Nhầm 1: temperature là "độ thông minh" của model.
✅ Temperature không đổi những gì model biết hay tính, nó chỉ đổi cách chọn từ phân phối có sẵn. Model "cứng nhắc" ở T thấp không phải vì kém đi, "sáng tạo" ở T cao không phải vì giỏi hơn.
❌ Nhầm 2: đặt T về 0 là loại bỏ hoàn toàn ngẫu nhiên.
✅ T tiến gần 0 chỉ làm phân phối nhọn tới mức gần-greedy. Trên server thật, sai số dấu phẩy động và cách gom request thành batch vẫn làm logits xê dịch rất nhỏ, đủ đổi thứ hạng khi hai token sát điểm nhau. Muốn chắc output giống hệt thì chạy lại kiểm chứng, đừng suy từ con số T.
❌ Nhầm 3: top-p càng cao càng "an toàn", càng thấp càng "rủi ro".
✅ Ngược lại. p = 1.0 là không lọc gì, giữ nguyên đuôi dài xác suất thấp. p càng thấp mới càng siết chặt, càng gần-greedy. Đọc nhầm chiều tham số này là vặn sai hướng khi debug output rời rạc.
❌ Nhầm 4: thấy output lặp đi lặp lại một cụm từ thì đổ cho temperature quá cao.
✅ Lặp vòng là dấu hiệu của phía ngược lại: T rất thấp hoặc decode kiểu greedy, luôn chọn token điểm cao nhất nên một cụm đã có xác suất cao dễ tự kéo chính nó quay lại. T cao cho ra kiểu lỗi khác: câu rời rạc, lạc đề, token lạ. Phân biệt hai triệu chứng này trước khi vặn núm.
7. 📚 Deep Dive
Paper chính chủ:
- Holtzman, Buys, Du, Forbes & Choi — The Curious Case of Neural Text Degeneration: paper đề xuất nucleus (top-p) sampling. Đọc phần motivation để thấy hai kiểu thoái hoá (greedy lặp vòng, sample thuần trôi rời rạc) và vì sao đuôi dài xác suất thấp nguy hiểm hơn trực giác.
Ghi chú: bảng số ở mục 3–4 tính trực tiếp bằng công thức softmax/nucleus trong bài, không phải số đo từ model thật. Mục đích là đúng hướng thay đổi, không phải con số tuyệt đối.
8. Liên hệ các bài khác
- Bài 01 — Dự đoán token kế tiếp: vòng lặp chứa bước chọn token mà bài này đi sâu.
- Bài 05 — Từ base model đến chat: SFT/RLHF định hình phân phối, sampling quyết định chọn gì từ phân phối đó.
- Bài 06 — Hallucination: output rời rạc do sai cấu hình sampling khác với hallucination, khi model trôi chảy mà bịa nội dung.
9. Tóm tắt
- Chia logits cho
Trồi mới softmax: T = 0.5 đẩy "đẹp" từ 50% lên gần 70%, T = 2 kéo "lạnh" từ 7.6% lên gần 15%. - p = 1.0 nghĩa là không lọc gì; p thấp mới siết tập ứng viên, và ở p = 0.5 ví dụ trong bài chỉ còn đúng một token.
- Lặp vòng là triệu chứng của T thấp/greedy; rời rạc, lạc đề, token lạ là triệu chứng của T cao với đuôi dài còn nguyên.
- Hai núm độc lập: debug output bất thường thì kiểm cả hai.
10. Tự kiểm tra
- Q1Từ phân phối xác suất ở bài 01, giải thích temperature làm gì với phân phối đó, và vì sao nó không phải nút chỉnh độ thông minh của model.
- Q2Cho hai cấu hình: T gần 0 với top-p mặc định cao, và T gần 2 với top-p mặc định cao. Dự đoán khác biệt hành vi output và giải thích cơ chế đằng sau.
- Q3top-p = 1.0 và top-p = 0.1 khác nhau thế nào về tập token có thể được chọn? Vì sao nói p càng cao càng an toàn là hiểu sai chiều tham số?
- Q4Nucleus sampling (top-p) giải quyết vấn đề gì mà chỉ chỉnh temperature không giải quyết được?
- Q5Team đang debug một bot trả lời rời rạc, đang nói chủ đề này thì nhảy sang chủ đề khác, thỉnh thoảng chen từ vô nghĩa. Từ bài này, hai giả thuyết cấu hình đầu tiên bạn kiểm tra là gì, cách sửa mỗi giả thuyết, và nếu triệu chứng lại là lặp một cụm từ mãi thì bạn nghi hướng nào?
Bài tiếp theo: Từ base model đến chat
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này