Context window — bộ nhớ làm việc hữu hạn
Model chỉ nhìn được số token giới hạn mỗi request. Hết chỗ thì phần cũ bị cắt — đây là lý do thật của việc model 'quên', không phải trí nhớ kém.
TL;DR: Context window là "bộ nhớ làm việc" của model trong một request: dung lượng cố định đo bằng token (bài trước), không phải ký tự hay số lượt hội thoại. Hết chỗ thì model không "nhớ kém dần"; ứng dụng gọi model buộc phải cắt bớt token cũ nhất để nhét phần mới vào, và phần bị cắt biến mất hoàn toàn khỏi request kế tiếp. Vì đơn vị là token, tiếng Việt (tốn token hơn tiếng Anh cho cùng nội dung, bài 02) lấp đầy context nhanh hơn. Chi phí và độ trễ cũng tính theo đúng số token đó: context càng dài, hoá đơn và thời gian chờ càng tăng.
Một chatbot hỗ trợ nội bộ chạy production được vài tuần. Ở tin nhắn đầu, user dặn: "trả lời ngắn gọn, không dùng thuật ngữ tiếng Anh". Hội thoại càng dài, model càng phớt lờ yêu cầu đó, tới tin nhắn 40 thì coi như chưa từng được dặn. Team dev nghi model "yếu dần", rồi thử một cách tốn kém: nhắc lại constraint ở mọi tin nhắn.
Cùng lúc, một bot khác trả lời sai một câu hỏi tra cứu policy, dù đáp án đã được dán nguyên văn vào prompt và không hề bị cắt. Câu hỏi để dành cho cuối bài: sao thông tin có mặt trong context mà model vẫn bỏ sót?
Cả hai cùng một gốc: context window là tài nguyên hữu hạn, và model "dùng" nó không đều. Chuyện không chỉ là còn chỗ hay hết chỗ.
Bài 01: mỗi bước, model dự đoán token kế tiếp dựa trên toàn bộ token đứng trước nó. Câu hỏi của bài này: "toàn bộ" đó lớn được tới đâu? Context window chính là giới hạn ấy, và khi vượt quá, một phần token đứng trước không còn nằm trong tầm nhìn của model nữa.
1. Analogy: sổ tay có số trang cố định
Bạn ghi chép một cuộc họp dài vào cuốn sổ tay in sẵn số trang: hết trang là hết, không viết thêm vào cuốn cũ được. Họp càng lâu, bạn càng phải xé bớt trang đầu tiên (ghi chép cũ nhất) để có chỗ viết tiếp. Người đọc lại sổ chỉ thấy phần còn nguyên trang; phần đã xé thì mất hẳn chứ không "mờ đi".
| Sổ tay | Context window |
|---|---|
| Số trang cố định, in trước khi họp | Giới hạn token cố định của một request |
| Hết trang, xé trang đầu để viết tiếp | Context đầy → token cũ nhất bị cắt khỏi request kế tiếp |
| Đọc lại sổ, dễ nhớ rõ trang đầu còn lại và trang cuối, dễ lướt qua trang giữa dày đặc chữ | Model dễ "bỏ sót" thông tin nằm giữa context dài, dù trang đó không hề bị xé |
| Viết càng nhiều trang càng tốn giấy + tốn thời gian chép | Token input + output càng nhiều càng tốn tiền + tốn thời gian sinh |
Context window không phải trí nhớ dài hạn, nó là số trang sổ còn lại trong đúng cuộc họp này. Đóng sổ (kết thúc request) thì phiên sau là sổ mới, trừ khi bạn tự chép lại những gì cần giữ.
2. Context window là gì?
Context window là số token tối đa model "nhìn thấy" được trong một lần gọi. System prompt, toàn bộ lịch sử hội thoại được đưa vào, câu hỏi mới nhất và cả token model đang sinh ra đều cộng chung vào một giới hạn cố định của model đó.
Vài điểm cần khớp với bài trước để khỏi hiểu sai:
- Đơn vị là token, không phải ký tự hay từ. Cùng giới hạn token, văn bản tiếng Việt chứa được ít câu hơn tiếng Anh, vì mỗi câu tiếng Việt tốn nhiều token hơn (bài 02).
- Giới hạn khác nhau giữa các model và đổi theo thời gian mỗi lần nhà cung cấp nâng cấp. Đừng nhớ một con số cố định; tra tài liệu chính chủ đúng lúc build, và kiểm luôn tokenizer có đổi không (bài 02).
- Context không phải bộ nhớ giữa các request. Cảm giác "model nhớ cuộc trò chuyện" là do ứng dụng chủ động gửi lại lịch sử vào context của request mới, cho tới khi lịch sử dài quá không nhét vừa nữa.
Thử ngẫmđóng hẳn app chat rồi mở cuộc trò chuyện mới tinh, hỏi lại đúng câu vừa hỏi ở phiên trước. Model có "nhớ" phiên cũ không, và điều gì thật sự quyết định chuyện đó?
3. Đầy thì model cắt cái gì trước?
Khi tổng token (system + lịch sử + input mới) vượt giới hạn, gửi nguyên cả khối lên thì API thường từ chối request. Nên ứng dụng gọi model phải tự quyết bỏ bớt gì trước khi gửi. Cách phổ biến nhất: giữ input mới nhất, lùi dần về lịch sử cũ hơn, dừng ngay khi vừa đủ chỗ. Token của những lượt cũ nhất bị loại hẳn khỏi request đó.
function build_request(history, current_input):
    total <- đếm_token(system_prompt) + đếm_token(current_input)
    included <- []
    for luot in đảo_ngược(history):     -- duyệt từ MỚI NHẤT lùi về CŨ NHẤT
        if total + đếm_token(luot) > token_limit:
            break                        -- hết chỗ: DỪNG
        included.add(luot)
        total <- total + đếm_token(luot)
    -- lượt CŨ NHẤT chưa được add khi chạm break — mất hẳn khỏi request này
    return system_prompt + đảo_ngược(included) + current_input
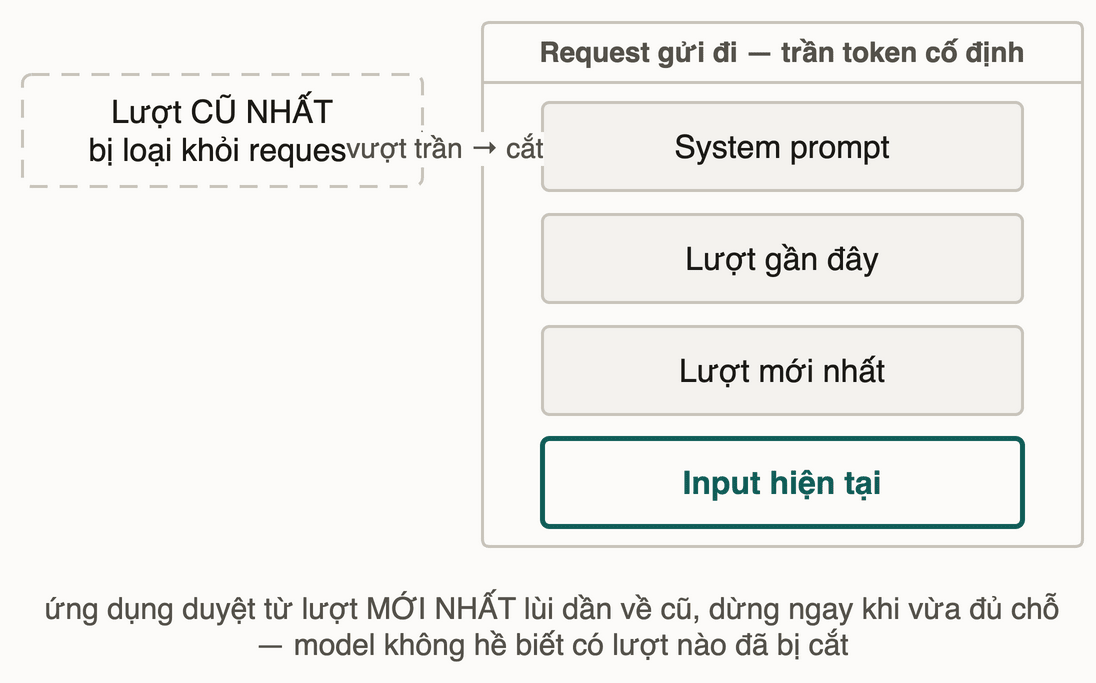
Đây là nguyên nhân của sự cố mở bài. Constraint dặn ở tin nhắn 1 không bị model "quên" theo nghĩa suy giảm năng lực: nó bị cắt khỏi request thuần cơ học khi hội thoại đủ dài. Tiếng Việt tốn token hơn (bài 02) nên cửa sổ đầy nhanh hơn, và constraint bị "quên" sớm hơn so với cùng hội thoại bằng tiếng Anh.
4. Vị trí nào trong context dễ bị bỏ sót?
Sự cố thứ hai ở đầu bài vẫn chưa được giải thích: đáp án nằm nguyên trong context, không hề bị cắt, sao model vẫn trả lời sai?
Bạn dán một tài liệu dài vào prompt, đặt đúng MỘT câu chứa đáp án ở một trong ba vị trí (đầu, giữa, hoặc cuối tài liệu), rồi hỏi model câu cần câu đó mới trả lời đúng. Toàn bộ tài liệu nằm gọn trong context, không vị trí nào bị cắt. Bạn đoán: đặt đáp án ở vị trí nào thì model dễ trả lời sai nhất?
Liu và cộng sự đo đúng hiện tượng này trên nhiều model có context dài (Lost in the Middle: How Language Models Use Long Contexts, arXiv:2307.03172). Khả năng truy xuất cao nhất khi thông tin cần thiết nằm ở đầu hoặc cuối context, và giảm rõ khi nó nằm ở giữa, dù thông tin đó chưa bao giờ bị cắt, chỉ bị "chôn" giữa một khối văn bản dài. Paper đặt tên cho hiện tượng này là lost-in-the-middle.
Tóm lại, "còn trong context" và "model chắc chắn dùng được" là hai chuyện khác nhau. Cửa sổ đủ rộng để chứa một tài liệu không có nghĩa là mọi phần của tài liệu được model chú ý như nhau.
5. Token trong context kéo theo những chi phí gì?
Token trong context là đơn vị bạn trả giá trên mấy mặt cùng lúc:
| Thứ bị ảnh hưởng | Vì sao | Hệ quả thực tế |
|---|---|---|
| "Trí nhớ" hội thoại | Đầy thì cắt token cũ nhất (mục 3) | Constraint/ngữ cảnh đầu hội thoại mất dần khi hội thoại dài ra |
| Độ chính xác truy xuất | Vị trí giữa context dễ bị bỏ sót (mục 4) | Tài liệu càng dài, đáp án nằm giữa càng dễ bị bỏ qua dù không bị cắt |
| Chi phí API | Tính tiền theo tổng token input + output | Prompt dài, đặc biệt tiếng Việt (tốn token hơn — bài 02), hoá đơn tăng nhanh hơn cảm giác |
| Tốc độ trả lời | Model phải xử lý hết context trước token đầu tiên, và mỗi token sau đó vẫn nhìn lại cả context | Context càng dài, chờ token đầu tiên càng lâu, mỗi token sau cũng nặng hơn một chút |
Thử ngẫmmột cuộc gọi hội nghị tính phí theo phút, và mỗi phút thêm cũng làm người điều phối phản ứng chậm hơn một nhịp. Token trong context giống "phút gọi" đó ở điểm nào?
6. Pitfall tổng hợp
❌ Nhầm 1: nghĩ model "yếu trí nhớ" khi hội thoại dài, và cách sửa là đổi sang model "thông minh hơn".
✅ Giới hạn token là cố định theo model, còn việc bỏ lượt nào là do ứng dụng quyết. Đổi model không giải quyết gốc nếu context window mới vẫn hữu hạn. Chỗ cần sửa là ứng dụng: tóm tắt lịch sử cũ, hoặc chủ động nhắc lại constraint quan trọng gần cuối prompt (hay đưa hẳn vào system prompt) thay vì chỉ để ở tin nhắn đầu.
❌ Nhầm 2: "còn chỗ trống trong context là an toàn, nhét bao nhiêu tài liệu cũng được".
✅ Còn chỗ chỉ đảm bảo không bị cắt, không đảm bảo model dùng đều. Fact quan trọng chôn giữa một tài liệu dài có nguy cơ bị bỏ sót (mục 4) dù chưa từng rời khỏi context. Muốn chắc model dùng một thông tin then chốt, đặt nó gần đầu hoặc gần cuối prompt.
❌ Nhầm 3: chỉ đếm token phần mình gõ, quên rằng phần model sinh ra cũng ăn vào cùng ngân sách.
✅ Kiến trúc autoregressive (bài 01) đưa cả token vừa sinh vào chuỗi đang xử lý tiếp, nên input càng dài thì chỗ còn lại cho output càng hẹp. Ước lượng ngân sách phải cộng cả hai chiều, và nhớ tiếng Việt tốn token hơn ở cả hai chiều.
7. 📚 Deep Dive
Paper chính chủ:
- Liu et al. — Lost in the Middle: How Language Models Use Long Contexts: nguồn của hiện tượng lost-in-the-middle ở mục 4. Abstract mô tả xu hướng theo vị trí một cách định tính, không kèm phần trăm, nên bài này không trích con số nào từ paper.
Ghi chú: bài không trích kích thước context window của model cụ thể nào vì con số đó đổi theo từng đợt nâng cấp. Tra tài liệu chính chủ đúng lúc build thay vì nhớ một con số cố định.
8. Liên hệ các bài khác
- Bài 01 — Dự đoán token kế tiếp: vòng lặp autoregressive dựa trên "toàn bộ token đứng trước"; context window là giới hạn của chính "toàn bộ" đó.
- Bài 02 — Tokenization: đơn vị đo context là token; tiếng Việt tốn token hơn nên lấp đầy cửa sổ nhanh hơn, cả ở input lẫn output.
- Bài 04 — Sampling: temperature và top-p: bước kế tiếp trong vòng lặp. Context quyết định model "thấy" gì, sampling quyết định model "chọn" token nào.
- Mini-challenge — đọc log ba sự cố: một trong ba sự cố là bot quên yêu cầu đầu hội thoại, đúng cơ chế mục 3 của bài này.
9. Tóm tắt
- Khi vượt trần, ứng dụng duyệt lịch sử từ mới về cũ và bỏ lượt cũ nhất; model không hề biết lượt đó từng tồn tại.
- Constraint chỉ nằm ở tin nhắn đầu là thứ đầu tiên rơi ra, nên đặt nó vào system prompt hoặc nhắc lại gần cuối.
- Lost-in-the-middle: thông tin chôn giữa context dài dễ bị bỏ sót hơn thông tin ở đầu/cuối, dù không hề bị cắt.
- Context dài làm tăng cả tiền lẫn thời gian chờ token đầu tiên.
10. Tự kiểm tra
- Q1Một chatbot hội thoại dài dần 'quên' yêu cầu được dặn ở tin nhắn đầu tiên. Đây có phải model suy giảm năng lực theo thời gian không? Giải thích cơ chế thật.
- Q2Vì sao cùng một ứng dụng chatbot, hội thoại bằng tiếng Việt 'quên' constraint đầu hội thoại sớm hơn hội thoại tương đương bằng tiếng Anh?
- Q3Một đáp án đúng nằm nguyên vẹn trong tài liệu bạn dán vào prompt, không bị cắt bớt. Vì sao model vẫn có thể trả lời sai câu hỏi cần đáp án đó?
- Q4Từ hiện tượng lost-in-the-middle, bạn nên đặt một constraint quan trọng (ví dụ: 'luôn trả lời bằng tiếng Việt') ở đâu trong một prompt dài để model tuân thủ chắc nhất, và vì sao?
- Q5Bạn ước lượng ngân sách token cho một tính năng chat, chỉ đếm token của prompt mình gõ. Vì sao ước lượng này thiếu, và thiếu theo hướng nào?
Bài tiếp theo: Sampling — temperature và top-p
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này