Từ base model đến chat model
Base model chỉ biết viết tiếp văn bản. SFT dạy nó dạng hỏi-đáp, RLHF chỉnh theo lựa chọn con người — vì thế model chat cư xử khác hẳn cỗ máy thô bên dưới.
TL;DR: Model bạn gọi qua API chat KHÔNG phải cỗ máy dự đoán token kế tiếp ở dạng thô: nó đã qua hai pha huấn luyện thêm. SFT (supervised fine-tuning) cho model xem các ví dụ "câu hỏi → câu trả lời chuẩn" do con người viết, dạy nó dạng hội thoại hỏi-đáp thay vì viết tiếp bất cứ thứ gì thống kê hay theo sau. RLHF (reinforcement learning from human feedback) chỉnh tiếp bằng lựa chọn của con người: model sinh nhiều câu trả lời, người chấm xếp hạng câu nào tốt hơn, model tối ưu theo xếp hạng đó. Hai pha này đổi hành vi (biết dừng, biết từ chối, làm theo yêu cầu, và có xu hướng bớt bịa hơn) chứ không nạp thêm kiến thức mới.
Một đội dựng trợ lý tra cứu tài liệu nội bộ, dùng thẳng một base model mã nguồn mở (chưa qua tinh chỉnh) vì rẻ và có sẵn. Prompt: "Cách đổi mật khẩu trong hệ thống X là gì?" Họ chờ một câu trả lời. Model trả về:
Cách đổi mật khẩu trong hệ thống X là gì?
Cách đổi email đăng ký trong hệ thống X là gì?
Cách xoá tài khoản trong hệ thống X là gì?
Cách lấy lại tài khoản bị khoá là gì?
Không có câu trả lời nào, chỉ một danh sách câu hỏi khác, cứ sinh tiếp tới khi chạm max_tokens. Đội nghĩ prompt sai, viết lại năm lần vẫn vậy. Model không hỏng: nó đang làm đúng việc nó được huấn luyện để làm, tức viết tiếp văn bản giống dữ liệu đã thấy. Bài này giải thích vì sao, và hai bước nào biến nó thành thứ biết "trả lời" thật.
1. Analogy: thực tập sinh mới đọc hết kho tài liệu
Một thực tập sinh vừa vào công ty, việc đầu tiên là đọc toàn bộ email, forum nội bộ và tài liệu FAQ trong ổ lưu trữ, không ai hướng dẫn thêm gì. Người này bắt chước văn phong rất giỏi nhưng chưa hiểu "trả lời khách hàng" là việc gì. Đưa cho họ một câu hỏi, họ viết tiếp theo đúng kiểu văn bản đã đọc, mà trong FAQ thì sau một câu hỏi thường là... một câu hỏi khác (mục lục, danh sách đề mục), nên họ liệt kê thêm câu hỏi.
Công ty sửa chuyện này bằng hai bước huấn luyện thêm:
| Thực tập sinh | LLM |
|---|---|
| Đọc hết kho tài liệu, bắt chước văn phong nhưng chưa hiểu vai trò | Base model: pretrain trên corpus khổng lồ, chỉ học dự đoán token kế tiếp |
| Xem hàng trăm ví dụ mẫu "khách hỏi X, nhân viên trả lời chuẩn Y" do quản lý soạn sẵn, tập làm theo đúng mẫu | SFT: fine-tune trên tập instruction-response do con người viết |
| Thử trả lời nhiều câu, quản lý xếp hạng câu nào ổn hơn, thực tập sinh chỉnh dần theo xếp hạng đó | RLHF: reward model chấm theo lựa chọn con người, model tối ưu theo điểm |
| Nhân viên chính thức: biết dừng đúng lúc, biết từ chối yêu cầu ngoài phạm vi, đúng vai | Chat model: làm theo chỉ dẫn, biết dừng, biết từ chối |
Base model là đọc hết kho tài liệu mà chưa ai dạy vai trò. SFT là xem mẫu chuẩn. RLHF là bị chấm điểm rồi chỉnh theo điểm. Ba bước, ba tầng hành vi khác nhau.
2. Base model làm gì với một câu hỏi?
Bài 01: LLM sinh văn bản bằng cách lặp một bước duy nhất: nhìn toàn bộ token đã có, dự đoán phân phối xác suất cho token kế tiếp, chọn một token, nối vào chuỗi, lặp lại. Không có bước nào trong vòng lặp đó biết "đây là câu hỏi, phải trả lời".
Base model (pretrained model) là kết quả trực tiếp của vòng lặp đó khi huấn luyện trên corpus khổng lồ (sách, web, forum, code) với đúng một mục tiêu: đoán đúng token kế tiếp của văn bản thật. Không có nhãn "đây là câu hỏi" hay "đây là câu trả lời chuẩn" nào được đưa vào; model chỉ học thống kê chữ gì hay theo sau chữ gì.
Hệ quả: đưa một câu hỏi cho base model, nó không coi đó là yêu cầu cần trả lời mà viết tiếp chuỗi theo thứ hay xuất hiện sau một câu hỏi trong dữ liệu huấn luyện. Nếu dữ liệu đó là trang FAQ, thứ hay theo sau một câu hỏi là một câu hỏi khác, đúng chuyện ở tình huống mở bài.
Thử ngẫmnếu phần lớn trang web mà base model đọc được đều là danh sách câu hỏi nối nhau, thứ nó học được về "điều gì theo sau một câu hỏi" sẽ lệch theo hướng nào?
3. SFT dạy model điều gì?
SFT (Supervised Fine-Tuning), tinh chỉnh có giám sát, là bước huấn luyện tiếp base model trên một tập dữ liệu nhỏ hơn nhiều, gồm các cặp (instruction, response mẫu) do con người (thường là người gắn nhãn được thuê) soạn: một yêu cầu, kèm câu trả lời đúng kiểu mong muốn.
Bài toán vẫn là dự đoán token kế tiếp, cơ chế học không đổi, chỉ đổi dữ liệu: giờ model chỉ thấy toàn cặp "hỏi rồi đáp thẳng, gọn, đúng trọng tâm". Học đủ nhiều cặp như vậy, token có xác suất cao nhất sau một câu hỏi không còn là "câu hỏi khác" mà là "bắt đầu câu trả lời".
SFT sửa đúng lỗi ở tình huống mở bài vì nó dạy model định dạng hội thoại. Nhưng khi hai câu trả lời cùng đúng định dạng, SFT chưa cho biết câu nào hay hơn, nên cần thêm một bước nữa.
4. RLHF chỉnh model theo lựa chọn con người ra sao?
RLHF (Reinforcement Learning from Human Feedback), học tăng cường từ phản hồi con người, chỉnh model đã qua SFT bằng một vòng khác:
1. Model (sau SFT) sinh nhiều câu trả lời khác nhau cho cùng một prompt
2. Người chấm xếp hạng: câu nào tốt hơn câu nào (không cần viết lại từ đầu)
3. Huấn luyện một "reward model" riêng: học dự đoán điểm số
   khớp với thứ tự xếp hạng của người chấm
4. Tối ưu model chính để sinh câu trả lời mà reward model chấm điểm cao hơn
Khác biệt cốt lõi: SFT cần con người viết câu trả lời mẫu (tốn công, phủ được ít tình huống), còn RLHF chỉ cần con người so sánh các câu model tự sinh ra. Cách này rẻ hơn và phủ rộng hơn, vì reward model tổng quát hoá từ những lần so sánh đó.
Toàn cảnh, nhìn qua đúng một prompt:
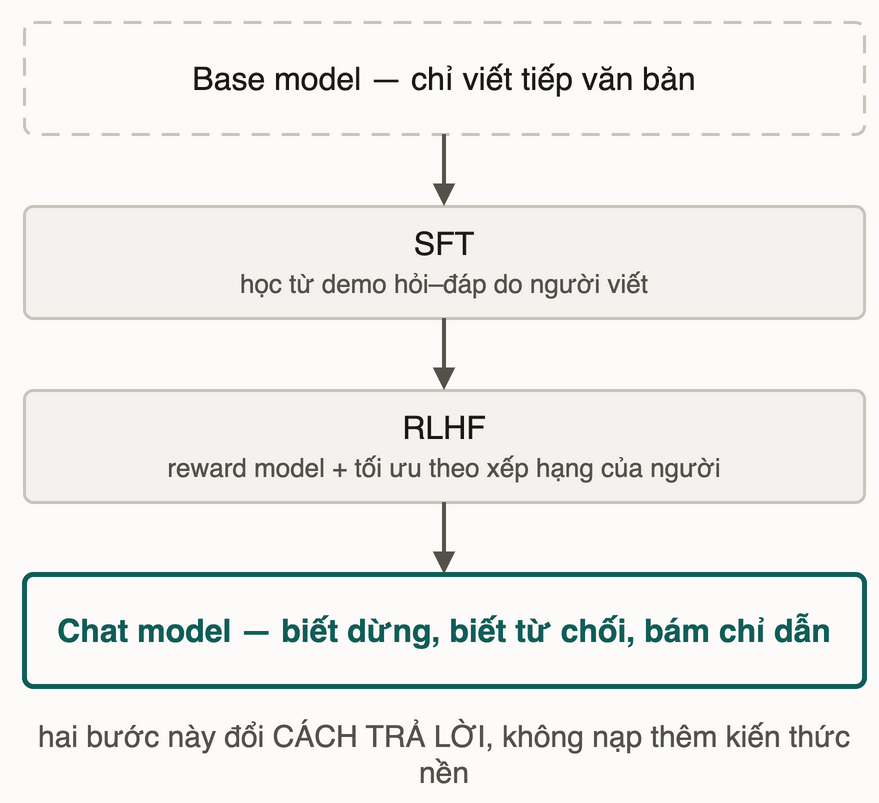
SFT là học bắt chước ví dụ mẫu con người viết. RLHF là học tối ưu theo lựa chọn của con người (xếp hạng, không viết mẫu). Cả hai đều là bước huấn luyện sau pretrain và đều KHÔNG đổi kiến trúc model, chỉ đổi trọng số nhờ dữ liệu thêm vào.
5. Base model trả lời "explain the moon landing" thế nào?
Prompt: "Explain the moon landing to a 6 year old in a few sentences." Đưa thẳng cho một base model (chưa qua SFT/RLHF). Bạn đoán nó sinh ra gì: một lời giải thích cho trẻ 6 tuổi, hay thứ khác hẳn? Viết dự đoán ra trước khi đọc tiếp.
Đây là ví dụ kinh điển cho khác biệt hành vi này. Base model GPT-3 không giải thích chuyến đổ bộ lên Mặt Trăng, mà viết tiếp một danh sách câu cùng khuôn: "Explain the theory of gravity to a 6 year old", "Explain the theory of relativity to a 6 year old", "Explain the big bang theory to a 6 year old"... Trong dữ liệu huấn luyện, câu dạng "Explain X to a 6 year old" hay nằm trong danh sách đề bài hay worksheet giáo dục, và thứ hay theo sau một đề bài trong danh sách là đề bài kế tiếp, không phải lời giải.
Model cùng họ GPT-3 sau khi qua SFT + RLHF (InstructGPT trong paper) nhận đúng prompt này thì trả lời thẳng: một đoạn giải thích ngắn, đơn giản, hợp với trẻ 6 tuổi, không liệt kê thêm đề bài nào.
Về kiến thức Mặt Trăng, hai model ngang nhau: cả hai học từ cùng loại dữ liệu về chủ đề đó. Chỗ khác duy nhất là hành vi: một bên viết tiếp theo khuôn thống kê "sau đề bài là đề bài", bên kia đã học "sau một yêu cầu là một câu trả lời trực tiếp, đúng đối tượng".
6. Pitfall tổng hợp
❌ Nhầm 1: RLHF làm model "biết nhiều hơn".
✅ RLHF không nạp kiến thức mới: kiến thức vẫn đến từ pretrain, và điều model chưa từng gặp thì RLHF không dạy được. Cái RLHF đổi được là xu hướng dùng kiến thức sẵn có: người chấm ưu tiên câu trung thực, ít bịa, nên model học cách trả lời thận trọng hơn. InstructGPT đo được trên TruthfulQA là câu trả lời vừa trung thực vừa có ích xuất hiện khoảng gấp đôi so với GPT-3, và bịa ít hơn trong các tác vụ tóm tắt. Nói gọn: RLHF sửa cách trả lời, gồm cả độ trung thực, chứ không mở rộng kho kiến thức.
❌ Nhầm 2: coi chuyện "model không trả lời thẳng, cứ liệt kê thêm câu hỏi" là bug cần sửa prompt.
✅ Với base model, đó là hành vi đúng theo cơ chế, không phải lỗi để prompt engineering vá. Cách sửa đúng là dùng model đã qua SFT (thêm RLHF nếu cần chất lượng cao hơn), không phải viết lại prompt cho base model.
❌ Nhầm 3: nghĩ SFT và RLHF là một bước, dùng lẫn hai tên.
✅ SFT cần con người viết ví dụ mẫu (tốn công, ít tình huống); RLHF chỉ cần con người so sánh các câu model tự sinh (rẻ hơn, phủ rộng hơn). Hai cách lấy dữ liệu khác nhau, thường chạy nối tiếp (SFT trước, RLHF sau) chứ không thay thế nhau.
7. 📚 Deep Dive
Paper chính chủ:
- Ouyang et al. — Training language models to follow instructions with human feedback (InstructGPT), arXiv:2203.02155: paper gốc mô tả pipeline SFT + reward model + RLHF (PPO) áp lên GPT-3, kèm số đo về độ trung thực và mức bịa của InstructGPT so với GPT-3.
Ghi chú: ví dụ "explain the moon landing to a 6 year old" đi kèm công bố InstructGPT (tài liệu công bố, không nằm nguyên văn trong bản paper), dùng để minh hoạ định tính khác biệt hành vi, không phải số đo độc lập của bài này. Con số TruthfulQA (~2×) lấy từ chính paper.
8. Liên hệ các bài khác
- Bài 01 — Dự đoán token kế tiếp: cơ chế autoregressive mà cả base model lẫn chat model đều dùng; hai loại model chỉ khác nhau ở dữ liệu huấn luyện thêm, không khác cơ chế sinh.
- Bài 06 — Hallucination: RLHF có làm model bớt bịa, nhưng không nạp thêm kiến thức, nên hallucination vẫn còn nguyên gốc cơ chế ở cả model đã qua SFT/RLHF.
- Mini-challenge — đọc log ba sự cố: phân biệt sự cố do cấu hình (tokenization, context, sampling) với chuyện hành vi model.
9. Tóm tắt
- Base model gặp câu hỏi thì viết tiếp như trong dữ liệu (ví dụ danh sách câu hỏi FAQ), cứ thế cho tới
max_tokens. - SFT đổi dữ liệu, không đổi cơ chế: học đủ cặp hỏi-đáp thì token xác suất cao nhất sau câu hỏi là "bắt đầu trả lời".
- RLHF rẻ hơn SFT ở khâu dữ liệu vì người chấm chỉ so sánh chứ không viết mẫu, rồi reward model tổng quát hoá.
- Ví dụ moon landing: cùng họ model, cùng kiến thức, chỉ khác hành vi sau SFT + RLHF.
10. Tự kiểm tra
- Q1Vì sao base model, khi nhận một câu hỏi, lại có xu hướng sinh thêm câu hỏi khác thay vì trả lời — và vì sao đây không phải bug sửa được bằng prompt hay hơn?
- Q2Phân biệt: SFT cần con người làm gì, và RLHF cần con người làm gì? Vì sao RLHF thường rẻ hơn khi mở rộng quy mô?
- Q3Một model đã qua SFT + RLHF trả lời sai một sự kiện lịch sử khá hiếm. Đồng nghiệp kết luận 'chắc RLHF làm hỏng kiến thức'. Đánh giá kết luận này.
- Q4Vì sao ví dụ 'giải thích chuyến đổ bộ lên Mặt Trăng cho trẻ 6 tuổi' cho ra hai kết quả khác hẳn nhau giữa base model và model đã qua SFT+RLHF, dù cả hai cùng họ model và cùng học từ dữ liệu có kiến thức về Mặt Trăng?
- Q5Đội bạn cân nhắc dùng base model thô (rẻ, có sẵn) cho một chatbot hỏi-đáp nội bộ để tiết kiệm chi phí. Dựa vào bài này, đánh giá lựa chọn đó.
Bài tiếp theo: Hallucination — vì sao model tự tin nói sai
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này