Hallucination — vì sao model bịa
Model không nói dối — nó chọn token khả dĩ nhất, không có khái niệm đúng/sai. Hallucination là hệ quả tất yếu của cơ chế, nên đoán trước được khi nào nó dễ xảy ra.
TL;DR: Model không "nói dối". Nó chọn token theo phân phối xác suất (bài 01), không có khái niệm đúng/sai, và không có bước kiểm chứng sự thật nào chạy song song. Khi cả dữ liệu train lẫn context đều không cho model căn cứ, nó vẫn phải chọn ra một token kế tiếp, và kết quả là một câu trả lời trôi chảy nhưng bịa. Đó là hallucination: hệ quả tất yếu của cơ chế, không phải bug ngẫu nhiên. Hiểu cơ chế cho bạn một thứ đáng giá hơn lời giải thích: đoán trước được tình huống nào dễ bịa, ngay từ trước khi hỏi.
Quay lại bài tokenization: bot trả lời sai khi đếm chữ "r" trong "strawberry", vì model không thấy ký tự mà chỉ thấy ID token. Nhưng bài đó còn bỏ ngỏ một câu hỏi: vì sao model không biết là mình có thể sai, mà vẫn trả lời dõng dạc như chắc chắn? Bài này trả lời câu hỏi đó, ở phạm vi rộng hơn nhiều so với chuyện đếm chữ.
Model chỉ nhìn được một cửa sổ token giới hạn. Thông tin nằm ngoài cửa sổ (bị cắt, hoặc chưa từng được đưa vào prompt) không góp phần gì vào phân phối xác suất model đang tính. Model không "biết mình thiếu dữ liệu"; nó vẫn chọn token kế tiếp như thường, chỉ là dựa trên ít căn cứ hơn.
Temperature điều chỉnh phân phối xác suất nhọn hay phẳng trước khi chọn token. Temperature cao làm phân phối phẳng ra, token xác suất thấp có cơ hội được chọn cao hơn hẳn. Với tác vụ cần chính xác (tra số liệu, trích dẫn), đó là vặn thêm may rủi vào đúng chỗ không nên vặn.
1. Analogy: người bị ép trả lời ngay
Hỏi một người bạn: "Thủ đô của Kyrgyzstan là gì?" Không biết thì người bình thường nói "tôi không chắc". Nhưng giả sử luật chơi bắt buộc phải trả lời ngay bằng một từ, không được im lặng. Người đó sẽ đoán, bằng trực giác về thứ nghe hợp lý: một cái tên nghe giống thành phố Trung Á. Có thể đúng, có thể sai, nhưng câu trả lời lần nào cũng được nói ra với vẻ tự tin như nhau, vì luật chơi không chừa chỗ cho mức độ chắc chắn.
Model đứng đúng ở vị trí đó, với mọi câu hỏi, vào mọi lúc:
| Người bị ép trả lời | Model sinh token |
|---|---|
| Không được nói "không biết" | Không có bước "im lặng vì không chắc"; muốn nói "không biết" thì chính câu đó phải là thứ khả dĩ nhất |
| Đoán bằng trực giác "nghe hợp lý" | Chọn token có xác suất cao theo phân phối đã học |
| Giọng tự tin như nhau dù nhớ chắc hay đoán | Chữ viết ra không mang dấu hiệu "nhớ chắc" hay "đoán" |
| Càng ít thông tin nền, càng dễ đoán sai | Câu hỏi ngoài dữ liệu train / thiếu context → phân phối thiếu căn cứ |
Model không có nút "im lặng". Mỗi bước sinh nó phải xuất ra một token, và hallucination là cái giá của việc không bao giờ được ngừng đoán.
2. Model phân biệt đúng và sai bằng cách nào?
Nó không phân biệt. Bài 01 đã dựng vòng lặp: model dự đoán token kế tiếp dựa trên toàn bộ token đứng trước, rồi lặp lại. Điều bài đó chưa nhấn là bên trong vòng lặp ấy không có bước nào kiểm tra sự thật: không có "fact-checker" chạy song song, không có bảng tra đối chiếu output với thế giới thực (trừ khi hệ thống cố tình gắn thêm công cụ ngoài, việc nằm ngoài phạm vi bài này). Model chỉ tính phân phối xác suất cho token kế tiếp, rồi chọn theo cơ chế sampling (bài 04).
"Đúng sự thật" và "khả dĩ về mặt thống kê" là hai trục khác nhau, và model chỉ tối ưu trục thứ hai. Phần lớn thời gian hai trục trùng nhau, vì văn bản đúng sự thật cũng thường phổ biến và mạch lạc trong dữ liệu train. Khi hai trục tách ra, model vẫn chọn theo trục nó tối ưu. Nó không "nói dối" theo nghĩa biết sự thật mà cố tình nói khác; nó không có kênh nào để biết sự thật ngoài chính phân phối xác suất đó.
Hai đường đi, một khi phân phối có căn cứ, một khi không:
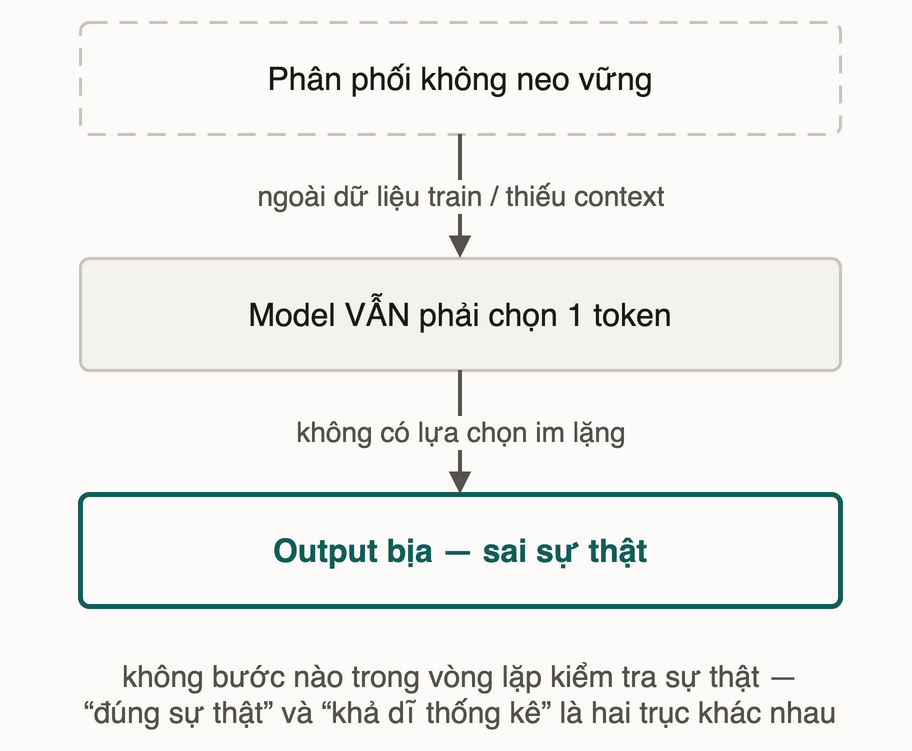
Mấu chốt nằm ở cuối hình: cả hai nhánh cho ra câu văn cùng một giọng trôi chảy, tự tin. Bên trong model thật ra có một phần thông tin về độ chắc chắn: xác suất của từng token thường thấp hơn khi model đang đoán, và model pretrain có mức hiệu chuẩn (calibration) khá tốt (Kadavath et al., arXiv:2207.05221). Nhưng thông tin đó nằm trong con số xác suất, không hiện ra trên chữ bạn đọc, và báo cáo kỹ thuật GPT-4 ghi nhận hiệu chuẩn còn giảm sau khi post-train bằng RLHF (OpenAI, arXiv:2303.08774). Vì vậy đọc bằng mắt thì rất khó bắt được hallucination.
3. Vì sao là hệ quả tất yếu, không phải bug ngẫu nhiên?
Gọi hallucination là "bug" là ngầm cho rằng vá được, và khi nó không xảy ra thì cơ chế đang "chạy đúng". Cách nhìn đó sai ở ba chỗ. Thứ nhất, cùng một cơ chế sinh cả câu đúng lẫn câu bịa, không có "chế độ bịa" riêng để tắt; chỉ đầu vào khác (câu hỏi có căn cứ hay không), cùng một phép tính cho ra kết quả khác. Thứ hai, xác suất token cao chỉ có nghĩa là khả dĩ theo thống kê, không có nghĩa là đúng sự thật. Thứ ba, vòng lặp autoregressive không có bước kiểm chứng: model có thể sinh ra token kết thúc, và chat model được huấn luyện để nói "tôi không biết", nhưng nó chỉ nói vậy khi chính câu đó là thứ khả dĩ nhất, chứ không phải vì đã tra lại sự thật.
Vậy hallucination không phải "khi model trục trặc", mà là hành vi mặc định khi phân phối thiếu căn cứ. Ji và cộng sự (Survey of Hallucination in Natural Language Generation, arXiv:2202.03629) liệt kê nhiều nguồn gây hallucination, trong đó có cả tính ngẫu nhiên của chiến lược decoding, và cho thấy hiện tượng này không riêng gì "vài model kém" mà gắn với chính cách văn bản được sinh ra.
"Model đời mới hơn, nhiều tham số hơn thì hết hallucination." Model tốt hơn thu hẹp vùng dễ bịa (học nhiều kiến thức hơn, phân phối có căn cứ ở nhiều chủ đề hơn), nhưng cơ chế autoregressive vẫn buộc nó chọn token khi gặp câu hỏi vượt ra ngoài vùng đó. Không kích thước model nào xoá hẳn tình huống "hỏi ngoài những gì đã học".
4. Tình huống nào dễ làm model bịa?
Trước khi đọc danh sách bên dưới: dựa trên những gì vừa đọc (phân phối cần căn cứ từ dữ liệu train hoặc context, và temperature ảnh hưởng độ phẳng của phân phối), bạn đoán tình huống nào khiến model dễ bịa nhất? Viết ra ít nhất hai tình huống trước khi cuộn tiếp.
Đoán ra được vài ý dưới đây là bạn đã hiểu cơ chế đủ để dự đoán hành vi, không chỉ nhớ triệu chứng.
1. Hỏi ngoài dữ liệu train. Sự kiện sau knowledge cutoff, hoặc chủ đề quá hẹp, quá mới nên hiếm trong kho huấn luyện. Phân phối không có gì làm căn cứ, model vẫn chọn token nghe hợp lý nhất.
2. Đòi chi tiết cụ thể: số, tên riêng, ngày tháng, trích dẫn. Nhóm nguy hiểm nhất vì dễ tưởng là đáng tin: một citation đầy đủ (tên tác giả, năm, tạp chí) nghe như đã tra cứu kỹ. Nhưng chi tiết càng cụ thể thì xác suất đúng từng chữ càng thấp nếu không có nguồn thật; model sinh ra thứ "trông giống trích dẫn" chứ không tra cứu trích dẫn. Citation bịa với định dạng hoàn hảo là dạng phổ biến nhất của nhóm này.
3. Context thiếu thông tin cần thiết (nối bài 03). Dữ kiện cần nằm ngoài cửa sổ context, do bị cắt vì hội thoại dài hoặc chưa từng được đưa vào prompt. Model tính phân phối dựa trên phần còn lại, thiếu căn cứ mà vẫn phải trả lời.
4. Temperature cao (nối bài 04). Phân phối bị chủ động làm phẳng, token xác suất thấp được chọn thường hơn. Với tác vụ cần chính xác (tra số liệu, trích dẫn), đó là tự tăng rủi ro bịa.
| Tình huống | Vì sao phân phối thiếu căn cứ |
|---|---|
| Ngoài dữ liệu train | Chủ đề không đủ dữ liệu để hình thành phân phối nhọn |
| Chi tiết cụ thể (số/tên/ngày/citation) | Đúng dạng thức dễ, đúng từng ký tự khó — model tối ưu dạng thức |
| Context thiếu thông tin | Dữ kiện cần thiết nằm ngoài cửa sổ token model đang thấy |
| Temperature cao | Phân phối bị làm phẳng chủ động, token xác suất thấp dễ được chọn |
5. Pitfall
❌ Nhầm 1: nghĩ giọng tự tin là dấu hiệu đáng tin.
✅ Giọng văn (mạch lạc, dõng dạc) không cho biết model chắc tới đâu, vì model không có cơ chế hạ giọng khi đoán. Tự tin và đúng là hai chuyện độc lập.
❌ Nhầm 2: tin citation vì đúng định dạng (tên tác giả, năm, tạp chí đầy đủ).
✅ Định dạng đúng dễ sinh hơn nội dung đúng: model học rất tốt khuôn trích dẫn học thuật, nhưng khuôn không đảm bảo bài báo có tồn tại. Luôn tra lại citation trước khi dùng.
❌ Nhầm 3: hỏi lại model "bạn có chắc không?" để kiểm tra.
✅ Câu hỏi đó đi qua đúng cơ chế sinh token vừa mô tả: model sinh ra lời xác nhận hoặc xin lỗi theo phân phối xác suất, không phải một phép tự kiểm tra độc lập. Cách đáng tin là đối chiếu nguồn bên ngoài (tài liệu gốc, search, con người), không phải hỏi lại chính model.
6. 📚 Deep Dive
Paper chính chủ:
- Ji et al. — Survey of Hallucination in Natural Language Generation (arXiv:2202.03629): tổng quan học thuật về hallucination trong sinh ngôn ngữ tự nhiên, gồm định nghĩa, nguồn gốc, và vì sao hiện tượng này gắn với bản chất xác suất của quá trình sinh.
- Kadavath et al. — Language Models (Mostly) Know What They Know (arXiv:2207.05221): đo mức model "biết mình biết gì" qua xác suất, nguồn cho ý "bên trong có một phần thông tin về độ chắc chắn" ở mục 2.
Ghi chú: bài này trình bày định tính, không trích con số benchmark tỉ lệ hallucination nào vì các con số đó đổi nhanh theo từng model và dễ lỗi thời. Cơ chế mô tả (phân phối thiếu căn cứ, không có bước fact-check) là phần ổn định, không phụ thuộc con số.
7. Liên hệ các bài khác
- Bài 01 — Dự đoán token kế tiếp: vòng lặp sinh token không có bước kiểm tra sự thật, gốc của mọi hallucination.
- Bài 03 — Context window: thiếu thông tin trong cửa sổ context là một trong bốn tình huống dễ bịa.
- Bài 04 — Sampling, temperature: temperature cao làm phân phối phẳng, tăng rủi ro chọn token bịa.
- Bài 05 — Từ base model đến chat: RLHF làm model bớt bịa nhưng không nạp thêm kiến thức.
- Mini-challenge — đọc log ba sự cố: chẩn đoán một sự cố hallucination trong log.
8. Tóm tắt
- "Đúng sự thật" và "khả dĩ thống kê" là hai trục; model chỉ tối ưu trục thứ hai, và phần lớn thời gian hai trục trùng nhau.
- Thông tin độ chắc chắn có nằm trong xác suất token, nhưng không hiện ra trên chữ, nên đọc bằng mắt rất khó bắt.
- Chi tiết cụ thể (citation, số liệu, ngày) là nhóm dễ bịa nhất vì đúng khuôn thì dễ, đúng từng chữ thì khó.
- Kiểm chứng bằng nguồn ngoài; hỏi lại "bạn có chắc không?" chỉ chạy lại đúng cơ chế cũ.
9. Tự kiểm tra
- Q1Vì sao gọi hallucination là 'bug' là cách nhìn không chính xác về mặt cơ chế?
- Q2Đồng nghiệp nói: 'Model trả lời rất dõng dạc, chắc chắn đúng.' Phản biện dựa trên cơ chế đã học ở bài này.
- Q3Bạn hỏi model một câu có kèm yêu cầu 'trích dẫn nguồn: tên tác giả, năm, tên tạp chí'. Vì sao đây là tình huống rủi ro hallucination cao, dù câu trả lời có thể trông rất chuyên nghiệp?
- Q4Nối với bài context window: vì sao một hội thoại rất dài với model dễ dẫn tới hallucination hơn một hội thoại ngắn, cùng chủ đề?
- Q5Bạn nghi một câu trả lời của model bị bịa, nên hỏi lại: 'Bạn có chắc chắn không?' Vì sao cách kiểm chứng này không đáng tin, và nên làm gì thay thế?
Bài tiếp theo: Mini-challenge — đọc log ba sự cố
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này