Tokenization — vì sao model không thấy ký tự
Model thấy token, không thấy chữ cái. Đó là gốc của lỗi đếm chữ, và lý do hoá đơn API tiếng Việt cao hơn tiếng Anh cho cùng nội dung.
TL;DR: LLM không đọc từng chữ cái. Văn bản được tokenizer cắt thành token (mảnh sub-word), và model chỉ thấy dãy số ID của các mảnh đó. Vì thế model đếm ký tự sai một cách có hệ thống; cùng nội dung, tiếng Việt tốn token hơn tiếng Anh, tức trả tiền API nhiều hơn. Số token không phải thuộc tính của văn bản mà của cặp (văn bản, tokenizer): mỗi model đếm một kiểu, nên ước lượng chi phí phải đo bằng đúng tokenizer của model đang dùng, đừng nhẩm theo quy tắc "4 ký tự = 1 token".
Team bạn ước lượng chi phí chatbot tra cứu policy nội bộ bằng quy tắc truyền miệng "1 token ≈ 4 ký tự". Hai triệu ký tự tài liệu tiếng Việt, nhân chia ra ngân sách gọn gàng. Cuối tháng đầu, hoá đơn API cao gần gấp đôi ước tính dù lưu lượng đúng dự phóng. Cùng lúc, tester báo một bug khó hiểu: hỏi bot "từ 'strawberry' có mấy chữ r?", bot dõng dạc trả lời sai.
Hai sự cố, một về tiền, một về đếm chữ, chung một gốc: model không nhìn thấy ký tự. Bài này giải thích tokenizer cắt văn bản thế nào, vì sao tiếng Việt bị "phạt" token, và đếm sao cho đúng.
Neuron chỉ nhân đầu vào với trọng số rồi cộng lại, tức chỉ làm việc với số. Văn bản phải đổi thành số trước khi vào model, và tokenizer là bước đổi đó.
1. Analogy: combo ở siêu thị
Siêu thị bán hàng theo combo: những món hay được mua cùng nhau (mì gói, trứng, xúc xích) gói sẵn, quét một mã vạch là xong. Món lạ không có combo thì phải quét từng món lẻ.
Tokenizer làm y hệt với văn bản. Chuỗi ký tự hay đi cùng nhau trong kho huấn luyện (phần lớn là tiếng Anh) như the, ing, tion được "đóng combo" thành một token; còn "Hôm nay" với dấu tiếng Việt ít gặp thì không có combo, bị quét thành nhiều mảnh lẻ.
| Siêu thị | Tokenizer |
|---|---|
| Combo mì + trứng + xúc xích, quét 1 mã | Chuỗi ký tự phổ biến gộp thành 1 token |
| Món lạ không có combo, quét từng món | Từ hiếm/có dấu bị cắt thành nhiều token |
| Danh mục combo chốt sẵn, in trước | Vocabulary cố định sau khi train tokenizer |
| Hoá đơn tính theo số lần quét | API tính tiền theo số token |
Token là combo ký tự: văn bản "quen" thì ít lần quét, văn bản "lạ" thì nhiều, và hoá đơn tính theo lần quét.
2. Token là gì, và model thấy gì?
Bài trước bạn đã thấy vòng lặp: model dự đoán mảnh kế tiếp dựa trên các mảnh đứng trước. Giờ nói rõ mảnh đó là gì. Token là đơn vị nhỏ nhất model xử lý: thường là mảnh của từ, đôi khi trọn một từ, đôi khi chỉ một ký tự. Tokenizer là chương trình tách văn bản thành token trước khi model thấy bất cứ thứ gì, dựa trên một vocabulary (danh mục token) cố định cỡ vài chục tới vài trăm nghìn mục.
Điểm then chốt: sau bước tách, model chỉ nhận dãy số ID, không nhận văn bản.
2.1 Tách thật bằng hai tokenizer
Đo bằng hai tokenizer của OpenAI (cl100k_base đời GPT-4, o200k_base đời GPT-4o), ngày 2026-07-23:
| Chuỗi | cl100k_base (đời GPT-4) | o200k_base (đời GPT-4o) |
|---|---|---|
strawberry | str · aw · berry — 3 token | st · raw · berry — 3 token |
Vietnam | Viet · nam — 2 token | Vietnam — 1 token |
Việt Nam | Vi · ệ · t · Nam — 4 token | Vi · ệt · Nam — 3 token |
Hôm nay | H · ôm · n · ay — 4 token | H · ôm · nay — 3 token |
500_000_000 | 500 · _ · 000 · _ · 000 — 5 token | 500 · _ · 000 · _ · 000 — 5 token |
Khoảng trắng được gộp vào token đứng sau (thực tế là ␣Nam, ␣n).
Bảng này lộ ra bốn điều:
- Với model,
"strawberry"là vài mảnh ID, và trong dãy ID không hề có "chữ r". Nhờ model đếm chữ r là hỏi thứ nó chưa từng thấy, nên sai không phải bug mà là hệ quả của kiến trúc. "Việt Nam"tốn token hơn"Vietnam"vì dấu tiếng Việt hiếm trong kho huấn luyện tokenizer, không được "đóng combo".- Code và số cũng bị cắt vụn: hằng số 11 ký tự thành 5 token (mục 4 đo kỹ hơn).
- Hai tokenizer cắt cùng một chuỗi ra kết quả khác nhau. Đây là bằng chứng đầu tiên cho luận điểm chính của bài: số token do tokenizer quyết, không nằm sẵn trong văn bản.
Thử ngẫmhai người dùng hai cuốn từ điển viết tắt khác nhau để mã hoá cùng một đoạn văn, ra hai bản mã dài ngắn khác nhau. Độ dài đó là thuộc tính của đoạn văn hay của cuốn từ điển?
3. BPE đóng combo như thế nào?
Thuật toán tách token phổ biến nhất là BPE (Byte Pair Encoding). Sennrich, Haddow và Birch đưa nó vào dịch máy năm 2016 (arXiv:1508.07909, ACL 2016) để xử lý từ hiếm bằng cách cắt từ chưa gặp thành các mảnh đã biết. Phần huấn luyện gói gọn trong một vòng lặp:
vocab <- tất cả ký tự đơn lẻ trong kho  -- khởi đầu: toàn "món lẻ"
while vocab.size < mục tiêu (vd 100k):
    (a, b) <- cặp token đứng cạnh nhau
              XUẤT HIỆN NHIỀU NHẤT trong kho văn bản
    vocab.add(merge(a, b))              -- đóng combo mới
    thay mọi (a, b) trong kho bằng combo vừa tạo
-- Kết quả: chuỗi phổ biến = 1 token, chuỗi hiếm = nhiều mảnh
(Biến thể hiện đại kiểu byte-level khởi đầu từ 256 giá trị byte (2^8) thay vì ký tự, nên chuỗi nào cũng mã hoá được, không còn "ký tự lạ" nằm ngoài vocabulary.) Chạy trên kho phần lớn là tiếng Anh thì th được merge sớm, rồi the, rồi the, nên tiếng Anh tích được nhiều combo dài. Chuỗi có dấu như ệt xuất hiện ít hơn nhiều bậc nên merge muộn hoặc không bao giờ được merge. "Bất công token" là hệ quả thống kê của dữ liệu huấn luyện tokenizer, không ai cố tình thiết kế. Đo trên nhiều ngôn ngữ, cùng một nội dung dịch ra các thứ tiếng chênh nhau tới 15 lần số token (Petrov et al., arXiv:2305.15425); kể cả tokenizer mức ký tự hay byte vẫn chênh hơn 4 lần, tức bỏ BPE cũng không xoá được vấn đề.
Toàn cảnh đường đi của văn bản:
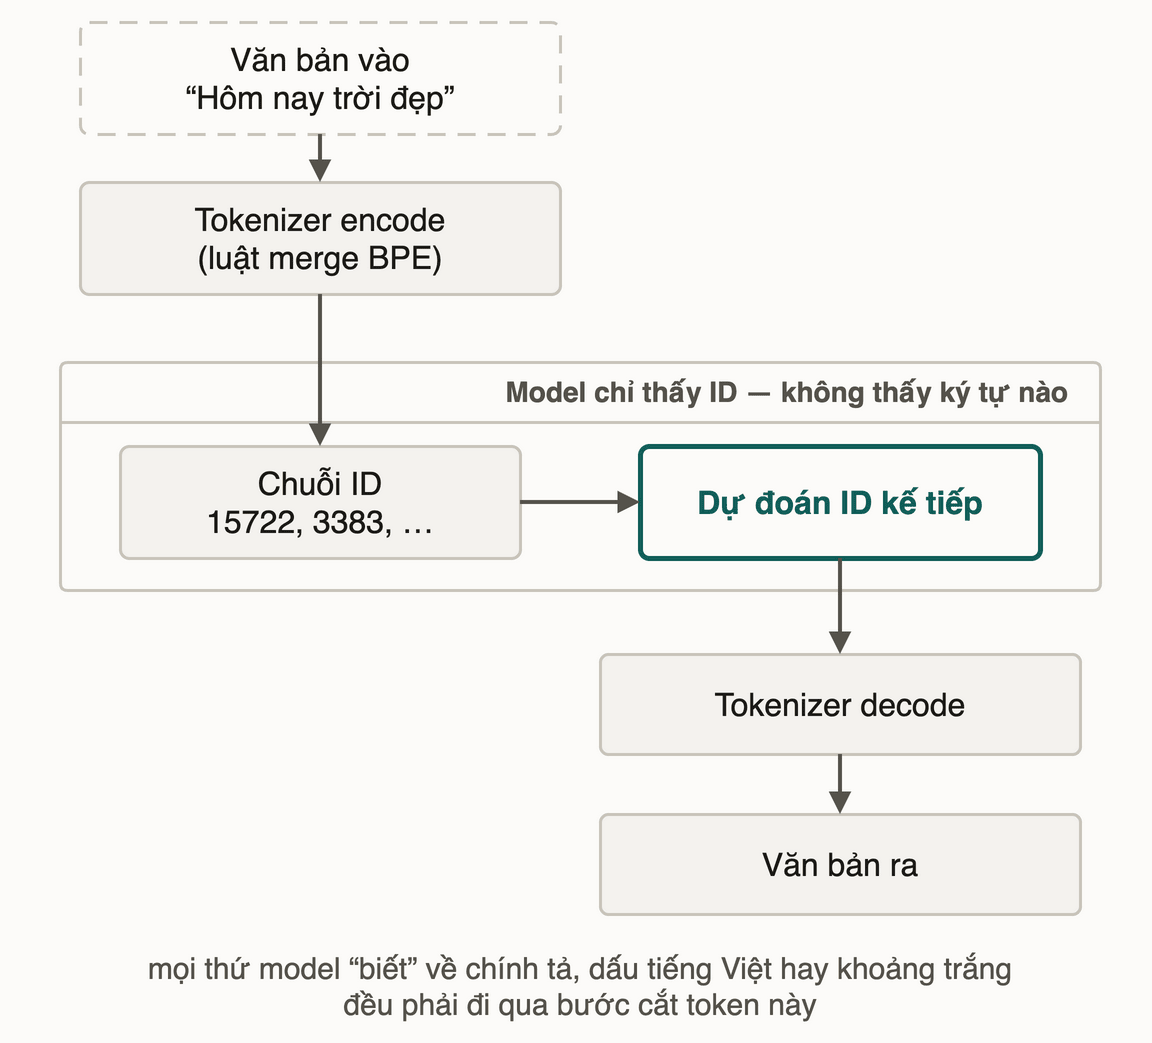
Hai hộp tokenizer (encode và decode) là biên giới duy nhất giữa thế giới ký tự và thế giới ID. Mọi thứ model "biết" về chính tả hay số chữ cái đều là kiến thức gián tiếp học từ dữ liệu, không phải quan sát trực tiếp.
4. Tiếng Việt "đắt" hơn bao nhiêu?
Đừng chỉ tin con số in sẵn, đoán trước đã.
Cùng nội dung viết bằng tiếng Việt và tiếng Anh, bạn đoán bản Việt tốn gấp mấy lần token? Viết ra con số trước khi cuộn tiếp.
Chúng tôi đo 5 cặp câu song ngữ cùng nội dung bằng cả hai tokenizer (thư viện gpt-tokenizer, đo 2026-07-23):
| Phép đo (tổng 5 cặp câu) | cl100k_base | o200k_base |
|---|---|---|
| Token bản tiếng Việt | 136 | 84 |
| Token bản tiếng Anh | 57 | 55 |
| Tỉ lệ Việt/Anh | 2.39× | 1.53× |
| Token mỗi từ — Việt | 2.13 | 1.31 |
| Token mỗi từ — Anh | 1.19 | 1.15 |
Đọc kết quả:
- Tiếng Việt tốn gấp rưỡi (1.53×, o200k) tới hơn gấp đôi (2.39×, cl100k) so với tiếng Anh cùng nội dung, khớp bậc độ lớn của nghiên cứu đa ngôn ngữ. Nhớ bậc, đừng nhớ số lẻ.
- o200k (vocabulary lớn hơn) cắt tiếng Việt tốt hơn hẳn. Tokenizer đời sau đã bớt bất công, nhưng khoảng cách vẫn còn.
- Đổi model có thể kèm đổi tokenizer. Model cùng họ thường dùng chung thước (GPT-3.5 và GPT-4 cùng
cl100k), nhưng khi tokenizer đổi thật thì độ lệch đáng kể: migration guide của Anthropic ghi tokenizer mới của một đời Opus dùng "roughly 1x to 1.35x as many tokens". Nâng cấp model là phải đo lại ngân sách token.
Cùng phép đo cho code: một dòng if dài 53 ký tự tốn 17 token trên cả hai tokenizer, tức ~3.1 ký tự/token, trong khi văn xuôi tiếng Anh cùng bộ đo được ~5.5. Ký hiệu, số, dấu chấm là chuỗi hiếm nên bị cắt lẻ, vì vậy code và JSON "đặc" token gần gấp đôi văn xuôi tiếng Anh.
Token là đơn vị của cả ba thứ bạn phải trả giá:
| Thứ bị ảnh hưởng | Vì sao | Hệ quả với tiếng Việt |
|---|---|---|
| Chi phí API | Tính tiền theo token vào + ra | Cùng nội dung, trả nhiều hơn theo đúng tỉ lệ token |
| Context window | Giới hạn đo bằng token (bài sau) | "Bộ nhớ làm việc" chứa được ít nội dung tiếng Việt hơn |
| Tốc độ sinh | Model sinh từng token một | Câu trả lời tiếng Việt cần nhiều bước sinh hơn |
Thử ngẫmmột dịch vụ giao hàng tính phí theo số kiện, không theo cân nặng. Đóng một món hàng thành 5 kiện nhỏ thay vì 2 kiện lớn có đổi tổng phí không?
5. Pitfall tổng hợp
❌ Nhầm 1: nhờ model đếm ký tự, đảo chữ, tách vần.
✅ Model không thấy ký tự, nên tác vụ mức ký tự (đếm, đảo chuỗi, soát chính tả từng chữ) là điểm mù của kiến trúc. Cần đếm thì để code đếm: code cho kết quả xác định, model chỉ đoán. (Code cũng phải chọn đúng đơn vị: text.length của JS đếm code unit UTF-16, một emoji có thể bị tính thành nhiều.) Việc máy tính xác định được thì đừng giao cho máy dự đoán.
❌ Nhầm 2: ước lượng chi phí bằng "1 token ≈ 4 ký tự".
✅ Đó là rough rule of thumb của OpenAI cho tiếng Anh. Với tiếng Việt, sai số đủ làm vỡ ngân sách như ở tình huống mở bài. Cách đúng: chạy vài mẫu tài liệu thật qua đúng tokenizer của model định dùng, lấy tỉ lệ đo được làm hệ số.
❌ Nhầm 3: dùng tiktoken đếm token cho mọi model.
✅ tiktoken là tokenizer của OpenAI. Dùng nó đếm cho Claude là đếm bằng thước của hãng khác, nên lệch có hệ thống, thiếu hay thừa tuỳ cặp tokenizer và không đoán trước được. Claude có endpoint count_tokens chính chủ; model khác có tokenizer riêng. Nguyên tắc: model nào, thước đó.
6. 📚 Deep Dive
Paper & tài liệu chính chủ:
- Sennrich, Haddow & Birch — Neural Machine Translation of Rare Words with Subword Units (ACL 2016): paper khai sinh BPE cho NLP. Đọc phần motivation để hiểu vì sao sub-word thắng cả word-level lẫn character-level.
- Petrov et al. — Language Model Tokenizers Introduce Unfairness Between Languages (NeurIPS 2023): nguồn của con số chênh tới 15 lần giữa các ngôn ngữ.
- tiktoken (OpenAI): tokenizer thật, chạy offline, tự tách thử mọi chuỗi bạn tò mò.
- Hugging Face NLP Course — chương Tokenizers: so sánh BPE / WordPiece / Unigram.
Ghi chú: hai paper là nền lý thuyết (chỉ con số 15 lần lấy từ Petrov et al.); các số đo tiếng Việt trong bài là đo độc lập bằng gpt-tokenizer, 2026-07-23.
7. Liên hệ các bài khác
- Bài 01 — Dự đoán token kế tiếp: vòng lặp sinh văn bản, mỗi bước sinh đúng một token, đơn vị mà bài này vừa định nghĩa.
- Bài 03 — Context window: "bộ nhớ làm việc" của model đo bằng token, nên chuyện tiếng Việt tốn token lặp lại ở đó.
- Bài 06 — Hallucination: lỗi đếm chữ r là ca nhỏ nhất của một hiện tượng lớn hơn, model tự tin về thứ nó không quan sát được.
- Mini-challenge — đọc log ba sự cố: sự cố số một cần đúng bài này để chẩn đoán.
8. Tóm tắt
- BPE gộp các chuỗi ký tự phổ biến thành combo: phổ biến thì ít token, hiếm thì nhiều; ký tự có dấu tiếng Việt hiếm trong kho huấn luyện nên bị cắt vụn.
- Code và JSON cũng "đặc" token: ~3.1 ký tự/token, so với ~5.5 của văn xuôi tiếng Anh.
- Chi phí API, sức chứa context và tốc độ sinh đều tính bằng token, nên tiếng Việt chịu thiệt ở cả ba.
- Tác vụ mức ký tự (đếm, đảo, chính tả) là điểm mù của model: giao cho code, đừng giao cho model.
9. Tự kiểm tra
- Q1Vì sao model trả lời sai câu 'strawberry có mấy chữ r' — và vì sao đây không phải bug sửa được bằng prompt hay hơn?
- Q2Cùng nội dung, vì sao
"Việt Nam"tốn nhiều token hơn"Vietnam"? - Q3Team bạn nâng cấp model lên đời mới hơn của cùng một hãng. Vì sao ngân sách token và ngưỡng cắt context phải đo lại từ đầu?
- Q4Bạn cần ước lượng chi phí cho chatbot nội bộ xử lý tài liệu tiếng Việt. Mô tả cách làm đúng trong khoảng mười phút, và giải thích vì sao quy tắc '1 token xấp xỉ 4 ký tự' cho ra ngân sách sai.
- Q5Bot của bạn trả kết quả qua API dạng JSON có cấu trúc. Từ số đo mật độ trong bài, giải thích vì sao hoá đơn output cao hơn dự tính dù phần chữ ít, và cách kiểm chứng.
Bài tiếp theo: Context window — bộ nhớ làm việc hữu hạn
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Dự đoán token kế tiếp — vòng lặp sinh văn bản
Bài tiếpContext window — bộ nhớ làm việc hữu hạn
Thảo luận & góp ý
Hỏi đáp về bài này