RAG — retrieve rồi mới generate
Không phải model tra database: đoạn liên quan được truy hồi rồi nhét vào context trước khi sinh. Hiểu từng bước để biết từng bước hỏng ở đâu.
TL;DR: RAG (Retrieval-Augmented Generation) không phải "cho model tra database bằng khoá trùng khớp". Các đoạn tài liệu liên quan được retrieve (truy hồi) bằng cosine similarity, rồi nhét vào context như tài liệu thí sinh được mở trong phòng thi, trước khi model sinh câu trả lời. Bài này trace đủ 5 bước của một lượt truy vấn (nhận câu hỏi, embed câu hỏi, retrieve top-k, nhét context, generate) và tách rõ chúng khỏi bước index-time chạy trước đó. Biết chính xác dữ liệu chảy qua đâu ở từng bước là điều kiện để sau này chẩn đoán được một hệ RAG hỏng ở chỗ nào.
Nhóm tra cứu policy nội bộ giờ đã có một index embed xong: mỗi chính sách được cắt đoạn, mỗi đoạn có một vector nằm trong không gian nghĩa ở bài 01. Gõ câu hỏi vào, hệ thống trả về vài đoạn tài liệu gần nghĩa nhất. Nhưng người dùng không muốn đọc nguyên văn điều khoản, họ muốn một câu trả lời thẳng. Ai đó đề xuất: "cứ nhét mấy đoạn tìm được vào cho model, bảo nó trả lời dựa trên đó". Có người phản đối: "vậy khác gì để model tự tra database rồi trả lời luôn?" Câu phản đối đó trộn hai cơ chế rất khác nhau, và bài này gỡ đúng chỗ trộn ấy.
Bạn đã học phép đo "gần nghĩa": cosine similarity giữa vector câu hỏi và vector từng đoạn, con số càng cao thì càng gần. Bước retrieve của bài này dùng đúng phép đo đó, và nó là phép xếp hạng tương đối, không có ngưỡng "đủ liên quan" mặc định.
1. Analogy: thi được mở tài liệu, không phải thi thuộc lòng
Một học sinh không thể nhớ nguyên văn cả cuốn sách giáo khoa. Nhưng trước khi viết bài, em được lật đúng vài trang liên quan nhất tới đề, không phải cả cuốn, chỉ vài trang do em (hoặc ai đó) chọn, rồi viết câu trả lời dựa trên kiến thức nền cộng với những trang vừa xem.
| Thi được mở tài liệu có chọn lọc | RAG |
|---|---|
| Không nhớ hết cả cuốn sách | Model không "chứa" toàn bộ tài liệu công ty trong tham số |
| Trước khi viết, lật đúng vài trang liên quan | Trước khi generate, retrieve đúng k đoạn liên quan nhất |
| Chỉ xem những trang đã chọn, không thấy phần còn lại của sách | Chỉ thấy k đoạn được nhét vào context, không thấy phần còn lại của index |
| Bài làm = kiến thức nền + trang vừa xem | Generate = tham số đã học (nền) + context vừa nhét (mới) |
Analogy hỏng ở một chỗ quan trọng: học sinh tự nhận ra "trang này lạc đề, bỏ qua" nếu lỡ lật nhầm. Model không có bước mặc định nào như vậy. Context đưa vào là nó dùng, coi như đáng tin, bất kể đoạn đó có thật sự liên quan hay không.
RAG = thi được mở tài liệu có chọn lọc: không thuộc lòng cả sách, chỉ được xem vài trang chọn sẵn, và trang được chọn XONG rồi mới bắt đầu làm bài.
Thử ngẫmhọc sinh tự bỏ qua được trang lật nhầm, lạc đề. Nếu một hệ RAG retrieve nhầm một đoạn không liên quan vào context, model có tự làm được điều tương tự không?
2. Không phải "tra database bằng khoá": retrieve là xếp hạng gần đúng
Phản ứng "vậy khác gì tra database" ở đầu bài trộn hai cơ chế khác hẳn nhau. Tra database bằng khoá (WHERE id = ...) là so khớp chính xác: đúng khoá thì ra đúng một dòng, sai khoá thì ra rỗng. Retrieve trong RAG không làm vậy. Nó tính cosine similarity giữa vector câu hỏi và từng vector trong index, xếp hạng toàn bộ theo điểm, rồi lấy k đoạn cao nhất. (Ở quy mô lớn, việc này làm bằng approximate nearest-neighbor như HNSW, IVF… chứ không so từng vector một, nhưng nguyên lý xếp hạng theo cosine vẫn vậy.)
Khác biệt lớn nhất: retrieve luôn trả về đúng k đoạn, vì danh sách xếp hạng nào cũng có k điểm cao nhất, kể cả khi tài liệu chẳng có đoạn nào trả lời được câu hỏi. Không có khái niệm "không tìm thấy" như khi tra khoá thất bại. Chỉ có k đoạn đỡ xa nhất trong đám còn lại, đúng hay sai với câu hỏi là chuyện khác.
Thử ngẫmmột index chỉ chứa tài liệu về bóng đá. Ai đó hỏi công thức nấu ăn. Retrieve vẫn trả về k đoạn bóng đá điểm cao nhất. Hệ thống có báo lỗi "không tìm thấy" không?
3. Trace pipeline: index-time trước, query-time sau
Toàn bộ pipeline tách làm hai giai đoạn không chạy cùng lúc.
Index-time chạy một lần, hoặc chạy lại mỗi khi tài liệu đổi, và không phụ thuộc câu hỏi nào. Tài liệu được cắt thành đoạn (chunking), mỗi đoạn được embed thành vector, và cặp (đoạn gốc, vector) được lưu vào index. Việc này xong trước khi người dùng gõ câu hỏi đầu tiên.
Query-time chạy lại từ đầu cho mỗi câu hỏi mới, gồm đúng 5 bước:
1. Query      -- cau hoi tho cua nguoi dung den he thong
2. Embed query -- embed CAU HOI bang DUNG model da dung luc index
3. Retrieve   -- tinh cosine similarity giua vector cau hoi va MOI vector trong index
              -- lay k doan diem cao nhat
4. Context    -- ghep k doan goc (khong phai vector) + cau hoi goc thanh MOT prompt dai hon
5. Generate   -- chay vong lap autoregressive tren prompt da mo rong, sinh cau tra loi
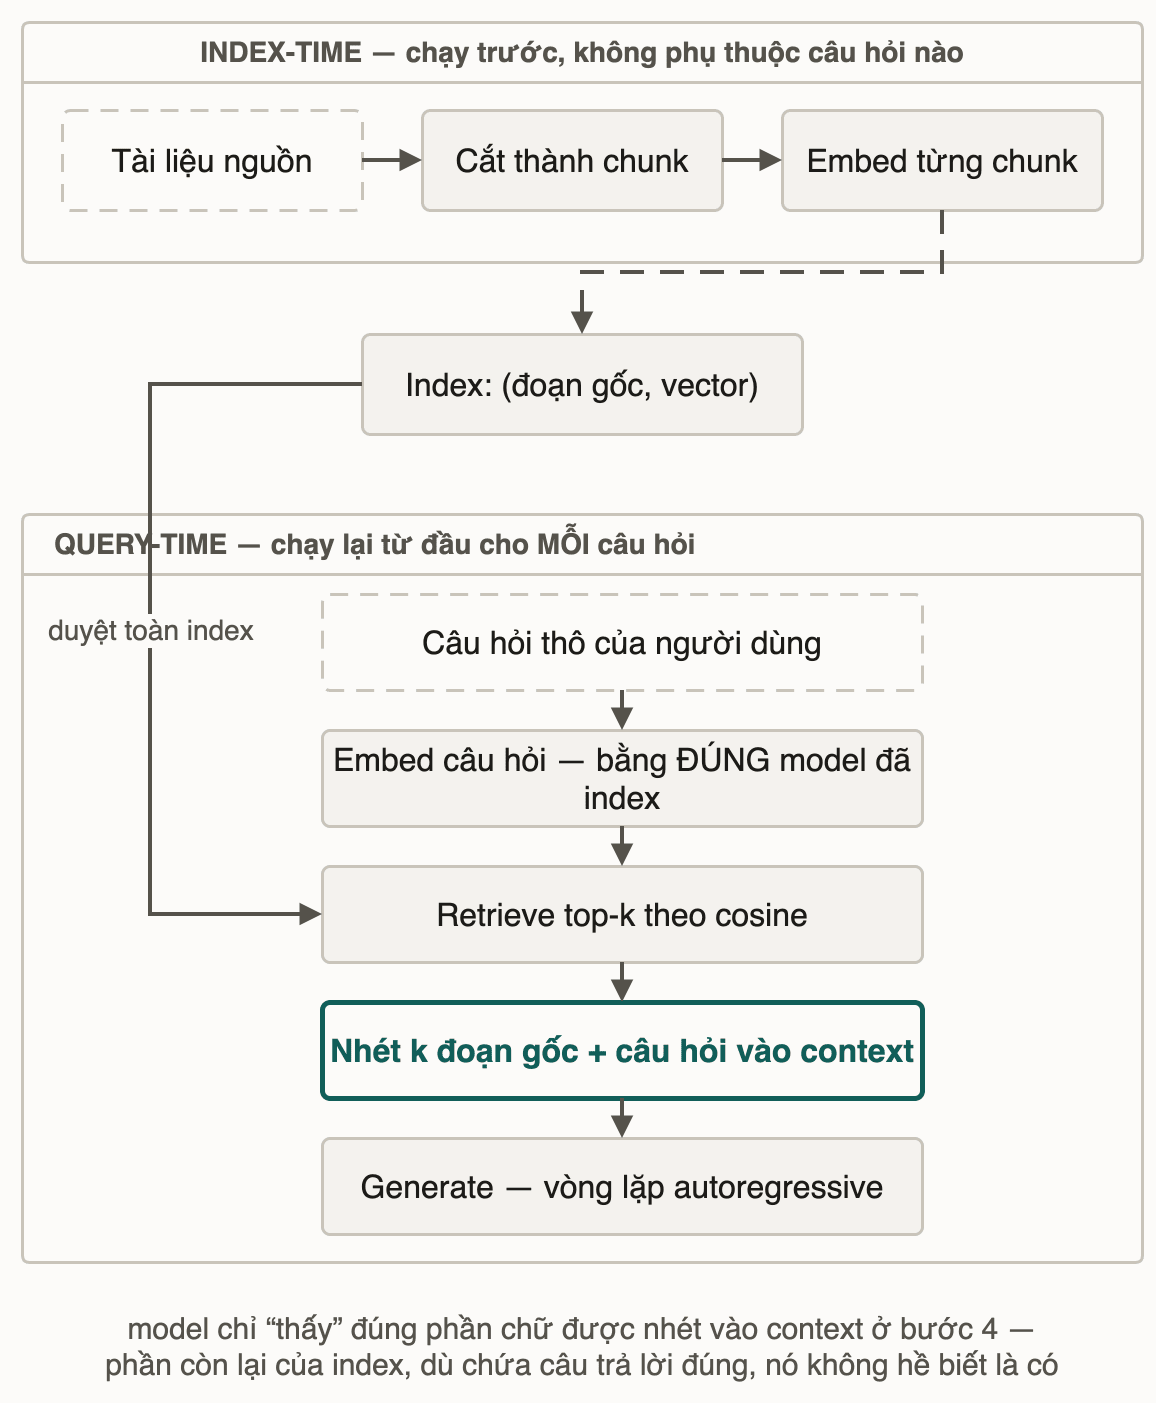
Hai điểm dễ bỏ sót khi trace. Bước 2 phải dùng đúng model đã dùng lúc index: hai model dựng hai không gian nghĩa khác nhau, vector câu hỏi và vector index sống ở hai nơi không so chéo được (bài 01). Còn bước 5 không có cơ chế gì mới: đó đúng là vòng lặp dự đoán token kế tiếp, chỉ khác input dài hơn vì chứa thêm k đoạn tài liệu trước câu hỏi.
Bạn đã trace: mỗi bước, model nhận toàn bộ chuỗi token đã có, tính phân phối xác suất cho token kế tiếp, chọn một token, nối vào, lặp lại. Bước generate ở đây chạy đúng vòng lặp đó; input chỉ dài hơn vì có thêm k đoạn được nhét vào trước câu hỏi.
4. Tự dự đoán: bước nào hỏng thì sai kiểu gì?
Trace xong 5 bước, thử dự đoán trước khi đọc tiếp: nếu một bước hỏng (các bước khác vẫn chạy đúng), hệ thống có tự báo lỗi không, hay vẫn chạy trơn tru và chỉ trả lời sai?
Viết ra một câu dự đoán triệu chứng cho mỗi tình huống, trước khi đọc phần giải thích ngay sau:
- Bước 2 (embed query) lỡ dùng sai model so với model đã dùng lúc index toàn bộ tài liệu. Triệu chứng quan sát được là gì?
- Bước 3 (retrieve top-k) chạy đúng cơ chế, nhưng không đoạn nào trong index thật sự trả lời được câu hỏi. Triệu chứng quan sát được là gì?
- Bước 4 nhét đúng đoạn chứa câu trả lời vào context, nhưng bước 5 vẫn generate sai chi tiết. Đây có phải lỗi của retrieve không?
Cả ba tình huống chung một điểm đáng ngại: không tình huống nào tạo ra lỗi runtime. Hệ thống vẫn chạy hết 5 bước, vẫn trả về một câu trả lời, chỉ là sai, và không có gì tự báo.
- Sai model ở bước 2: vector câu hỏi giờ sống trong không gian nghĩa khác với vector của cả index. Nếu hai model tình cờ cùng số chiều output (khá phổ biến khi đổi giữa hai model cùng họ), bước 3 vẫn tính cosine bình thường và vẫn xếp ra đúng k con số. Chỉ là những con số đó không phản ánh nghĩa thật, nên top-k gần như ngẫu nhiên, mà không có dòng lỗi nào. (Khác số chiều thì phép nhân vector báo lỗi ngay, đỡ nguy hiểm hơn vì lộ liền.)
- Retrieve "đúng" ở bước 3 dù index không có đoạn nào liên quan: cosine là phép xếp hạng tương đối (mục 2), không có ngưỡng loại bỏ mặc định. Index không có đoạn nào thật sự liên quan thì hệ thống vẫn răm rắp trả về k đoạn điểm cao nhất trong những gì đang có, dù tất cả đều lạc đề. Bước 4 vẫn nhét đúng k đoạn đó, bước 5 vẫn generate bình thường trên một context toàn nhiễu.
- Đây là ranh giới cần tách bạch: context ở bước 4 đã chứa đúng thông tin mà bước 5 vẫn sinh sai thì lỗi nằm ở generation, không phải retrieval. Hai nửa pipeline hỏng vì hai lý do khác hẳn nhau. Tách được câu hỏi "hỏng ở đâu" mới sửa đúng chỗ, thay vì đi đổi retrieval cho một lỗi thật ra nằm ở generation.
5. Pitfall tổng hợp
❌ Nhầm 1: coi RAG là cho model "tra database bằng khoá trùng khớp".
✅ Retrieve không so khớp chuỗi hay khoá chính xác. Nó xếp hạng toàn bộ index theo cosine similarity giữa vector câu hỏi và vector từng đoạn, rồi lấy k đoạn điểm cao nhất, và luôn trả về đủ k đoạn kể cả khi chẳng đoạn nào liên quan.
❌ Nhầm 2: coi RAG là cho model "đọc luôn" toàn bộ tài liệu trong index.
✅ Model không nhìn thấy index. Nó chỉ thấy phần chữ được nhét vào context ở bước 4. Nếu retrieve chọn sai đoạn, phần còn lại của index dù chứa câu trả lời đúng thì model cũng không hề biết là có.
6. 📚 Deep Dive
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (NeurIPS 2020, arXiv:2005.11401): nguồn gốc tên gọi và kiến trúc RAG. Động lực gốc của paper là kết hợp bộ nhớ tham số (parametric, kiến thức nén sẵn trong trọng số) với bộ nhớ phi tham số (non-parametric, một index truy hồi được và cập nhật độc lập với model), để câu trả lời có nguồn gốc tường minh và cập nhật được mà không phải train lại model. Giảm hallucination là lợi ích các nghiên cứu sau này ghi nhận thêm, không phải động lực ban đầu của bài báo năm 2020.
Ghi chú: đối chiếu nguồn ngày 2026-07-23; bài dùng paper làm nguồn gốc thuật ngữ và ý tưởng kiến trúc, không tóm tắt kết quả thực nghiệm của nó.
7. Liên hệ các bài khác
- Bài 02 — Cosine similarity: bước retrieve ở mục 3 là phép đo đó áp lên toàn bộ index.
- Bài 04 — Chunking: index-time bắt đầu từ đây; "đoạn" nhét vào context ở bước 4 là chunk được cắt ở bài đó.
- Dự đoán token kế tiếp: bước generate ở mục 3 là vòng lặp autoregressive đó, chỉ khác input dài hơn.
- Bài 06 — RAG failure modes: mỗi kiểu hỏng vừa dự đoán ở mục 4 sẽ được gọi đúng tên theo taxonomy.
- pgvector (khoá PostgreSQL — Advanced & Scale): bước retrieve dựng thật trong PostgreSQL, gồm lưu vector, index HNSW, và vì sao kết quả chỉ là xấp xỉ.
8. Tóm tắt
- Index-time chạy trước và chạy lại mỗi khi tài liệu hoặc embedding model đổi; query-time chạy lại cả 5 bước cho mỗi câu hỏi.
- Bước 2 dùng khác model với lúc index mà cùng số chiều là ca nguy hiểm nhất: không lỗi nào, top-k gần như ngẫu nhiên.
- Index chỉ có tài liệu bóng đá thì câu hỏi nấu ăn vẫn nhận về k đoạn bóng đá, vì retrieve không có khái niệm "không tìm thấy".
- Nguồn gốc RAG (Lewis et al., 2020): kết hợp bộ nhớ tham số với phi tham số để có nguồn gốc và cập nhật được, không phải ban đầu để chống hallucination.
9. Tự kiểm tra
- Q1Một đồng nghiệp nói: "RAG là cho model tra cứu đúng tài liệu bằng ID, giống một câu query database". Chỗ nào sai trong câu này, và cơ chế thật sự là gì?
- Q2Phân biệt index-time và query-time trong pipeline RAG: cái gì chạy khi nào, và vì sao gộp chung hai giai đoạn này là một nhầm lẫn hay gặp?
- Q3Bước 2 (embed query) lỡ dùng model khác với model đã dùng lúc index. Retrieve ở bước 3 có báo lỗi không? Vì sao đây lại là ca nguy hiểm?
- Q4Hệ thống nhét đúng đoạn tài liệu chứa câu trả lời vào context, nhưng model vẫn generate sai chi tiết. Lỗi này nằm ở retrieval hay generation? Giải thích.
- Q5Vì sao nói "model không biết những gì nằm ngoài context vừa được nhét vào", dù đoạn đó có nằm trong index đi chăng nữa?
Bài tiếp theo: Bốn kiểu hỏng của RAG: lỗi ở retrieval hay generation?
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Chunking — cắt tài liệu để truy hồi
Bài tiếpBốn kiểu hỏng của RAG: lỗi ở retrieval hay generation?
Thảo luận & góp ý
Hỏi đáp về bài này