Chunking — cắt tài liệu để truy hồi
Tài liệu phải cắt thành đoạn vì embedding model có trần input và vì một vector gánh nhiều chủ đề thì nhoè nghĩa. Cắt sai là nguyên nhân hỏng RAG hay gặp nhất.
TL;DR: Tài liệu phải cắt thành chunk (đoạn) trước khi embed, vì hai giới hạn cộng lại: embedding model có trần input đo bằng token (text-embedding-3 của OpenAI tối đa 8.192 token mỗi lần), và một vector có độ dài cố định nên đoạn quá dài bị nhiều chủ đề "trung bình hoá" làm nhoè nghĩa. Cắt sai cũng hỏng theo hai hướng ngược nhau: chunk quá nhỏ mất ngữ cảnh, chunk quá to nhồi nhiều chủ đề vào một vector.
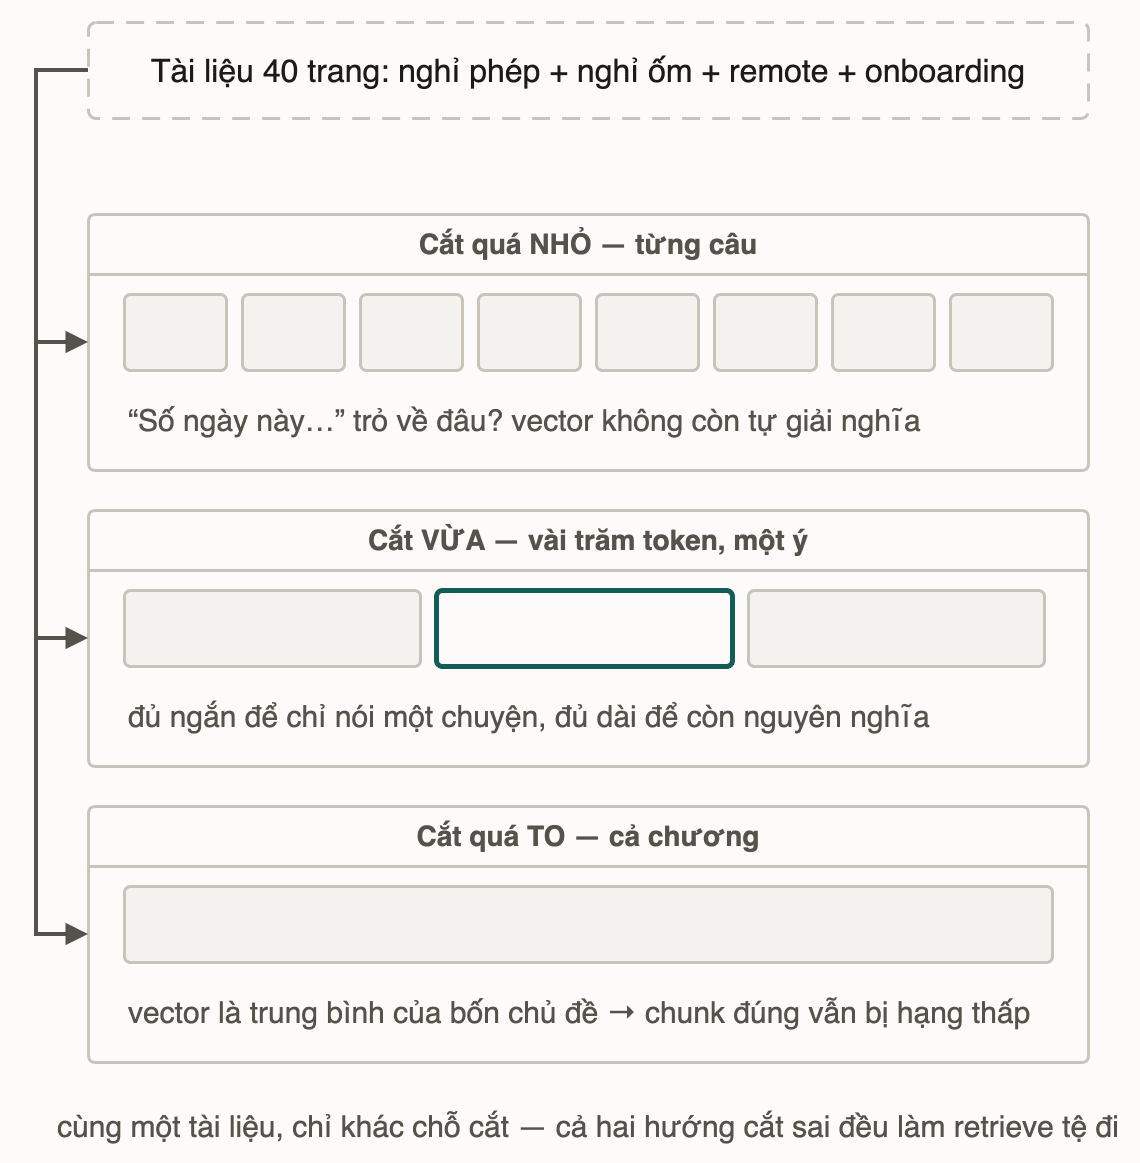
Nhóm ở bài trước đã embed câu hỏi ngắn "cách xin nghỉ phép năm" ra một vector gọn, đứng gần vector câu trả lời đúng trong tài liệu HR. Nhưng tài liệu HR không phải một câu. Nó là file 40 trang gồm nghỉ phép, nghỉ ốm, làm từ xa, onboarding. Ai đó thử cách đơn giản nhất: gửi nguyên file cho embedding API. API trả lỗi vượt giới hạn 8.192 token. Người khác dùng một thư viện bọc ngoài thì không thấy lỗi nào, vì thư viện đã lặng lẽ cắt cụt, chỉ giữ vài trang đầu. Mọi câu hỏi về nghỉ ốm hay làm từ xa nằm ở phần bị cắt nên không bao giờ tìm ra.
Nhóm lùi một bước: embed từng chương, mỗi chương vài nghìn token, vừa dưới trần. Hết lỗi, nhưng câu hỏi nào cũng trả về đúng chương to nhất mà vẫn không chỉ ra câu trả lời nằm ở đâu. Bài này giải thích vì sao phải cắt nhỏ hơn thế, và hai cách cắt sai hay gặp khiến việc cắt phản tác dụng.
Bài đó: context của model là bộ nhớ làm việc hữu hạn, đo bằng token, đầy thì phải cắt bớt. Chunking xử lý đúng giới hạn đó ở phía tài liệu nguồn: thay vì nhét cả kho tài liệu vào context, hệ thống chỉ chọn vài đoạn liên quan nhất để đưa vào. Muốn chọn được đoạn liên quan thì tài liệu phải được cắt thành đoạn từ trước.
1. Analogy: trích một đoạn trong sách, không đưa cả cuốn
Ai đó hỏi bạn: "cuốn này nói gì về cách xin nghỉ phép?" Bạn có hai lựa chọn. Một là đưa nguyên cuốn sách 40 trang và nói "trong đó có". Hai là lật đúng trang, trích ra đoạn 5 dòng nói về nghỉ phép. Cách hai hữu ích hơn hẳn. Đoạn 5 dòng không "đúng hơn" cả cuốn sách; nó đủ ngắn để chỉ nói một chuyện, và đủ dài để chuyện đó còn nguyên nghĩa.
| Đời thường | Chunking |
|---|---|
| Cả cuốn sách 40 trang | Toàn bộ tài liệu nguồn |
| Trích đúng đoạn 5 dòng về nghỉ phép | Một chunk: vài trăm token, một chủ đề |
| Trích 1 chữ "nghỉ": vô nghĩa, thiếu ngữ cảnh | Chunk quá nhỏ: mất ngữ cảnh |
| Trích cả chương 10 trang gồm nghỉ phép, nghỉ ốm, làm từ xa | Chunk quá to: nhiều chủ đề, nghĩa bị nhoè |
Chunk tốt giống một đoạn trích: đủ ngắn để chỉ nói một chuyện, đủ dài để chuyện đó còn nguyên nghĩa.
2. Vì sao phải cắt tài liệu thành chunk?
Hai lý do độc lập cùng dẫn về một kết luận: đừng embed nguyên cả tài liệu dài.
Lý do 1: trần input, đo bằng token. Có hai chỗ bị giới hạn. Embedding model nhận tối đa một số token mỗi lần embed: text-embedding-3-small và -large của OpenAI là 8.192 token (đọc 2026-09-24; model khác có trần khác, tra tài liệu model bạn dùng). Model sinh câu trả lời cũng chỉ chứa được một số token nhất định mỗi request. File HR 40 trang tiếng Việt đã vượt xa 8.192 token, chưa kể cả kho tài liệu công ty hàng trăm, hàng nghìn file. Vượt trần thì hoặc API báo lỗi, hoặc thư viện bọc ngoài cắt cụt mà không báo gì, và phần bị cắt không bao giờ vào vector. Hệ thống buộc phải chia nhỏ rồi chỉ đưa phần liên quan vào.
Lý do 2: độ dài vector cố định. Bài embedding đã nói: vector nào cũng ra cùng độ dài, bất kể input dài hay ngắn. Một câu 6 chữ và một chương vài nghìn token (vẫn dưới trần) đều ra ngần ấy con số. Với câu ngắn, ngần ấy con số đủ đại diện cho một ý. Với cả chương, chúng phải gánh hàng chục ý cùng lúc, nghĩa bị ép "trung bình hoá", và cái "trung bình" đó không nằm gần chủ đề nào trong không gian nghĩa.
embed("Đoạn 5 dòng: cách xin nghỉ phép năm")
  -> vector đại diện SÁT nghĩa cho đúng một chủ đề: nghỉ phép

embed("Cả chương 3.000 token: nghỉ phép + nghỉ ốm + remote + onboarding")
  -> vector đại diện MỜ cho bốn chủ đề cùng lúc
  -> câu hỏi về "nghỉ phép" hay câu hỏi về "remote" đều cho điểm gần bằng nhau
  -> similarity không còn phân biệt được đâu là chủ đề chính
Vì vậy tài liệu phải được cắt thành nhiều chunk trước khi embed: mỗi chunk ra một vector riêng, đại diện cho đúng phần nội dung của nó, thay vì một vector cố gánh cả tài liệu.
3. Thử đoán trước khi đọc tiếp
Bạn có một tài liệu FAQ nội bộ, mỗi mục hỏi–đáp dài khoảng 3–4 câu. Nếu cắt theo từng câu một (mỗi câu một chunk), retrieve sẽ hỏng theo hướng nào? Còn nếu cắt theo từng chương (gộp 20 mục hỏi–đáp khác nhau vào một chunk), retrieve sẽ hỏng theo hướng nào? Viết dự đoán ra trước khi đọc mục 4.
4. Hai cách cắt sai, và vì sao cả hai đều làm hỏng retrieve
4.1 Cắt quá nhỏ: mất ngữ cảnh
Cắt theo từng câu nghe hợp lý, vì câu là đơn vị ngữ pháp rõ ràng. Nhưng nhiều câu chỉ có nghĩa nhờ câu đứng trước:
Câu gốc trong tài liệu:
  "Nhân viên có 12 ngày phép mỗi năm.
   Số ngày này được cộng dồn nếu không dùng hết."

Cắt theo từng câu, chunk 2 đứng một mình:
  "Số ngày này được cộng dồn nếu không dùng hết."
  -- "Số ngày này" trỏ về đâu? Chunk không còn giữ thông tin đó.
Embed riêng chunk 2 thì vector của nó không còn mang thông tin "12 ngày phép": cụm "số ngày này" không tự giải nghĩa được nữa. Nếu chunk 2 lọt top kết quả, model nhận một câu thiếu chủ ngữ rõ ràng, và câu trả lời sinh ra dễ mơ hồ hoặc sai hẳn. Thông tin gốc chưa hề mất khỏi tài liệu; nó chỉ bị cắt sai chỗ.
4.2 Cắt quá to: nghĩa bị nhoè
Ngược lại, gộp nhiều mục hỏi–đáp không liên quan vào một chunk "cho chắc, đỡ mất ngữ cảnh" thì quay về đúng vấn đề ở mục 2: một vector phải đại diện cho nhiều chủ đề cùng lúc.
Chunk to = 20 mục hỏi-đáp: nghỉ phép, nghỉ ốm, remote, onboarding, ...
embed(chunk to) -> một vector "trung bình" của 20 chủ đề

Câu hỏi "cách xin nghỉ phép năm" so với chunk to:
  -> similarity không cao rõ rệt, vì 19/20 phần nội dung không liên quan
  -> chunk nhỏ hơn, tập trung đúng chủ đề nghỉ phép, có thể còn thắng điểm
Chunk càng to càng dễ "chứa" đáp án, nhưng điểm similarity của nó lại càng kém đại diện cho riêng phần đáp án đó. Chunk chứa câu trả lời chưa chắc được xếp hạng cao, vì phần nội dung còn lại kéo vector lệch khỏi chủ đề đang hỏi.
Thử ngẫmmột hợp đồng dài được cắt theo từng trang thay vì từng điều khoản. Câu hỏi về đúng một điều khoản có nguy cơ hỏng theo kiểu nào trong hai kiểu vừa học?
5. Vùng hay dùng và overlap
Không có một con số chunk-size đúng cho mọi tài liệu, vì độ dài hợp lý phụ thuộc văn phong nguồn (văn xuôi khác dòng log, khác cell bảng). Nhưng có một vùng hay dùng làm điểm khởi đầu: vài trăm token, đủ dài để giữ trọn một ý (mục 4.1) và đủ ngắn để không lẫn nhiều chủ đề (mục 4.2).
Cắt theo độ dài cứng thì vẫn có thể cắt ngang giữa một ý, y như lỗi ở mục 4.1 nhưng do vị trí cắt rơi ngẫu nhiên. Cách giảm rủi ro là cho các chunk liền kề overlap: chunk sau lặp lại một phần cuối của chunk trước, để ý bị cắt ngang vẫn còn nguyên trong ít nhất một chunk.
Tài liệu: [ ... đoạn A ... | ranh giới cắt cứng | ... đoạn B ... ]

Không overlap:
  chunk 1 = đoạn A          -- nếu ý bị cắt ngang ranh giới, cả 2 chunk đều thiếu
  chunk 2 = đoạn B

Có overlap (chunk 2 lặp lại phần cuối của chunk 1):
  chunk 1 = đoạn A
  chunk 2 = [phần cuối đoạn A] + đoạn B   -- ý bị cắt ngang giờ còn nguyên trong chunk 2
Overlap không miễn phí: phần lặp lại tốn thêm dung lượng và thời gian embed, vì cùng một câu văn giờ nằm trong hai chunk. Đó là đánh đổi có chủ đích, chấp nhận trùng lặp để khỏi cắt đứt một ý đúng ranh giới chunk.
Thử ngẫmtăng overlap giữa các chunk từ 0% lên 50% thì dung lượng lưu trữ tăng gần gấp đôi. Khi nào cái giá đó đáng trả, và khi nào là lãng phí?
6. Pitfall tổng hợp
❌ Nhầm 1: chọn chunk-size càng nhỏ càng an toàn, vì "nhỏ thì tìm chính xác hơn".
✅ Chunk nhỏ đúng là cho similarity "sắc" hơn với một câu đơn lẻ, nhưng câu tách khỏi ngữ cảnh dễ mất chủ ngữ, mất mốc thời gian, mất điều kiện đi kèm (mục 4.1). Retrieve có thể đúng file mà sai nghĩa.
❌ Nhầm 2: chọn chunk-size càng to càng an toàn, vì "to thì không sót thông tin".
✅ Chunk to không mất thông tin bên trong, nhưng vector đại diện cho nó nhoè tới mức chunk chứa đúng câu trả lời chưa chắc được xếp hạng cao (mục 4.2). Thông tin có mặt mà không được tìm thấy. Còn nếu to quá trần input của embedding model thì phần vượt trần bị cắt hẳn.
7. 📚 Deep Dive
Chunk-size tối ưu phụ thuộc mạnh vào embedding model, loại tài liệu và task, nên đo trên chính dữ liệu của hệ thống: lấy 30–50 câu hỏi thật, thử hai ba cỡ chunk, so tỉ lệ đoạn đúng lọt top-k (cách đo ở mục 4.2 bài Embedding). Trần input của từng embedding model ghi trong tài liệu của nhà cung cấp, ví dụ OpenAI Embeddings guide (đọc 2026-07-23).
8. Liên hệ các bài khác
- Bài 01 — Embedding, không gian của nghĩa: gốc của lý do 2, vì sao vector độ dài cố định làm nghĩa bị trung bình hoá.
- Context window: gốc của lý do 1, vì sao hệ thống chỉ đưa được vài đoạn, không phải cả kho tài liệu.
- Bài 05 — RAG pipeline: chunk là đơn vị được embed, lưu trữ và retrieve trong toàn bộ pipeline RAG.
- Bài 06 — RAG failure modes: cắt chunk sai là một nguyên nhân gốc hay gặp khi retrieve trả về sai đoạn.
9. Tóm tắt
text-embedding-3nhận tối đa 8.192 token mỗi lần; file 40 trang vượt trần thì bị từ chối hoặc bị cắt cụt không báo, phần thừa không bao giờ tìm ra.- "Số ngày này được cộng dồn…" đứng một mình là ví dụ chunk quá nhỏ: chữ còn nguyên mà nghĩa mất vì câu giải nghĩa nằm ở chunk khác.
- Vài trăm token là điểm khởi đầu, không phải con số tuyệt đối; chốt cỡ chunk bằng tỉ lệ lọt top-k trên câu hỏi thật.
- Overlap mua sự an toàn ở ranh giới cắt bằng dung lượng: 50% overlap là gần gấp đôi dung lượng lưu trữ.
10. Tự kiểm tra
- Q1Vì sao chunking vẫn cần thiết ngay cả khi context window của model sinh câu trả lời đủ lớn để chứa toàn bộ tài liệu?
- Q2Một đồng nghiệp cắt tài liệu theo từng câu để 'tìm cho chính xác'. Điều gì có thể hỏng, và tại sao đây không phải lỗi mất dữ liệu?
- Q3Một hệ thống chunk theo từng chương (chunk rất to) và than phiền retrieve 'bỏ sót' câu trả lời đúng dù câu đó nằm trong một chunk bị xếp hạng thấp. Giải thích cơ chế, không phải 'model kém'.
- Q4Overlap giữa các chunk liền kề giải quyết vấn đề gì, và cái giá phải trả là gì?
- Q5Vì sao không có một con số chunk-size 'đúng' áp dụng chung cho mọi tài liệu?
Bài tiếp theo: RAG: retrieve rồi mới generate
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này