Mini-challenge: chọn kiến trúc cho ba bài toán thật
Ba bài toán nghe giống nhau — chatbot policy, tài liệu kỹ thuật, trợ lý tester. Tự chọn prompt-only / RAG / fine-tune; có bài không cần RAG.
TL;DR: Kiến trúc cho một hệ hỏi–đáp trên tài liệu không quyết bởi "có tài liệu hay không", mà bởi ba trục: kho tài liệu có vượt cửa sổ context không, truy vấn là ngôn ngữ tự nhiên hay định danh chính xác, và dữ liệu đổi bao lâu một lần. Bài này đưa ba scenario ngân hàng để bạn tự áp ba trục đó, chọn giữa prompt-only, RAG, RAG hybrid và fine-tune, rồi liệt kê rủi ro và ước lượng chi phí trước khi xem lời giải.
Bạn là tech lead một đội nền tảng nội bộ ngân hàng. Sáng thứ Hai, ba ticket cùng rơi vào backlog, cả ba mở đầu bằng đúng một câu: "Mình muốn làm con chatbot AI cho...". Sếp muốn mỗi ticket một đề xuất kiến trúc kèm rủi ro và ước tính chi phí, xong trước chiều.
Cả ba nghe như nhau, đều là "hỏi đáp trên tài liệu công ty". Nhưng trả lời cả ba bằng cùng một kiến trúc thì ít nhất một cái sẽ hoặc đội chi phí vô ích, hoặc hỏng ở đúng loại câu hỏi quan trọng nhất. Bài này bắt bạn phân biệt chúng.
🎯 Đề bài: ba ticket
Với mỗi ticket, bạn phải nộp ba thứ: (1) kiến trúc: prompt-only, RAG, RAG hybrid, hay fine-tune; (2) ước lượng chi phí thô: kho tài liệu rơi vào bậc bao nhiêu token, có vừa context không; (3) rủi ro: hai tới ba rủi ro cụ thể của lựa chọn đó.
Ticket A: chatbot tra cứu policy nhân sự
- Kho: ~500 văn bản policy (nghỉ phép, thai sản, công tác phí…), mỗi văn bản 3–8 trang, viết bằng tiếng Việt.
- Cập nhật: sửa vài lần mỗi năm khi quy định đổi; trả lời sai điều khoản là rủi ro tuân thủ.
- Truy vấn: ngôn ngữ tự nhiên, ví dụ "nghỉ thai sản được bao nhiêu ngày theo policy 2024?". Người dùng cần biết câu trả lời dựa trên điều khoản nào.
Ticket B: trợ lý tra cứu tài liệu kỹ thuật
- Kho: runbook vận hành và wiki kỹ thuật của đội, vài nghìn trang.
- Cập nhật: wiki đổi liên tục, mỗi lần deploy hoặc có sự cố lại có người sửa.
- Truy vấn: xoay quanh định danh chính xác, ví dụ "lỗi
ERR-PAYMENT-4023xử lý thế nào?", "endpoint/api/v2/transfersnhận field gì?", "bug này fix ở version nào?".
Ticket C: trợ lý cho tester trong đợt UAT
- Kho: ~150 test spec của một đợt UAT, mỗi spec trung bình nửa trang, đặc bảng, mã ID và số liệu.
- Cập nhật: cố định suốt đợt test (2–3 tuần), không sửa giữa chừng.
- Truy vấn: ngôn ngữ tự nhiên, ví dụ "test case nào cover luồng chuyển khoản liên ngân hàng?", "spec cho hạn mức giao dịch nằm ở đâu?".
🧭 Bộ tiêu chí quyết định
Đây là các tiêu chí bạn đã gặp rải rác trong module, gom lại một chỗ. Nó cho tiêu chí, không cho sẵn đáp án của ba ticket; việc ghép là của bạn.
| Kiến trúc | Chọn khi | Cái giá phải trả |
|---|---|---|
| Prompt-only (nhét thẳng tài liệu vào context) | Toàn bộ tài liệu liên quan vừa cửa sổ context và ổn định trong một phiên | Trả token cho cả kho mỗi request; kho lớn thì bất khả thi |
| RAG (retrieve top-k rồi mới sinh) | Kho vượt context, hoặc đổi thường xuyên, hoặc cần trích nguồn | Hạ tầng vector store, thêm một chỗ có thể hỏng: retrieval |
| RAG hybrid (keyword + vector) | Như RAG, nhưng truy vấn xoay quanh định danh chính xác | Phức tạp hơn: hai đường tìm kiếm phải gộp kết quả |
| Fine-tune | Đổi giọng/định dạng/hành vi đầu ra | Đắt, phải train lại khi dữ liệu đổi; nạp dữ kiện không đáng tin |
Ba câu hỏi lọc, theo thứ tự:
- Kho có vượt cửa sổ context không? Ước lượng: (số văn bản × độ dài trung bình) × hệ số token tiếng Việt. Nếu không vượt và dữ liệu tĩnh trong phiên, cân nhắc prompt-only trước khi nghĩ tới RAG.
- Truy vấn là ngôn ngữ tự nhiên hay định danh chính xác? Nếu trung tâm là mã/tên/version thì semantic thuần sẽ trượt, cần hybrid.
- Dữ liệu đổi bao lâu một lần? Đổi thường xuyên thì nghiêng về RAG (re-index rẻ); fine-tune phải train lại nên gần như luôn thua ở trục này.
Nhớ lại bài tokenization: cùng nội dung, tiếng Việt tốn gấp rưỡi tới hơn gấp đôi token so với tiếng Anh. Khi ước lượng kho tài liệu tiếng Việt có vừa context không, đừng dùng quy tắc "4 ký tự = 1 token" của tiếng Anh, vì nó cho ra con số lạc quan quá mức.
✍️ Phần việc của bạn
Trước khi cuộn xuống, viết ra (trên giấy hoặc trong đầu, nhưng phải thành câu) cho cả ba ticket:
- Kiến trúc bạn chọn, và một câu vì sao.
- Ước lượng thô: kho rơi vào bậc bao nhiêu token, có vừa cửa sổ context của một model chat phổ biến không.
- Hai tới ba rủi ro cụ thể cho lựa chọn đó.
Generation trong RAG cần bốn năng lực có tên chuẩn (benchmark RGB, xem phần Mở rộng): noise robustness (không bị đoạn nhiễu kéo lệch), negative rejection (biết từ chối khi kho không có đáp án), information integration (gộp được nhiều nguồn), counterfactual robustness (không tin theo tài liệu sai). Bài rag-failure-modes đi qua từng cái; ở đây dùng bốn tên này làm danh sách soát khi liệt kê rủi ro cho mỗi ticket.
Với mỗi ticket, tự hỏi kiến trúc đơn giản nhất nào đáp ứng đủ ba trục trước khi mặc định chọn RAG chỉ vì nó là chủ đề của module.
Câu hỏi thứ tư, chẩn đoán hai lỗi: hai hệ đã lên production, mỗi hệ báo một lỗi. Với mỗi lỗi, tự trả lời: hỏng ở bước retrieval hay generation, và ứng với failure mode nào, trước khi xem lời giải.
Cả hai đều là hệ RAG của Ticket A:
- Lỗi 1: hỏi "nghỉ thai sản theo policy 2024", bot trả lời đúng định dạng nhưng trích policy 2022 (đã hết hiệu lực). Log cho thấy top-k chỉ có các đoạn của bản 2022.
- Lỗi 2: hỏi về "chế độ nghỉ không lương dài hạn", một chính sách công ty chưa ban hành. Kho không có đoạn nào về nó, nhưng bot vẫn trả một câu chi tiết, tự tin (kèm số ngày, điều kiện cụ thể) như thể policy đó có thật.
Hai lỗi nghe giống nhau ("bot trả sai") nhưng nằm ở hai bước khác nhau của pipeline. Phân biệt được chúng mới gọi là chẩn đoán.
💡 Gợi ý
Ở đây không có con số hay lựa chọn nào, chỉ có câu hỏi để bạn tự lần ra. Chưa viết xong phần việc ở trên thì quay lại làm trước.
- Ước lượng token: mỗi kho nhân ra khoảng bao nhiêu token (nhớ hệ số tiếng Việt)? Con số đó lớn hơn hay nhỏ hơn cửa sổ context của một model chat 2026? Câu trả lời quyết định prompt-only còn khả thi hay không.
- Loại truy vấn: câu hỏi của người dùng chủ yếu là ngôn ngữ tự nhiên hay xoay quanh một chuỗi định danh chính xác? Bài semantic-vs-keyword nói gì về loại thứ hai?
- Cập nhật: dữ liệu mỗi ticket đổi bao lâu một lần? Nếu đổi, kiến trúc bạn chọn cập nhật bằng cách nào: re-index, sửa prompt, hay train lại toàn bộ?
- Phản chứng: với từng ticket, hỏi ngược "nếu bỏ retrieval đi thì hỏng chỗ nào?" và trả lời trung thực với chính mình.
- Rủi ro: nhìn lại bốn failure mode ở bài rag-failure-modes, cái nào áp cho kiến trúc bạn vừa chọn?
- Chẩn đoán: "hỏng ở retrieval" khác "hỏng ở generation" thế nào? Mỗi lỗi thuộc bên nào? (Bốn failure mode chỉ mô tả một trong hai bước đó.)
✅ Lời giải
Không có đáp án "đúng tuyệt đối", chỉ có lập luận vững và lập luận hổng. Dưới đây là lập luận vững cho từng ticket; bạn chọn khác mà nêu được đánh đổi tương đương thì vẫn đạt.
Ticket A → RAG (semantic là đủ), kèm trích nguồn
Ước lượng: 500 văn bản × 3–8 trang, nhân hệ số token tiếng Việt, rơi vào khoảng ~1–4 triệu token tuỳ độ dài thực tế. Cả đầu thấp lẫn đầu cao của khoảng này đều đã vượt xa cửa sổ ~200 nghìn token phổ biến, và xấp xỉ hoặc vượt cả cửa sổ 1–2 triệu của những model lớn nhất 2026, nên bắt buộc phải retrieve chứ không nhét thẳng được. Kể cả có model vừa đủ, nhét vài triệu token mỗi request cũng không chịu nổi về chi phí lẫn latency. (Cửa sổ context thay đổi theo từng model, kiểm lại theo model thật.)
Vì sao RAG: kho vượt context (bắt buộc retrieve), dữ liệu đổi vài lần/năm (RAG cập nhật bằng re-index, không train lại), và cần trích nguồn (RAG trả kèm đoạn gốc để người dùng tự kiểm điều khoản). Truy vấn là ngôn ngữ tự nhiên nên semantic search là hợp, chưa cần hybrid.
Vì sao KHÔNG fine-tune: đây là chỗ hay chọn sai nhất. Fine-tune không nạp được dữ kiện đáng tin: model đã fine-tune trên policy vẫn bịa số ngày, tên điều khoản, vì kiến thức tuân thủ cần có căn cứ ngay lúc suy luận — tức đưa đúng đoạn vào context, không phải nhồi vào trọng số. Ovadia et al. (EMNLP 2024) đo được fine-tune không giám sát thua RAG ở cả kiến thức cũ lẫn kiến thức mới.
Rủi ro:
- Retrieve sai điều khoản thì bot trả lời sai mà vẫn tự tin (rác vào, rác ra). Với dữ liệu tuân thủ, một câu sai điều khoản là sự cố thật.
- Thiếu negative rejection: không có policy nào khớp mà model bịa thay vì nói "không tìm thấy".
- Prompt injection (OWASP
LLM01:2025, đứng số 1): nếu một văn bản policy chứa câu chèn lệnh, nội dung đó đi thẳng vào context. RAG làm tăng bề mặt tấn công vì kéo tài liệu không kiểm soát vào prompt.
Ticket B → RAG hybrid (keyword + vector)
Vì sao hybrid, không vector thuần: truy vấn xoay quanh định danh chính xác (ERR-PAYMENT-4023, /api/v2/transfers, số version), và đây là trọng tâm của cả bài. Semantic search mù đúng ở loại này: nó tìm "gần nghĩa", mà một mã lỗi thì không có "gần nghĩa", chỉ có trùng hoặc không. Vector thuần sẽ trả về runbook nghe giống thay vì runbook đúng mã.
Với mã lỗi, số hoá đơn, tên endpoint, version, keyword/BM25 thắng vì đây là bài toán khớp chuỗi chính xác chứ không phải gần nghĩa: một mã lỗi không có "gần đúng", chỉ trùng hoặc không. Bài semantic-vs-keyword đi sâu vào ranh giới này; hybrid chạy song song hai đường rồi gộp điểm để lấy thế mạnh của cả hai.
Ước lượng và cập nhật: vài nghìn trang × hệ số token tiếng Việt rơi vào bậc vài triệu token, vượt context, bắt buộc retrieve. Wiki đổi liên tục nên RAG re-index là hợp, còn fine-tune thì vô lý (train lại mỗi lần đổi là bất khả thi).
Rủi ro:
- Chọn vector thuần là trượt thẳng ở truy vấn quan trọng nhất (đúng mã lỗi). Rủi ro số một chính là chọn sai cách retrieve.
- Thiếu noise robustness: retrieve nhầm một runbook gần nghĩa nhưng khác mã sẽ dẫn kỹ sư vận hành xử lý sai hướng giữa lúc đang có sự cố.
- Trọng số gộp điểm keyword và vector không có công thức phổ quát, phải đo trên truy vấn thật của đội (đúng tinh thần "đo trên dữ liệu của mình" ở bài embedding).
Ticket C → Prompt-only (nhét thẳng vào context), KHÔNG RAG
Ước lượng: 150 spec × nửa trang, nhân hệ số token tiếng Việt, lại đặc token hơn văn xuôi vì đầy bảng, mã ID, số liệu (bài tokenization đã đo: code và số bị cắt vụn nên mật độ token gần gấp đôi). Cộng lại rơi vào bậc ~60–100 nghìn token, tức là vừa cửa sổ 200 nghìn token trở lên của model chat phổ biến 2026 (kiểm lại theo model thật). Kho lại tĩnh suốt đợt UAT.
Vì sao KHÔNG RAG: đây là chỗ sai theo chiều ngược lại, kiểu "có tài liệu thì phải RAG". Khi cả kho vừa context và không đổi, nhét thẳng mọi spec vào prompt đơn giản hơn và đáng tin hơn: không vector store, không bước retrieve, nên không có chỗ hỏng retrieval. Thêm RAG ở đây là thêm hạ tầng và thêm một nguồn lỗi mà chẳng được gì.
Rủi ro và đánh đổi:
- Lost in the Middle: khi context gần đầy, model dễ bỏ qua thông tin nằm giữa prompt; hiệu năng cao nhất khi thông tin liên quan nằm ở đầu hoặc cuối (Liu et al., TACL 2024). Nếu kho gần chạm trần context, lọc bớt spec không liên quan trước khi nhét.
- Chi phí token mỗi request: nhét cả kho mỗi lần hỏi là tốn. Đây là một trục ngoài ba câu hỏi lọc. Nếu lưu lượng truy vấn rất cao suốt đợt, chi phí token lặp lại mới là lúc RAG bắt đầu đáng tiền (giảm token/request). Nói cách khác, ba trục có chỉ về prompt-only thì trục chi phí thứ tư vẫn có thể lật ngược kết luận ở quy mô lớn.
Câu hỏi chẩn đoán: hai lỗi, hai bước khác nhau
Lỗi 1 (Ticket A) → hỏng ở retrieval. Log cho thấy top-k chỉ có đoạn của policy 2022, bản 2024 không hề được retrieve. Nội dung sai không phải model bịa: nó nằm sẵn trong đoạn được đưa vào context, và model chỉ sinh từ đúng thứ nó nhận. Bước tìm kiếm trả về đúng chủ đề (nghỉ thai sản) nhưng sai ràng buộc chính xác (năm 2024), một biến thể của vấn đề ở Ticket B: "policy 2024" là một định danh chính xác mà semantic search bỏ qua. Sửa ở retrieval: lọc metadata theo năm hiệu lực, hoặc hybrid khớp chuỗi version, chứ không phải chỉnh prompt hay đổi model sinh. Nếu log cho thấy cả bản 2022 lẫn 2024 cùng vào context mà bot vẫn trích 2022, thì lỗi chuyển sang generation, đúng dạng counterfactual robustness như Ticket 4 ở bài 06.
Lỗi 2 → hỏng ở generation, do thiếu negative rejection. Retrieve vẫn làm đúng cơ chế của nó: như bài 05 đã nói, retrieve luôn trả về k đoạn, nên context vẫn có k đoạn điểm thấp, lạc đề (về nghỉ phép năm, nghỉ ốm…), vì kho không có đoạn nào về chính sách chưa ban hành. Lỗi nằm ở generation: model không nhận ra những đoạn đó không trả lời câu hỏi, và đáng lẽ phải từ chối ("không có policy về việc này") thì lại bịa. Đó là thiếu negative rejection, một trong bốn năng lực RGB đo, nằm ở phía sinh. Sửa ở tầng sinh: prompt buộc model trả "không tìm thấy" khi các đoạn retrieve không nói tới đúng điều được hỏi, cộng ngưỡng điểm similarity để loại đoạn quá xa. Retrieve nhiều hơn không giúp gì.
Đặt hai lỗi cạnh nhau cho ra nguyên tắc chẩn đoán: cô lập bước hỏng trước. Hỏi "đoạn đúng có nằm trong những gì model nhận không?". Không có, trong khi kho có, thì là retrieval. Có rồi mà model vẫn xử lý sai, hoặc kho không có mà model không chịu từ chối, thì là generation. Lỗi 1 sai vì đoạn đúng không được đưa vào; Lỗi 2 sai vì model xử lý sai một context vốn không liên quan. Chỉ khi đã chốt "generation" mới bàn tới bốn failure mode, vì cả bốn đều mô tả cách model xử lý context, tức đều ở phía sinh. Lỗi thuần retrieval như Lỗi 1 nằm ở thượng nguồn, ngoài bốn cái tên đó.
Cả bài trong một hình
Ba câu hỏi lọc, áp theo thứ tự từ trên xuống, dừng ở câu đầu tiên cho ra kiến trúc (lần lượt là lời giải Ticket C, B, A):
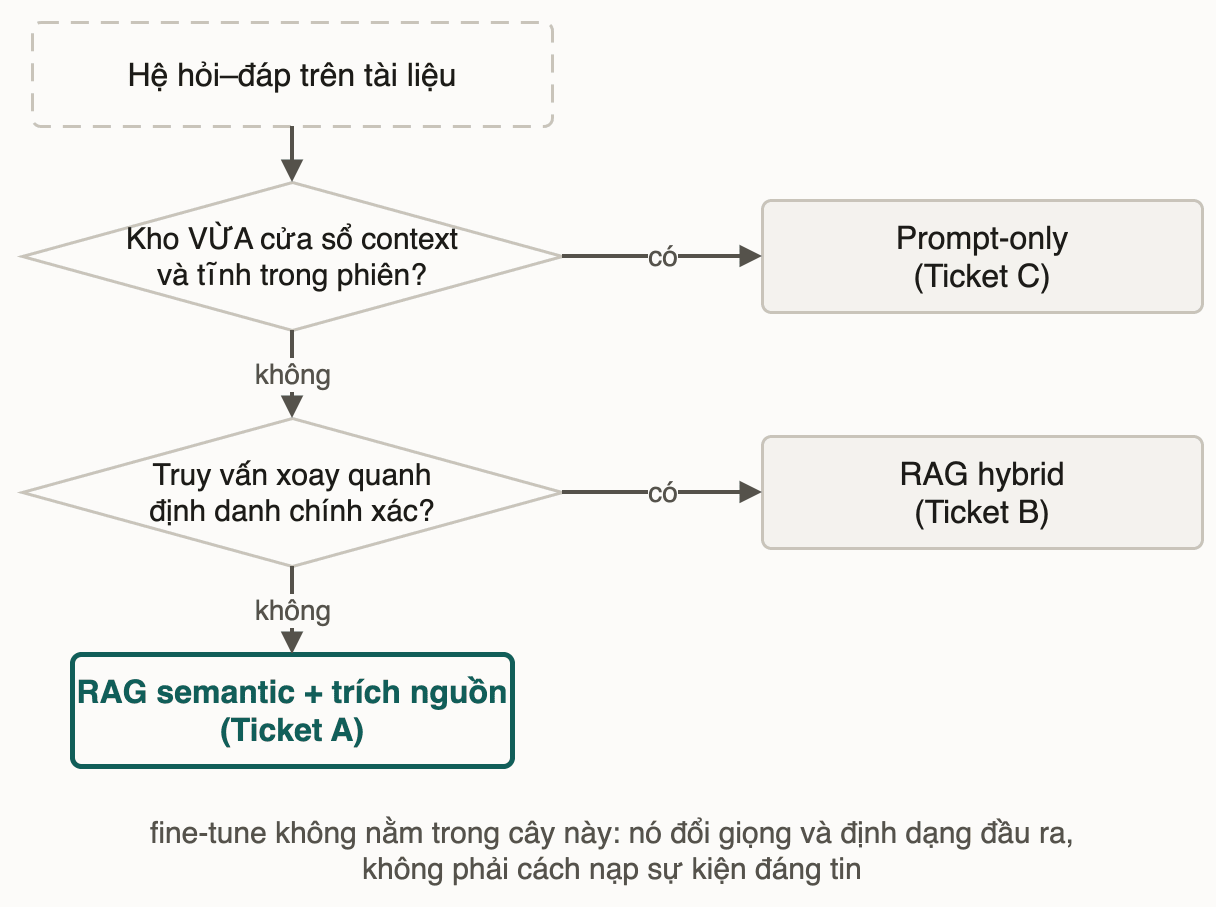
Fine-tune không nằm trong cây này: nó đổi giọng/định dạng đầu ra, không phải cách nạp kiến thức, nên gần như không bao giờ là đáp án cho câu hỏi "trả lời đúng theo tài liệu".
Thử ngẫmsếp thêm một use case thứ tư, chatbot trả lời câu hỏi từ 5 file quy trình không đổi trong cả năm. Áp ba trục trong bài, kiến trúc nào rẻ nhất mà vẫn đủ?
🎓 Mở rộng
Bốn failure mode là công cụ chẩn đoán, chưa phải bằng chứng đo trên tiếng Việt. Taxonomy noise robustness · negative rejection · information integration · counterfactual robustness đến từ benchmark RGB (Chen et al., AAAI 2024), nhưng RGB đánh giá 6 model trên corpus tiếng Anh và tiếng Trung, không có tiếng Việt. Cách chia thì dùng được; con số cụ thể thì bạn phải tự đo trên dữ liệu Việt của mình.
"RAG giảm hallucination" nghĩa là giảm, không phải triệt tiêu. RAG ra đời để LLM truy cập tri thức ngoài tham số theo cách kiểm chứng được, kèm nguồn gốc cho câu trả lời (Lewis et al., NeurIPS 2020); giảm bịa đặt chỉ là lợi ích các nghiên cứu sau ghi nhận thêm — nhà cung cấp chưa từng hứa con số nào. Phần bịa còn lại vẫn có tên: retrieve nhiễu, không biết từ chối, thông tin nằm giữa context. Đừng hứa với sếp một con số phần trăm, hãy hứa một quy trình chẩn đoán khi nó vẫn sai.
Ba ticket, ba kiến trúc khác nhau, cùng một mô tả ban đầu. Đó là bài học lớn nhất: câu "làm chatbot hỏi đáp trên tài liệu" chưa đủ để chọn kiến trúc. Ba trục (kích thước so với context, loại truy vấn, tần suất cập nhật) mới quyết định.
✨ Điều bạn vừa làm được
- Phân biệt ba bài toán nghe giống hệt nhau và ánh xạ mỗi cái sang một kiến trúc khác nhau, có lập luận.
- Nhận ra khi nào KHÔNG dùng RAG, thứ mà biết dựng RAG thôi thì chưa đủ để thấy.
- Bác bỏ fine-tune như cách nạp kiến thức, bằng lý do có nguồn chứ không phải cảm tính.
- Gắn mỗi lựa chọn với nhóm rủi ro có tên riêng, và cô lập được bước hỏng (retrieval hay generation) khi một hệ RAG lên production vẫn trả lời sai.
Bài tiếp theo: Tổng kết module: cheat sheet và tự đánh giá
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bốn kiểu hỏng của RAG: lỗi ở retrieval hay generation?
Bài tiếpTổng kết: Embedding, tìm kiếm & RAG
Thảo luận & góp ý
Hỏi đáp về bài này