Embedding — không gian của nghĩa
Văn bản thành dãy số sao cho gần nghĩa thì gần nhau. Không phải mã hoá, không decode ngược được — và không có model 'tốt nhất' cho mọi task.
TL;DR: Embedding biến một đoạn văn bản thành vector, tức một dãy số thực có độ dài cố định, trong "không gian nghĩa": hai đoạn gần nghĩa nằm gần nhau dù không chung chữ nào. Đây là ánh xạ một chiều, không có hàm decode nào dựng lại văn bản gốc. Không gian đó được học từ mục tiêu huấn luyện, nên "gần" là gần theo định nghĩa của dữ liệu đã dạy model, không theo nhu cầu của bạn. Hệ quả: không có model tốt nhất cho mọi task, và vector dài hơn không đồng nghĩa kết quả tốt hơn.
Vẫn nhóm làm chatbot tra cứu policy nội bộ ở module Cỗ máy LLM. Giờ họ vấp bài toán tìm tài liệu: nhân viên gõ "cách xin nghỉ phép năm", văn bản công ty lại viết "thủ tục đăng ký ngày nghỉ hằng năm". Không trùng từ khoá nào, ô tìm kiếm trả về rỗng. Ai đó đề xuất dùng embedding, và câu hỏi đầu tiên trong phòng họp là: "model nào tốt nhất?"
Cả nhóm chọn theo bản năng: model nhiều chiều nhất, 3072 thay vì 1536. Hai tuần sau, dung lượng vector store và thời gian truy vấn tăng đúng tỉ lệ số chiều, còn chất lượng nhích không đáng kể. Trong khi đó tài liệu của chính hãng ghi rõ model ấy cắt xuống 256 chiều vẫn vượt model đời trước ở 1536 chiều.
Bạn đã thấy văn bản bị cắt thành token rồi thành dãy số ID, thứ duy nhất model nhận. Embedding là bước ngay sau: từ dãy ID của cả đoạn, model nén ra một vector đại diện cho nghĩa.
1. Analogy: địa chỉ nhà và toạ độ GPS
Cùng một quán cà phê, hai người mô tả hai kiểu: "số 5 ngõ 12 Trần Duy Hưng" và "quán sau lưng siêu thị trên Trần Duy Hưng". So khớp chuỗi thì hai câu gần như chẳng dính gì nhau. Đổi sang toạ độ GPS, chúng rơi vào hai điểm cách nhau vài chục mét, và bạn hỏi được câu mà chuỗi địa chỉ không trả lời nổi: "còn quán nào gần đây không?"
| Bản đồ | Embedding |
|---|---|
| Địa chỉ viết bằng chữ, mỗi người một kiểu | Câu chữ, mỗi người diễn đạt một kiểu |
| Toạ độ (vĩ độ, kinh độ) | Vector vài trăm tới vài nghìn số |
| Hai mô tả cùng một chỗ ra toạ độ sát nhau | Hai câu cùng nghĩa ra vector sát nhau |
| Hỏi được "quán nào gần đây" | Hỏi được "đoạn nào gần câu hỏi này" |
Analogy hỏng ở hai chỗ: bản đồ có 2 chiều còn không gian nghĩa có hàng trăm tới hàng nghìn chiều; và toạ độ GPS tra ngược ra địa chỉ được, còn vector thì không có hàm decode nào dựng lại văn bản gốc.
Embedding là toạ độ của nghĩa: viết khác nhau vẫn đứng cạnh nhau trên bản đồ.
2. Embedding trả về cái gì?
Embedding (vector nhúng) là hàm nhận văn bản, trả về vector: dãy số thực độ dài cố định, ví dụ 1536 số. Embedding model là model huấn luyện riêng cho việc đó. Khác model sinh văn bản ở module trước, nó không sinh ra chữ nào.
embed("Cách xin nghỉ phép năm")            -> [ 0.021, -0.144, ...,  0.087]
embed("Thủ tục đăng ký ngày nghỉ hằng năm") -> [ 0.019, -0.151, ...,  0.081]   -- gần vector trên
embed("Cách cài Docker trên máy Mac")       -> [-0.233,  0.402, ..., -0.010]   -- xa cả hai

-- Độ dài vector CỐ ĐỊNH với mọi input:
--   một câu 6 chữ -> 1536 số
--   một trang A4  -> 1536 số   <-- vẫn đúng ngần ấy số
Ba tính chất phải nhớ, vì mọi bài sau đều dựa vào chúng:
- Độ dài cố định. Một câu hay cả trang đều ra ngần ấy số. Đó là điều kiện để so mọi thứ với mọi thứ, nhưng cũng là lý do nhồi cả trang vào một vector làm nghĩa bị "trung bình hoá" (bài Chunking).
- Một chiều và lossy. Nén một trang thành 1536 số thì thông tin phải mất, và model không kèm hàm decode. Embedding không phải mã hoá.
- Chỉ có nghĩa trong cùng một không gian. Vector của model A không so được với vector của model B, kể cả khi cùng 1536 chiều. Vì vậy đổi embedding model là phải index lại toàn bộ, một việc tốn kém chứ không phải một dòng đổi config.
Từng con số trong vector không đọc được: không chiều nào là "độ trang trọng" hay "chủ đề nhân sự". Thứ mang ý nghĩa là vị trí tương đối giữa các vector, còn đo bằng gì thì để bài 02.
3. Không gian nghĩa từ đâu ra, và "gần" là gần theo ai?
Không ai gán toạ độ bằng tay. Không gian đó được học theo một nguyên tắc cũ: đơn vị ngôn ngữ xuất hiện trong ngữ cảnh giống nhau thì nghĩa giống nhau. Word2vec (Mikolov et al., 2013) làm điều đó ở mức từ; model embedding câu áp cùng ý tưởng ở mức đoạn, với mục tiêu kéo gần cặp liên quan, đẩy xa cặp không liên quan:
for each (query, positive, negative) trong dữ liệu huấn luyện:
    kéo gần  embed(query) và embed(positive)   -- positive: đoạn ĐÚNG cho query
    đẩy xa   embed(query) và embed(negative)   -- negative: đoạn không liên quan
-- Lặp lại trên quy mô rất lớn
-- => hình dạng không gian là KẾT QUẢ của việc "cặp nào được coi là đúng"
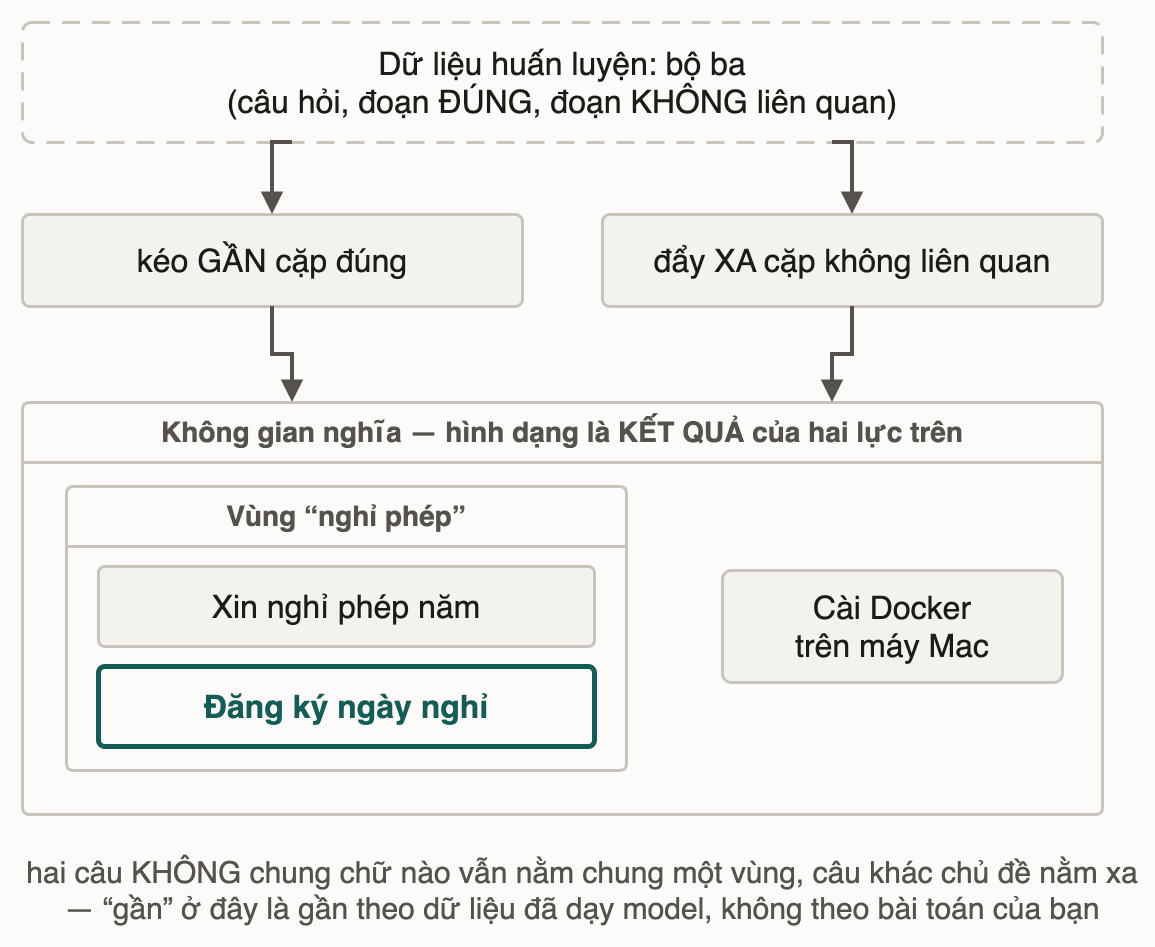
Đây là mấu chốt của cả bài. Câu "embedding hiểu nghĩa" viết cho chính xác phải là: model học được một khái niệm "liên quan" cụ thể, do dữ liệu huấn luyện định nghĩa. Dạy chủ yếu bằng cặp hỏi–đáp tiếng Anh trên web thì "gần" của nó là gần theo kiểu đó. Kéo theo hai điều. Hai câu không chung chữ nào vẫn có thể rất gần ("xin nghỉ phép năm" và "đăng ký ngày nghỉ"), chỗ mà tìm kiếm từ khoá bó tay. Nhưng hai đoạn xếp gần nhau cũng không đảm bảo trả lời được câu hỏi của bạn, và đó là gốc của mọi ca hỏng ở bài 03 và bài 06.
Vậy sao không bỏ vector đi, đưa thẳng từng cặp (câu hỏi, đoạn tài liệu) cho model chấm? Vì chi phí: tìm cặp câu giống nhau nhất trong 10.000 câu mất chừng 65 giờ nếu mỗi cặp chạy qua BERT, còn nén sẵn thành vector rồi so thì chỉ khoảng 5 giây (Reimers & Gurevych, EMNLP 2019). Embedding tách phần đắt (hiểu nghĩa, chạy một lần lúc index) khỏi phần lặp lại mỗi truy vấn. Cũng vì thế câu hỏi phải đi qua đúng model đã dùng lúc index.
4. Hai câu hỏi đặt sai: "bao nhiêu chiều" và "model nào tốt nhất"
4.1 Số chiều quyết định chi phí, gần như không quyết định chất lượng
text-embedding-3-large mặc định 3072 chiều. Theo bạn, cắt nó xuống còn bao nhiêu chiều thì nó vẫn vượt được model đời trước text-embedding-ada-002 ở đủ 1536 chiều? Viết ra con số trước khi đọc tiếp.
Số công bố trong tài liệu OpenAI (đọc 2026-07-23), cột điểm là trung bình MTEB:
| Model | Số chiều mặc định | Điểm MTEB |
|---|---|---|
text-embedding-ada-002 | 1536 | 61.0% |
text-embedding-3-small | 1536 | 62.3% |
text-embedding-3-large | 3072 | 64.6% |
Tài liệu công bố con số 256 chiều: 3-large rút xuống 256 vẫn vượt ada-002 nguyên 1536 chiều, tức ít hơn 6 lần số chiều mà điểm vẫn cao hơn. Đọc bảng theo thứ tự:
3-smallvàada-002cùng 1536 chiều mà chênh 1.3 điểm: cùng kích thước, khác chất lượng.- Ca cắt còn 256 chiều là bằng chứng khó cãi nhất, vì nó so một model với chính nó: bỏ 11/12 số trong vector mà vẫn thắng model đời cũ.
Thứ số chiều quyết định chắc chắn là chi phí: dung lượng lưu trữ và khối lượng tính mỗi truy vấn đều tỉ lệ thuận với số chiều, đúng hoá đơn nhóm ở đầu bài đã trả. OpenAI còn cho tham số dimensions để cắt bớt chiều mà không cần huấn luyện lại. Nói cách khác, chính nhà cung cấp coi số chiều là chỗ vặn chi phí.
4.2 Không có model tốt nhất cho mọi task
Câu "model nào tốt nhất" đã có nghiên cứu trả lời. MTEB (Massive Text Embedding Benchmark) đo các model trên 8 loại task, 58 dataset, 112 ngôn ngữ, và kết luận nguyên văn: "We find that no particular text embedding method dominates across all tasks." (Muennighoff et al., 2022). Không có model nào thắng mọi task, và mục 3 đã cho lý do: model dạy bằng cặp câu đối xứng ("hai câu này cùng nghĩa không?") mạnh ở đo tương đồng câu, còn model dạy bằng cặp lệch (câu hỏi ngắn với đoạn văn dài) mạnh ở truy hồi. Hai mục tiêu huấn luyện sinh ra hai không gian khác nhau, nên thứ hạng đảo giữa các task là chuyện bình thường.
- Task thật là gì? Truy hồi đoạn tài liệu cho câu hỏi, hay so hai câu xem có cùng nghĩa? Hai việc này cần hai kiểu model khác hẳn.
- Đo trên dữ liệu nào? Lấy 30–50 câu hỏi thật, gắn nhãn đoạn đúng, rồi tính tỉ lệ lọt top-k cho từng model ứng viên.
- Bao nhiêu chiều là đủ? Chọn mức thấp nhất còn đạt ngưỡng đó, vì lưu trữ và truy vấn đều tăng theo số chiều.
5. Pitfall tổng hợp
❌ Nhầm 1: coi embedding là mã hoá, và coi vector là dữ liệu vô hại.
✅ Hai vế sai theo hai hướng ngược nhau. Không có hàm decode chính chủ, nên đừng lưu vector rồi tưởng vẫn giữ được nguyên văn. Nhưng cũng đừng coi vector là ẩn danh: OWASP xếp riêng LLM08:2025 Vector and Embedding Weaknesses vì embedding có thể bị đảo ngược để khôi phục một lượng đáng kể thông tin gốc.
❌ Nhầm 2: trộn vector cũ và mới sau khi đổi model.
✅ Một index chứa vector của hai model là index hỏng. Truy vấn vẫn chạy, vẫn trả kết quả, chỉ là vô nghĩa với phần dữ liệu nằm sai không gian. Đổi model thì index lại toàn bộ rồi mới chuyển sang dùng.
6. 📚 Deep Dive
- Muennighoff et al. — MTEB: Massive Text Embedding Benchmark (2022): nguồn câu "không model nào thống trị mọi task"; đọc thiết kế benchmark để thấy 8 loại task khác nhau ra sao.
- Reimers & Gurevych — Sentence-BERT (EMNLP 2019): nguồn con số 65 giờ so với 5 giây.
- Mikolov et al. — Efficient Estimation of Word Representations (2013): word2vec, gốc của "nghĩa học từ ngữ cảnh".
- OpenAI — Embeddings guide: nguồn số MTEB, tham số
dimensions, ca cắt 256 chiều. - OWASP — LLM08:2025 Vector and Embedding Weaknesses: rủi ro vector store.
Ghi chú: mọi số đối chiếu nguồn gốc ngày 2026-07-23; benchmark đổi theo thời gian, hãy kiểm lại khi ra quyết định thật.
7. Liên hệ các bài khác
- Bài 02 — Cosine similarity: bài này nói vector ở gần nhau; bài sau định nghĩa "gần" bằng phép đo cụ thể, và vì sao điểm số dễ bị đọc sai.
- Bài 03 — Semantic vs keyword search: hệ quả của "gần theo thước của model", khi có loại truy vấn mà thước đó thua hẳn từ khoá.
- Bài 04 — Chunking: sinh ra từ tính chất độ dài vector cố định; cắt tài liệu thành đoạn bao lớn thì một vector còn giữ được nghĩa.
- Tokenization: bước ngay trước embedding; giới hạn đầu vào của embedding model cũng đo bằng token.
8. Tóm tắt
- Ánh xạ một chiều và lossy: không có hàm decode, nhưng vector vẫn bị đảo ngược một phần được (
LLM08:2025), nên đừng coi nó là ẩn danh. - Nén sẵn thành vector là thứ biến 65 giờ so từng cặp thành khoảng 5 giây; cái giá là câu hỏi phải đi qua đúng model đã index.
3-largeở 256 chiều vẫn vượtada-002ở 1536 chiều: tăng số chiều là tăng hoá đơn lưu trữ và truy vấn trước khi tăng chất lượng.- Chọn model bằng tỉ lệ lọt top-k trên 30–50 câu hỏi thật của bạn, không bằng hạng trung bình trên bảng xếp hạng; đổi model là index lại toàn bộ.
9. Tự kiểm tra
- Q1Hai câu 'cách xin nghỉ phép năm' và 'thủ tục đăng ký ngày nghỉ' không chung từ khoá nào mà vector rất gần nhau. Cơ chế nào tạo ra kết quả đó?
- Q2Vì sao nói số chiều quyết định chi phí chứ gần như không quyết định chất lượng? Dùng số liệu trong bài để chứng minh.
- Q3Sếp đọc một bảng xếp hạng embedding và yêu cầu đổi sang model đứng số một. Nêu hai câu hỏi phải trả lời trước, và vì sao đổi không phải một dòng config.
- Q4Một đồng nghiệp embed nguyên cả trang tài liệu thành một vector rồi thấy tìm kiếm ra kết quả lệch. Từ tính chất của phép ánh xạ, giải thích vì sao.
- Q5Hệ thống trả về đoạn điểm cao nhất nhưng đoạn đó không trả lời được câu hỏi. Vì sao đây là hành vi đúng chứ không phải bug?
Bài tiếp theo: Cosine similarity: đo "gần nghĩa" bằng gì
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này