Cosine similarity — đo gần nghĩa bằng góc
Phép so khớp mặc định của tìm kiếm ngữ nghĩa: đo góc giữa hai vector, bỏ qua độ dài. Và vì sao điểm similarity cao chưa chắc là thứ người dùng cần.
TL;DR: Cosine similarity đo góc giữa hai vector và bỏ qua độ dài (magnitude) của chúng: hai vector cùng hướng cho điểm gần 1 dù một vector "dài" gấp mấy lần vector kia. Đây là phép so khớp mặc định của tìm kiếm ngữ nghĩa. Nhưng điểm cao chỉ nói một điều: hai vector gần nhau theo hướng mà model đã học ở bài trước. Nó không nói "đoạn này trả lời đúng câu hỏi của bạn", và nhầm hai chuyện đó là nguồn của rất nhiều ca RAG trả lời sai mà không ai hiểu tại sao.
Nhóm ở bài trước đã thấy embedding tìm ra đúng đoạn dù câu hỏi và tài liệu không chung từ khoá nào. Vector store trả kết quả kèm một con số cho mỗi đoạn: 0.91, 0.84, 0.79... Ai đó chốt luôn: "cứ lấy đoạn điểm cao nhất, chắc chắn đúng nhất." Hai tuần sau, đoạn 0.91 đứng đầu danh sách mà không trả lời được câu nhân viên hỏi, còn đoạn đứng thứ ba, điểm 0.79, lại đúng thứ cần. Con số đó đo cái gì mà đứng đầu bảng vẫn có thể sai?
Attention đo độ khớp giữa query và key bằng dot product: hai vector càng cùng hướng, con số càng lớn. Bài này dùng lại đúng phép nhân đó, chỉ chia thêm cho độ lớn của hai vector để kết quả chỉ còn phản ánh hướng.
1. Analogy: kim đồng hồ dài ngắn
Một chiếc đồng hồ có kim ngắn ba đốt tay, chiếc khác có kim dài gấp đôi, cả hai cùng chỉ đúng ba giờ. Hỏi "hai kim đang trỏ về hướng nào" thì câu trả lời giống hệt nhau, dù độ dài kim khác hẳn. Chẳng ai đo "kim nào dài hơn" để trả lời câu đó, người ta chỉ nhìn hướng trỏ.
Cosine similarity hỏi đúng câu đó về vector: kệ vector nào "dài" hơn, chỉ so hai vector đang trỏ về đâu trong không gian nghĩa.
| Kim đồng hồ | Cosine similarity |
|---|---|
| Kim ngắn và kim dài cùng chỉ 3 giờ | Hai vector độ lớn khác nhau nhưng cùng hướng |
| Câu hỏi là "trỏ về hướng nào", không phải "kim dài bao nhiêu" | Câu hỏi là "góc giữa hai vector", không phải "vector dài bao nhiêu" |
| Kim dài gấp đôi không đổi hướng đang trỏ | Nhân đôi mọi toạ độ không đổi hướng, cosine vẫn bằng 1 |
Analogy hỏng ở một chỗ: kim đồng hồ chỉ quay trên mặt phẳng 2 chiều, còn vector nghĩa có hàng trăm tới hàng nghìn chiều. "Góc" ở đây là một phép tính, không phải thứ mắt nhìn ra được.
Cosine similarity là "đo hướng, kệ độ dài": kim ngắn hay kim dài không quan trọng, quan trọng là đang chỉ về đâu.
2. Cosine similarity đo cái gì?
Với hai vector A và B cùng số chiều, cosine similarity được định nghĩa:
cosine(A, B) = (A · B) / (|A| × |B|)

A · B  -- dot product: nhân từng cặp toạ độ rồi cộng lại
         (a1×b1) + (a2×b2) + ... + (an×bn)

|A|    -- độ lớn (norm) của vector A: căn bậc hai tổng bình phương từng toạ độ
         căn( a1² + a2² + ... + an² )
Bài trước dùng "độ dài cố định" để nói số chiều: một câu hay cả trang đều ra ngần ấy con số. Ở đây "độ dài" (|A|) là độ lớn hình học của vector, tính từ chính các con số bên trong, nên hai vector cùng 1536 chiều vẫn có thể có |A| khác hẳn |B|. Cosine chia cho đúng đại lượng này để loại nó khỏi kết quả.
Chia cho |A| × |B| là bước then chốt: công thức này tương đương với việc chuẩn hoá A và B về độ dài 1 trước khi nhân, nên kết quả cuối chỉ còn phản ánh hướng, dù bản thân A và B không đổi. Kết quả nằm trong khoảng từ -1 đến 1. Càng gần 1 càng cùng hướng, càng gần 0 càng vuông góc (không liên quan theo cách model học), càng gần -1 càng ngược hướng.
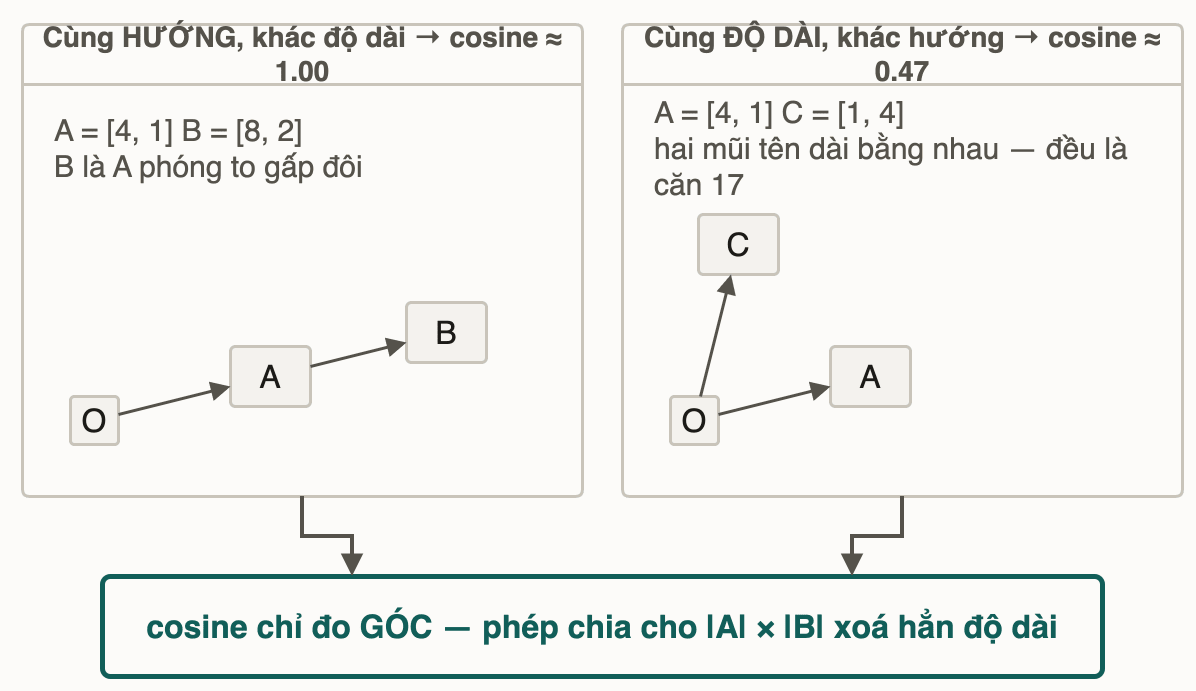
3. Tính tay: cùng hướng khác độ dài, cùng độ dài khác hướng
Ba vector đồ chơi, 2 chiều để tính tay được (vector nghĩa thật có hàng trăm tới hàng nghìn chiều, không ai tính tay): A = [4, 1], B = [8, 2] (mỗi toạ độ của B đúng gấp đôi A) và C = [1, 4]. Đoán trước hai điều: cosine(A, B) bằng bao nhiêu, ước lượng một con số cụ thể? Và giữa hai cặp (A, B) với (A, C), cặp nào điểm cao hơn? Viết ra trước khi đọc tiếp.
Coi hai chiều này là hai trục ý nghĩa đồ chơi, nối lại ví dụ bài trước: trục thứ nhất là "độ liên quan tới nghỉ phép", trục thứ hai là "độ liên quan tới kỹ thuật". A đại diện "cách xin nghỉ phép năm". B đại diện một câu cùng chủ đề nhưng viết dài hơn, "thủ tục đăng ký ngày nghỉ hằng năm, giải thích chi tiết từng bước", nên giá trị lớn hơn ở cả hai trục. C đại diện "cách cài Docker trên máy Mac", nghiêng hẳn sang trục kỹ thuật.
A = [4, 1]
B = [8, 2]   -- mỗi toạ độ gấp đôi A
C = [1, 4]   -- nghiêng hẳn sang trục còn lại

cosine(A, B):
  A · B = (4 × 8) + (1 × 2) = 32 + 2 = 34
  |A|   = căn(4² + 1²) = căn(17)  ≈ 4.123
  |B|   = căn(8² + 2²) = căn(68)  ≈ 8.246
  cosine(A, B) = 34 / (4.123 × 8.246) = 34 / 34.00  ≈ 1.00

cosine(A, C):
  A · C = (4 × 1) + (1 × 4) = 4 + 4 = 8
  |C|   = căn(1² + 4²) = căn(17)  ≈ 4.123   -- CÙNG độ lớn với A
  cosine(A, C) = 8 / (4.123 × 4.123) = 8 / 17  ≈ 0.47
Kết quả khớp trực giác ở mục 1. A và B nằm trên cùng một đường thẳng qua gốc toạ độ, B chỉ là A phóng to gấp đôi, nên góc giữa chúng bằng 0 và cosine bằng đúng 1 bất kể B "dài" gấp đôi. A và C thì ngược lại: cùng độ lớn hệt nhau (đều bằng căn 17) mà lệch hướng, nên cosine tụt xuống 0.47. Cùng độ lớn không cứu được điểm số khi hướng lệch nhau, vì cosine chỉ quan tâm tới góc.
4. Vì sao bỏ qua độ dài?
Độ lớn của một vector nghĩa thường phản ánh những thứ chẳng dính tới nghĩa: đoạn văn dài hơn, lặp từ nhiều hơn, hay đơn giản là cách một model cụ thể biểu diễn cường độ. Nó không có nghĩa "đúng nghĩa hơn" hay "quan trọng hơn". Ở ví dụ trên, B dài gấp đôi A vì câu viết dài hơn, chứ không vì nó sát chủ đề hơn.
Dùng một phép đo nhạy với độ lớn, ví dụ lấy dot product thô mà không chia cho |A| × |B|, thì một đoạn tài liệu dài, lặp ý nhiều lần dễ thắng một đoạn ngắn, súc tích, dù đoạn ngắn mới là câu trả lời đúng. Phép chia ở mục 2 khử đúng sai lệch đó: mọi vector được đưa về cùng độ lớn 1 trước khi so, nên kết quả chỉ còn phản ánh hướng.
Thực tế có một chi tiết làm chuyện này nhẹ đi: nhiều embedding API, ví dụ OpenAI, trả về vector đã chuẩn hoá sẵn về độ dài 1. Với các vector đó, |A| × |B| luôn bằng 1, cosine và dot product cho ra cùng con số và cùng thứ hạng. Vì vậy nhiều vector store tính thẳng dot product cho nhanh. Phép chia chỉ còn quan trọng khi model không chuẩn hoá sẵn, hoặc khi index trộn vector từ nhiều nguồn khác nhau. Trước khi chọn metric trong vector store, kiểm tài liệu model xem output đã chuẩn hoá chưa.
Thử ngẫmnếu bỏ phép chia cho |A|×|B| và dùng thẳng dot product để xếp hạng vector CHƯA chuẩn hoá, đoạn văn nào có xu hướng thắng: đoạn ngắn súc tích hay đoạn dài lặp ý?
5. Vì sao điểm cao không đồng nghĩa đúng ý người dùng?
Quay lại câu hỏi mở đầu: vì sao đoạn 0.91 đứng đầu mà không trả lời được, còn đoạn 0.79 đứng thứ ba lại đúng? Cosine đo hướng của một vector đại diện cho cả đoạn văn, và hướng đó phản ánh chủ đề, ngữ cảnh tổng thể. Nó không phản ánh chuyện "đoạn này có chứa câu trả lời cụ thể hay không". Một đoạn giới thiệu chung như "Chính sách nghỉ phép của công ty áp dụng cho mọi loại hình nhân viên" rất sát chủ đề nên cosine cao, nhưng chẳng có bước nào để làm theo. Một đoạn liệt kê thao tác như "Bước 1: đăng nhập hệ thống nhân sự, bước 2: chọn mục nghỉ phép năm..." dùng từ ngữ ít giống câu hỏi hơn nên cosine thấp hơn, trong khi nó chứa đúng thứ người hỏi cần.
Đó là hệ quả trực tiếp của mục 3 bài trước: không gian nghĩa được học theo mục tiêu "cặp nào được coi là liên quan" trong dữ liệu huấn luyện, không theo định nghĩa "trả lời được câu hỏi" của bạn. Cosine đo chính xác trên không gian đó, và chỉ thế thôi. Chấm câu trả lời đúng hay sai nằm ngoài những gì nó đo được.
Thử ngẫmmột tính năng tự động hiển thị đoạn có điểm cosine cao nhất, không qua người duyệt. Rủi ro lớn nhất rơi vào loại câu hỏi nào?
6. Pitfall tổng hợp
❌ Nhầm 1: đọc điểm cosine như một tỉ lệ phần trăm đúng.
✅ 0.91 không đo "phần trăm đúng" — nó là cos của một góc. Cũng không có hằng số chung kiểu "trên 0.8 là đủ gần" cho mọi model: mỗi embedding model dựng một không gian riêng (bài trước), nên ngưỡng "đủ gần" phải đo trên câu hỏi thật của hệ thống bạn, không suy từ một con số đọc được ở đâu đó.
❌ Nhầm 2: coi điểm càng cao càng tốt trong mọi hệ thống.
✅ Một số vector store trả về khoảng cách (thường là 1 trừ cosine similarity) thay vì độ giống nhau. Với khoảng cách, điểm thấp mới là gần. Đọc nhầm chiều là lấy ngược cả danh sách kết quả mà không có lỗi nào hiện ra. Luôn kiểm tài liệu vector store đang dùng trả về loại điểm nào trước khi diễn giải.
7. Liên hệ các bài khác
- Bài 01 — Embedding, không gian của nghĩa: bài đó nói vector gần nhau; bài này là phép đo cụ thể cho chữ "gần".
- Bài 03 — Semantic vs keyword search: điểm cosine cao mà vẫn sai câu trả lời là một lý do keyword search đôi khi thắng semantic search.
- Bài 06 — RAG failure modes: "điểm cao nhất nhưng không trả lời được" là mầm của một failure mode có tên riêng ở bài đó.
- pgvector (khoá PostgreSQL — Advanced & Scale): operator
<=>của pgvector trả về cosine distance, đúng ca "điểm thấp mới là gần" ở Nhầm 2.
8. Tóm tắt
cosine(A, B) = (A · B) / (|A| × |B|), kết quả từ -1 đến 1; phép chia cho|A| × |B|là thứ loại độ dài ra khỏi điểm số.[4, 1]và[8, 2]cho đúng 1.00, còn[4, 1]và[1, 4]cùng độ lớn căn 17 mà chỉ được 0.47: hướng quyết định, độ lớn không.- Với vector API đã chuẩn hoá sẵn về độ dài 1, cosine và dot product cho cùng thứ hạng; kiểm tài liệu model trước khi chọn metric.
- Ngưỡng "đủ gần" phải đo trên câu hỏi thật của hệ thống; cột
distancethì điểm thấp mới là gần.
9. Tự kiểm tra
- Q1Vector A = [4, 1] và vector B = [8, 2]. Không tính số, dự đoán cosine(A, B) rồi giải thích bằng một câu vì sao.
- Q2Hai vector có độ lớn (norm) bằng hệt nhau. Điều đó có đảm bảo cosine similarity giữa chúng cao không? Vì sao?
- Q3Một đồng nghiệp thấy đoạn tài liệu điểm cosine 0.91 đứng đầu kết quả tìm kiếm nhưng không trả lời được câu hỏi, trong khi đoạn điểm 0.79 đứng thứ ba lại đúng. Đây có phải lỗi của thuật toán cosine không? Giải thích.
- Q4Một vector store trong hệ thống của bạn trả về cột 'distance' thay vì 'similarity' cho mỗi kết quả. Bạn nên sắp xếp kết quả theo chiều nào, và vì sao đọc nhầm chiều lại nguy hiểm?
- Q5Vì sao cosine similarity chia thêm cho |A| × |B| thay vì dùng thẳng dot product? Và khi nào hai cách cho cùng kết quả?
Bài tiếp theo: Semantic vs keyword search
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này