Bốn kiểu hỏng của RAG: lỗi ở retrieval hay generation?
RAG giảm bịa nhưng không triệt tiêu. Bốn failure mode có tên chuẩn cho bạn cách chẩn đoán: hỏng ở retrieval hay generation, và generation hỏng theo kiểu nào.
TL;DR: RAG (bài trước) giảm hallucination bằng cách buộc model trả lời dựa trên đoạn tài liệu vừa retrieve, nhưng không triệt tiêu được: model vẫn xử lý sai ngay cả khi có đúng đoạn trong tay. Sửa một hệ RAG hỏng, việc đầu tiên là cô lập bước hỏng: đáp án có trong kho tài liệu không, có được retrieve vào context không, rồi mới hỏi generation xử lý ra sao. Bốn năng lực mà generation cần có đều đã có tên chuẩn: noise robustness, negative rejection, information integration, counterfactual robustness. Gọi đúng tên thì bạn tra đúng chỗ sửa thay vì đoán mò.
Nhóm ở bài trước vừa dựng xong pipeline RAG cho chatbot tra policy nội bộ. Tuần triển khai đầu tiên, bốn ticket "bot trả lời sai" đổ về gần như cùng lúc:
- Ticket 1: Hỏi "Nghỉ phép năm áp dụng cho intern không?". Bot trộn quy định cho nhân viên chính thức với đoạn nói về lương thực tập, hai đối tượng bị gộp làm một.
- Ticket 2: Hỏi "Công ty có áp dụng tuần làm việc 4 ngày không?". Chính sách này chưa từng tồn tại, vậy mà bot trả lời chắc nịch: "Có, áp dụng từ quý này."
- Ticket 3: Hỏi "Tổng ngày nghỉ phép cộng dồn sau ba năm?". Đáp án cần cộng số ngày cơ bản (một đoạn) với phần thâm niên (đoạn khác). Bot chỉ lấy số ở đoạn đầu.
- Ticket 4: Hỏi "Mức phụ cấp đi lại hiện tại?". Kho có cả bản nháp cũ (số lỗi thời) lẫn bản đã duyệt (số mới), và cả hai đều được retrieve. Bot trích số ở bản nháp cũ.
Bốn ticket cùng một triệu chứng bề mặt, nhưng đổ ngay cho generation thì vội. Bài này đưa ra một quy trình chẩn đoán để tách chúng ra.
Model không có khái niệm đúng/sai, chỉ có phân phối xác suất token kế tiếp. Khi dữ liệu train hay context không đủ thông tin để chốt phân phối đó, model vẫn phải chọn ra một token, và câu trả lời sinh ra trôi chảy mà bịa. RAG đưa thêm context tốt hơn; bốn failure mode trong bài này là những cách generation vẫn trượt dù đã có context đó.
Tài liệu bị cắt thành đoạn (chunk) trước khi embed và index, vì embedding model có trần input và vector có độ dài cố định. Chunk sai cỡ hoặc mất ngữ cảnh ở biên là một nguồn gây hỏng retrieval: đoạn lọt vào context tự nó đã thiếu hoặc lẫn thông tin, và điều đó ảnh hưởng tới cả bốn failure mode ở bài này.
1. Analogy: thủ thư và người đọc
Bạn nhờ thư viện tìm tài liệu để trả lời một câu hỏi. Có hai vai tách biệt: thủ thư đi tìm và mang về các trang liên quan (retrieval), người đọc cầm các trang đó và trả lời (generation). Thủ thư có thể mang nhầm sách, bỏ sót cuốn đúng, và lỗi đó xảy ra trước khi người đọc chạm vào trang nào. Nhưng giả sử thủ thư mang đúng hết, người đọc vẫn có thể hỏng theo bốn kiểu: bị trang lạc đề kẹp chung xấp giấy làm phân tâm; không dám nói "không có câu trả lời" nên bịa đại; đọc trang đầu rồi quên trang sau dù cả hai đều cần; hoặc tin theo một trang ghi sai, lỗi thời. Bốn failure mode trong bài này toàn bộ là lỗi của người đọc, không phải của thủ thư.
| Thư viện | RAG | Hỏng ở đâu |
|---|---|---|
| Thủ thư mang nhầm/thiếu sách | Retrieve nhầm hoặc sót đoạn | Retrieval (ngoài 4 mode) |
| Người đọc bị trang lạc đề làm phân tâm | Thiếu noise robustness | Generation |
| Người đọc không dám nói "không có", bịa đại | Thiếu negative rejection | Generation |
| Người đọc chỉ đọc trang đầu, quên trang sau | Thiếu information integration | Generation |
| Người đọc tin theo một trang ghi sai/lỗi thời | Thiếu counterfactual robustness | Generation |
Một câu để nhớ: thủ thư mang nhầm sách là retrieval hỏng (ngoài 4 mode); người đọc đọc sai dù cầm đúng sách là 4 mode, nằm ở generation.
2. RAG trả lời sai: hỏng ở bước nào?
Trước khi gọi tên một mode, cô lập bước hỏng bằng ba câu hỏi theo đúng thứ tự. Bỏ qua câu đầu là lý do hay gặp nhất khiến người chẩn đoán gán nhầm mode.
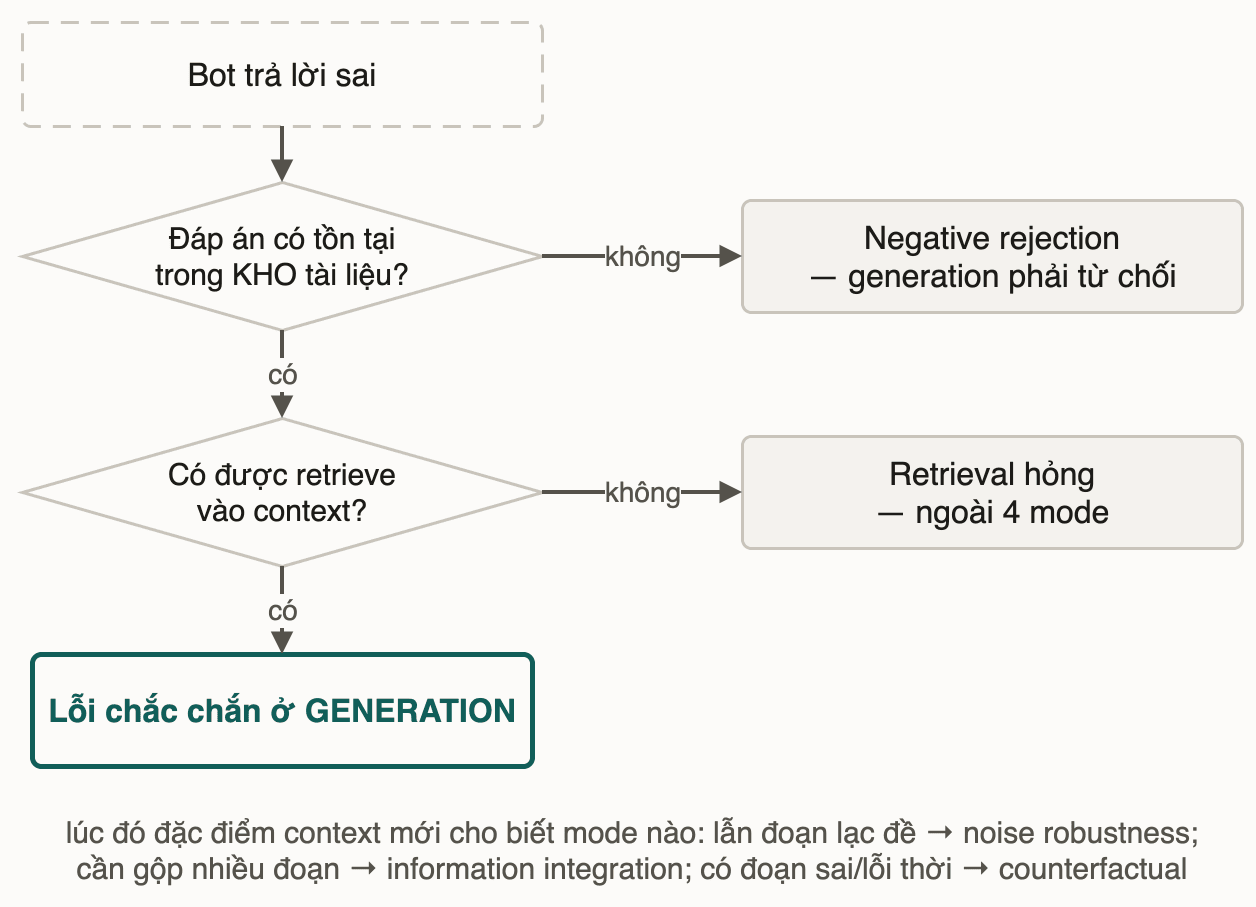
Chỉ khi đã loại được "đáp án vắng mặt trong kho" (bước 1) và "retrieve sót" (bước 2) thì lỗi mới chắc chắn ở generation. Lúc đó, đặc điểm của context cho biết mode nào trong ba mode còn lại (bảng bên dưới).
3. Bốn failure mode có tên gọi gì?
Bốn tên này lấy nguyên văn từ benchmark RGB (Chen et al., 2023, xem Deep Dive §6), đo trên sáu LLM. Cả bốn cùng kiểm tra một thứ: generation xử lý context đã retrieve tốt tới đâu. Ba bước cô lập ở mục 2 là cách áp bốn tên đó vào debug một hệ thật.
1. Noise robustness. Context lẫn đoạn nhiễu: gần nghĩa nhưng không trả lời câu hỏi (vì embedding tìm theo độ gần nghĩa, không theo "có trả lời được không"). Model bỏ qua được nhiễu hay bị kéo lệch? Ticket 1 (trộn chính sách intern) là ca này.
2. Negative rejection. Không đoạn nào trong context chứa đáp án, vì đáp án thật sự không có trong kho. Hệ thống không có bug nào cả. Năng lực cần có là nói "không tìm thấy thông tin này". Ticket 2 (tuần 4 ngày) là ca thiếu năng lực đó: bot lẽ ra phải từ chối, nhưng nó bịa.
3. Information integration. Đáp án cần gộp thông tin từ nhiều đoạn, không đoạn nào một mình đủ trả lời trọn. Model tổng hợp được, hay dùng đoạn đầu rồi dừng? Ticket 3 (ngày phép cơ bản cộng thâm niên) là ca này.
4. Counterfactual robustness. Một đoạn trong context chứa thông tin sai hoặc lỗi thời: nó liên quan hẳn tới câu hỏi, chỉ có điều nội dung sai. Model tin theo mù quáng hay phát hiện mâu thuẫn? (RGB đo năng lực này khi model được cảnh báo trước trong instruction rằng context có thể chứa thông tin sai; tự phát hiện mâu thuẫn mà không được nhắc là biến thể khó hơn.)
| Triệu chứng | Mode / Bước |
|---|---|
| Đáp án không có ở bất cứ đâu trong kho tài liệu | Negative rejection (generation phải biết từ chối) |
| Đáp án có trong kho, nhưng không đoạn nào trong context chứa nó | Retrieval hỏng (thượng nguồn, ngoài 4 mode) |
| Context có đoạn đúng lẫn đoạn nhiễu gần nghĩa, model bị nhiễu lái sang hướng khác | Noise robustness (generation) |
| Đáp án cần gộp từ 2 đoạn trở lên, model chỉ dùng 1 đoạn rồi dừng | Information integration (generation) |
| Một đoạn trong context chứa thông tin sai/lỗi thời, model trích lại như thật | Counterfactual robustness (generation) |
Negative rejection và retrieval hỏng đều bắt đầu bằng "không đoạn nào trả lời được câu hỏi", nhìn context thì giống hệt nhau. Khác biệt nằm ở câu hỏi bước 1: đáp án có tồn tại trong kho tài liệu không, chứ không phải có tồn tại trong context đã retrieve không. Bỏ qua bước 1 mà đi thẳng vào bước 2 là cách nhanh nhất để coi nhầm một ca negative rejection (generation phải học cách từ chối) thành một ca retrieval hỏng, rồi đi sửa nhầm pipeline retrieve.
4. Ticket khó nhất: retrieval hỏng hay generation?
Ticket 1, 2, 3 đã gắn mode ở mục trên. Ticket 4 dễ nhầm nhất vì bề mặt trông như retrieval hỏng. Tự chẩn đoán trước khi xem đáp án.
Kho tài liệu có một bản nháp cũ (số phụ cấp lỗi thời) và một bản đã duyệt (số đúng). Cả hai bản đều được retrieve vào context, không có đoạn nào bị retrieve nhầm. Bot trích số ở bản nháp cũ. Áp ba bước ở mục 2: đáp án đúng có trong kho không, có được retrieve vào context không, và lỗi rơi vào mode nào? Viết câu trả lời ra trước khi cuộn tiếp.
Đáp án: cả hai bản đều vào context, nên đáp án đúng có mặt và retrieval đã làm xong việc. Lỗi chắc chắn ở generation. "Một đoạn sai/lỗi thời nằm cạnh đoạn đúng" khớp định nghĩa counterfactual robustness. Nó không phải noise, vì bản cũ vẫn liên quan trực tiếp, chỉ là sai; cũng không phải negative rejection, vì đáp án đúng có mặt. Đối chiếu với Ticket 2 (chính sách chưa từng ban hành): ca đó dừng ngay ở bước 1, không có gì để retrieve, và generation phải từ chối thay vì bịa. Đó là negative rejection.
Gọi đúng tên xong, cách sửa rẻ nhất cho Ticket 4 lại nằm ở tầng index chứ không ở prompt: đừng index bản nháp, và gắn metadata trạng thái (draft/approved) cùng ngày hiệu lực cho từng tài liệu để bước retrieve lọc bỏ bản chưa duyệt hoặc hết hiệu lực. Bản cũ không vào context thì model không có gì để tin nhầm. Dạy model tự phân xử giữa hai bản mâu thuẫn là lớp phòng thủ thứ hai, không phải lớp đầu tiên.
5. Pitfall
❌ Thấy bot trả lời sai là đi sửa prompt/model ngay. Chạy ba bước cô lập trước. Nếu đáp án chưa được retrieve vào context, sửa prompt hay đổi model không giải quyết gì: model không thể trả lời đúng thứ nó chưa từng thấy. Và nhớ rằng RAG chỉ giảm bịa chứ không triệt tiêu: có đúng đoạn không đảm bảo model dùng đúng nó.
6. 📚 Deep Dive
- Chen, Lin, Han & Sun — Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), arXiv:2309.01431, AAAI 2024: nguồn bốn tên gọi, lấy nguyên văn từ abstract.
- Liu et al. — Lost in the Middle, arXiv:2307.03172: vị trí đoạn thông tin trong context (đầu/giữa/cuối) ảnh hưởng tới việc model dùng đúng đoạn nào. Paper không dùng thuật ngữ của RGB; mối liên hệ với noise robustness và information integration là suy luận của bài.
Caveat bắt buộc: RGB đánh giá sáu model trên corpus tiếng Anh và tiếng Trung, không có tiếng Việt. Bốn tên gọi mô tả cơ chế xử lý context nên dùng được cho mọi ngôn ngữ, nhưng con số cụ thể (model nào mạnh/yếu ở mode nào) không tự động đúng cho tiếng Việt. Phải tự đo trên dữ liệu thật.
Ghi chú: đối chiếu ngày 2026-07-23; hai paper trên không công bố con số giảm hallucination áp dụng chung, và benchmark đổi theo thời gian.
7. Liên hệ các bài khác
- Bài 05 — RAG pipeline: bài này giả định pipeline embed, retrieve, context, generate chạy đúng luồng; bốn mode ở đây dùng khi kết quả vẫn sai.
- Bài 04 — Chunking: chunk sai cỡ hoặc mất ngữ cảnh ở biên hay đẩy một ca vào noise robustness hoặc information integration.
- Hallucination: cơ chế gốc. Model không có khái niệm đúng/sai, chỉ có phân phối xác suất; RAG cho phân phối đó thêm căn cứ, không xoá được cơ chế.
- Mini-challenge: chọn kiến trúc: dùng lại ba bước chẩn đoán này khi cân nhắc RAG có hợp một use case hay không.
8. Tóm tắt
- Ticket 2 dừng ở bước 1 (kho không có), Ticket 4 qua cả hai bước (đáp án đúng có trong context): cùng triệu chứng "bot sai", khác hẳn chỗ sửa.
- Ca bản nháp cũ nằm cạnh bản duyệt sửa rẻ nhất ở tầng index: không index bản nháp, lọc theo metadata trạng thái và ngày hiệu lực.
- Negative rejection là năng lực từ chối khi kho không có đáp án; thiếu nó thì bot bịa một câu tự tin như Ticket 2.
- RGB đo trên tiếng Anh/Trung, không có tiếng Việt: taxonomy dùng được, con số cụ thể phải tự đo.
9. Tự kiểm tra
- Q1Một đồng nghiệp thấy bot trả lời sai liền kết luận ngay 'model kém, phải đổi model mạnh hơn'. Phản biện bằng ba bước chẩn đoán trong bài.
- Q2Ticket 2 (tuần 4 ngày) và Ticket 4 (phụ cấp lỗi thời) đều là 'bot trả lời sai'. Vì sao chúng lại là hai mode khác nhau?
- Q3Vì sao negative rejection và retrieval hỏng dễ nhầm nhất? Nêu một câu hỏi phân biệt hai ca này.
- Q4Noise robustness và counterfactual robustness đều là 'một đoạn không đáng tin trong context'. Phân biệt hai mode này.
- Q5Ticket 3 là information integration. Nếu bot chỉ nêu số ngày cơ bản, bỏ qua thâm niên, điều đó nói lên gì về cách generation xử lý context?
- Q6Vì sao 'RGB đánh giá trên tiếng Anh và tiếng Trung' lại quan trọng khi áp taxonomy này vào một hệ RAG tiếng Việt?
Bài tiếp theo: Mini-challenge: chọn kiến trúc
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
RAG — retrieve rồi mới generate
Bài tiếpMini-challenge: chọn kiến trúc cho ba bài toán thật
Thảo luận & góp ý
Hỏi đáp về bài này