Full-text search tiếng Việt — tsvector, unaccent, GIN
LIKE '%deploy%' quét cả bảng và không match 'deployment'; 'khan cap' không ra 'khẩn cấp'. Bài dựng FTS PostgreSQL với tsvector, GIN và config unaccent cho tiếng Việt.
TL;DR: WHERE body LIKE '%deploy%' có hai bệnh: leading wildcard vô hiệu hoá B-tree nên quét cả bảng, và nó so khớp chuỗi con nên "deployment" không match "deploy", "khan cap" không match "khẩn cấp". Full-text search của PostgreSQL chữa cả hai: to_tsvector tách document thành token (có stem với tiếng Anh), lưu vào generated column, GIN index tra ngược từ token về row, và @@ so với tsquery từ câu người dùng gõ. Với tiếng Việt, PostgreSQL không có dictionary sẵn; bạn tự tạo config vietnamese = unaccent + simple, để cả document lẫn query đều bị bỏ dấu trước khi so. Lỗi gõ sai ("dploy") thì FTS chịu, phải thêm pg_trgm.
TaskFlow vừa ra mắt search box. Product manager demo trước khách: gõ "deploy", kết quả về sau 2,8 giây và task "deployment pipeline" không xuất hiện. Gõ "khẩn cấp" thì không có kết quả, dù có chục task urgent. Gõ "khan cap" không dấu, vẫn trắng. Demo thất bại.
Query hiện tại là WHERE body LIKE '%deploy%': leading wildcard chặn mọi B-tree, và LIKE so khớp chuỗi con nguyên văn nên không biết "deployment" chứa "deploy", không biết "khẩn" và "khan" là một. Bài này xây search cho TaskFlow hoàn toàn trong PostgreSQL, không cần Elasticsearch.
1. Analogy — thư viện và bảng tra từ khoá cuối sách
| Cách tìm | Tương đương SQL | Đặc điểm |
|---|---|---|
| Đọc từng cuốn từ đầu tới cuối tìm chuỗi "deploy" | LIKE '%deploy%' Seq Scan | Chính xác nhưng chậm tuyến tính với số sách |
| Tra bảng từ khoá cuối sách ("deploy" → trang 45, 112) | FTS với GIN | Index từng token, không đọc toàn bộ |
| Gộp "deploy", "deployed", "deployment" vào một mục | Stemming | Nhóm các dạng của từ về gốc |
| Gộp "khẩn" và "khan" vào một mục | Unaccent | Có dấu và không dấu về cùng entry |
| Tìm cuốn chứa chuỗi "dpl" (gõ sai) | pg_trgm | Fuzzy, chịu typo, không phải FTS |
tsvector là bảng tra từ khoá của một document, làm một lần, tra nhiều lần. tsquery là câu hỏi bạn tra vào bảng đó. @@ là hành động tra, trả true/false.
2. Vấn đề LIKE với 1M row
EXPLAIN ANALYZE
SELECT id, title, body FROM tasks WHERE body LIKE '%deploy%';
Seq Scan on tasks  (cost=0.00..24532.00 rows=1000 width=312)
                   (actual time=0.051..2487.312 rows=3241 loops=1)
  Filter: (body ~~ '%deploy%'::text)
  Rows Removed by Filter: 996759
Execution Time: 2531.447 ms
Leading wildcard vô hiệu hoá B-tree nên PG đọc cả 1M row. Khoá Internals đã dùng pg_trgm GIN để cứu pattern như vậy, nhưng LIKE vẫn còn hai bệnh FTS chữa tốt hơn: không tokenize ("deployment" không match "deploy") và không normalize ("khẩn cấp" không match "khan cap").
3. tsvector + tsquery — giải phẫu FTS
tsvector là document đã tiền xử lý: text gốc thành danh sách (token, vị trí). tsquery là biểu thức boolean của token.
-- tsvector: preprocessed document
SELECT to_tsvector('english', 'The quick brown fox jumps over the lazy dog');
-- 'brown':3 'dog':9 'fox':4 'jump':5 'lazi':8 'quick':2
-- stopword (the, over) bi bo; jumps -> jump, lazy -> lazi (stem); giu vi tri de rank

-- tsquery
SELECT to_tsquery('english', 'deploy | deployment');
-- 'deploy' | 'deploy'  -- ca hai stem ve 'deploy'

-- @@ : tsvector match tsquery?
SELECT to_tsvector('english', 'deploy production') @@ to_tsquery('english', 'deployment');
-- true
| Aspect | LIKE '%x%' | FTS tsvector @@ tsquery |
|---|---|---|
| "deployment" match "deploy" | Không | Có (stemming) |
| Index | Không (leading %) | GIN |
| Xếp hạng theo độ liên quan | Không | ts_rank |
| Highlight đoạn match | Không | ts_headline |
| Bỏ dấu | Không | Có (với unaccent) |
4. Hàm nào để biến câu người dùng gõ thành tsquery?
-- plainto_tsquery: AND moi token, khong parse operator
SELECT plainto_tsquery('english', 'deploy production');
-- 'deploy' & 'product'

-- websearch_to_tsquery (PG 11+): cu phap kieu Google, khong nem loi voi input bat ky
SELECT websearch_to_tsquery('english', '"deploy production" -staging OR test');
-- 'deploy' <-> 'product' & !'stage' | 'test'

-- to_tsquery: parse day du (& | ! <->), dung khi app tu build query
SELECT to_tsquery('english', 'deploy & prod & !staging');
-- 'deploy' & 'prod' & !'stage'
Với search box nhận input tự do, websearch_to_tsquery là lựa chọn đúng: người dùng đã quen cú pháp Google, và hàm không ném lỗi khi họ gõ dấu ngoặc thừa.
5. GIN cho tsvector — workflow cơ bản
Cùng một GIN của bài 03, chỉ đổi element từ key-value JSONB sang token của tsvector. Setup với config English trước, tiếng Việt ở section sau:
-- Generated column: PG tu tinh lai khi body doi, luu tren disk
ALTER TABLE tasks
  ADD COLUMN body_tsv tsvector
    GENERATED ALWAYS AS (to_tsvector('english', coalesce(body, ''))) STORED;

CREATE INDEX idx_tasks_body_fts ON tasks USING gin(body_tsv);

-- Search: dat tsquery vao FROM de dung lai o ca WHERE lan SELECT
SELECT id, title, ts_rank(body_tsv, query) AS rank
FROM tasks, plainto_tsquery('english', 'deploy production') query
WHERE body_tsv @@ query
ORDER BY rank DESC
LIMIT 10;
Bitmap Heap Scan on tasks  (cost=32.45..1234.12 rows=312 width=124)
                            (actual time=1.203..4.892 rows=312 loops=1)
  Recheck Cond: (body_tsv @@ plainto_tsquery('english', 'deploy production'))
  ->  Bitmap Index Scan on idx_tasks_body_fts
        (actual time=1.101..1.101 rows=312 loops=1)
Execution Time: 5.234 ms
Từ 2531 ms xuống 5 ms trong demo này. Vì sao phải là generated column: tính to_tsvector('english', body) ngay trong WHERE thì PG không biết biểu thức đó trùng với cột đã index, GIN bị bỏ qua và mỗi row lại tokenize từ đầu.
6. Vì sao config 'english' không tìm ra "khẩn cấp" khi gõ "khan cap"?
PostgreSQL không có Vietnamese dictionary sẵn. Config 'english' chạy Snowball stemmer cho tiếng Anh và giữ nguyên ký tự có dấu. Trước khi chạy câu thứ hai, hãy đoán nó trả true hay false:
SELECT to_tsvector('english', 'Khẩn cấp triển khai sản phẩm');
-- 'cấp':2 'khai':4 'khẩn':1 'phẩm':6 'sản':5 'triển':3

SELECT to_tsvector('english', 'Khẩn cấp') @@ to_tsquery('english', 'khan & cap');
-- false
Token bên document còn dấu, token bên query không dấu, GIN tra hai chuỗi khác nhau. Tiếng Việt cần hai thứ: bỏ dấu để "khẩn" và "khan" về một token, và không stem, vì tiếng Việt là ngôn ngữ đơn lập, không chia động từ.
7. Config vietnamese = unaccent + simple
Extension unaccent bỏ dấu; dictionary simple chỉ lowercase, không stem. Ghép lại thành config đủ dùng cho production:
CREATE EXTENSION IF NOT EXISTS unaccent;

SELECT unaccent('Khẩn cấp triển khai sản phẩm');
-- Khan cap trien khai san pham

-- Config rieng: copy simple, chen unaccent truoc simple trong pipeline
CREATE TEXT SEARCH CONFIGURATION vietnamese (COPY = simple);
ALTER TEXT SEARCH CONFIGURATION vietnamese
  ALTER MAPPING FOR hword, hword_part, word
  WITH unaccent, simple;

SELECT to_tsvector('vietnamese', 'Khẩn cấp triển khai sản phẩm');
-- 'cap':2 'khai':4 'khan':1 'pham':6 'san':5 'trien':3

-- Document co dau, query khong dau (va nguoc lai) deu match
SELECT to_tsvector('vietnamese', 'Khẩn cấp') @@ to_tsquery('vietnamese', 'khan & cap');
-- true
SELECT to_tsquery('vietnamese', 'khẩn & cấp');
-- 'khan' & 'cap'
Cơ chế: unaccent chạy trước simple trong pipeline, và pipeline này áp cho cả document lúc index lẫn query lúc tìm, nên hai bên luôn về cùng token.
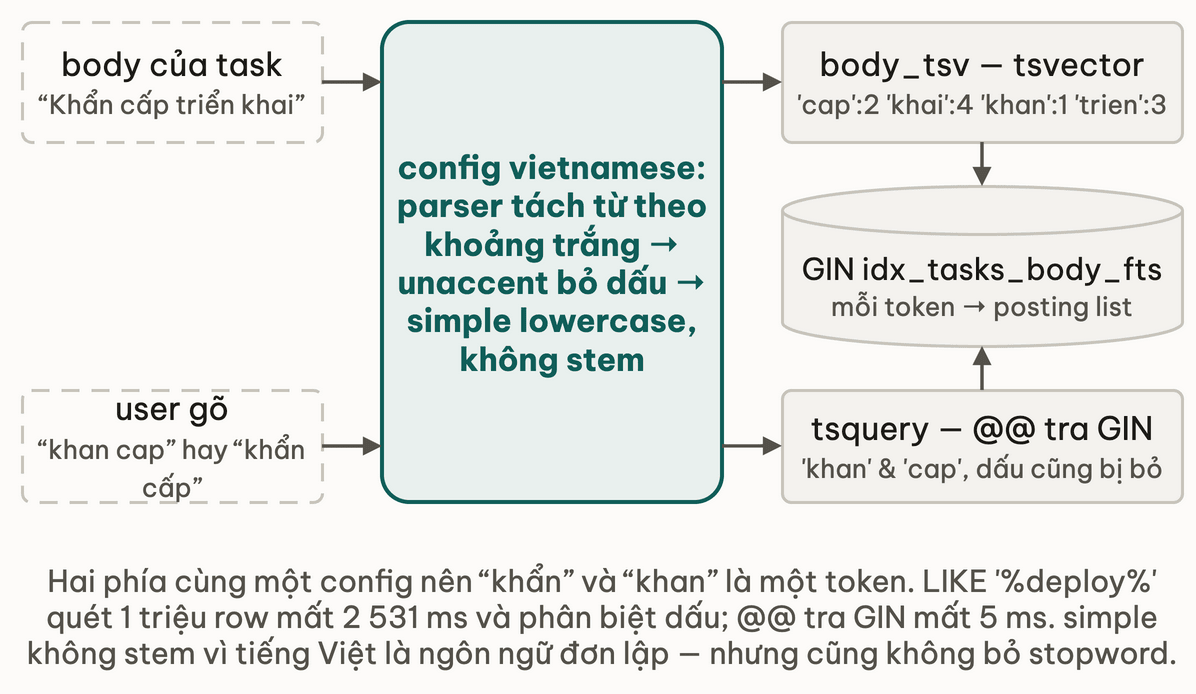
Ba giới hạn cần biết trước khi ship: simple tách token theo khoảng trắng, nên "trienkhai" viết liền không match "triển khai"; không có tokenizer phân tích ranh giới từ như tiếng Nhật/Trung, cần thật thì nhìn sang pgroonga hoặc Elasticsearch với analysis-icu; và simple không bỏ stopword tiếng Việt ("và", "là", "của"), các token này chiếm posting list lớn và lọt vào query, nên hoặc tạo stopword file riêng cho config, hoặc strip ở app trước khi gọi websearch_to_tsquery.
Thử ngẫmconfig vietnamese bạn vừa tạo không strip stopword "và", "là", "của". Nếu user TaskFlow gõ "task và deploy" vào ô search, kết quả sẽ thiếu những task nào?
8. ts_rank + ts_headline — xếp hạng và highlight
-- ts_rank: diem cang cao cang khop (tan suat token + vi tri + weight)
SELECT id, title, ts_rank(body_tsv, query) AS rank
FROM tasks, plainto_tsquery('vietnamese', 'khan cap deploy') query
WHERE body_tsv @@ query
ORDER BY rank DESC
LIMIT 20;

-- ts_headline: cat doan van chua match va boc the highlight
SELECT id,
       ts_headline('vietnamese', body, query,
                   'StartSel=<mark>, StopSel=</mark>, MaxWords=20, MinWords=10') AS snippet
FROM tasks, plainto_tsquery('vietnamese', 'khan cap') query
WHERE body_tsv @@ query;
-- snippet: "...task <mark>khẩn</mark> <mark>cấp</mark> cần deploy ngay..."
-- (highlight tren text goc con dau -- dung nhu mong doi)
ts_headline parse lại body gốc để tìm vị trí match, nên tốn CPU với body dài; giới hạn bằng MaxFragments và chỉ gọi trên trang kết quả đã LIMIT.
9. pg_trgm — typo và tìm chuỗi con
FTS lo stemming và dấu, nhưng không chịu được lỗi gõ: "dploy" hay "trienkha" không match. pg_trgm cắt chuỗi thành bộ ba ký tự và đo độ trùng:
CREATE EXTENSION IF NOT EXISTS pg_trgm;

CREATE INDEX idx_tasks_title_trgm ON tasks USING gin(title gin_trgm_ops);

-- % la similarity operator, nguong mac dinh 0.3
SELECT title, similarity(title, 'dploy') AS sim
FROM tasks
WHERE title % 'dploy'
ORDER BY sim DESC
LIMIT 10;
-- "deploy production" van match du thieu chu e
| Nhu cầu | FTS (tsvector) | pg_trgm |
|---|---|---|
| Search nội dung dài, xếp hạng | Tốt | Kém |
| Stemming / bỏ dấu | Tốt | Không |
| Chịu typo | Không | Tốt |
| Search-as-you-type (prefix) | Kém | Tốt |
| Chuỗi con bất kỳ | Không | Tốt |
Pattern production: FTS là đường chính; khi FTS trả 0 kết quả, fallback sang title % $1 bằng trigram.
Thử ngẫmuser gõ "dploy" vào search box TaskFlow, thiếu một chữ e. tsvector @@ tsquery trả về gì, và operator nào trong bài này mới cứu được câu tìm kiếm đó?
10. Pitfall tổng hợp
Pitfall 1 — tính to_tsvector trong WHERE thay vì generated column:
-- Sai: GIN tren body_tsv khong duoc dung, moi row tokenize lai
SELECT * FROM tasks WHERE to_tsvector('vietnamese', body) @@ query;

-- Dung: generated column STORED + GIN tren column do
ALTER TABLE tasks
  ADD COLUMN body_tsv tsvector
    GENERATED ALWAYS AS (to_tsvector('vietnamese', coalesce(body, ''))) STORED;
Pitfall 2 — tưởng FTS là substring search:
SELECT to_tsvector('vietnamese', 'apple watch') @@ to_tsquery('vietnamese', 'apl');
-- false: GIN tra token 'apl', khong co entry
Cần chuỗi con hay autocomplete thì dùng pg_trgm, FTS chỉ so token nguyên.
Pitfall 3 — không đo kích thước GIN trước khi ship:
GIN trên tsvector có thể lớn, và lớn bao nhiêu phụ thuộc số token phân biệt và độ dài body của dữ liệu thật. Đừng ước lượng bằng hệ số; nạp dataset thật rồi đo pg_total_relation_size('tasks') trước và sau khi tạo index, rồi tính vào storage và backup.
11. Applied — search box TaskFlow production-ready
-- Generated column ghep title (weight A) + body (weight B): ts_rank uu tien title
ALTER TABLE tasks
  ADD COLUMN search_tsv tsvector
    GENERATED ALWAYS AS (
      setweight(to_tsvector('vietnamese', coalesce(title, '')), 'A') ||
      setweight(to_tsvector('vietnamese', coalesce(body, '')),  'B')
    ) STORED;

CREATE INDEX idx_tasks_search ON tasks USING gin(search_tsv);

-- /api/search?q=khan+cap+deploy  ($1 = input, $2 = project_id)
SELECT id, title,
       ts_headline('vietnamese', coalesce(body, ''), query,
                   'StartSel=<mark>, StopSel=</mark>, MaxWords=20, MaxFragments=2') AS snippet,
       ts_rank(search_tsv, query) AS rank
FROM tasks, websearch_to_tsquery('vietnamese', $1) query
WHERE search_tsv @@ query
  AND project_id = $2
ORDER BY rank DESC, created_at DESC
LIMIT 20;
12. Deep Dive
- PostgreSQL Documentation — "Full Text Search": tsvector/tsquery, text search configuration, GIN/GiST cho FTS,
ts_rank,ts_headline. Mục Dictionaries giải thích pipeline dictionary mà configvietnamesedựa vào. - PostgreSQL Documentation — unaccent: cách unaccent hoạt động như filtering dictionary và cách tạo
unaccent.rulesriêng. - PostgreSQL Documentation — pg_trgm: operator trigram,
similarity(),word_similarity(),pg_trgm.similarity_threshold. - PostgreSQL Documentation — Text Search Types: spec của
tsvector/tsquery,setweight, phrase search<->.
13. Liên hệ các bài khác
- Bài 03 — GIN index cho JSONB: cùng cơ chế posting list và pending list; ghi nhiều thì FTS cũng chịu write tax như JSONB.
- Bài 06 — pgvector: FTS so token, không so nghĩa; "fix payment bug" và "resolve checkout error" cần embedding.
- Bài 07 — Mini-challenge: config
vietnameseở đây gộp với GIN JSONB và B-tree trong một query. - Trie (khoá Thuật toán cốt lõi): cấu trúc cho prefix search, để thấy vì sao FTS kém search-as-you-type còn trigram thì được.
- Semantic vs keyword (khoá AI Core): ranh giới giữa keyword search bài này và semantic search bài sau.
14. Tóm tắt
- Checklist ship search: generated column
STORED+ GIN, config đúng ngôn ngữ ở cả hai phía,websearch_to_tsquerycho input người dùng,LIMITtrước khits_headline. - Debug "search không ra": chạy
to_tsvector(config, doc)vàto_tsquery(config, q)riêng, so token hai bên; khác dấu hoặc khác config là thủ phạm. - Tiếng Việt:
unaccent+simple, không stem; stopword tự lo; từ viết liền không match. setweightA cho title, B cho body khi cần title thắng trongts_rank.- Typo, prefix, chuỗi con:
pg_trgmvớigin_trgm_ops, dùng làm fallback khi FTS trả 0.
15. Tự kiểm tra
- Q1Tại sao `WHERE body LIKE '%deploy%'` không dùng được B-tree dù có index trên `body`? FTS giải bài toán này khác LIKE ở đâu?
- Q2Giải thích cơ chế config `unaccent + simple`. Tại sao 'khan cap' match được document chứa 'Khẩn cấp'?
- Q3Vì sao dùng `GENERATED ALWAYS AS (...) STORED` cho tsvector thay vì tính `to_tsvector(body)` trong WHERE?
- Q4Làm sao để match ở `title` được rank cao hơn match ở `body`? `setweight` hoạt động thế nào?
- Q5FTS và `pg_trgm` đều dùng GIN nhưng giải bài toán khác nhau. Khi nào chọn cái nào, khi nào cần cả hai?
- Q6GIN cho tsvector có write tax như GIN cho JSONB không? Sau khi thêm `search_tsv` và GIN, INSERT đổi thế nào và kiểm tra ra sao?
Bài tiếp theo: pgvector và semantic search — embedding, cosine similarity
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên