JSONB vs JSON vs TEXT — lưu dữ liệu bán cấu trúc trong PostgreSQL
TEXT không validate, JSON giữ nguyên chuỗi nên parse lại mỗi query, JSONB tách thành cây binary đã sort key và có GIN index. Bài giải thích khi nào chọn loại nào.
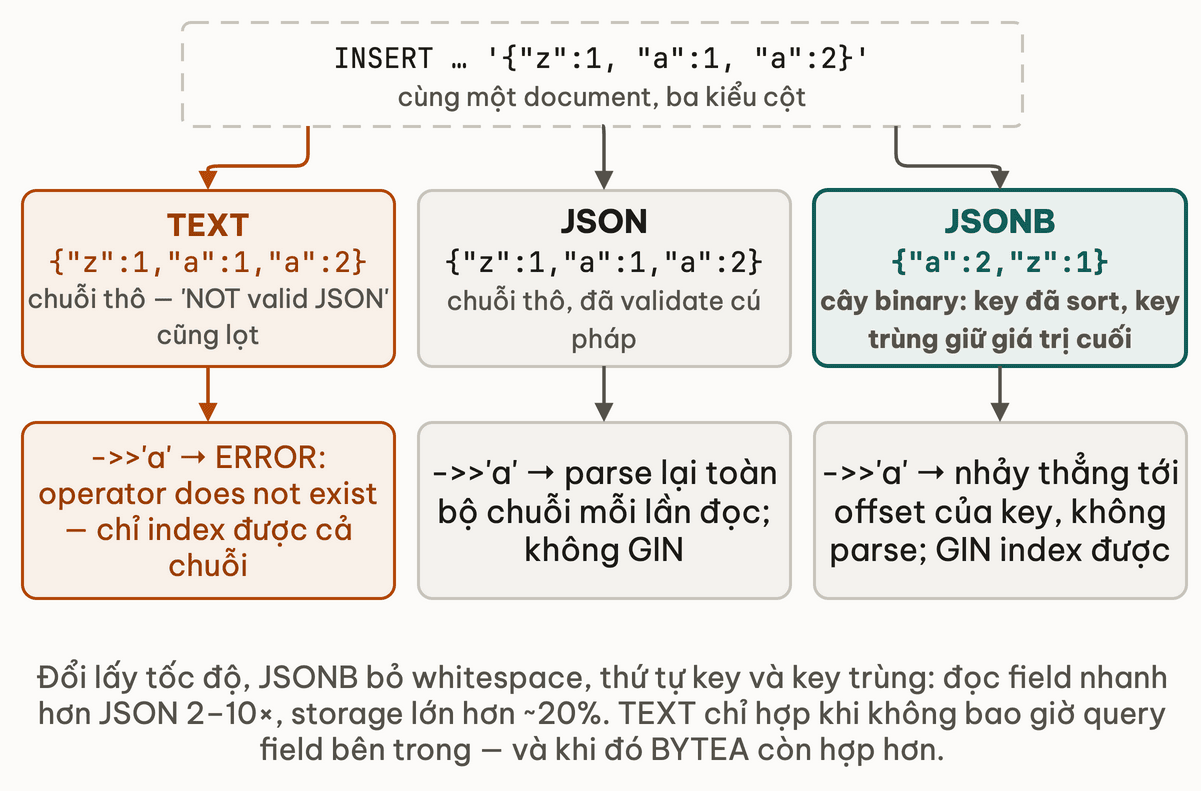
TL;DR: PostgreSQL có ba cách lưu một document JSON. TEXT chỉ giữ chuỗi ký tự: không validate, không operator, không index theo field. JSON validate cú pháp và giữ nguyên chuỗi gốc (khoảng trắng, thứ tự key, cả key trùng), nên mỗi lần đọc một field phải parse lại từ đầu và không tạo được GIN index. JSONB parse một lần lúc INSERT rồi lưu dạng binary đã sort key và dedupe, nhờ đó đọc field là nhảy thẳng tới offset và hỗ trợ GIN index cho @>. Với backend thông thường, JSONB là mặc định; JSON và TEXT chỉ còn chỗ khi bạn cần giữ byte-exact chuỗi gốc.
TaskFlow cần "custom field per project": project A có due_priority, project B có blocker_id, project C có compliance_tag. Schema cứng không scale, vì mỗi tenant thêm field là một lần ALTER TABLE trên production. Bạn cần một cột chứa được cấu trúc khác nhau cho từng row, và PostgreSQL cho ba cách: TEXT, JSON, JSONB. Bài này giải thích ba loại khác nhau ở đâu bên trong engine và vì sao JSONB thắng gần như mọi trường hợp.
1. Analogy — ba cách lưu hồ sơ giấy
Bạn có hàng nghìn hồ sơ giấy cần lưu:
| Cách lưu hồ sơ | Tương đương SQL | Đặc điểm |
|---|---|---|
| Nhét nguyên tờ giấy vào folder không phân loại | TEXT | Chỉ tìm được bằng tên folder; mở ra không biết nội dung là gì |
| Scan ảnh hồ sơ và lưu file ảnh | JSON | Giữ nguyên bản gốc, nhưng phải đọc lại (OCR) mỗi khi cần một thông tin |
| OCR toàn bộ, index từng trường vào database | JSONB | Mất bản gốc (ảnh), nhưng tra trường nào cũng nhanh |
2. TEXT — PostgreSQL chỉ thấy một chuỗi
Lưu JSON như chuỗi ký tự thông thường: PostgreSQL không biết đây là JSON hay bất kỳ cấu trúc nào khác.
-- TEXT: PG treat nhu opaque blob
ALTER TABLE tasks ADD COLUMN task_metadata TEXT;

INSERT INTO tasks (project_id, title, task_metadata)
VALUES (1, 'Deploy v2', '{"priority": "high", "labels": ["deploy"]}');

-- PG khong validate: insert string xau duoc
INSERT INTO tasks (project_id, title, task_metadata)
VALUES (2, 'Fix bug', 'this is NOT valid JSON at all');
-- Khong co loi! PG khong kiem tra noi dung

-- Khong the query field ben trong:
SELECT * FROM tasks WHERE task_metadata->>'priority' = 'high';
-- ERROR: operator does not exist: text ->> unknown
Ba hệ quả đi cùng nhau: chuỗi hỏng lọt vào bảng và chỉ vỡ khi app đọc; không có operator ->, ->>, @> nên muốn lọc theo field phải kéo cả chuỗi về app; không index được nội dung. Đổi lại, write nhanh nhất vì PG chỉ ghi byte. TEXT hợp lý khi bạn không bao giờ query theo field, ví dụ một JWT đã ký cần verify nguyên văn; khi đó BYTEA còn hợp hơn.
Thử ngẫmbạn vừa insert 'this is NOT valid JSON at all' vào cột TEXT và PostgreSQL không báo lỗi gì. Sáu tháng sau, ai sẽ là người phát hiện ra bug này, và phát hiện ở đâu?
3. JSON — validate cú pháp, giữ nguyên chuỗi gốc
Type JSON validate cú pháp khi INSERT và cho phép dùng các JSON operator, nhưng bên trong vẫn lưu đúng chuỗi bạn gửi vào.
-- JSON: validate syntax + preserve raw text
ALTER TABLE tasks ADD COLUMN task_metadata JSON;

INSERT INTO tasks (project_id, title, task_metadata)
VALUES (2, 'Fix bug', 'NOT valid JSON');
-- ERROR: invalid input syntax for type json

-- Preserve EVERYTHING: whitespace, key order, duplicate key
SELECT '{"a": 1,   "b": 2}'::json;
-- {"a": 1,   "b": 2}  -- whitespace giu nguyen

SELECT '{"z": 1, "a": 2}'::json;
-- {"z": 1, "a": 2}    -- key order giu nguyen

SELECT '{"a": 1, "a": 2}'::json;
-- {"a": 1, "a": 2}    -- ca hai cap key trung deu duoc giu
Cái "giữ nguyên" đó là giá phải trả: mỗi lần đọc một field, PG parse lại toàn bộ chuỗi. Và vì không có cấu trúc đã tách sẵn, PG không tạo được GIN index trên cột JSON. GIN (Generalized Inverted Index) là index tra ngược từ phần tử về row chứa nó, mổ ở bài 03; nó cần document đã tách thành key và value, thứ chỉ JSONB có.
Còn key trùng? PostgreSQL giữ cả hai cặp trong chuỗi, nhưng khi bạn đọc ->>'a', hàm xử lý coi giá trị cuối là giá trị có hiệu lực, tức trả 2, giống JSONB. Điểm khác nằm ở chỗ chuỗi thô vẫn mang cả hai cặp: một client khác đọc raw JSON bằng thư viện lấy giá trị đầu sẽ thấy 1, và hai bên lệch nhau mà không ai báo lỗi.
Vậy JSON còn chỗ nào? Khi bạn cần vừa validate cú pháp lúc ghi, vừa trả lại đúng chuỗi đã nhận, và không bao giờ lọc theo field. Tổ hợp đó hiếm; cột JSON gần như chỉ còn gặp ở schema cũ.
4. Vì sao JSONB đọc field nhanh hơn JSON dù cùng một document?
Type JSONB validate và parse JSON khi INSERT, sau đó lưu dạng binary đã tách: một cấu trúc cây có key được sort, key trùng bị dedupe, và một bảng offset để nhảy thẳng tới từng phần tử.
Trước khi chạy ba câu dưới, hãy đoán: '{"z": 1, "a": 2}'::jsonb in ra thứ tự nào, và '{"a": 1, "a": 2}'::jsonb in ra gì?
-- JSONB: parse 1 lan khi INSERT, luu binary
ALTER TABLE tasks ADD COLUMN task_metadata JSONB DEFAULT '{}';

SELECT '{"a": 1,   "b": 2}'::jsonb;
-- {"a": 1, "b": 2}    -- whitespace bi bo

SELECT '{"z": 1, "a": 2}'::jsonb;
-- {"a": 2, "z": 1}    -- KEY DUOC SORT

SELECT '{"a": 1, "a": 2}'::jsonb;
-- {"a": 2}            -- DUPLICATE BI DEDUPE, giu gia tri cuoi cung
Quá trình decompose khi INSERT:
- Parse và validate cú pháp (giống JSON).
- Tách object thành các cặp key-value.
- Sort key để binary search nhanh.
- Dedupe key trùng, giữ giá trị xuất hiện cuối.
- Ghi binary kèm bảng offset cho random access.
Kết quả: query một field là nhảy tới offset của key trong cây, không parse lại. Chênh lệch so với JSON tăng theo kích thước và độ sâu document; muốn có con số cho workload của bạn, so EXPLAIN ANALYZE cùng một query trên hai cột.
5. So sánh TEXT / JSON / JSONB
| Aspect | TEXT | JSON | JSONB |
|---|---|---|---|
| Validate cú pháp | Không | Có | Có |
| Giữ whitespace / thứ tự key / key trùng | Có | Có | Không |
| Kích thước lưu trữ | Đúng bằng chuỗi | Đúng bằng chuỗi | Thường lớn hơn một chút (header + offset), tuỳ hình dạng document |
| Tốc độ INSERT | Nhanh nhất | Trung bình (validate) | Chậm nhất (decompose) |
| Đọc field | Không làm được | Parse lại mỗi lần | Nhảy tới offset |
| GIN index | Không | Không | Có |
Operator ->, ->>, #>, #>> | Không | Có (parse lại) | Có, nhảy offset |
Operator @>, ? | Không | Không có | Có |
Phần dư kích thước của JSONB đo bằng pg_column_size(); với backend đọc nhiều hơn ghi, khoản này gần như luôn rẻ hơn tốc độ đọc và GIN index nhận lại.
6. Demo — TaskFlow custom field per project
Thêm JSONB column để mỗi project tự khai field riêng mà không cần ALTER TABLE:
ALTER TABLE tasks ADD COLUMN task_metadata JSONB DEFAULT '{}';

INSERT INTO tasks (project_id, title, task_metadata) VALUES
  (1, 'Deploy v2',
   '{"priority": "high", "labels": ["deploy", "prod"], "estimate_hours": 4}'),
  (1, 'Fix critical bug',
   '{"priority": "low", "blocker_task_id": 100}'),
  (2, 'Write privacy doc',
   '{"compliance_tag": "GDPR", "reviewer_count": 3}'),
  (3, 'Refactor auth',
   '{"sprint": 12, "story_points": 8, "epic": "security"}');
-- Moi project co field rieng -- khong can ALTER TABLE

-- Doc field: ->> tra text
SELECT title, task_metadata->>'priority' AS priority
FROM tasks
WHERE task_metadata->>'priority' = 'high';
-- Deploy v2 | high

-- Key ton tai (JSONB only)
SELECT title FROM tasks
WHERE task_metadata ? 'compliance_tag';
-- Write privacy doc

-- Containment (JSONB only, nhanh voi GIN index)
SELECT title FROM tasks
WHERE task_metadata @> '{"labels": ["prod"]}';
-- Deploy v2
Ba operator ->>, ?, @> được mổ từng cái ở bài 02.
7. Pitfall — JSONB không phải NoSQL, và đừng nhét schema cố định vào đó
Pitfall 1 — "JSONB là document store":
JSONB chỉ là một column type trong bảng relational: vẫn có NOT NULL và CHECK trên cột, FK trên các cột khác cùng row, và WAL với MVCC bảo vệ JSONB write y như mọi cột khác. Thứ nó thiếu là B-tree riêng cho từng field bên trong; chỉ có GIN trên cả document hoặc expression index cho một field.
Pitfall 2 — nhét field có schema cố định vào JSONB:
-- Sai: task_metadata chua cac field luon co, schema co dinh
task_metadata = '{"status": "todo", "assignee_id": 5, "priority": "high"}'

-- Nen extract ra column rieng:
-- status TEXT CHECK (status IN ('todo', 'doing', 'done'))
-- assignee_id BIGINT REFERENCES users(id)
-- priority TEXT CHECK (priority IN ('low', 'medium', 'high'))
Field đã biết schema thì column riêng cho bạn type safety, CHECK, FK và B-tree, tất cả tốt hơn JSONB. Khi nào nên dời một key JSONB lên column và dời thế nào không downtime là chủ đề của bài 04.
Thử ngẫmtrong schema dự án bạn đang làm, có cột JSONB nào chứa một key xuất hiện ở gần 100% row và được lọc thường xuyên không? Key đó đang trả giá gì so với một column?
8. Applied — hai use case JSONB thực chiến
Custom field multi-tenant ở section 6 là use case thứ nhất. Use case thứ hai là audit log, nơi mỗi loại event mang payload khác hẳn nhau:
CREATE TABLE audit_logs (
  id          BIGSERIAL PRIMARY KEY,
  event_type  TEXT NOT NULL,
  user_id     BIGINT REFERENCES users(id),
  occurred_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  payload     JSONB NOT NULL DEFAULT '{}'
);

INSERT INTO audit_logs (event_type, user_id, payload) VALUES
  ('task.update', 7, '{"task_id": 42, "old": {"status": "todo"}, "new": {"status": "done"}}');
Cột chung cho mọi event (event_type, user_id, occurred_at) là column cứng để filter và partition; phần khác nhau theo event nằm trong payload. Webhook delivery log theo cùng khuôn: status_code là column, request_payload là JSONB để replay khi debug.
9. Deep Dive
- PostgreSQL Documentation — "JSON Types": toàn bộ hành vi của JSON và JSONB, kể cả câu nói rõ key trùng trong JSON được giữ nhưng hàm xử lý lấy giá trị cuối; mục "jsonb Containment and Existence" định nghĩa
@>và?; mục "jsonb Indexing" nói GIN index hoạt động thế nào trên JSONB.
10. Liên hệ các bài khác
- Bài 02 — JSONB operators & JSONPath: ba operator
->>,?,@>bạn vừa thấy ở demo, cùng bẫy kiểu trả về và cast số. - Bài 03 — GIN index cho JSONB: vì sao chỉ JSONB tạo được GIN, và hai operator class đổi gì lấy gì.
- Bài 04 — Hybrid schema: quy trình 8 bước dời một key JSONB lên column khi nó thành field chung, không downtime.
- Data types (khoá SQL & Database): chọn kiểu cho column cứng, thứ JSONB không thay thế.
- Normalization 1NF–3NF: JSONB là chỗ bạn cố ý phá chuẩn hoá; đọc lại để biết mình đánh đổi gì.
11. Tóm tắt
- Chọn nhanh: field query theo nội dung → JSONB; blob không bao giờ đọc field → TEXT hoặc BYTEA; cần giữ byte-exact và vẫn muốn validate → JSON (hiếm).
- Kiểm tra dedupe bằng
SELECT '{"a":1,"a":2}'::jsonb(ra{"a": 2}); JSON giữ cả hai cặp nhưng->>'a'cũng trả giá trị cuối. - Đo phần dư kích thước của JSONB bằng
pg_column_size(col)trên dữ liệu thật thay vì tin con số phần trăm. - Dấu hiệu dùng sai JSONB: một key có ở gần 100% row, xuất hiện trong WHERE/JOIN thường xuyên, hoặc cần FK. Đó là column.
12. Tự kiểm tra
- Q1Tại sao JSONB mất whitespace và key order nhưng lại được coi là 'tốt hơn' JSON? Có trường hợp nào việc mất key order là vấn đề nghiêm trọng không?
- Q2JSON và JSONB xử lý key trùng như thế nào? Nếu client gửi `{"role": "admin", "role": "viewer"}`, rủi ro thật nằm ở đâu và chặn ở đâu?
- Q3TaskFlow có column `tasks.status TEXT CHECK (status IN ('todo', 'doing', 'done'))`. Tại sao không nên chuyển status vào task_metadata JSONB? Khi nào nên làm ngược lại, extract field từ JSONB ra column?
- Q4Giải thích tại sao GIN index chỉ hoạt động với JSONB mà không phải JSON hoặc TEXT. GIN lưu gì bên trong?
- Q5Trong hai use case Applied (custom field multi-tenant, audit log), use case nào thật sự cần JSONB thay vì schema cứng? Webhook payload thì sao?
Bài tiếp theo: JSONB operators & JSONPath — ->, ->>, @>, ?, jsonb_path_query
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên