Mini-challenge — TaskFlow advanced search: FTS + JSONB + pgvector
Dựng search box TaskFlow gộp 3 index (GIN FTS, GIN JSONB, B-tree due_at) trong một query, thêm pgvector similarity và hybrid rerank thủ công.
TaskFlow vừa nhận yêu cầu từ enterprise customer: search box phải hỗ trợ 3 chiều cùng lúc: keyword tìm trong nội dung task (có dấu hoặc không dấu), filter theo label như urgent hay backend, và lọc theo deadline trong 7 ngày tới. Query phải đi index ở cả ba chiều, không Seq Scan.
Đây là bài cuối module này. Nó tổng hợp mọi thứ đã học: JSONB operators, GIN index, FTS tiếng Việt với unaccent, và pgvector HNSW. Mục tiêu: một file SQL hoàn chỉnh, copy-paste-ready, với EXPLAIN output chứng minh cả ba index cùng được dùng trong một query.
Trước khi đọc lời giải từng bước, hãy thử tự viết: (1) DDL thêm cột body_tsv generated và embedding; (2) bốn index cho FTS, JSONB, due_at, embedding; (3) một query lọc đồng thời keyword "deploy", label urgent, due_at trong 7 ngày tới, mỗi điều kiện dùng operator mà index tương ứng hỗ trợ, rồi tự chạy EXPLAIN và mô tả planner làm gì. Mỗi step dưới có phần lời giải bọc lại để bạn so.
Setup — extension + schema extend
Bắt đầu từ TaskFlow canonical schema. Extension và FTS config cần tạo trước:
-- =====================================================
-- Extension setup (chay mot lan)
-- =====================================================
CREATE EXTENSION IF NOT EXISTS unaccent;
CREATE EXTENSION IF NOT EXISTS pg_trgm;
CREATE EXTENSION IF NOT EXISTS vector;

-- Vietnamese FTS config: copy simple, add unaccent mapping (see lesson 05)
-- CREATE TEXT SEARCH CONFIGURATION has no IF NOT EXISTS -> guard by DO block
DO $$
BEGIN
  IF NOT EXISTS (SELECT 1 FROM pg_ts_config WHERE cfgname = 'vietnamese') THEN
    CREATE TEXT SEARCH CONFIGURATION vietnamese (COPY = simple);
    ALTER TEXT SEARCH CONFIGURATION vietnamese
      ALTER MAPPING FOR hword, hword_part, word
      WITH unaccent, simple;
  END IF;
END $$;
Extend bảng tasks với 4 column mới: body, task_metadata JSONB, body_tsv generated tsvector, và embedding vector:
-- =====================================================
-- Extend tasks table (chay mot lan, idempotent)
-- =====================================================
ALTER TABLE tasks ADD COLUMN IF NOT EXISTS body          TEXT;
ALTER TABLE tasks ADD COLUMN IF NOT EXISTS task_metadata JSONB NOT NULL DEFAULT '{}';

-- Generated column: tu dong cap nhat khi title/body thay doi
ALTER TABLE tasks ADD COLUMN IF NOT EXISTS body_tsv tsvector
  GENERATED ALWAYS AS (
    to_tsvector('vietnamese',
      coalesce(title, '') || ' ' || coalesce(body, ''))
  ) STORED;

-- pgvector: 1536 dims cho text-embedding-3-small
-- NULL ban dau -- backfill tu external script (Step 5)
ALTER TABLE tasks ADD COLUMN IF NOT EXISTS embedding vector(1536);
Tại sao GENERATED ALWAYS AS ... STORED? PostgreSQL tự tính lại column này mỗi khi title hoặc body thay đổi, không cần trigger hay app code. STORED nghĩa là giá trị nằm trên disk, nên GIN index được trực tiếp trên column; PostgreSQL 18 có thêm generated column VIRTUAL nhưng loại đó không index được.
Step 1 — Generate sample dataset
Seed 100.000 task với title tiếng Việt realistic, task_metadata JSONB chứa labels array, và due_at trải trong 30 ngày tới:
-- =====================================================
-- Seed: 100k task voi title VN + metadata
-- Mat khoang 30-60 giay
-- =====================================================
INSERT INTO tasks (
  project_id, assignee_id, title, body,
  status, due_at, task_metadata, created_at, updated_at
)
SELECT
  (random() * 10 + 1)::int,               -- project_id 1-10
  (random() * 20 + 1)::int,               -- assignee_id 1-20

  -- Title tieng Viet diverse
  (ARRAY[
    'Trien khai feature thanh toan ' || gs,
    'Sua loi dang nhap nguoi dung ' || gs,
    'Toi uu toc do truy van ' || gs,
    'Viet unit test cho module gio hang ' || gs,
    'Review code pull request ' || gs,
    'Cap nhat tai lieu API ' || gs,
    'Fix payment gateway timeout ' || gs,
    'Deploy len moi truong staging ' || gs,
    'Kiem tra bao mat endpoint ' || gs,
    'Khac phuc loi xuat hoa don ' || gs,
    'Tich hop webhook thanh toan ' || gs,
    'Refactor service xu ly don hang ' || gs,
    'Monitor latency sau deploy ' || gs,
    'Cau hinh alert cho loi 5xx ' || gs,
    'Migrate du lieu sang schema moi ' || gs
  ])[floor(random() * 15) + 1],

  -- Body mo ta chi tiet hon
  (ARRAY[
    'Can kiem tra flow thanh toan end-to-end truoc khi len prod.',
    'Nguoi dung bao cao loi khi dang nhap bang Google OAuth.',
    'Query dashboard chay 3 giay, can them index phu hop.',
    'Stripe webhook tra ve 500 trong 2 phan tram request.',
    'Sau deploy 14h, p99 latency tang tu 120ms len 450ms.'
  ])[floor(random() * 5) + 1],

  -- Status: mot random() duy nhat (r) cho ca CASE, neu goi random() moi nhanh
  -- thi phan bo lech (~45/41/13/1 thay vi 45/30/20/5)
  (ARRAY['todo','doing','done','archived'])[
    CASE
      WHEN r < 0.45 THEN 1   -- 45% todo
      WHEN r < 0.75 THEN 2   -- 30% doing
      WHEN r < 0.95 THEN 3   -- 20% done
      ELSE 4                 -- 5% archived
    END
  ],

  -- due_at: -8..+32 ngay -> 20% da qua han, 80% trong ~30 ngay toi
  now() + ((random() * 40 - 8) * interval '1 day'),

  -- task_metadata JSONB: labels + priority + source
  jsonb_build_object(
    'labels', (
      CASE floor(random() * 8)::int
        WHEN 0 THEN '["urgent","backend"]'::jsonb
        WHEN 1 THEN '["urgent","frontend"]'::jsonb
        WHEN 2 THEN '["backend","performance"]'::jsonb
        WHEN 3 THEN '["frontend","ui"]'::jsonb
        WHEN 4 THEN '["urgent","security"]'::jsonb
        WHEN 5 THEN '["backend","migration"]'::jsonb
        WHEN 6 THEN '["devops","deployment"]'::jsonb
        ELSE        '["testing"]'::jsonb
      END
    ),
    'priority', (ARRAY['low','medium','high','critical'])[floor(random() * 4) + 1],
    'source',   (ARRAY['jira','linear','internal'])[floor(random() * 3) + 1]
  ),

  now() - (random() * interval '60 days'),
  now() - (random() * interval '30 days')
FROM generate_series(1, 100000) gs
CROSS JOIN LATERAL (SELECT random() AS r) x;   -- r moi cho moi row

-- Verify
SELECT status, count(*) FROM tasks GROUP BY status ORDER BY count(*) DESC;
-- Expected: todo ~45k, doing ~30k, done ~20k, archived ~5k

SELECT count(*) FROM tasks WHERE task_metadata @> '{"labels":["urgent"]}';
-- Expected: ~37.5k (3 trong 8 nhanh label deu co 'urgent' -> 37.5% cua 100k)
Sau khi insert xong, chạy ANALYZE để planner có statistics chính xác:
ANALYZE tasks;
Step 2 — 3 index GIN/B-tree + 1 HNSW
Tạo 4 index: GIN trên body_tsv (FTS), GIN trên task_metadata (JSONB), B-tree trên due_at, và HNSW trên embedding:
-- =====================================================
-- Index 1: GIN cho FTS (body_tsv generated column)
-- =====================================================
CREATE INDEX IF NOT EXISTS idx_tasks_body_tsv
  ON tasks USING gin(body_tsv);

-- =====================================================
-- Index 2: GIN jsonb_path_ops cho JSONB containment
-- jsonb_path_ops chi ho tro @> (containment) nhung nho hon
-- va nhanh hon gin_default_ops cho pattern nay
-- =====================================================
CREATE INDEX IF NOT EXISTS idx_tasks_metadata
  ON tasks USING gin(task_metadata jsonb_path_ops);

-- =====================================================
-- Index 3: B-tree cho due_at range filter
-- =====================================================
CREATE INDEX IF NOT EXISTS idx_tasks_due_at
  ON tasks(due_at);

-- =====================================================
-- Index 4: HNSW cho pgvector cosine similarity
-- m=16, ef_construction=64 la default production-safe
-- =====================================================
CREATE INDEX IF NOT EXISTS idx_tasks_embedding
  ON tasks USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);
Tại sao jsonb_path_ops thay vì default? Nó hash cả đường dẫn key + value thành một entry thay vì tách key và value riêng, nên index nhỏ hơn và @> là một lần tra. Trade-off: không hỗ trợ ?, ?|, ?& (hỏi key). Query của bài chỉ dùng @> nên đây là lựa chọn đúng.
Kiểm tra index đã được tạo:
SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = 'tasks'
  AND indexname LIKE 'idx_tasks_%'
ORDER BY indexname;
Step 3 — Composite query: 3 điều kiện, 3 index
Query kết hợp 3 điều kiện: FTS với unaccent (keyword "deploy", có dấu hay không dấu đều match), JSONB containment filter label "urgent", và B-tree range filter due_at trong 7 ngày tới.
Viết query trả về id, title, due_at, priority, snippet có highlight và rank, với đúng 3 điều kiện trên, mỗi điều kiện dùng đúng operator mà index tương ứng hỗ trợ (@@ cho tsvector, @> cho JSONB, BETWEEN cho due_at). Gợi ý: đặt websearch_to_tsquery(...) vào FROM để dùng lại ở cả WHERE lẫn SELECT.
-- =====================================================
-- Composite search query: 3 dieu kien, 3 index
-- $keyword: tu tim kiem (co dau/khong dau deu match)
-- =====================================================

SELECT
  id,
  title,
  status,
  due_at,
  task_metadata ->> 'priority'             AS priority,
  task_metadata -> 'labels'                AS labels,
  ts_headline(
    'vietnamese',
    body,
    websearch_to_tsquery('vietnamese', 'deploy'),
    'MaxWords=20, MinWords=5, StartSel=**, StopSel=**'
  )                                        AS snippet,
  ts_rank(body_tsv,
    websearch_to_tsquery('vietnamese', 'deploy'))
                                           AS rank
FROM tasks,
     websearch_to_tsquery('vietnamese', 'deploy') query
WHERE task_metadata @> '{"labels":["urgent"]}'
  AND body_tsv @@ query
  AND due_at BETWEEN now() AND now() + INTERVAL '7 days'
ORDER BY rank DESC, due_at ASC
LIMIT 20;
FROM tasks, websearch_to_tsquery(...) query là implicit cross join với một row scalar, cho phép dùng lại query ở cả WHERE lẫn SELECT mà không viết lại websearch_to_tsquery. Pattern này giống CROSS JOIN total_tasks trong bài burndown chart của khoá SQL & Database.
websearch_to_tsquery thay vì to_tsquery vì nó accept input tự do từ user — không ném exception khi user gõ "deploy +feature" hay dấu ngoặc. Với tiếng Việt đã có unaccent trong config vietnamese, "trien khai" sẽ match "triển khai".
ts_headline generate snippet với từ match được highlight — chuỗi trả về là plain text (StartSel/StopSel dùng ** như Markdown bold), app frontend có thể render trực tiếp.
Step 4 — EXPLAIN: planner gộp 3 index thế nào?
Trước khi chạy, hãy đoán: planner sẽ chọn một index selective nhất rồi lọc phần còn lại trên heap, hay dùng cả ba index? Và node nào gộp chúng?
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  id, title, due_at,
  ts_rank(body_tsv,
    websearch_to_tsquery('vietnamese', 'deploy')) AS rank
FROM tasks,
     websearch_to_tsquery('vietnamese', 'deploy') query
WHERE task_metadata @> '{"labels":["urgent"]}'
  AND body_tsv @@ query
  AND due_at BETWEEN now() AND now() + INTERVAL '7 days'
ORDER BY rank DESC, due_at ASC
LIMIT 20;
Output tham khảo dưới đây lấy từ một lần chạy với phân bố dữ liệu khác seed ở Step 1, nên số row từng nhánh không khớp seed của bạn; với seed 100k trên, kỳ vọng ba nhánh cỡ ~37,5k (urgent), ~30k (deploy trong title hoặc body) và ~17,5k (due trong 7 ngày), giao lại còn khoảng 2.000 row trước LIMIT. Cấu trúc plan là thứ cần so:
Limit  (cost=2341.89..2341.94 rows=20 width=96)
       (actual time=8.341..8.347 rows=20 loops=1)
  ->  Sort  (cost=2341.89..2342.01 rows=48 width=96)
            (actual time=8.339..8.343 rows=20 loops=1)
        Sort Key: (ts_rank(...)) DESC, due_at
        Sort Method: quicksort  Memory: 28kB
        ->  Bitmap Heap Scan on tasks
              (cost=312.45..2340.34 rows=48 width=96)
              (actual time=3.812..8.201 rows=47 loops=1)
              Recheck Cond: ((task_metadata @> '{"labels":["urgent"]}')
                             AND (body_tsv @@ query)
                             AND (due_at >= now())
                             AND (due_at <= (now() + '7 days'::interval)))
              Heap Blocks: exact=43
              Buffers: shared hit=312 read=28
              ->  BitmapAnd
                    (cost=312.45..312.45 rows=48 width=0)
                    (actual time=3.641..3.641 rows=0 loops=1)
                    ->  Bitmap Index Scan on idx_tasks_metadata
                          (cost=0.00..89.12 rows=2431 width=0)
                          (actual time=0.912..0.912 rows=2413 loops=1)
                          Index Cond: (task_metadata @>
                                       '{"labels":["urgent"]}'::jsonb)
                    ->  Bitmap Index Scan on idx_tasks_body_tsv
                          (cost=0.00..143.21 rows=1892 width=0)
                          (actual time=1.234..1.234 rows=1876 loops=1)
                          Index Cond: (body_tsv @@ query)
                    ->  Bitmap Index Scan on idx_tasks_due_at
                          (cost=0.00..78.34 rows=7124 width=0)
                          (actual time=0.891..0.891 rows=7089 loops=1)
                          Index Cond: ((due_at >= now()) AND
                                       (due_at <= (now() + '7 days')))
Planning Time: 1.423 ms
Execution Time: 8.891 ms
Đọc plan output:
BitmapAnd là node kết hợp 3 Bitmap Index Scan — mỗi index scan tạo ra một bitmap (tập hợp page ID thỏa điều kiện), BitmapAnd lấy giao của 3 bitmap. Chỉ những page chứa row thỏa cả 3 điều kiện mới được fetch từ heap.
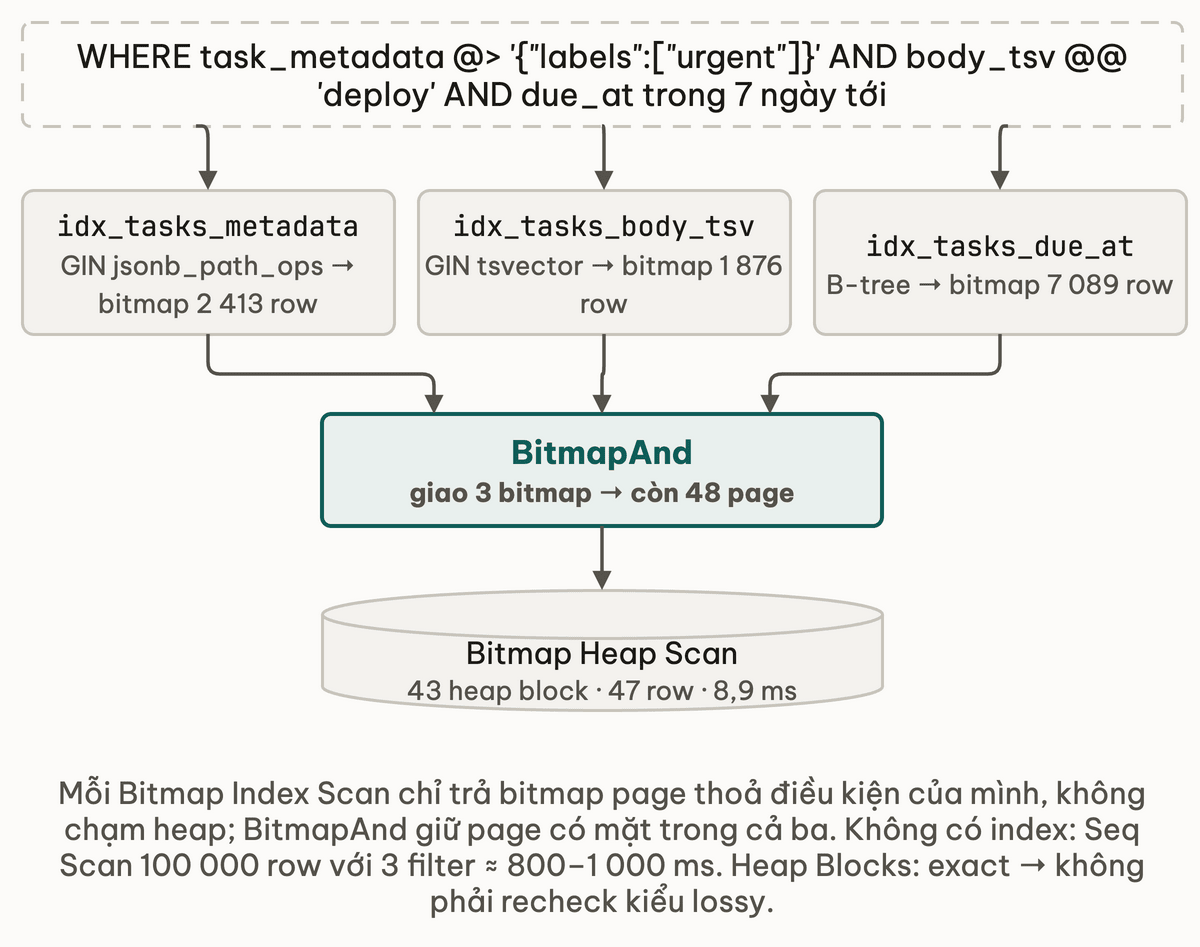
Không có 3 index, planner phải Seq Scan 100k row rồi lọc từng row bằng cả ba điều kiện; với BitmapAnd nó chỉ đọc những heap block còn lại sau phép giao. Hãy chạy hai bản (drop index và có index) trên máy bạn và so Execution Time, đừng tin một hệ số.
Heap Blocks: exact=N nghĩa là bitmap vẫn giữ được vị trí từng tuple. Nếu bitmap vượt work_mem, PostgreSQL nén thành "lossy" (chỉ nhớ page), và Recheck Cond thành bộ lọc thật trên từng row của page đó.
Thử ngẫmgiả sử chỉ có hai trong ba index tồn tại. Planner vẫn dùng BitmapAnd được không, và điều kiện thứ ba đi đâu trong plan?
Step 5 — Vector similarity query
Viết query k-NN: 5 task gần nhất với embedding $1 theo cosine distance, bỏ row chưa có embedding, và chứng minh bằng EXPLAIN rằng HNSW index được dùng. Sau đó thử thêm WHERE project_id = 3 và quan sát số row trả về so với LIMIT.
pgvector cần embedding được tính trước ở app layer, PostgreSQL không gọi OpenAI API trực tiếp. Workflow:
App layer (Python pseudo, backfill):
import openai

def get_embedding(text: str) -> list[float]:
    resp = openai.embeddings.create(
        input=text,
        model="text-embedding-3-small"   # 1536 dims
    )
    return resp.data[0].embedding

# Backfill: tinh embedding cho tasks chua co
def backfill_embeddings(db, batch_size: int = 100):
    while True:
        rows = db.query(
            "SELECT id, title, body FROM tasks "
            "WHERE embedding IS NULL ORDER BY id LIMIT %s",
            (batch_size,)
        )
        if not rows:
            break
        texts = [f"{r.title}. {r.body or ''}" for r in rows]
        resp = openai.embeddings.create(
            input=texts,
            model="text-embedding-3-small"
        )
        for row, emb in zip(rows, resp.data):
            db.execute(
                "UPDATE tasks SET embedding = %s WHERE id = %s",
                (emb.embedding, row.id)
            )
Sau khi có embedding cho query string "fix payment bug" (tính ở app), truyền vào PostgreSQL qua parameterized query:
-- $1 = embedding vector cua query string
-- Vi du: tinh truoc: get_embedding("fix payment bug")
-- -> [0.0234, -0.0156, ..., 0.0892]  (1536 floats)

SELECT
  id,
  title,
  body,
  status,
  embedding <=> $1    AS distance   -- cosine distance: 0=identical, 2=opposite
FROM tasks
WHERE embedding IS NOT NULL
ORDER BY embedding <=> $1
LIMIT 5;

-- Expected results (vi du):
-- id=1423  "Fix payment gateway timeout"          distance=0.0821
-- id=5891  "Khac phuc loi xu ly thanh toan"       distance=0.1034
-- id=2210  "Stripe webhook tra ve 500"            distance=0.1289
-- id=8834  "Tich hop cong thanh toan moi"         distance=0.1534
-- id=3341  "Kiem tra flow checkout end-to-end"    distance=0.1872
Kiểm tra EXPLAIN — phải thấy HNSW Index Scan, không phải Seq Scan:
EXPLAIN ANALYZE
SELECT id, title, embedding <=> $1 AS distance
FROM tasks
WHERE embedding IS NOT NULL
ORDER BY embedding <=> $1
LIMIT 5;
Limit  (cost=0.01..0.26 rows=5 width=40)
       (actual time=12.341..12.398 rows=5 loops=1)
  ->  Index Scan using idx_tasks_embedding on tasks
        (cost=0.01..4123.45 rows=79845 width=40)
        (actual time=12.339..12.394 rows=5 loops=1)
        Order By: (embedding <=> $1)
        Filter: (embedding IS NOT NULL)
Execution Time: 12.543 ms
-- Expected: 10-30ms cho 100k vector co embedding
-- ANN (approximate): HNSW co the bo sot mot it result o bien
-- ef_search mac dinh 40, tang len 100 cho recall tot hon
<=> là cosine distance operator (bài 06). HNSW Index Scan không quét tuần tự mà duyệt graph nhiều tầng để tìm approximate nearest neighbors. Nhớ giới hạn của bài 06: thêm WHERE project_id = $2 thì filter chạy sau khi index trả ef_search ứng viên, nên có thể nhận ít hơn 5 row; tăng hnsw.ef_search hoặc bật hnsw.iterative_scan (pgvector 0.8.0+).
Bonus — Hybrid search rerank manual
Combine FTS top-50 và vector top-50 với weighted score — lấy top 10 hybrid. Pattern này giải quyết limitation của từng approach: FTS miss semantic match, vector miss exact keyword match:
-- $1 = embedding vector cua query string (tinh o app layer)
-- $2 = keyword string cho FTS (vi du: 'payment bug')
-- Weight: vector 60%, FTS 40% (dieu chinh theo use case)

WITH fts AS (
  SELECT
    id,
    ts_rank(body_tsv,
      websearch_to_tsquery('vietnamese', $2)) AS fts_score
  FROM tasks
  WHERE body_tsv @@ websearch_to_tsquery('vietnamese', $2)
  ORDER BY fts_score DESC
  LIMIT 50
),

vec AS (
  SELECT
    id,
    1.0 - (embedding <=> $1)   AS vec_score  -- cosine similarity: 1=identical
  FROM tasks
  WHERE embedding IS NOT NULL
  ORDER BY embedding <=> $1
  LIMIT 50
)

SELECT
  t.id,
  t.title,
  t.status,
  t.due_at,
  COALESCE(fts.fts_score,  0) * 0.4
    + COALESCE(vec.vec_score, 0) * 0.6       AS hybrid_score,
  COALESCE(fts.fts_score,  0)                AS fts_score,
  COALESCE(vec.vec_score,  0)                AS vec_score
FROM tasks t
LEFT JOIN fts USING (id)
LEFT JOIN vec USING (id)
WHERE fts.id IS NOT NULL OR vec.id IS NOT NULL
ORDER BY hybrid_score DESC
LIMIT 10;
Tại sao LEFT JOIN thay vì INNER JOIN? Task chỉ có trong FTS top-50 (không có embedding) hoặc chỉ trong vector top-50 (không có FTS match) đều nên xuất hiện trong kết quả. COALESCE(..., 0) cho score 0 khi không có ở một trong hai nhánh — điểm hybrid vẫn tính được từ nhánh còn lại.
Tuning weight: 0.4 / 0.6 là điểm xuất phát phổ biến. Tăng weight FTS khi domain có nhiều jargon kỹ thuật (acronym, tên sản phẩm) mà embedding model không biết. Tăng weight vector khi user query thường là câu ngắn hoặc paraphrase.
Limit 50 cho mỗi nhánh: compromise giữa recall và performance. Tăng lên 100 cho recall tốt hơn nhưng sort + join overhead lớn hơn. Giảm xuống 20 cho performance tốt hơn nhưng có thể miss kết quả tốt.
Thử ngẫmnếu cộng thẳng distance thô embedding <=> $1 vào weighted sum thay vì 1.0 - distance, thứ tự sau ORDER BY ... DESC sai theo hướng nào? Và đổi trọng số sang 0.7 FTS / 0.3 vector thì loại câu tìm kiếm nào đổi hạng nhiều nhất?
Deliverable — full SQL script
Tạo file module9_advanced_search.sql bằng cách ghép theo thứ tự:
- Section A — Setup: DDL extension + FTS config +
ALTER TABLEtừ section "Setup" ở trên. - Section B — Seed: INSERT 100k task từ "Step 1".
- Section C — Index: 4 lệnh
CREATE INDEXtừ "Step 2", thêmANALYZE tasks;sau cùng. - Section D — Queries: composite query (Step 3), EXPLAIN (Step 4), vector query (Step 5), hybrid rerank (Bonus).
Checklist trước khi chạy:
-- Kiem tra extension da duoc cai
SELECT name, installed_version FROM pg_available_extensions
WHERE name IN ('unaccent','pg_trgm','vector');
-- Phai thay ca 3 co installed_version khac NULL

-- Kiem tra 4 index da ton tai
SELECT indexname FROM pg_indexes
WHERE tablename = 'tasks' AND indexname LIKE 'idx_tasks_%'
ORDER BY indexname;
-- Expected: idx_tasks_body_tsv, idx_tasks_due_at,
--           idx_tasks_embedding, idx_tasks_metadata

-- Kiem tra composite query co BitmapAnd
EXPLAIN (ANALYZE, BUFFERS)
SELECT id FROM tasks,
  websearch_to_tsquery('vietnamese', 'deploy') q
WHERE task_metadata @> '{"labels":["urgent"]}'
  AND body_tsv @@ q
  AND due_at BETWEEN now() AND now() + INTERVAL '7 days'
LIMIT 20;
-- Phai thay: BitmapAnd -> 3x Bitmap Index Scan
Bài tiếp theo: Module Scaling, replication & multi-tenant đang được viết. Quay lại trang khoá học để theo dõi, hoặc đọc trước phần nguyên lý ở Single-leader replication ở khoá Dữ liệu phân tán.
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên