Cache line và locality — vì sao truy cập gần nhau lại nhanh
Cache lấy dữ liệu theo khối 64 byte (cache line), không theo từng byte. Hiểu cache line và locality giải thích vì sao duyệt tuần tự nhanh hơn ngẫu nhiên nhiều lần.
TL;DR: Cache không nạp từng byte riêng lẻ — nó luôn nạp cả một cache line (khối 64 byte liền nhau) mỗi lần. Khi bạn đọc một byte, 63 byte hàng xóm cũng được kéo vào cache "miễn phí". Điều này thưởng cho code có locality: temporal locality (dùng lại cùng dữ liệu trong thời gian ngắn) và spatial locality (dùng các dữ liệu nằm gần nhau trong bộ nhớ). Duyệt một mảng tuần tự khai thác tối đa spatial locality — mỗi cache miss kéo về 64 byte dùng được ngay cho 15–16 phần tử kế tiếp. Truy cập ngẫu nhiên thì mỗi lần miss chỉ dùng được 1 trong 64 byte, lãng phí 98% băng thông. Hiểu cache line giải thích vì sao mảng nhanh hơn linked list, vì sao duyệt ma trận theo hàng nhanh hơn theo cột, và là nền tảng cho mọi tối ưu bộ nhớ còn lại.
Bạn có một mảng 1 triệu số và một linked list 1 triệu số, cùng cộng tất cả. Cùng O(n), cùng số phép cộng — nhưng mảng nhanh hơn nhiều lần. Bạn duyệt một ma trận 2D theo hàng rồi theo cột, cùng số phần tử, một bản chậm gấp 5–10 lần. Câu trả lời cho cả hai nằm ở một đơn vị bạn chưa từng khai báo trong code: cache line.
Bài này giải thích cache lấy dữ liệu theo cache line thế nào, hai loại locality, và vì sao bố cục dữ liệu trong bộ nhớ quyết định tốc độ nhiều hơn bạn tưởng.
1. Analogy — mua cả vỉ trứng, không mua từng quả
Khi cần một quả trứng, bạn không ra siêu thị mua đúng một quả rồi về — bạn mua cả vỉ. Lần sau cần trứng, đã có sẵn trong tủ lạnh, khỏi đi lại. Đi siêu thị (truy cập RAM) tốn kém; nên mỗi lần đi, bạn mang về cả khối.
CPU làm y hệt: khi cần 1 byte ở địa chỉ X, nó không nạp 1 byte — nó nạp cả cache line 64 byte chứa X (cả "vỉ"). Nếu sau đó bạn cần byte kế bên (rất thường gặp), nó đã nằm sẵn trong cache. Code dùng nhiều byte trong cùng một "vỉ" trước khi đi mua vỉ khác là code nhanh.
| Mua trứng | Cache |
|---|---|
| Một quả trứng | Một byte |
| Cả vỉ trứng | Một cache line (64 byte) |
| Đi siêu thị | Truy cập RAM (cache miss) |
| Lấy từ tủ lạnh | Truy cập cache (cache hit) |
| Dùng hết vỉ trước khi đi lại | Spatial locality tốt |
| Mua một quả rồi về, lần sau lại đi | Truy cập ngẫu nhiên, lãng phí |
Đơn vị truy cập bộ nhớ của CPU không phải byte, mà là cache line 64 byte. Mỗi cache miss kéo về 64 byte. Code nhanh là code dùng được nhiều byte trong mỗi line trước khi miss line tiếp theo — tức là code có locality cao.
2. Cơ chế — cache line 64 byte
Bộ nhớ được chia ngầm thành các khối 64 byte căn chỉnh (line 0 = byte 0–63, line 1 = byte 64–127, ...). Cache lưu trữ theo đơn vị line này. Khi CPU truy cập một địa chỉ:
- Tính xem địa chỉ thuộc cache line nào.
- Line đó đã trong cache? → hit, trả về byte cần.
- Chưa? → miss: nạp cả 64 byte của line từ RAM (hoặc tầng dưới) vào cache, rồi trả về byte cần. Một line cũ bị đẩy ra (eviction) để nhường chỗ.
Hệ quả then chốt: đọc byte thứ 2, 3, ... trong cùng line gần như miễn phí (đã ở cache). Chi phí thật là lần miss đầu kéo cả line về.
Cache line 64 byte chua mot mang int (4 byte/phan tu):

[ a[0] | a[1] | a[2] | ... | a[15] ]   <- 16 int trong 1 line 64 byte
   ^miss o day -> nap ca line
        ^hit   ^hit  ...    ^hit       <- 15 truy cap sau MIEN PHI
Duyệt mảng int tuần tự: cứ 16 phần tử mới có 1 cache miss (vì 16 × 4 byte = 64 byte = 1 line). Tỉ lệ miss ~1/16. Truy cập 16 phần tử ngẫu nhiên rải khắp bộ nhớ: mỗi phần tử một line khác → 16 miss. Cùng số phần tử, gấp 16 lần số lần đi RAM.
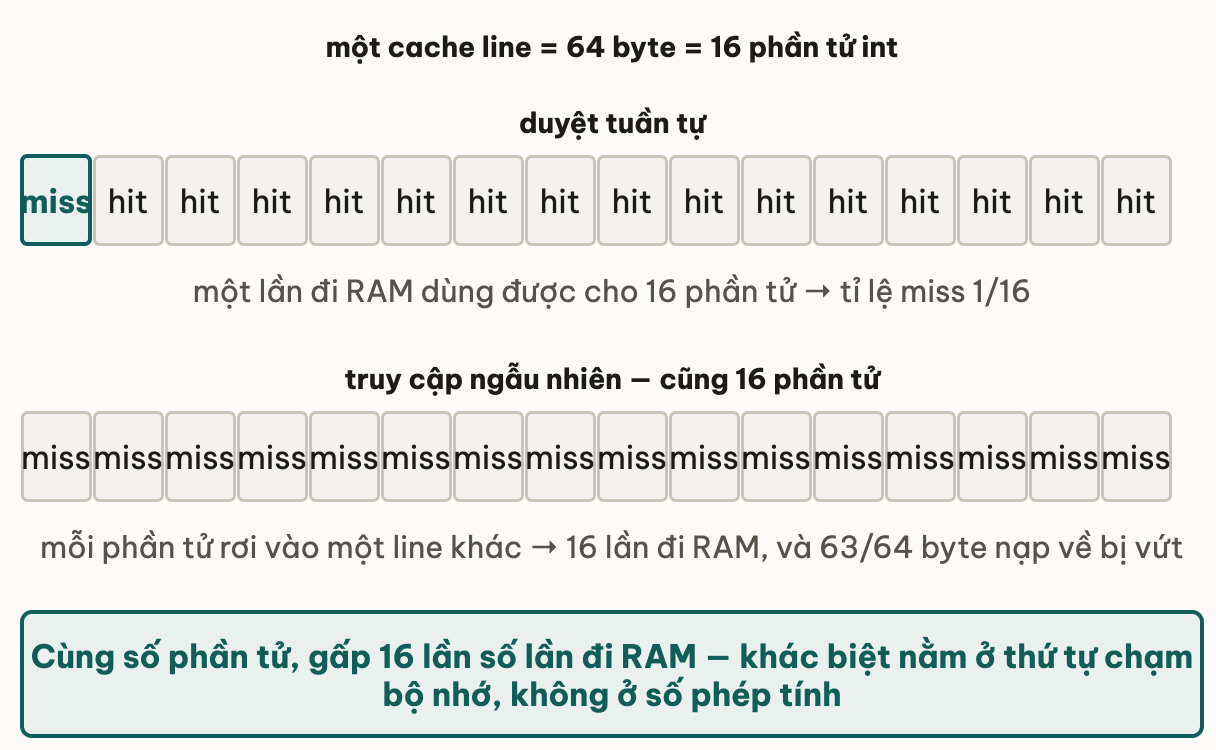
Thử ngẫmmột mảng byte[100] nằm vắt qua ranh giới hai cache line. Đọc phần tử đầu và phần tử cuối mảng có tốn cùng một lần miss không?
3. Hai loại locality
Cache thưởng cho hai kiểu mẫu truy cập:
Temporal locality (locality theo thời gian): nếu bạn vừa dùng một dữ liệu, khả năng cao bạn sẽ dùng lại nó sớm. Cache giữ dữ liệu gần đây, nên lần dùng lại là hit. Ví dụ: biến đếm trong vòng lặp, một bảng tra cứu được hỏi liên tục.
Spatial locality (locality theo không gian): nếu bạn vừa dùng dữ liệu ở địa chỉ X, khả năng cao bạn sẽ dùng dữ liệu gần X (X+1, X+2...). Vì cache nạp cả line, các byte gần X đã sẵn sàng. Ví dụ: duyệt mảng tuần tự, đọc các field của cùng một object.
Temporal (truc THOI GIAN): cung dia chi X duoc cham lai nhieu lan
  t1: doc X    t2: doc Y    t3: doc X    t4: doc Z    t5: doc X
      ^miss                     ^hit (X con trong cache)   ^hit
  -> giu du lieu vua dung -> lan sau hit

Spatial (truc DIA CHI): cac dia chi lien nhau dung trong thoi gian ngan
  doc X, X+1, X+2, ... X+15   (cung mot cache line 64 byte)
      ^miss nap ca line        ^15 truy cap sau deu hit
  -> nap ca khoi lan can -> lan can san sang
// Temporal: 'total' va 'table' duoc dung lai lien tuc -> o cache
long total = 0;
for (int i = 0; i < n; i++) {
    total += table[data[i]];   // total: temporal; table[...]: tuy data
}

// Spatial: duyet tuan tu -> moi line nap ve dung cho 16 phan tu
for (int i = 0; i < n; i++) {
    sum += a[i];               // a[i], a[i+1]... cung line
}
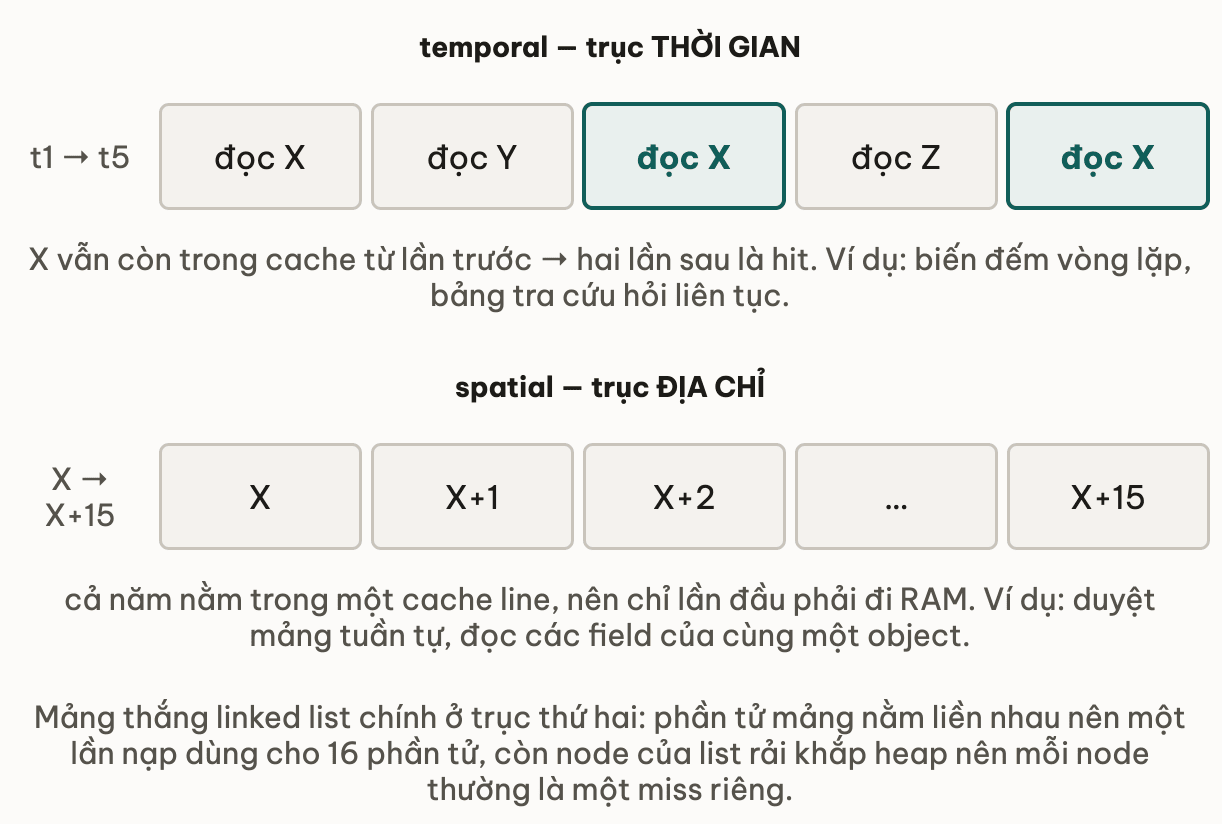
Mảng lưu phần tử liền nhau trong bộ nhớ → spatial locality hoàn hảo: duyệt tuần tự, mỗi cache line dùng cho ~16 phần tử. Linked list lưu mỗi node rải rác trên heap, nối nhau bằng con trỏ → duyệt list là một chuỗi truy cập ngẫu nhiên, mỗi node thường là một cache miss riêng. Dù cả hai là O(n), mảng có thể nhanh hơn nhiều lần chỉ nhờ locality. Đây là lý do ArrayList thường thắng LinkedList trong duyệt và thậm chí chèn/xoá ở thực tế, trái với trực giác big-O. Bài 04 (AoS vs SoA) đẩy ý này xa hơn.
Thử ngẫmmột hàm xử lý event đọc field timestamp của 10.000 object rải trên heap, mỗi object 200 byte nhưng chỉ 8 byte dùng tới. Cache line 64 byte đang phục vụ bạn hay lãng phí cho bạn?
4. Áp dụng vào code của bạn
Locality biến thành quy tắc thực tế về cách bố trí và duyệt dữ liệu.
Duyệt theo thứ tự bộ nhớ, không theo thứ tự logic. Ma trận 2D trong hầu hết ngôn ngữ lưu theo row-major (hàng nối tiếp hàng). Duyệt theo hàng đi tuần tự trong bộ nhớ; duyệt theo cột nhảy cách số_cột × kích_thước byte mỗi bước — phá spatial locality:
// CACHE-FRIENDLY: duyet theo hang (row-major) -> tuan tu
for (int row = 0; row < N; row++)
    for (int col = 0; col < N; col++)
        sum += m[row][col];      // m[row][0], m[row][1]... lien nhau

// CHAM: duyet theo cot -> nhay N phan tu moi buoc, miss lien tuc
for (int col = 0; col < N; col++)
    for (int row = 0; row < N; row++)
        sum += m[row][col];      // m[0][col], m[1][col]... cach xa nhau
Trên ma trận lớn (vượt cache), bản theo cột có thể chậm 5–10 lần dù cùng số phép cộng. Quy tắc: vòng lặp trong cùng nên chạy theo chiều dữ liệu liền nhau trong bộ nhớ.
Gói dữ liệu nóng lại gần nhau. Nếu một vòng lặp chỉ dùng 2 field của một object có 20 field, mỗi cache line vẫn kéo về cả 20 field — phí băng thông cho 18 field không dùng. Tách 2 field nóng ra cấu trúc riêng (hoặc dùng SoA, bài 04) để mỗi line toàn dữ liệu cần.
Ưu tiên cấu trúc liền mạch. Khi duyệt là thao tác chính, chọn mảng/ArrayList thay vì linked list hay cây con trỏ rải rác. Với map, cân nhắc open-addressing (lưu liền) thay vì chaining (con trỏ rải rác) khi locality quan trọng.
Tối ưu locality (đổi thứ tự vòng lặp, tách field, đổi cấu trúc dữ liệu) làm code phức tạp hơn. Với dữ liệu nhỏ (vừa trong cache), khác biệt không đáng kể. Chỉ tối ưu khi: (1) dữ liệu lớn hơn cache, (2) đây là hot path, (3) profiler hoặc đếm cache-miss (perf stat -e cache-misses) xác nhận. Đổi thứ tự hai vòng lặp lồng nhau là tối ưu rẻ và đáng làm; viết lại toàn bộ cấu trúc dữ liệu thì cần bằng chứng.
5. Đào sâu (tuỳ chọn)
Hardware prefetcher: CPU phát hiện mẫu truy cập tuần tự (stride đều) và nạp trước các cache line kế tiếp trước khi bạn yêu cầu — nên duyệt tuần tự gần như không bao giờ phải "chờ" miss sau line đầu. Prefetcher rất giỏi với stride cố định (mảng), nhưng bó tay với truy cập ngẫu nhiên (con trỏ rải rác). Đây là một lý do nữa vì sao mẫu truy cập đoán được (mảng, vòng lặp tuần tự) nhanh hơn nhiều so với chasing con trỏ.
Cache associativity: một line không thể vào bất kỳ chỗ nào trong cache; nó bị ánh xạ vào một tập (set) cố định dựa trên địa chỉ (N-way set associative). Hệ quả: nhiều địa chỉ cách nhau đúng bội số lớn của 2 có thể ánh xạ cùng set và đẩy nhau ra liên tục (cache conflict / thrashing) — đây là lý do mảng có chiều là luỹ thừa của 2 đôi khi chậm bất ngờ, và người ta thêm padding để né.
Cache line 64 byte là quy ước phổ biến trên x86 và ARM hiện đại, nhưng không phổ quát (một số kiến trúc dùng 32 hoặc 128 byte). Truy vấn runtime: sysconf(_SC_LEVEL1_DCACHE_LINESIZE) trên Linux, hoặc đọc /sys/devices/system/cpu/cpu0/cache/. Con số 64 byte sẽ trở lại ở bài 05 (false sharing).
6. Liên hệ các bài khác
- Bài 01 — Vì sao có cache & độ trễ: cache line là cơ chế biến độ trễ RAM (~100 ns) thành chi phí khấu hao thấp khi có locality.
- Bài 03 — Viết code cache-friendly: áp dụng locality một cách hệ thống — kỹ thuật blocking, đổi thứ tự vòng lặp, gói dữ liệu.
- Bài 04 — AoS vs SoA: chọn bố cục dữ liệu để mỗi cache line toàn dữ liệu cần — đẩy spatial locality lên mức thiết kế.
- Bài 05 — False sharing: mặt trái của cache line trong đa luồng — hai luồng ghi cùng một line dù khác biến.
7. Tóm tắt
- Cache nạp dữ liệu theo cache line (64 byte), không theo từng byte. Một cache miss kéo về cả 64 byte.
- Spatial locality: dùng dữ liệu gần nhau → các byte cùng line đã sẵn sàng. Temporal locality: dùng lại dữ liệu gần đây → vẫn còn trong cache.
- Duyệt mảng
inttuần tự: ~1 miss mỗi 16 phần tử. Truy cập ngẫu nhiên: ~1 miss mỗi phần tử — gấp 16 lần số lần đi RAM. - Mảng đánh bại linked list trong duyệt nhờ spatial locality (phần tử liền nhau), dù cùng
O(n). - Duyệt ma trận theo hàng (row-major) nhanh hơn theo cột nhiều lần vì đi tuần tự trong bộ nhớ; vòng lặp trong cùng nên theo chiều dữ liệu liền nhau.
- Prefetcher nạp trước các line khi thấy mẫu tuần tự, nên truy cập đoán được nhanh hơn nhiều truy cập ngẫu nhiên.
- Tối ưu locality đáng làm khi dữ liệu lớn hơn cache, ở hot path, và được profiler/
perfxác nhận.
8. Tự kiểm tra
- Q1Cache nạp dữ liệu theo đơn vị nào? Vì sao điều đó khiến đọc byte thứ hai trong cùng vùng gần như miễn phí?
- Q2Phân biệt temporal locality và spatial locality, mỗi loại cho một ví dụ code.
- Q3Một mảng và một linked list cùng chứa 1 triệu số nguyên, cùng cộng tổng O(n). Vì sao mảng thường nhanh hơn nhiều lần?
- Q4Vì sao duyệt một ma trận 2D theo cột chậm hơn nhiều so với theo hàng, dù cùng số phần tử?
- Q5Một vòng lặp nóng chỉ đọc 2 trong 20 field của mỗi object trong một mảng object lớn. Vì sao điều này lãng phí cache, và hướng sửa là gì?
- Q6Hardware prefetcher giúp truy cập tuần tự thế nào, và vì sao nó không cứu được truy cập theo con trỏ ngẫu nhiên?
Bài tiếp theo: Viết code cache-friendly
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên