AoS vs SoA — bố cục dữ liệu theo cache
Array of structs (AoS) hay struct of arrays (SoA): cùng dữ liệu, hai bố cục bộ nhớ. Khi vòng lặp chỉ dùng vài field, SoA giảm cache miss mạnh. Cách chọn và đo trước-sau.
TL;DR: Cùng một tập dữ liệu có hai cách bố trí trong bộ nhớ. AoS (Array of Structs): mảng các bản ghi, mỗi bản ghi gói đủ field liền nhau — [{x,y,z}, {x,y,z}, ...]. SoA (Struct of Arrays): mỗi field thành một mảng riêng — xs[], ys[], zs[]. Khi vòng lặp nóng chỉ dùng một phần field (ví dụ chỉ x), SoA cho mỗi cache line toàn x dùng được; còn AoS kéo cả y, z vô ích vào line, phí băng thông. SoA cũng mở đường cho SIMD (xử lý nhiều phần tử cùng lúc). Đổi lại, AoS thuận khi bạn dùng cả bản ghi cùng lúc, hoặc thêm/xoá nguyên bản ghi. Đây là một quyết định data-oriented design: tổ chức dữ liệu theo cách nó được truy cập, không theo cách nó "trông gọn gàng" về mặt OOP. Capstone của course sẽ đo trực tiếp chênh lệch này.
Bạn lưu một triệu hạt (particle) trong game vật lý, mỗi hạt có vị trí, vận tốc, màu, khối lượng, id. Vòng lặp cập nhật vật lý mỗi frame chỉ cần vị trí và vận tốc. Lưu chúng kiểu "mảng các object Particle" nghe tự nhiên — nhưng nó khiến mỗi cache line kéo về cả màu, khối lượng, id không dùng. Đổi sang "vài mảng song song, mỗi mảng một field" có thể tăng tốc gấp đôi. Khác biệt không ở thuật toán, mà ở bố cục dữ liệu.
Bài này so sánh AoS và SoA, giải thích vì sao SoA thắng trong vòng lặp dùng ít field, và khi nào AoS vẫn là lựa chọn đúng.
1. Analogy — hồ sơ nhân viên: theo người hay theo cột
Một công ty lưu hồ sơ nhân viên. Hai cách:
- Theo người (AoS): mỗi nhân viên một tập hồ sơ đầy đủ — tên, lương, phòng ban, ngày sinh, ảnh — cất chung một folder. Cần xem hết thông tin một người: tiện, mở một folder là đủ.
- Theo cột (SoA): một danh sách tất cả tên, một danh sách tất cả lương, một danh sách tất cả phòng ban... Cần tính tổng lương cả công ty: chỉ rút đúng danh sách lương, không phải mở từng folder lật qua ảnh và ngày sinh.
Nếu thao tác thường gặp là "duyệt một field qua mọi người" (tính tổng lương, lọc theo phòng), cách theo cột nhanh hơn nhiều. Nếu thao tác là "lấy đủ thông tin một người", cách theo người tiện hơn.
| Hồ sơ nhân viên | Bố cục dữ liệu |
|---|---|
| Folder đầy đủ mỗi người | AoS — array of structs |
| Danh sách riêng từng cột | SoA — struct of arrays |
| Xem hết thông tin một người | Truy cập nhiều field của một phần tử → AoS hợp |
| Tính tổng một cột qua mọi người | Duyệt một field qua mọi phần tử → SoA hợp |
Câu hỏi quyết định: vòng lặp nóng của bạn duyệt nhiều field của một phần tử (→ AoS) hay một field qua nhiều phần tử (→ SoA)? Bố trí dữ liệu theo chiều bạn duyệt nó nhiều nhất.
2. Cơ chế — hai bố cục trong bộ nhớ
Xét một điểm 3D với toạ độ x, y, z (mỗi float 4 byte) và vài field khác.
AoS — mảng các struct, mỗi struct gói đủ field liền nhau:
AoS: [x0 y0 z0 m0][x1 y1 z1 m1][x2 y2 z2 m2]...
      \__struct 0__/\__struct 1__/
Cache line keo ve: x0 y0 z0 m0 x1 y1 z1 ...  (lan du loai field)
SoA — mỗi field một mảng riêng, đặt cạnh chỉ số:
SoA: xs = [x0 x1 x2 x3 x4 ...]   <- toan x, lien nhau
     ys = [y0 y1 y2 y3 y4 ...]
     zs = [z0 z1 z2 z3 z4 ...]
     ms = [m0 m1 m2 m3 m4 ...]
Cache line cua xs keo ve: x0 x1 x2 ... x15  (toan x dung duoc)
Giả sử một vòng lặp chỉ cần x (ví dụ tìm x lớn nhất):
- AoS: mỗi cache line 64 byte chứa ~4 struct (nếu struct 16 byte), nhưng chỉ 4 giá trị
xdùng được — 75% line lày, z, mvô ích. Tỉ lệ dữ liệu hữu ích ~25%. - SoA: cache line của
xschứa 16 giá trịx— 100% dùng được. Tỉ lệ hữu ích 100%, miss ít hơn ~4 lần.
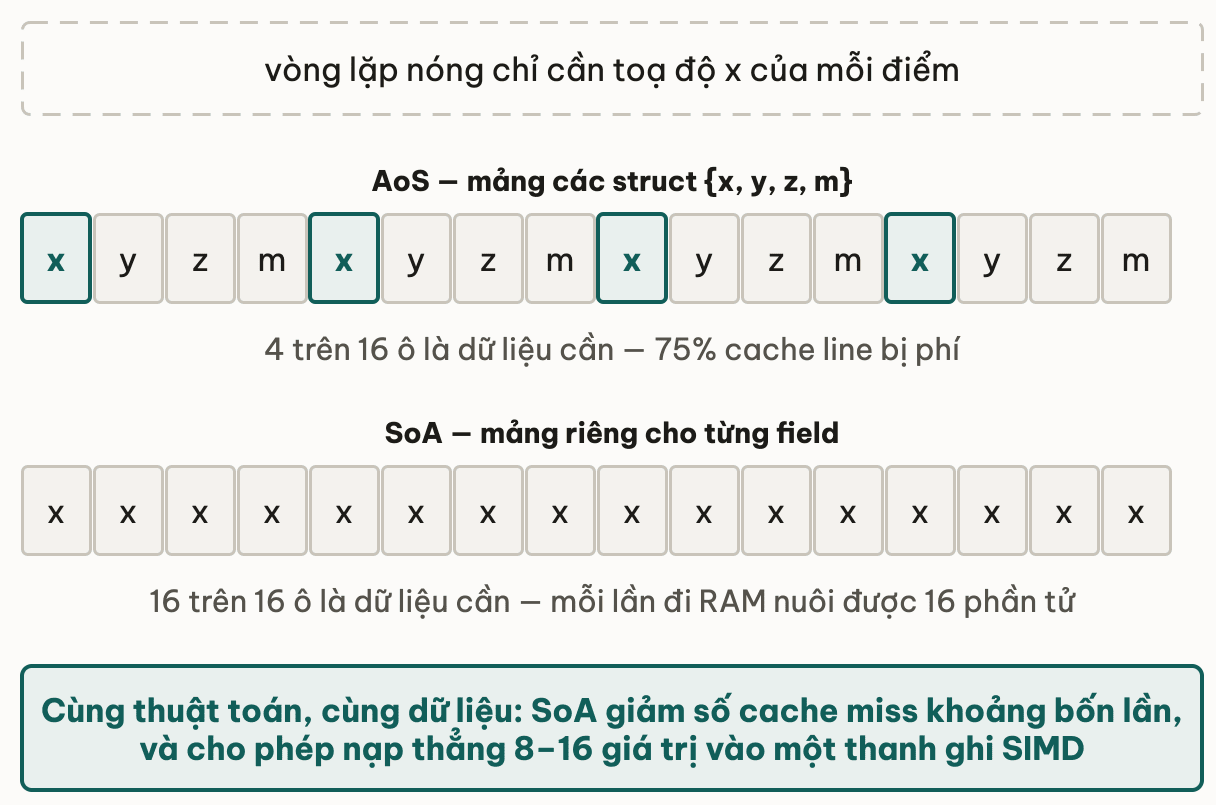
Với dữ liệu lớn hơn cache, chênh lệch tỉ lệ hữu ích chuyển thẳng thành chênh lệch số cache miss, và thành chênh lệch thời gian.
Thử ngẫmmột bảng điểm game có id, score, name, avatar cho 500.000 người chơi. Vòng lặp xếp hạng chỉ cần score — tỉ lệ hữu ích mỗi cache line ở AoS xấp xỉ bao nhiêu?
3. SoA và SIMD
SoA còn một lợi thế thứ hai: nó hợp với SIMD (Single Instruction Multiple Data — một lệnh xử lý nhiều giá trị cùng lúc, ví dụ cộng 8 float trong một lệnh AVX). SIMD cần dữ liệu cùng loại nằm liền nhau để nạp một lúc vào thanh ghi vector. SoA cho đúng điều đó: xs là 16 x liền nhau, nạp thẳng 8–16 cái vào một thanh ghi SIMD và xử lý song song.
AoS thì khó hơn: x nằm cách nhau bởi y, z, m, nên muốn gom 8 x để SIMD phải "gather" rải rác — chậm hoặc bất khả. Đây là lý do code hiệu năng cao (game engine, xử lý tín hiệu, ML) thường dùng SoA cho các vòng lặp nóng.
// SoA: cong delta vao toan bo x bang SIMD (vi du dich chuyen hat theo truc x)
for i = 0; i < n; i += 8:
    vec = simd_load(xs + i)       // nap 8 float x lien nhau tu xs[]
    vec = simd_add(vec, delta8)   // cong 8 gia tri cung mot lenh
    simd_store(xs + i, vec)       // ghi 8 ket qua ve
// AoS khong goi gon vay duoc: 8 x nam cach nhau boi y, z, m -> phai gather
OOP dạy gói dữ liệu liên quan vào một object (Particle có đủ position, velocity, color). Đẹp về mô hình hoá, nhưng không phải lúc nào tối ưu cho cách CPU đọc dữ liệu. Data-oriented design (DOD) đảo lại: tổ chức dữ liệu theo cách nó được xử lý theo lô, không theo "thực thể" khái niệm. Nếu hệ thống vật lý duyệt position+velocity của mọi hạt mỗi frame, thì position và velocity nên là các mảng song song (SoA), bất kể về mặt khái niệm chúng "thuộc về" một hạt. DOD không phủ nhận OOP — nó nhắc rằng bố cục bộ nhớ là một quyết định hiệu năng riêng, tách khỏi mô hình hoá khái niệm.
4. Khi nào AoS, khi nào SoA
Không có cái nào luôn thắng — chọn theo mẫu truy cập:
| Tình huống | Nên dùng | Vì sao |
|---|---|---|
| Vòng lặp dùng ít field qua nhiều phần tử | SoA | Mỗi line toàn field cần, ít miss, hợp SIMD |
| Vòng lặp dùng cả bản ghi cùng lúc | AoS | Các field của một phần tử cùng line, một lần nạp đủ |
| Thêm/xoá nguyên phần tử thường xuyên | AoS | Một thao tác trên một struct; SoA phải sửa mọi mảng |
| Cần SIMD trên một field | SoA | Field liền nhau nạp thẳng vào thanh ghi vector |
| Dữ liệu nhỏ (vừa cache) | Tuỳ tiện | Khác biệt không đáng kể, ưu tiên code rõ |
| Cần truyền/nối tiếp nguyên bản ghi | AoS | Bản ghi liền khối, dễ copy/serialize |
SoA phá tính đóng gói: thay vì một Particle p, bạn thao tác xs[i], ys[i], vs[i] — dễ lệch chỉ số, khó bảo trì, mất an toàn kiểu. Chỉ chuyển sang SoA khi: (1) đây là hot path thật, (2) dữ liệu lớn hơn cache, (3) profiler xác nhận cache miss là bottleneck, (4) speedup đo được biện minh cho độ phức tạp thêm. Nhiều ngôn ngữ/thư viện (ECS trong game, dataframe như pandas/Arrow) cung cấp SoA "đóng gói sẵn" để bạn hưởng lợi mà không tự quản chỉ số.
Thử ngẫmmột reviewer từ chối PR chuyển sang SoA vì "khó đọc hơn", dù benchmark cho thấy nhanh gấp 3 lần. Bạn thuyết phục họ bằng tiêu chí nào trong bốn điều kiện ở trên?
5. Áp dụng vào code của bạn
Quy trình quyết định bố cục:
- Xác định vòng lặp nóng và field nó dùng. Nếu hot loop chạm hầu hết field của mỗi phần tử → AoS giữ nguyên. Nếu nó chỉ chạm 1–2 field qua hàng triệu phần tử → ứng viên SoA.
- Ước lượng tỉ lệ hữu ích. AoS:
kích thước field dùng / kích thước cả struct. Nếu tỉ lệ thấp (dùng 8/64 byte = 12%), SoA có thể tăng tốc tới ~8 lần ở phần chờ bộ nhớ. - Cân nhắc chi phí bảo trì. SoA phức tạp hoá code; chỉ nhận nếu speedup đáng. Cân nhắc dùng thư viện SoA sẵn (ECS, columnar store) thay vì tự quản mảng song song.
- Đo trước-sau. Viết cả hai bản, benchmark trên dữ liệu thật kích thước thật, so cache-miss và thời gian. Capstone course này (bài cuối Module 4) cho bạn thực hành đúng quy trình đó.
Một dấu hiệu nhận biết trong thực tế: các hệ thống xử lý dữ liệu cột (columnar database như ClickHouse, định dạng Apache Arrow/Parquet, dataframe) về bản chất là SoA ở quy mô lớn — chúng lưu theo cột chính vì truy vấn phân tích thường quét vài cột qua hàng tỉ dòng, đúng kịch bản SoA thắng.
6. Liên hệ các bài khác
- Bài 02 — Cache line và locality: SoA là cách tối đa hoá tỉ lệ dữ liệu hữu ích trên mỗi cache line — ứng dụng trực tiếp của spatial locality.
- Bài 03 — Viết code cache-friendly: "gói dữ liệu nóng" (kỹ thuật 3) là dạng cơ bản của ý tưởng SoA.
- Bài 05 — False sharing: bố cục dữ liệu cũng ảnh hưởng đa luồng — cách sắp xếp field quyết định hai luồng có tranh cache line không.
- Course 1 — SIMD nhập môn: vì sao SoA mở đường cho xử lý vector song song.
7. Tóm tắt
- AoS (array of structs): mảng bản ghi, mỗi bản ghi gói đủ field liền nhau. SoA (struct of arrays): mỗi field một mảng riêng.
- Vòng lặp dùng ít field qua nhiều phần tử → SoA cho mỗi cache line toàn field cần, giảm miss tới vài lần. Dùng cả bản ghi → AoS hợp hơn.
- SoA còn mở đường cho SIMD: field liền nhau nạp thẳng vào thanh ghi vector, xử lý nhiều phần tử một lệnh.
- Đây là tư duy data-oriented design: bố cục dữ liệu theo cách nó được xử lý theo lô, tách khỏi mô hình hoá khái niệm OOP.
- AoS vẫn thắng khi: dùng cả bản ghi, thêm/xoá nguyên phần tử, hoặc cần serialize cả bản ghi.
- SoA phức tạp hoá code (lệch chỉ số, mất đóng gói) — chỉ chọn khi hot path, dữ liệu lớn hơn cache, và speedup đo được biện minh. Columnar DB và dataframe là SoA ở quy mô lớn.
8. Tự kiểm tra
- Q1Mô tả khác biệt bố cục bộ nhớ giữa AoS và SoA cho một tập điểm 3D (x, y, z).
- Q2Một vòng lặp chỉ đọc field x của một triệu điểm. Vì sao SoA giảm cache miss so với AoS, và giảm khoảng bao nhiêu?
- Q3Vì sao SoA hợp với SIMD còn AoS thì khó?
- Q4Nêu hai tình huống AoS là lựa chọn đúng hơn SoA.
- Q5Columnar database (ClickHouse) và định dạng Apache Arrow lưu dữ liệu theo cột. Liên hệ điều này với AoS/SoA và giải thích vì sao nó hợp cho truy vấn phân tích.
Bài tiếp theo: False sharing & cache coherence
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên