False sharing — khi hai luồng vô tình tranh một cache line
Hai luồng ghi vào hai biến khác nhau nhưng cùng một cache line vẫn làm chậm nhau, vì cache coherence buộc đồng bộ cả line. Cách phát hiện và sửa bằng padding.
TL;DR: Trong code đa luồng, hai luồng ghi vào hai biến khác nhau tưởng là độc lập — nhưng nếu hai biến đó nằm cùng một cache line 64 byte, chúng vô tình tranh nhau. Mỗi lần một luồng ghi biến của nó, giao thức cache coherence (giữ cache các nhân nhất quán) buộc vô hiệu hoá bản sao line đó ở cache của nhân kia — dù nhân kia chỉ quan tâm biến khác trong cùng line. Hai luồng liên tục "giật" cache line qua lại, mỗi lần tốn hàng chục đến trăm chu kỳ. Đây là false sharing: không chia sẻ dữ liệu logic, nhưng chia sẻ cache line vật lý. Nó làm code song song chậm hơn code tuần tự dù không có lỗi logic nào. Cách sửa: padding — đệm để mỗi biến nóng của mỗi luồng nằm trên cache line riêng.
Bạn viết một bộ đếm song song: mỗi luồng tăng một phần tử riêng của mảng counters[threadId], không luồng nào chạm phần tử của luồng khác — đúng nghĩa "không chia sẻ". Nhưng chương trình 8 luồng lại chậm hơn 1 luồng. Không có lock, không có race condition, không có bug logic. Thủ phạm là một thứ vô hình: 8 phần tử counters[0..7] nằm gọn trong cùng một cache line, và 8 nhân CPU đang giành giật line đó.
Bài này giải thích cache coherence buộc các nhân đồng bộ thế nào, vì sao false sharing phát sinh, cách phát hiện và sửa nó.
1. Analogy — một cuốn sổ chung chuyền tay
Tưởng tượng tám kế toán, mỗi người phụ trách một cột số trong cùng một cuốn sổ. Mỗi người chỉ ghi cột của mình — không ai sửa cột người khác. Nghe như họ làm việc độc lập.
Nhưng chỉ có một cuốn sổ vật lý. Quy tắc văn phòng: ai muốn ghi phải cầm cuốn sổ trên tay, và chỉ một người được cầm tại một thời điểm (để không ai ghi đè bản cũ). Kết quả: kế toán 1 cầm sổ ghi cột 1, kế toán 2 phải chờ lấy sổ để ghi cột 2, rồi kế toán 1 lại đòi sổ về... Cuốn sổ chuyền tay liên tục. Dù mỗi người ghi cột riêng, vật mang dữ liệu dùng chung khiến họ chặn nhau.
| Văn phòng kế toán | CPU đa nhân |
|---|---|
| Một kế toán | Một nhân (core) |
| Cột số riêng mỗi người | Biến riêng mỗi luồng |
| Cuốn sổ vật lý | Cache line 64 byte |
| Chỉ một người cầm sổ lúc ghi | Chỉ một nhân giữ line ở trạng thái ghi |
| Sổ chuyền tay liên tục | Cache line "ping-pong" giữa các nhân |
False sharing = "không chia sẻ dữ liệu, nhưng chia sẻ cache line". Hai biến độc lập về mặt logic nhưng nằm cùng một line 64 byte sẽ kéo nhau chậm lại, vì cache coherence đồng bộ theo cả line, không theo từng byte.
2. Cơ chế — cache coherence và ping-pong line
CPU đa nhân: mỗi nhân có cache L1/L2 riêng. Nếu hai nhân cùng giữ bản sao một cache line và một nhân ghi, bản sao ở nhân kia trở nên cũ. Giao thức cache coherence (phổ biến là MESI) đảm bảo không nhân nào đọc dữ liệu cũ: khi một nhân muốn ghi vào một line, nó phải giành quyền sở hữu độc quyền line đó, và vô hiệu hoá (invalidate) bản sao ở mọi nhân khác.
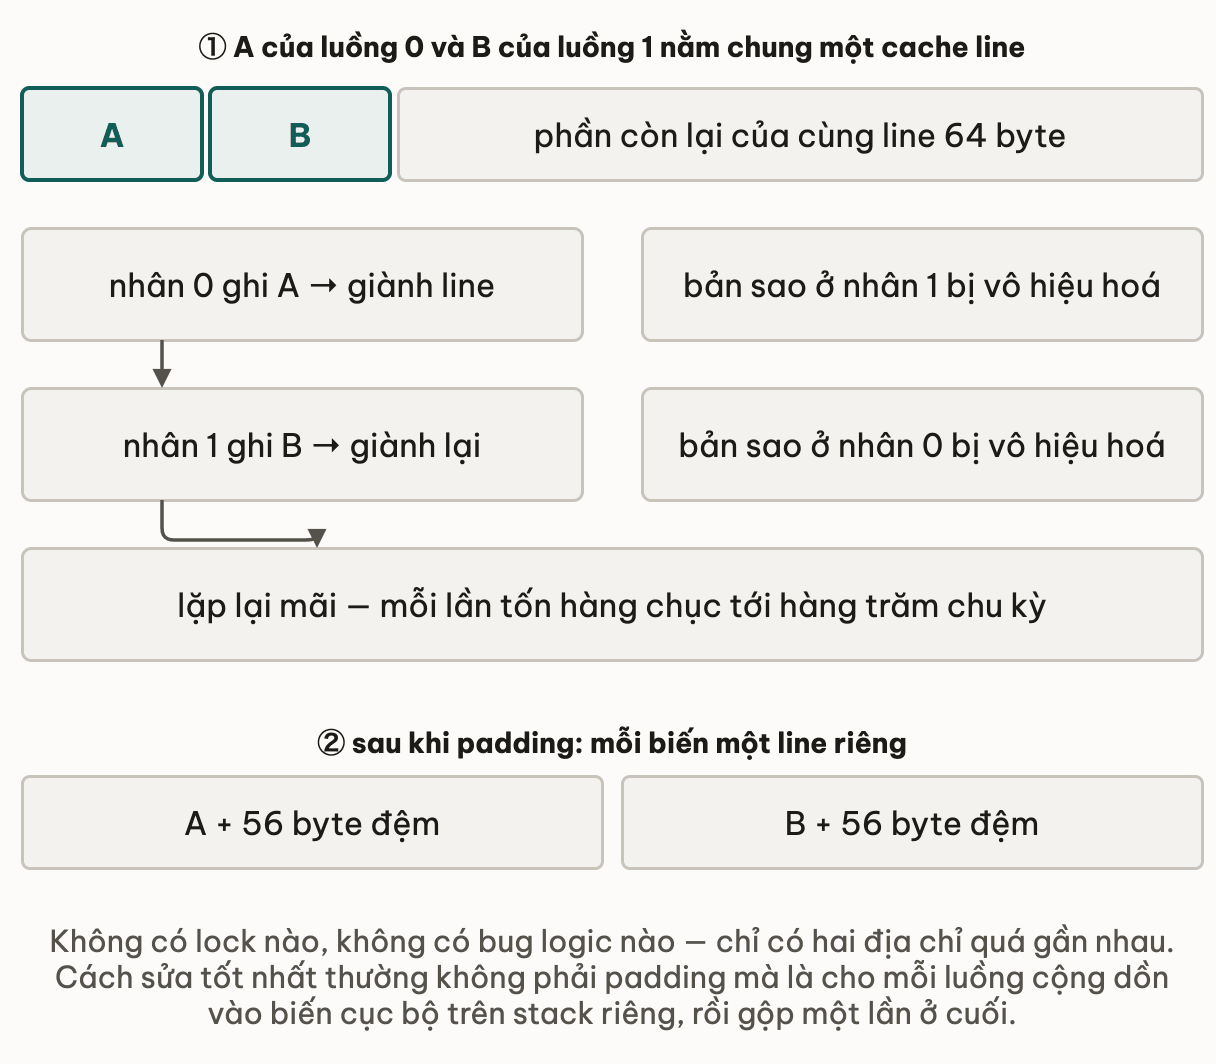
Mấu chốt: coherence làm việc theo đơn vị cache line, không theo từng biến. Nên khi nhân 0 ghi biến A và nhân 1 ghi biến B, nếu A và B cùng line, mỗi lần ghi buộc invalidate line ở nhân kia — dù nhân kia không hề quan tâm biến vừa bị ghi.
Cache line 64 byte:  [ A | B | ... ]   A cua luong 0, B cua luong 1

Nhan 0 ghi A -> gianh line, invalidate ban sao o nhan 1
Nhan 1 ghi B -> gianh lai line, invalidate ban sao o nhan 0
Nhan 0 ghi A -> gianh lai...   <- line "ping-pong" qua lai mai
Mỗi lần giành line giữa các nhân tốn hàng chục đến hàng trăm chu kỳ (phải đi qua cache chung L3 hoặc liên kết giữa các nhân). Vòng lặp nóng ghi liên tục → hàng triệu lần ping-pong → code song song chậm hơn cả tuần tự.
Thử ngẫmmột class đặt volatile boolean flag ngay cạnh một counter được 4 luồng ghi liên tục. Biến flag đó có nguy cơ gì dù bản thân nó chỉ đọc?
3. Phát hiện và sửa bằng padding
Dấu hiệu false sharing: code song song không tăng tốc (hoặc chậm đi) khi thêm luồng, dù không có lock và mỗi luồng làm việc trên dữ liệu "riêng". Công cụ: perf c2c (Linux) phát hiện cache line bị nhiều nhân tranh; hoặc thử nghiệm — nếu giãn các biến nóng ra xa nhau làm code nhanh hẳn, đó là false sharing.
Cách sửa: padding — đệm để mỗi biến nóng nằm trên cache line riêng (cách nhau ≥ 64 byte):
// SAI: 8 counter trong 1-2 cache line -> false sharing nang
long[] counters = new long[8];          // 8 x 8 byte = 64 byte = 1 line
// moi luong: counters[id]++  -> ping-pong

// DUNG: padding moi counter ra 1 line rieng (8 long = 64 byte cach nhau)
long[] padded = new long[8 * 8];        // 8 slot, moi slot cach 64 byte
// moi luong: padded[id * 8]++  -> moi counter mot line, khong tranh
Trong Java có annotation @Contended tự thêm padding quanh field nóng (JDK 8: bật bằng cờ -XX:-RestrictContended; từ JDK 9+ nó thuộc module jdk.internal.vm.annotation, dùng ngoài JDK cần thêm --add-opens java.base/jdk.internal.vm.annotation=ALL-UNNAMED):
import jdk.internal.vm.annotation.Contended;

class Counter {
    @Contended volatile long value;     // JVM padding ra cache line rieng
}
Padding tốn bộ nhớ (mỗi biến chiếm trọn một line 64 byte thay vì 8 byte) và chỉ đáng cho biến được nhiều luồng ghi đồng thời ở hot path. Padding biến ít dùng hoặc chỉ-đọc là lãng phí. Quy tắc: chỉ áp dụng sau khi xác nhận false sharing thật (qua perf c2c hoặc benchmark), và chỉ cho đúng biến gây tranh chấp. Một dạng dữ liệu hay dính: mảng trạng thái per-thread, counter song song, các field cạnh nhau bị ghi bởi luồng khác nhau.
4. Áp dụng vào code của bạn
False sharing là cái bẫy hiệu năng đa luồng phổ biến mà không hiện thành bug logic. Vài nguyên tắc:
Cho mỗi luồng dữ liệu riêng thật sự cách xa nhau. Đừng để các biến per-thread nằm liền trong một mảng. Hoặc tốt hơn: mỗi luồng tích luỹ vào biến cục bộ (trên stack của nó), chỉ gộp kết quả một lần ở cuối — biến cục bộ ở các stack khác nhau, không thể false-share:
// TOT NHAT: moi luong tich luy cuc bo, gop cuoi cung
long localSum = 0;                       // tren stack rieng moi luong
for (int i = start; i < end; i++) localSum += data[i];
results[threadId] = localSum;            // ghi mot lan duy nhat o cuoi
Cảnh giác field cạnh nhau bị các luồng khác nhau ghi. Một object có head (luồng producer ghi) và tail (luồng consumer ghi) cạnh nhau dễ false-share — đây là vấn đề kinh điển trong hàng đợi lock-free (ví dụ Disruptor của LMAX padding các con trỏ này).
Hiểu rằng đây là mặt trái của bố cục dữ liệu. Bài 02–04 dạy gói dữ liệu lại gần nhau để tăng locality. False sharing là trường hợp bạn cần làm ngược lại: tách dữ liệu của các luồng ra xa. Cùng một sự thật cache line 64 byte, hai hệ quả đối nghịch tuỳ ngữ cảnh đơn/đa luồng.
5. Đào sâu (tuỳ chọn)
Giao thức MESI: mỗi cache line ở một nhân mang một trong bốn trạng thái — Modified (đã sửa, độc quyền, khác RAM), Exclusive (độc quyền, giống RAM), Shared (nhiều nhân cùng giữ, chỉ đọc), Invalid (cũ, không dùng). Ghi vào line Shared buộc chuyển nó sang Modified và đẩy mọi bản sao khác sang Invalid (đây chính là invalidate gây false sharing). Đọc một line Invalid buộc lấy lại bản mới từ nhân đang giữ Modified. Các biến thể MESIF (Intel) và MOESI (AMD) thêm trạng thái để giảm lưu lượng. Bạn sẽ gặp lại coherence khi học memory ordering và lock-free ở Course 3 (đồng bộ) và java-internals (JMM).
NUMA (Non-Uniform Memory Access): trên server nhiều socket, mỗi socket có RAM "gần" riêng; truy cập RAM của socket khác chậm hơn (qua liên kết liên socket như QPI/UPI). Hệ quả: không chỉ cache line tranh chấp tốn kém, mà cả việc một luồng truy cập bộ nhớ cấp phát ở socket khác cũng chậm. Tối ưu NUMA (gắn luồng với socket chứa dữ liệu nó dùng — NUMA affinity) là chủ đề nâng cao cho dịch vụ hiệu năng cao; Course 3 chạm tới khi nói về scheduling.
Coherence không phải consistency: cache coherence đảm bảo mọi nhân cuối cùng thấy cùng giá trị cho một địa chỉ. Nó không đảm bảo thứ tự các thao tác trên nhiều địa chỉ được thấy nhất quán giữa các nhân — đó là memory consistency/ordering, cần memory barrier và là gốc của nhiều bug đa luồng tinh vi. Phân biệt hai khái niệm này quan trọng; Course 3 đào sâu.
6. Liên hệ các bài khác
- Bài 02 — Cache line và locality: false sharing là mặt trái của cùng sự thật cache line 64 byte — đơn luồng muốn gói gần, đa luồng cần tách xa.
- Bài 04 — AoS vs SoA: bố cục field quyết định hai luồng có vô tình chung line không; padding là một quyết định bố cục.
- Module 1 — Stack vs heap vs static: biến cục bộ trên stack riêng mỗi luồng nên miễn nhiễm false sharing — lý do "tích luỹ cục bộ rồi gộp" là cách sửa tốt nhất.
- Course 3 — Đồng thời & đồng bộ: cache coherence, memory ordering và lock-free là chủ đề trung tâm ở đó.
7. Tóm tắt
- False sharing: hai luồng ghi hai biến khác nhau nhưng cùng một cache line vẫn làm chậm nhau, dù không chia sẻ dữ liệu logic và không có bug.
- Cache coherence (MESI) giữ cache các nhân nhất quán theo đơn vị cache line: một nhân ghi line buộc invalidate bản sao ở nhân khác.
- Khi hai biến nóng của hai luồng cùng line, line ping-pong qua lại giữa các nhân, mỗi lần tốn hàng chục–trăm chu kỳ → song song chậm hơn tuần tự.
- Phát hiện: code song song không nhanh lên khi thêm luồng dù không có lock; xác nhận bằng
perf c2choặc thử giãn biến. - Sửa: padding cho mỗi biến nóng một cache line riêng (
@Contendedtrong Java), hoặc tốt hơn — mỗi luồng tích luỹ vào biến cục bộ rồi gộp một lần ở cuối. - Đây là mặt trái của locality: gói gần tốt cho đơn luồng, nhưng dữ liệu ghi bởi các luồng khác nhau cần tách xa.
8. Tự kiểm tra
- Q1False sharing là gì? Vì sao nó làm chậm dù không có race condition hay lock?
- Q2Một mảng counters[8], mỗi luồng tăng phần tử riêng của mình, không luồng nào chạm phần tử khác. Vì sao 8 luồng lại chậm hơn 1 luồng?
- Q3Padding sửa false sharing thế nào? Vì sao không nên padding mọi biến?
- Q4Vì sao 'mỗi luồng tích luỹ vào biến cục bộ rồi gộp một lần ở cuối' là cách tốt nhất tránh false sharing?
- Q5Bài 02 dạy gói dữ liệu gần nhau để tăng locality; bài này lại bảo tách dữ liệu ra xa. Hai lời khuyên này mâu thuẫn không? Giải thích.
Bài tiếp theo: Tổng kết Module 2
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên