Out-of-order và SIMD — CPU vắt kiệt song song mức lệnh
CPU hiện đại chạy lệnh không theo thứ tự để lấp chỗ trống chờ, và SIMD xử lý nhiều dữ liệu bằng một lệnh. Vì sao vòng lặp đơn giản, đều đặn lại được tối ưu tốt nhất.
TL;DR: CPU hiện đại không chạy code theo thứ tự bạn viết — bộ lập lịch phần cứng sắp xếp lại để nhiều đơn vị thực thi luôn bận rộn (out-of-order execution). Song song đó, SIMD cho phép một lệnh thao tác trên nhiều phần tử dữ liệu cùng lúc (8 phép cộng float bằng một lệnh AVX). Hai kỹ thuật này khai thác song song mức lệnh (ILP) mà không đòi hỏi lập trình viên viết luồng song song. Hệ quả thực tế: vòng lặp đơn giản, đều, không rẽ nhánh phức tạp — compiler tự biến thành SIMD và CPU tự sắp xếp lại để chạy nhanh nhất có thể.
Bạn có thể đã nghe đồng nghiệp nói "vòng lặp này chạy được SIMD rồi" sau khi đổi một cấu trúc dữ liệu. Hoặc bạn nhìn vào profiler và thấy một đoạn code với 10 dòng lệnh nhưng thực tế CPU chỉ mất 3 chu kỳ thay vì 10. Vì sao lại thế?
Bài này giải thích cơ chế CPU tái sắp xếp lệnh và nhóm dữ liệu để khai thác song song — cốt lõi để bạn hiểu vì sao cách viết code ảnh hưởng đến hiệu năng dù bạn không đụng đến thread nào.
1. Analogy — bếp trưởng và xửng hấp
Hãy tưởng tượng một bếp trưởng nhận đơn: "làm gà hầm, canh chua, bánh bao". Bếp trưởng kém sẽ làm tuần tự: bắt đầu gà, chờ gà chín rồi mới nấu canh, xong mới hấp bánh. Ba giờ trở thành tám giờ.
Bếp trưởng giỏi làm khác. Trong lúc chờ gà hầm (thao tác chậm — tương đương CPU chờ dữ liệu từ RAM), bếp trưởng tranh thủ thái rau cho canh — đây là out-of-order execution: làm những việc sẵn sàng thay vì chờ thứ tự ban đầu. Và khi hấp bánh, thay vì hấp từng cái một, bếp trưởng xếp 8 cái bánh vào cùng một xửng và hấp một lần — đây là SIMD: một thao tác xử lý nhiều dữ liệu cùng lúc.
Kết quả: bếp trưởng giỏi hoàn thành ba món trong cùng thời gian bếp trưởng kém làm một món.
| Nhà bếp | CPU |
|---|---|
| Chờ gà hầm chín | CPU chờ dữ liệu từ RAM (cache miss) |
| Tranh thủ thái rau trong lúc chờ | Out-of-order: chạy lệnh độc lập trước |
| 8 cái bánh trong một xửng hấp | SIMD: 1 lệnh thao tác 8 phần tử |
| Bếp trưởng bận rộn liên tục | Superscalar: nhiều đơn vị thực thi hoạt động song song |
| Thứ tự phục vụ đúng menu | Commit in-order: đảm bảo kết quả đúng ngữ nghĩa |
Out-of-order = làm việc sẵn sàng trước khi việc khác xong. SIMD = một lệnh, nhiều dữ liệu. Cả hai đều miễn phí cho lập trình viên — nhưng chỉ khi code "thân thiện" với chúng.
2. Superscalar và Out-of-order execution
2.1 Superscalar: IPC vượt 1
CPU thế hệ đầu chạy đúng một lệnh mỗi chu kỳ — IPC (Instructions Per Cycle) bằng 1. CPU superscalar có nhiều đơn vị thực thi (ALU, FPU, load/store unit…) hoạt động song song, cho phép chạy nhiều lệnh trong một chu kỳ đồng hồ duy nhất.
Chu ky 1:  [ADD r1, r2] [MUL r3, r4] [LOAD r5, mem]   <- 3 lenh doc lap, 3 don vi
Chu ky 2:  [ADD r6, r7] [STORE r8, mem]                <- 2 lenh tiep
IPC của CPU hiện đại thường từ 3 đến 5 trên workload thực tế — một chu kỳ có thể hoàn thành nhiều lệnh cùng lúc.
Điều kiện để chạy song song: các lệnh không phụ thuộc nhau về dữ liệu. Hai lệnh cùng đọc thanh ghi r1 thì OK. Lệnh dùng kết quả của lệnh trước thì phải chờ — gọi là data hazard (đã đề cập trong bài 02 — Pipeline).
2.2 Out-of-order execution: lấp chỗ trống chờ
Pipeline truyền thống bị đình trệ khi gặp hazard — tất cả lệnh phía sau đứng yên chờ. CPU out-of-order giải quyết khác hơn: nó nhìn trước vào hàng lệnh sắp đến, tìm những lệnh không phụ thuộc lệnh đang bị chờ, rồi chạy chúng trước.
Lenh 1: LOAD r1, [addr]    <- chong nho vao cache miss, phai cho 100+ chu ky
Lenh 2: ADD  r2, r3, r4    <- doc lap voi r1 -> CPU chay lenh 2 truoc
Lenh 3: MUL  r5, r6, r7    <- doc lap voi r1 -> CPU chay lenh 3 truoc
Lenh 4: ADD  r8, r1, r2    <- phu thuoc r1 -> phai cho lenh 1 xong
Trong ví dụ trên, thay vì pipeline đứng yên 100 chu kỳ chờ cache miss, CPU hoàn thành lệnh 2 và 3 trong thời gian chờ đó. Lệnh 4 vẫn phải chờ đúng thứ tự vì cần kết quả r1.
Cơ chế này khai thác ILP — Instruction-Level Parallelism: song song tiềm ẩn trong luồng lệnh đơn, không cần lập trình viên viết thread.
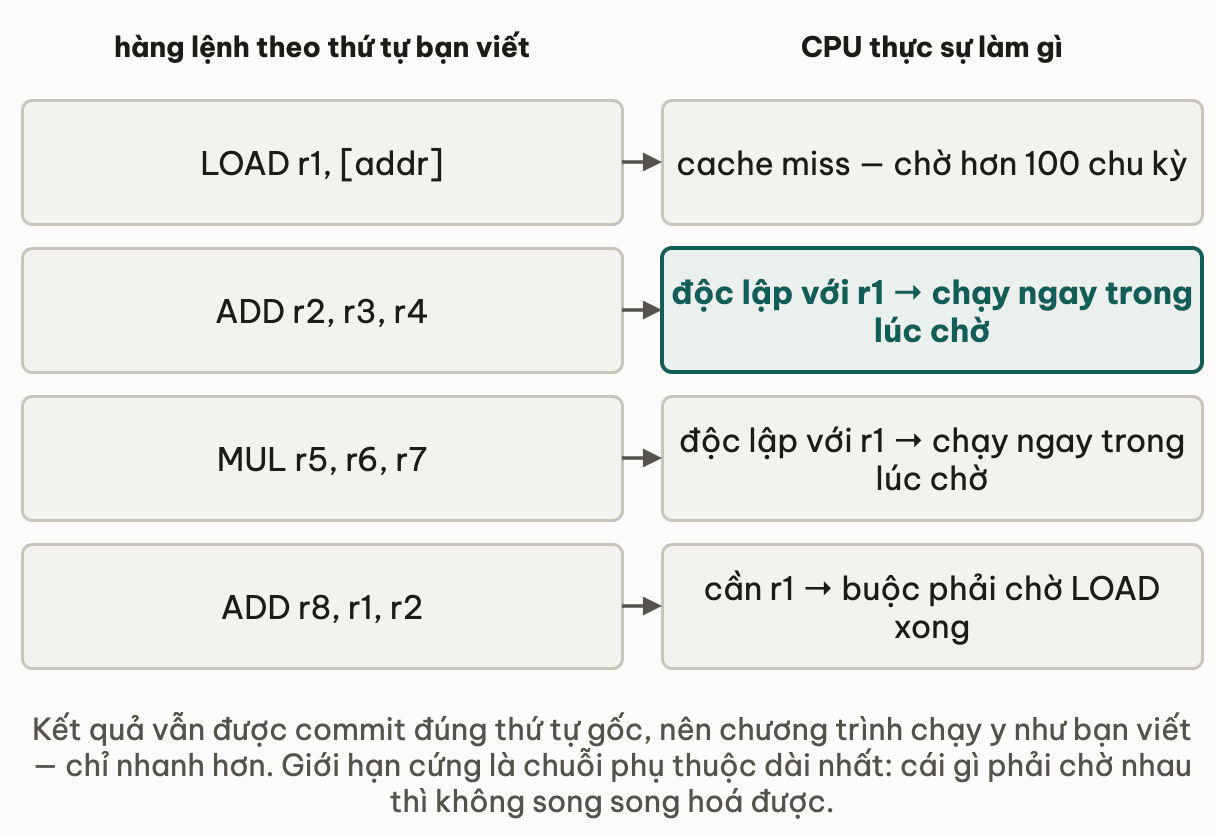
Commit in-order đảm bảo ngữ nghĩa đúng. Dù thực thi loạn xạ, CPU commit kết quả vào state kiến trúc (register file, bộ nhớ) đúng thứ tự gốc. Nhờ đó code của bạn chạy chính xác như bạn viết — chỉ khác là nhanh hơn nhiều.
Chuỗi lệnh mà mỗi lệnh dùng kết quả lệnh trước là dependency chain — CPU buộc phải chạy tuần tự. Đây là giới hạn hard của out-of-order: không thể song song hóa những gì phụ thuộc nhau. Chuỗi phụ thuộc dài nhất qua một đoạn code xác định critical path latency — tốc độ tối đa có thể đạt được.
Thử ngẫmhàm tính hash = hash * 31 + c cho từng ký tự trong chuỗi, mỗi bước dùng kết quả bước trước. Out-of-order execution có giúp vòng lặp này chạy nhanh hơn nhiều không?
3. SIMD — một lệnh, nhiều dữ liệu
3.1 Khái niệm: vector thay vì scalar
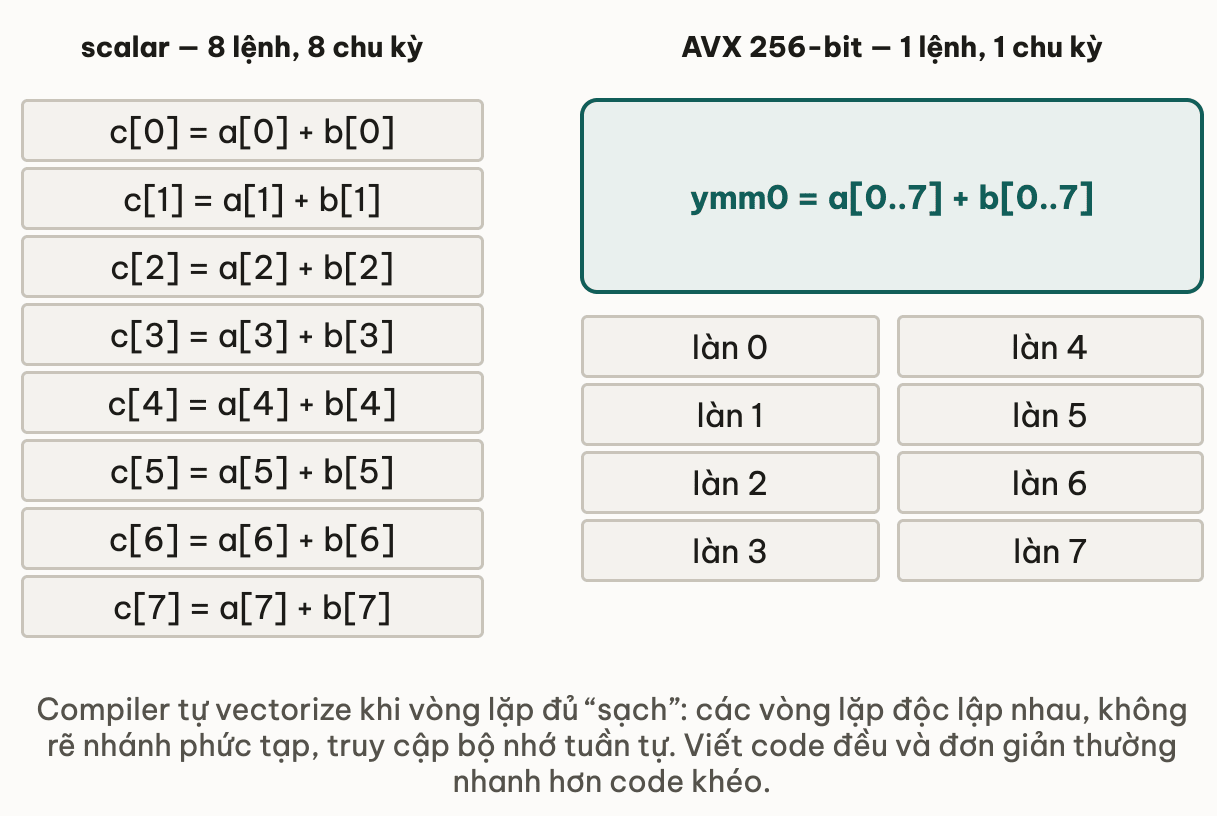
CPU thông thường (scalar) cộng hai số: một lệnh, hai toán hạng, một kết quả. SIMD — Single Instruction, Multiple Data mở rộng: một lệnh thao tác trên vector gồm nhiều phần tử cùng lúc.
Scalar:
  r1 = a[0] + b[0]   <- 1 phep cong, 1 chu ky
  r2 = a[1] + b[1]   <- 1 phep cong, 1 chu ky
  ...                 <- 8 phep cong = 8 chu ky

SIMD (AVX 256-bit, 8 float 32-bit):
  ymm0 = a[0..7] + b[0..7]   <- 8 phep cong, 1 chu ky
Tập lệnh SIMD phổ biến:
- SSE / SSE2 / SSE4 (x86): thanh ghi 128-bit, xử lý 4 float hoặc 2 double cùng lúc.
- AVX / AVX2 / AVX-512 (x86): 256-bit (8 float) và 512-bit (16 float).
- NEON (ARM): 128-bit, có mặt trên mọi chip ARM hiện đại (Apple M-series, Android flagship).
3.2 Auto-vectorization: compiler làm hộ bạn
Lập trình viên thường không cần viết SIMD bằng tay. Compiler (GCC, Clang, javac + JIT, .NET RyuJIT) có thể tự biến vòng lặp thành SIMD nếu đủ điều kiện — gọi là auto-vectorization.
// Vong lap nay compiler co the tu vectorize thanh SIMD
// Dieu kien: doc lap, khong ren nhanh, mang lien mach
void addArrays(float* a, float* b, float* c, int n) {
    for (int i = 0; i < n; i++) {
        c[i] = a[i] + b[i];   // khong phu thuoc vong lap truoc
    }
}
// GCC -O2: tu dong phat sinh lenh vmovups + vaddps (AVX)
Kết quả: một vòng lặp trên 1000 phần tử float, thay vì 1000 chu kỳ chỉ còn khoảng 125 chu kỳ (với AVX 8-wide) — tăng tốc gần 8 lần từ một thay đổi bằng không.
Trên JVM, JIT compiler (C2) cũng auto-vectorize. Java 17+ thêm Vector API (jdk.incubator.vector) cho phép viết SIMD tường minh khi cần kiểm soát tốt hơn.
// Vong lap Java co the duoc JIT vectorize
void addArrays(float[] a, float[] b, float[] c) {
    for (int i = 0; i < a.length; i++) {
        c[i] = a[i] + b[i];   // JIT C2 phat hien pattern, sinh SIMD
    }
}
4. Đào sâu (tuỳ chọn)
Register renaming và Reorder Buffer:
Out-of-order execution đòi hỏi hai cơ chế phần cứng then chốt:
-
Register renaming: CPU có nhiều thanh ghi vật lý hơn thanh ghi kiến trúc (x86 có 16 thanh ghi kiến trúc nhưng hàng trăm thanh ghi vật lý). Khi hai lệnh đều ghi vào
rax, CPU tự map chúng vào thanh ghi vật lý khác nhau, loại bỏ phụ thuộc giả (write-after-write, write-after-read hazard). Đây là lý do IPC thực tế cao hơn nhiều so với tốc độ issue. -
Reorder Buffer (ROB): lệnh được fetch theo thứ tự gốc vào ROB, nhưng thực thi khi sẵn sàng (out-of-order). Sau khi thực thi xong, lệnh nằm trong ROB chờ đến lượt commit theo thứ tự gốc. ROB là "vùng đệm" đảm bảo tính nhất quán kiến trúc.
Điều kiện cản auto-vectorization:
Compiler từ chối vectorize khi không thể chứng minh tính đúng đắn:
- Phụ thuộc dữ liệu giữa các vòng lặp:
a[i] = a[i-1] + b[i]— lần lặp i phụ thuộc lần lặp i-1, không thể song song. - Rẽ nhánh trong vòng lặp:
if (cond) c[i] = a[i] + b[i]; else c[i] = 0;— SIMD cần xử lý tất cả phần tử như nhau (có thể xử lý với predicated execution nhưng phức tạp hơn). - Con trỏ aliasing: compiler không biết
avàccó trỏ vào cùng vùng nhớ không — dùng__restrict__(C) hoặc tách array riêng để hint. - Kiểu dữ liệu không đồng nhất: lặp qua struct có nhiều field khác kiểu.
Vector API Java (java-internals): Java 16+ incubator, final từ JDK 22-23 (JEP 460/469) — cho phép viết SIMD tường minh với FloatVector, VectorSpecies. Hữu ích cho ML inference, image processing, scientific computing. Xem thêm tại JEP 469 và track java-internals.
Thử ngẫmvòng lặp cộng hai mảng có thêm dòng if (a[i] > 1000) log(a[i]); bên trong. Điều gì trong bốn điều kiện cản auto-vectorization vừa đọc khiến compiler khó SIMD hoá vòng lặp này?
5. Áp dụng vào code của bạn
Bạn không cần viết SIMD hay hiểu microarchitecture để hưởng lợi — chỉ cần viết code theo cách compiler và CPU có thể tối ưu.
Vòng lặp vectorize-friendly
// TOT: vong lap don gian, mang lien mach, khong ren nhanh
// -> compiler tu vectorize thanh AVX (8 float/lenh)
void scaleArray(float* arr, float factor, int n) {
    for (int i = 0; i < n; i++) {
        arr[i] *= factor;   // doc lap, khong aliasing, linear access
    }
}
// KHO VECTORIZE: ren nhanh trong vong lap
// -> compiler phai xuat ra scalar loop
void processArray(float* arr, int n) {
    for (int i = 0; i < n; i++) {
        if (arr[i] < 0) arr[i] = 0;   // ren nhanh -> vectorize kho hon
        else arr[i] *= 2.0f;
    }
    // Thay bang: arr[i] = arr[i] < 0 ? 0 : arr[i] * 2.0f;
    // Branchless -> compiler co the vectorize tot hon
}
Tránh phụ thuộc dữ liệu giả
// BAD: phu thuoc loop-carried -> khong vectorize duoc
float prefix[N];
prefix[0] = a[0];
for (int i = 1; i < N; i++) {
    prefix[i] = prefix[i-1] + a[i];   // phu thuoc i-1
}

// GOOD: accumulation doc lap -> vectorize tot
float result = 0;
for (int i = 0; i < N; i++) {
    result += a[i];   // compiler co the dung SIMD reduction
}
Bố trí dữ liệu liền mạch
Truy cập bộ nhớ tuần tự (stride-1) là điều kiện để cache prefetcher và SIMD đều hoạt động tốt. Cấu trúc dữ liệu phân tán (danh sách liên kết, mảng con trỏ) cản cả hai.
// AoS (Array of Structs) - truy cap xen ke, kho SIMD
Point[] points = new Point[N];   // [x0,y0,x1,y1,x2,y2...]
for (int i = 0; i < N; i++) {
    points[i].x *= scale;   // truy cap x cach nhau boi sizeof(Point)
}

// SoA (Struct of Arrays) - truy cap lien mach, SIMD tot hon
float[] xs = new float[N];  // [x0,x1,x2,...]
float[] ys = new float[N];  // [y0,y1,y2,...]
for (int i = 0; i < N; i++) {
    xs[i] *= scale;   // lien mach trong bo nho -> vectorize tot
}
AoS vs SoA là quyết định bố trí dữ liệu quan trọng trong Course 2 (bộ nhớ + cache). Bài này chỉ giới thiệu teaser.
Trong đại đa số trường hợp, không cần viết SIMD bằng tay hay intrinsics. Compiler và JIT làm tốt nếu vòng lặp đủ "sạch": đơn giản, đều, không rẽ nhánh phức tạp, truy cập tuần tự. Chỉ cân nhắc Vector API / intrinsics khi profiler chỉ rõ bottleneck và benchmark chứng minh cải thiện có thực.
6. Liên hệ các bài khác
- Bài 02 — Pipeline và Hazard: data hazard là nguyên nhân gốc rễ khiến out-of-order cần thiết — pipeline bình thường đứng yên chờ, out-of-order lấp chỗ trống đó.
- Bài 03 — Branch Prediction: out-of-order execution kết hợp với branch prediction — CPU đoán nhánh và thực thi speculative, tận dụng tối đa các đơn vị thực thi.
- Bài 06 — Spectre và Meltdown: speculative execution (hệ quả của out-of-order + branch prediction) là nguồn gốc của lỗ hổng bảo mật Spectre/Meltdown.
- Course 2 — Bộ nhớ và Cache: bố trí dữ liệu (AoS vs SoA, cache line alignment) quyết định SIMD và auto-vectorization có phát huy được không — hai chủ đề này gắn chặt nhau.
7. Tóm tắt
- Superscalar: CPU có nhiều đơn vị thực thi, chạy nhiều lệnh độc lập trong một chu kỳ — IPC vượt 1.
- Out-of-order execution: CPU chạy lệnh sẵn sàng trước (không đợi thứ tự gốc), rồi commit kết quả theo thứ tự để giữ ngữ nghĩa đúng.
- ILP (Instruction-Level Parallelism): song song tiềm ẩn trong luồng lệnh đơn — cả hai kỹ thuật trên đều khai thác ILP.
- SIMD: một lệnh xử lý nhiều phần tử dữ liệu cùng lúc (SSE/AVX trên x86, NEON trên ARM).
- Auto-vectorization: compiler tự biến vòng lặp đủ điều kiện thành SIMD — lập trình viên không phải viết tay.
- Điều kiện để tối ưu tốt: vòng lặp đơn giản, không rẽ nhánh phức tạp, không phụ thuộc dữ liệu giữa các lần lặp, truy cập bộ nhớ tuần tự.
- Hệ quả thực tế: viết code sạch, đều, không "tinh vi" thường nhanh hơn code "khéo" vì compiler/CPU có thể tối ưu tốt hơn.
8. Tự kiểm tra
- Q1Out-of-order execution giải quyết vấn đề gì của pipeline truyền thống? Cơ chế nào đảm bảo kết quả vẫn đúng dù lệnh chạy loạn xạ?
- Q2SIMD là gì và tại sao nó nhanh hơn vòng lặp scalar cho cùng phép tính?
- Q3Vì sao vòng lặp có rẽ nhánh phức tạp bên trong khó được auto-vectorize hơn vòng lặp đơn giản?
- Q4Một chuỗi lệnh mà lệnh sau luôn dùng kết quả lệnh trước có IPC bằng bao nhiêu? Vì sao?
- Q5Bạn có một vòng lặp Java cộng hai mảng float. Bạn cần làm gì để đảm bảo JIT có thể vectorize nó?
- Q6Vì sao bố trí dữ liệu SoA (Struct of Arrays) thường thân thiện với SIMD hơn AoS (Array of Structs)?
Bài tiếp theo: Spectre và Meltdown
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên