Đợt rà soát dung lượng quý ấy không bắt đầu từ sự cố nào cả. Chỉ là bảng postings, nơi giữ bút toán hai năm gần nhất, được nạp sang từ hệ thống cũ theo từng chi nhánh hồi migrate, đã phình tới mức tôi muốn biết chỗ nào ăn đĩa nhiều nhất trước khi đi xin thêm chỗ.
Bảng có mười một index. Cái to nhất 214 MB, xấp xỉ một phần ba dung lượng của chính bảng. Tôi mở pg_stat_user_indexes ra xem cái nào đáng đồng tiền:
SELECT s.indexrelname, s.idx_scan,
       pg_size_pretty(pg_relation_size(s.indexrelid)) AS kich_thuoc
FROM pg_stat_user_indexes s
JOIN pg_index i ON i.indexrelid = s.indexrelid
WHERE s.relname = 'postings'
  AND NOT i.indisunique AND NOT i.indisprimary
ORDER BY s.idx_scan;
Bốn dòng đầu có idx_scan bằng 0 tròn, chưa dùng lần nào kể từ lần reset bộ đếm gần nhất. Bộ đếm này chỉ tính trên chính máy chủ đang hỏi, nên tôi gộp thêm số từ replica đọc trước khi tin nó; trên PostgreSQL 16 còn có cột last_idx_scan cho biết lần dùng cuối. Bốn ngôi mộ: tạo ra, tốn đĩa, chưa một lần được ghé. Một trong bốn cái đó do chính tôi tạo mấy tháng trước, cho một báo cáo mà tôi nhớ rõ là đã chậm thật, và tôi còn nhớ rõ hơn là hồi ấy đã đo trên staging, thấy index thắng rồi mới đưa lên.
Bạn junior ngồi cùng bàn hỏi đúng câu đáng hỏi nhất lúc đó: xoá đi thì query nào chậm lại? Tôi chưa trả lời được, ít nhất là chưa trả lời bằng số đo. Cả bốn index ấy đều sinh ra để đỡ cho một câu truy vấn có thật, và cả bốn đều nằm đúng trên cột mà câu truy vấn ấy đang lọc. Có index, đúng cột, số lần dùng vẫn tròn 0.
Hai bệnh, một triệu chứng. Dòng Seq Scan trong EXPLAIN gộp hai chuyện chẳng liên quan gì nhau: có lúc planner không thể dùng index vì predicate bọc cột trong một hàm, có lúc planner tính giá đường đi qua index rồi chủ động bỏ vì quét thẳng còn rẻ hơn. Phép tính đó dựa trên thống kê và cost model, planner gần như không phải chạm vào index, nên idx_scan gần như đứng yên. Chẩn nhầm bệnh chính là lúc người ta đắp thêm một index không bao giờ được dùng.
Bệnh thứ nhất: đúng cột, sai biểu thức
Một hàm bọc quanh cột trong WHERE đẩy index trên cột đó ra ngoài cuộc chơi: planner chỉ dùng được index khi vế trong WHERE khớp đúng biểu thức làm khoá index, còn ở đây vế ấy đã thành một biểu thức khác. Câu truy vấn đẻ ra index đầu tiên rơi đúng vào bẫy này — nó là kết xuất sao kê theo ngày:
SELECT count(*), sum(amount)
FROM postings
WHERE DATE(posted_at) = DATE '2026-05-04';
Nhìn thì khớp: index nằm trên posted_at, WHERE cũng lọc posted_at. Nhưng đọc chậm lại một nhịp thì không phải vậy. WHERE không lọc theo posted_at, nó lọc theo DATE(posted_at), và đấy là một biểu thức khác.
B-tree vốn chỉ là một danh sách đã sắp thứ tự cộng thêm cách nhảy vào giữa danh sách ấy cho nhanh. Index này sắp mọi dòng theo posted_at, và khoá của nó chính là biểu thức posted_at. Planner chỉ chọn index cho một vế trong WHERE khi vế đó so khoá với một giá trị không phụ thuộc dòng đang quét (hằng, tham số…), khoá viết y như lúc tạo index. DATE(posted_at) không phải biểu thức ấy. Các dòng của ngày 4/5 thật ra vẫn nằm thành một đoạn liền trên index, nhưng planner không tự suy ra rằng DATE() giữ nguyên thứ tự để đổi phép so bằng thành một khoảng trên posted_at. Không thấy index nào khớp, nó chỉ còn cách đọc từng dòng ra rồi tính DATE() của dòng đó. Mà đọc mọi dòng ra thì đúng bằng định nghĩa của Seq Scan.
Planner giống một thủ thư chỉ biết so chữ trên phiếu với chữ trong mục lục. Mục lục ghi ngày kèm giờ, còn phiếu bạn đưa ghi ngày đã cắt giờ. Hai dòng chữ không giống nhau, thế là thủ thư coi như thư viện không có mục lục và đi lục từng kệ, dù sách cần tìm vẫn nằm liền nhau trên một kệ.
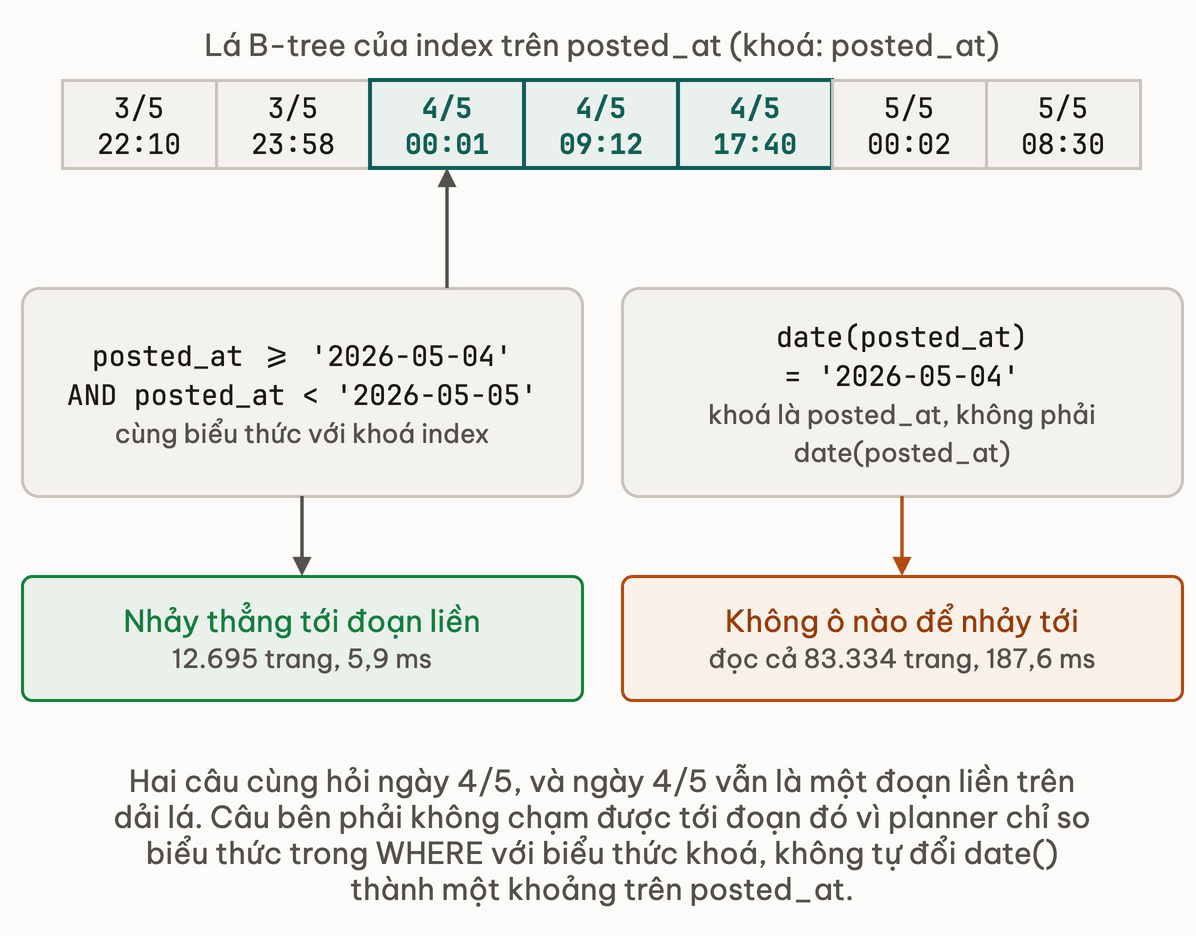
Để đo cho sạch, tôi dựng một bảng tái hiện cùng hình dạng: PostgreSQL 16, 10 triệu bút toán trải hai năm, cột posted_at kiểu timestamp (không time zone), nạp theo chi nhánh như bảng gốc, phần dữ liệu 651 MB, index trên posted_at 214 MB. Mọi số đo về postings trong bài chạy trên bảng này. Câu bọc DATE() chạy hết 187,6 ms và đọc 83.334 trang, tức toàn bộ bảng. Dòng đáng đọc trong EXPLAIN ANALYZE là dòng này:
Parallel Seq Scan on postings
  Filter: (date(posted_at) = '2026-05-04'::date)
  Rows Removed by Filter: 3328770
Mỗi worker vứt đi hơn 3,3 triệu dòng để giữ lại vài nghìn. Giờ hỏi lại đúng câu ấy, nhưng hỏi bằng đúng biểu thức mà index dùng làm khoá — cùng dữ liệu, cùng index, không tạo thêm gì:
SELECT count(*), sum(amount)
FROM postings
WHERE posted_at >= TIMESTAMP '2026-05-04'
  AND posted_at <  TIMESTAMP '2026-05-05';
5,9 ms, đọc 12.695 trang, trả về đúng 13.690 dòng như câu cũ. Index giữ nguyên, chỉ đổi hình dạng câu hỏi mà nhanh hơn khoảng 32 lần.
Cùng bệnh này còn có WHERE UPPER(email) = ... và WHERE CAST(so_tk AS TEXT) LIKE .... Dấu hiệu chung của cả họ: giữa cột và index có cái gì đó chen vào.
Hai trường hợp nữa cũng cho ra Seq Scan nhưng theo cơ chế khác, và đáng tách riêng. Thứ nhất là LIKE '%1234' với ký tự đại diện đứng đầu (Pattern 4 trong bài chẩn đoán plan xấu): chẳng có hàm nào bọc cột cả, chỉ là B-tree được sắp từ đầu chuỗi nên nó chỉ trả lời được câu hỏi dạng "bắt đầu bằng gì", không trả lời được "kết thúc bằng gì".
Thứ hai thì khó thấy hơn nhiều, vì câu lệnh trông sạch sẽ. Trên database chạy collation thường gặp như en_US.utf8, ngay cả LIKE 'abc%' — tiền tố đàng hoàng, ký tự đại diện nằm cuối — cũng không dùng được index B-tree mặc định. Lý do là index ấy sắp chuỗi theo quy tắc ngôn ngữ, còn phép so khớp tiền tố cần thứ tự so từng ký tự theo mã. Trên một bảng thử riêng ttext 300.000 dòng chuỗi, đã VACUUM, câu SELECT s FROM ttext WHERE s LIKE 'abc%' cho Seq Scan 9,3 ms; dựng thêm một index khai rõ lớp toán tử so theo mã ký tự thì xuống Index Only Scan 0,106 ms:
CREATE INDEX idx_ttext_pat ON ttext(s text_pattern_ops);
Ngõ cụt: lúc tôi tưởng planner chọn sai
Bệnh thứ nhất xử được ba trong bốn ngôi mộ. Cái thứ tư là cái của tôi, và nó mới là chỗ tôi mất cả buổi chiều.
Nó cũng nằm trên posted_at, trùng cột với index của câu sao kê. Hồi tạo tôi không để ý, vì cái kia đang 0 lượt dùng, mà index 0 lượt dùng thì nhìn chẳng khác gì chưa có. Nó phục vụ báo cáo đối soát của quý vừa đóng sổ, quét khoảng 90 ngày đã nằm hẳn trong quá khứ (nhờ vậy planner cũng không phải dò biên index, việc vẫn đẩy idx_scan lên một lượt mỗi lần lập kế hoạch khi hằng số chạm đoạn đầu hoặc cuối histogram), và predicate của báo cáo đó viết chuẩn ngay từ đầu: dạng khoảng, không hàm nào bọc, không ép kiểu nào chen giữa. idx_scan vẫn bằng 0.
Bạn junior đoán trước: thống kê cũ. Bảng ghi nặng, ANALYZE không chạy đủ gần đây thì planner ước lượng sai số dòng khớp là chuyện thường ngày. Đoán hợp lý, và rẻ để thử: chạy ANALYZE postings, mở lại EXPLAIN. Vẫn Seq Scan, không xê dịch một dòng nào.
Giả thuyết của tôi thì tự tin hơn nhiều: planner đang chọn sai. Chính mắt tôi đã thấy index thắng trên staging, nên tôi chắc sẽ chứng minh được. PostgreSQL có sẵn công tắc để ép nó bỏ quét thẳng:
SET enable_seqscan = off;
Tôi tưởng mình sắp cầm tang chứng trong tay. Kết quả đi ngược lại:
| Kế hoạch cho cùng câu 90 ngày | Thời gian | Trang đọc |
|---|---|---|
Mặc định: Parallel Seq Scan | 161,3 ms | 83.334 |
Ép index: Parallel Bitmap Heap Scan | 205,8 ms | 86.705 |
Ép dùng index thì chậm hơn, và đọc nhiều hơn đúng 3.371 trang, tức phần trang index phải lật thêm. Planner không sai. Cái sai nằm ở con số tôi mang từ staging về, và phải tới phần sau tôi mới hiểu vì sao.
Trong kế hoạch bị ép còn hai dòng nói thẳng vì sao:
Heap Blocks: exact=17284 lossy=11406    (phan cua tien trinh leader)
Rows Removed by Index Recheck: 1159121
lossy nghĩa là tấm bitmap dựng từ index không vừa work_mem (mặc định 4 MB), nên nó tụt xuống ghi nhớ ở mức trang thay vì mức dòng. Với những trang đó, PostgreSQL phải đọc nguyên trang rồi kiểm lại điều kiện trên từng dòng, và mỗi tiến trình loại khoảng 1,16 triệu dòng ở bước kiểm lại ấy. Index sinh ra để tránh chính việc đó.
Một dòng EXPLAIN, hai bệnh

Cơ chế đằng sau cột phải nằm ở một chỗ dễ quên: index cho bạn con trỏ, không cho bạn dữ liệu. Khoảng 90 ngày khớp 1.232.429 dòng, và dữ liệu của chúng nằm ở heap, rải trên 83.334 trang. Vì bảng này được nạp theo chi nhánh rồi theo mã tài khoản, thứ tự trên đĩa chẳng dính gì tới thời gian, nên 1,2 triệu con trỏ ấy trỏ tới gần như mọi trang trong bảng. Tra index xong thì vẫn phải đọc gần hết bảng, chỉ khác là đọc theo thứ tự lộn xộn và tốn thêm 3.371 trang index nữa. Quét thẳng từ đầu tới cuối, tuần tự, đọc ít trang hơn.
Ranh giới ấy đo được. Nới dần khoảng ngày trên cùng bảng đó:
| Khoảng | Thời gian | Dòng khớp (tỉ lệ bảng) | Kế hoạch |
|---|---|---|---|
| 1 ngày | 5,9 ms | 13.690 (0,14%) | Bitmap Heap Scan |
| 70 ngày | 201,2 ms | 958.726 (9,6%) | Parallel Bitmap Heap Scan |
| 75 ngày | 155,5 ms | 1.027.156 (10,3%) | Parallel Seq Scan |
| 90 ngày | 161,3 ms | 1.232.429 (12,3%) | Parallel Seq Scan |
Giữa 70 và 75 ngày, planner đổi ý. Nhìn cột thời gian thì thấy nó đổi ý hơi muộn: ở 70 ngày nó vẫn đi index mất 201,2 ms, trong khi quét thẳng cả khoảng rộng hơn 75 ngày chỉ hết 155,5 ms, nên ở 70 ngày quét thẳng nhiều khả năng đã nhanh hơn rồi. Cost model là phép ước lượng chứ không phải đồng hồ, nên điểm nó đổi ý không trùng khít điểm hoà. Nhưng chiều thì đúng: qua khỏi ngưỡng ấy, khoảng càng rộng thì index càng thua xa.
Từ đây có một phép thử phân biệt hai bệnh gọn hơn nhiều so với việc ngồi đoán. Bật enable_seqscan = off rồi chạy lại: nếu kế hoạch chuyển sang index mà chậm hơn thì bạn đang ở bệnh thứ hai, planner đúng, đừng đắp thêm gì cả. Còn nếu kế hoạch vẫn là Seq Scan, hoặc có đi qua index nhưng không có dòng Index Cond nào chứa cột đang lọc (câu có ORDER BY theo cột index đôi khi cho ra kiểu Index Scan quét trọn này), thì đó là bệnh thứ nhất — công tắc kia chỉ cộng một khoản phạt vào chi phí chứ không cấm được, và khi index không dùng được thì phạt bao nhiêu cũng vô nghĩa. Trên câu bọc DATE() ở đầu bài, ép xong EXPLAIN in ra Seq Scan với chi phí khởi điểm 10000000000.00, đúng khoản phạt đó nằm chình ình. Con số ấy là cách PostgreSQL 16, bản tôi đo, xử lý công tắc; từ PostgreSQL 18, planner đếm số node bị tắt thay cho khoản phạt, và EXPLAIN in Disabled: true ở node đó.
Ngưỡng mười phần trăm ấy không phải hằng số
Con số quanh 10% ở bảng trên rất dễ bị nhớ thành quy tắc. Muốn thấy nó chỉ là hệ quả của dữ liệu, chỉ cần đổi đúng một thứ: thứ tự vật lý của các dòng trên đĩa.
PostgreSQL theo dõi việc đó bằng correlation trong pg_stats, mức khớp giữa thứ tự giá trị trong cột và thứ tự các dòng nằm trên đĩa. Bảng tái hiện nạp theo chi nhánh rồi theo mã tài khoản giống bảng gốc, nên correlation của posted_at chỉ 0,013, nghĩa là hai dòng liền nhau theo thời gian có thể nằm ở hai đầu đĩa. Lệnh CLUSTER postings USING idx_postings_posted_at xếp lại các dòng theo đúng thứ tự index, rồi ANALYZE postings để thống kê thấy thứ tự mới (thiếu bước này planner vẫn tưởng correlation là 0,013). correlation lên 1. Không thêm index nào, không sửa câu truy vấn nào:
| Cùng câu 90 ngày (12,3% bảng) | Kế hoạch | Thời gian |
|---|---|---|
correlation 0,013 | Parallel Seq Scan | 161,3 ms |
correlation 1,0 sau CLUSTER | Parallel Index Scan | 54,9 ms |
Chỗ tiết kiệm nằm ở số trang phải lật, và nó nhìn được:

Vẫn chừng ấy con trỏ từ index, nhưng khi các dòng của 90 ngày nằm cạnh nhau trên đĩa thì chúng chỉ chiếm một dải trang liền, thay vì rải khắp 83.334 trang. Index lúc này tiết kiệm thật, nên planner dùng. Ngưỡng vì thế dịch đi rất xa: sau khi xếp lại, ngay cả khoảng 180 ngày với 2.467.276 dòng, gần một phần tư bảng, planner vẫn chọn index và chạy hết 113,6 ms. Mốc so gần nhất là lượt quét thẳng cả bảng của câu bọc DATE() ở cuối phần này, 163,4 ms; không cùng câu, nhưng đủ thấy index không thua.
Đừng vì thế mà mang CLUSTER lên production. Lệnh này giữ khoá ACCESS EXCLUSIVE, chặn cả đọc lẫn ghi suốt lúc viết lại bảng, và chỉ xếp một lần: dòng ghi sau đó không giữ thứ tự. Ở đây nó là công cụ thí nghiệm, để thấy ngưỡng dịch theo thứ tự vật lý.
Bảng bút toán ghi nối đuôi theo thời gian thì posted_at có sẵn correlation cao mà không ai phải làm gì, và index theo thời gian trên bảng như thế thường sống khoẻ hơn nhiều so với những gì con số 10% gợi ý. Bảng của chúng tôi nạp theo chi nhánh nên không được như vậy, và đó cũng là lý do CLUSTER dời được ngưỡng xa đến thế. Bút toán mới sau migrate cũng không cứu được: bảng giữ cuốn chiếu hai năm, mỗi đêm xoá bút toán quá hạn, mà các dòng cũ vốn nằm rải theo chi nhánh, nên VACUUM trả lại chỗ trống rải khắp heap và bút toán mới lấp vào đúng những chỗ đó.
Đó cũng là lời giải cho con số staging của tôi. Bản staging hồi ấy dựng lại bằng cách nạp dữ liệu theo thứ tự thời gian, nên posted_at trên staging có correlation gần 1, tức đúng điều kiện của bảng sau CLUSTER. Index thắng trên staging là thắng thật, chỉ là thắng trên một bảng có thứ tự vật lý khác hẳn production. Ngưỡng đo trên bảng này vì thế đừng bê sang bảng khác, kể cả khi bảng kia trùng tên.
Nhưng phép thử ấy còn một vế thứ hai, và vế đó mới là chỗ đáng nhớ. Sau khi CLUSTER, tôi chạy lại đúng câu bọc DATE() ở đầu bài, trên một cái bảng giờ đã ở điều kiện lý tưởng nhất mà index có thể mơ tới.
163,4 ms. Vẫn Parallel Seq Scan. Không nhúc nhích một milimét.
Khác biệt giữa hai bệnh nằm gọn ở đó. Bệnh thứ hai nhạy với đủ thứ: lượng dòng khớp, cách dữ liệu nằm trên đĩa, work_mem, bộ nhớ đệm. Bệnh thứ nhất chẳng nhạy với gì cả. Predicate đã bọc cột trong một hàm thì planner không nhận ra index nào khớp, và không có cách sắp xếp nào cứu nổi.
Chữa bệnh thứ nhất: sửa câu hỏi trước, tạo index sau.
-- CHAM: ham boc quanh cot, index tren posted_at coi nhu khong co
WHERE DATE(posted_at) = DATE '2026-05-04'

-- NHANH: cung ket qua, hoi dung bieu thuc khoa cua index
WHERE posted_at >= TIMESTAMP '2026-05-04'
  AND posted_at <  TIMESTAMP '2026-05-05'
Khi không sửa được câu truy vấn vì nó nằm trong thư viện, trong report builder hay trong code sinh tự động, PostgreSQL còn đường thứ hai: dựng index trên chính biểu thức đó.
CREATE INDEX idx_postings_ngay ON postings((DATE(posted_at)));
Lệnh này chạy được vì posted_at là timestamp. Với timestamptz, date() chỉ là hàm STABLE vì kết quả phụ thuộc time zone của phiên, nên PostgreSQL báo lỗi functions in index expression must be marked IMMUTABLE; khi đó phải dùng ((posted_at AT TIME ZONE 'Asia/Ho_Chi_Minh')::date) hoặc viết lại predicate thành khoảng.
Câu bọc DATE() xuống còn 5,7 ms. Index này cũng chỉ nặng 66 MB so với 214 MB của index trên posted_at, vì cả bảng chỉ có 731 giá trị ngày khác nhau, và từ PostgreSQL 13 B-tree gộp khoá trùng thành posting list: khoá trùng được gộp lại, mỗi khoá chỉ lặp lại một lần cho vài trăm con trỏ thay vì một lần cho mỗi dòng.
Đổi lại, đó là thêm một cây B-tree phải cập nhật trên mọi lần ghi, mà postings thì ghi suốt ngày. Sửa predicate không tốn gì; tạo index thì luôn kèm hoá đơn trả góp. Thử đường thứ nhất trước đã.
Bốn ngôi mộ hôm đó chia làm hai nhóm không đều nhau. Ba cái nằm chết vì câu truy vấn bọc hàm quanh cột, không phải vì vô dụng: sửa predicate xong, idx_scan của cả ba bắt đầu nhích, nên chúng ở lại, chỉ câu truy vấn là đổi. Cái thứ tư vừa trùng cột với index của câu sao kê, vừa phục vụ một báo cáo quét quá rộng mà planner sẽ tiếp tục bỏ qua. Nó là cái duy nhất bị xoá, và mỗi lần ghi bút toán bớt được một cây B-tree phải cập nhật theo.
Câu truy vấn pg_stat_user_indexes ở đầu bài giờ là mục thứ nhất trong checklist rà soát hằng quý của team, kèm một dòng chú thích tôi viết cho chính mình đọc lại: cột idx_scan không chấm điểm index của bạn, nó chấm điểm hình dạng câu hỏi bạn đặt cho database. Sau buổi chiều mất trắng với cái index thứ tư, mục ấy có thêm một bước cho index sắp tạo: dựng nó trên bản dump có correlation của cột lọc gần giống production, chạy EXPLAIN ANALYZE câu truy vấn nó định phục vụ, và chỉ đưa CREATE INDEX lên production khi plan thật sự đi qua nó.
Quý sau, bạn junior là người mở checklist ra chạy. Yêu cầu index đầu tiên vấp ở bước mới: tạo xong trên bản dump, plan vẫn là Parallel Seq Scan. Bạn ấy bật enable_seqscan = off để biết mình đang ở bệnh nào, rồi sửa theo thứ tự rẻ trước đắt sau mà bài Tuning toolbox xếp sẵn. Lệnh CREATE INDEX ban đầu không lên tới production.
Bài viết này đáng chia sẻ?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Sẵn sàng học sâu hơn?
Biến những gì vừa đọc thành kỹ năng thật với khoá học của OLHub, hoặc mang câu hỏi của bạn ra thảo luận cùng cộng đồng.
Đọc tiếp
Bài viết liên quan
Bọc transaction vẫn lệch số: bẫy isolation level READ COMMITTED
Báo cáo bọc trong BEGIN/COMMIT vẫn in ba dòng không cộng được: ở READ COMMITTED mỗi câu lệnh lấy một ảnh chụp mới, transaction không đóng băng dữ liệu.
Deadlock là gì? Bản chất 4 điều kiện Coffman và cách phòng tránh
Deadlock khiến hệ thống treo cứng khi các luồng chờ khoá chéo nhau. Mổ xẻ 4 điều kiện Coffman kinh điển và cách thiết kế lock ordering phòng tránh triệt để.
Sizing tài nguyên cho service mới: tính từ đâu để con số đáng tin?
Sizing service mới: dùng Little's Law đổi QPS thành số request cùng lúc, chừa chỗ trống theo hàng đợi, load test tìm điểm gãy để ra số pod, RAM, pool.
Vì sao Redis distributed lock vẫn cấp cho hai client khi failover?
Lock ghi vào master Redis nhưng replication bất đồng bộ chưa kịp sang replica; failover bầu replica lên thì key biến mất và client thứ hai xin được lock.