Sáng hôm đó tôi mở máy bằng một cảnh báo đối soát: số lãi tính cuối ngày lệch so với sổ. Xử lý số liệu có quy trình riêng, không phải chuyện của bài này. Chuyện của bài này là mười phút tôi ngồi đọc log để tìm vì sao.
Bối cảnh rất thường: batch tính lãi chạy trên ba pod Kubernetes. Cả ba cùng thức dậy đúng giờ, cùng xin một cái lock trên Redis, pod nào lấy được thì chạy, hai pod kia đứng chờ. Mục đích duy nhất của cái lock là để batch chạy đúng một lần.
Tôi lọc log quanh giờ batch và thấy một dòng lạ ở pod đang giữ lock, mười giây sau khi nó bắt đầu chạy: Can't update lock lock:eod-interest expiration, kèm RedisTimeoutException. Dòng đó đến từ watchdog của Redisson. Bạn cứ hình dung watchdog là một luồng chạy ngầm, cứ mười giây lại "gia hạn" cái lock một lần để nó không hết hạn khi job còn đang chạy. Nó đang báo là không gia hạn được.
Hai mươi giây sau, ở một pod khác: acquired lock lock:eod-interest. Pod thứ nhất vẫn chưa xong việc. Hai pod cùng tính lãi trên cùng một tập tài khoản, và mỗi bên đều tin mình là người duy nhất được phép.
Người viết cái lock đó là tôi. Redisson RLock, không đặt leaseTime để watchdog tự gia hạn đều, Redis một master hai replica, có Sentinel canh. Tôi tưởng mình đã tính hết mọi cách một lock có thể mất.
Thủ phạm. Redis chép dữ liệu từ master sang replica theo kiểu ghi xong mới chép: master trả OK cho client rồi mới gửi key sang replica. Master chết đúng trong khoảng đó thì replica được bầu lên làm master mới không hề có key lock, và client thứ hai xin lock sẽ được cấp trong khi client thứ nhất vẫn đang chạy. Redis docs gọi chuỗi này là safety violation. Đêm đó còn một lỗ thứ hai, ở chính watchdog.
Bộ máy đêm đó, kể bằng lời thường
Để theo được phần điều tra, bạn chỉ cần biết ba thứ về cách cụm Redis này chạy.
Thứ nhất, master và replica. Master là bản chính, nơi mọi lệnh ghi đi vào. Hai replica là hai bản sao, nhận lại từng thay đổi từ master để lỡ master chết thì còn chỗ thay thế. Bản sao luôn chậm hơn bản chính một chút, thường chỉ vài mili-giây, vì master ghi trước rồi mới gửi đi.
Thứ hai, Sentinel. Đó là một tiến trình đứng canh master. Master không trả lời nữa thì Sentinel chọn một replica và "bầu" nó lên làm master mới. Việc thay master này gọi là failover. Client (ở đây là các pod) sẽ hỏi Sentinel để biết master hiện tại là ai và kết nối lại.
Thứ ba, lock chỉ là một key có hạn dùng. Lấy lock nghĩa là ghi một key vào Redis với điều kiện "chỉ ghi nếu chưa có ai ghi", kèm một hạn tự hết: Redisson mặc định 30 giây (lockWatchdogTimeout, theo tài liệu cấu hình), watchdog gia hạn mỗi một phần ba khoảng đó, tức 10 giây. Job xong thì xoá key, gọi là nhả lock. Nếu pod giữ lock chết giữa chừng, không ai gia hạn, key tự hết hạn và pod khác lấy được.
Ba thứ đó ghép lại trông rất kín. Kẽ hở nằm ở chỗ chúng không biết nhau.
Hai ngõ cụt trước khi nhìn đúng chỗ
Giả thuyết đầu tiên của tôi đi thẳng vào dòng lỗi: watchdog hỏng nên lock hết hạn. Đặt hai dòng log cạnh nhau: pod thứ hai lấy được lock đúng 30 giây sau khi pod thứ nhất bắt đầu giữ, khớp y hệt hạn dùng mặc định của key. Khớp tới mức tôi suýt chốt là "mất kết nối tạm thời", fix là cho watchdog thử lại.
Cái kéo tôi lại là log của Sentinel. Giữa hai dòng log kia có một dòng +switch-master: master đã bị thay. Nghĩa là pod thứ hai không lấy lock trên cái master mà pod thứ nhất đã ghi vào. Nó lấy trên một master khác, còn master cũ đã chết. Câu hỏi đúng phải là: master mới có từng có key lock hay không?
Giả thuyết thứ hai: pod thứ nhất tự nhả lock khi mất kết nối, kiểu client thấy đứt kết nối thì dọn dẹp. Lọc tiếp log pod đó: không có dòng released nào. Ngược lại, lúc batch xong hơn hai phút sau, lệnh unlock() của nó văng IllegalMonitorStateException: attempt to unlock lock, not locked by current thread. Dịch ra lời thường: "anh đang cố nhả một cái lock không phải của anh". Lock không bị nhả. Nó đã đổi chủ từ lâu mà pod thứ nhất không hay.
Đặt tất cả lên một trục thời gian, lấy mốc 0 là lúc pod thứ nhất lấy được lock:
T+0s     pod-1     acquired lock lock:eod-interest              (master 10.0.1.5)
T+4s     node      master Redis chet dot ngot (node het bo nho)
T+10s    pod-1     Can't update lock lock:eod-interest expiration
                   org.redisson.client.RedisTimeoutException     (watchdog ban dung luc master chet)
T+10s    sentinel  +switch-master mymaster 10.0.1.5 6379 10.0.1.6 6379
T+30s    pod-2     acquired lock lock:eod-interest              (master MOI 10.0.1.6)
T+2m10s  pod-1     batch xong; unlock() -> IllegalMonitorStateException
Đọc từ trên xuống: master chết ở giây thứ 4. Watchdog của pod-1 đến kỳ gia hạn ở giây thứ 10, gửi lệnh vào một master không còn tồn tại, chờ hết thời gian và in ra dòng lỗi tôi thấy đầu tiên. Cùng lúc đó Sentinel bầu replica 10.0.1.6 lên. Pod-2 đứng chờ từ giây 0 và được Redisson đánh thức khi hết hạn dùng của key nó thấy lúc thử, tức 30 giây. Nó kết nối sang master mới, xin lock lần nữa, và được. Vì trên master mới, key lock:eod-interest chưa từng tồn tại, hoặc đã tồn tại mà không còn ai gia hạn. Cuối bài bạn sẽ thấy đêm đó cả hai khả năng đều đúng.
Cơ chế: lock chỉ được hứa trên một máy
Lock Redis chỉ là một key có hạn dùng, và lệnh SET NX chỉ hứa "một người lấy được" trên một máy. Thêm replica thì key phải chép sang theo kiểu bất đồng bộ, và một lần failover rơi đúng khoảng chép là mất lock.
Redis docs mô tả lock trên một instance bằng đúng một lệnh:
SET resource_name my_random_value NX PX 30000
NX là "chỉ ghi khi key chưa có", PX 30000 là "tự xoá sau 30 giây", còn my_random_value là dấu riêng của người giữ, để lúc nhả chỉ xoá đúng key mình đặt. Redisson làm gần y hệt, chỉ thêm một script gia hạn với điều kiện key còn và đúng chủ.
Vấn đề bắt đầu khi ta muốn Redis không bao giờ chết, nên thêm replica và Sentinel. Từ đây key lock phải đi thêm một chặng, từ master sang replica, và chặng đó là chặng chép sau (bài single-leader replication trong khoá Dữ liệu Phân tán giải thích kỹ vì sao). Client nhận OK không có nghĩa là replica đã có key. Khoảng trống đó bình thường chỉ vài mili-giây, nhưng nó tồn tại, và một lần failover rơi đúng vào đó là đủ.
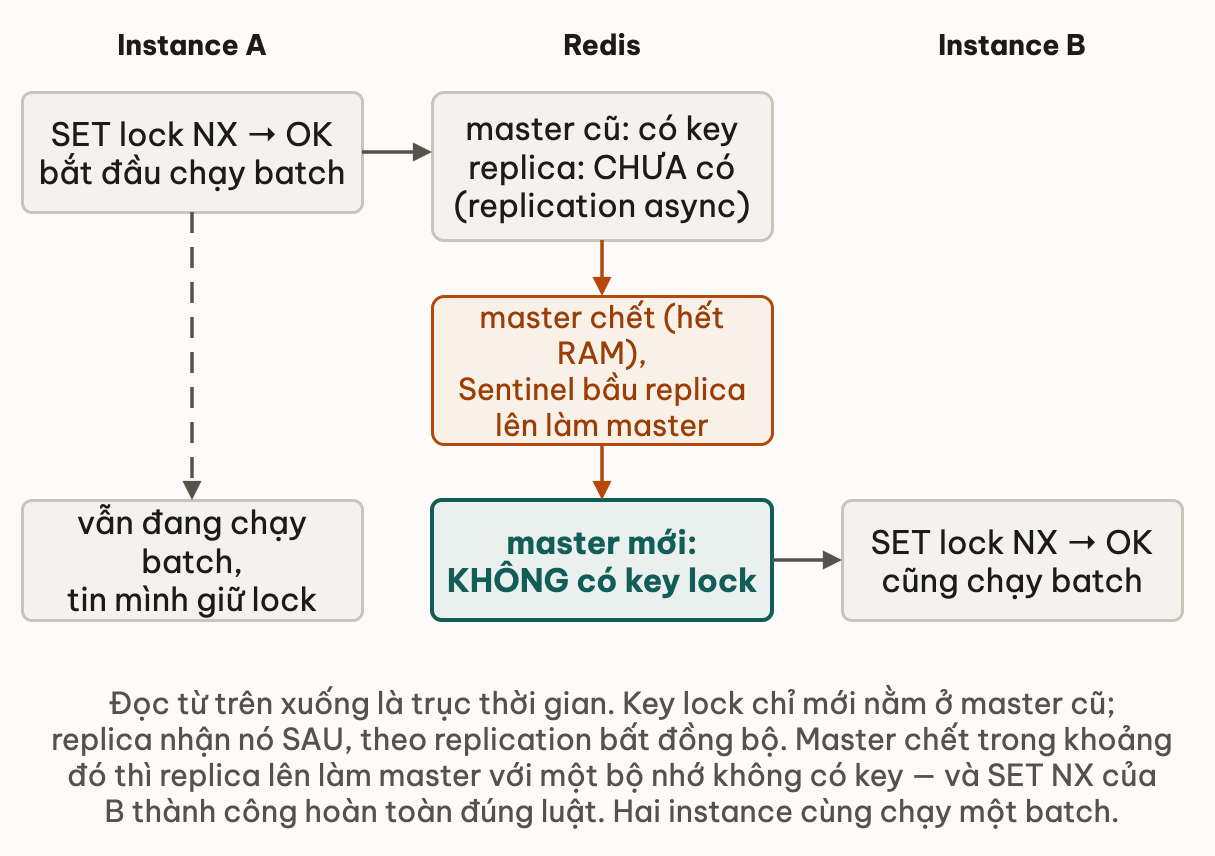
Redis docs không giấu chuyện này. Mục "Why Failover-based Implementations Are Not Enough" mô tả đúng chuỗi trên trong bốn bước, giải thích because Redis replication is asynchronous, rồi đóng bằng hai chữ in hoa: SAFETY VIOLATION!. Với Redis, lock chỉ là một lệnh ghi như mọi lệnh ghi khác.
Vậy sao cái lock đó chạy hàng tháng không sao? Vì cửa sổ chỉ mở khi đang có lock sống và master chết đúng lúc đó. Từ Redis 7.0, tắt master "tử tế" bằng SHUTDOWN hay SIGTERM còn chờ replica đuổi kịp tối đa 10 giây, nên bảo trì định kỳ hiếm khi rơi vào cửa sổ này. Node hết bộ nhớ, mất điện, VM treo thì không chờ ai. Đêm đó là loại chết thứ hai.
Watchdog đứng ở đâu trong chuyện này?
Watchdog không làm key rơi khỏi replica. Nhưng ở bản Redisson chúng tôi dùng đêm đó (nhánh 3.15), nó là lỗ thứ hai, và lỗ này một mình cũng đủ: gặp lỗi một lần là ngừng gia hạn vĩnh viễn.
Tôi đọc source RedissonBaseLock bản 3.15.6. Nếu lệnh gia hạn ném exception, nó ghi log.error("Can't update lock … expiration") rồi xoá lock khỏi danh sách cần gia hạn, không lên lịch chạy lại.
Ghép vào trục thời gian. Giả sử replica 10.0.1.6 có kịp nhận key trước khi master chết. Lên làm master, nó mang theo key với hạn dùng còn khoảng 26 giây. Nhưng watchdog của pod-1 đã "chết" ở giây thứ 10 sau một lần lỗi. Không ai gia hạn. Key hết hạn ở giây thứ 30, đúng lúc pod-2 tỉnh dậy xin lock. Kết cục y hệt kịch bản key chưa sang replica, chỉ khác đường đi.
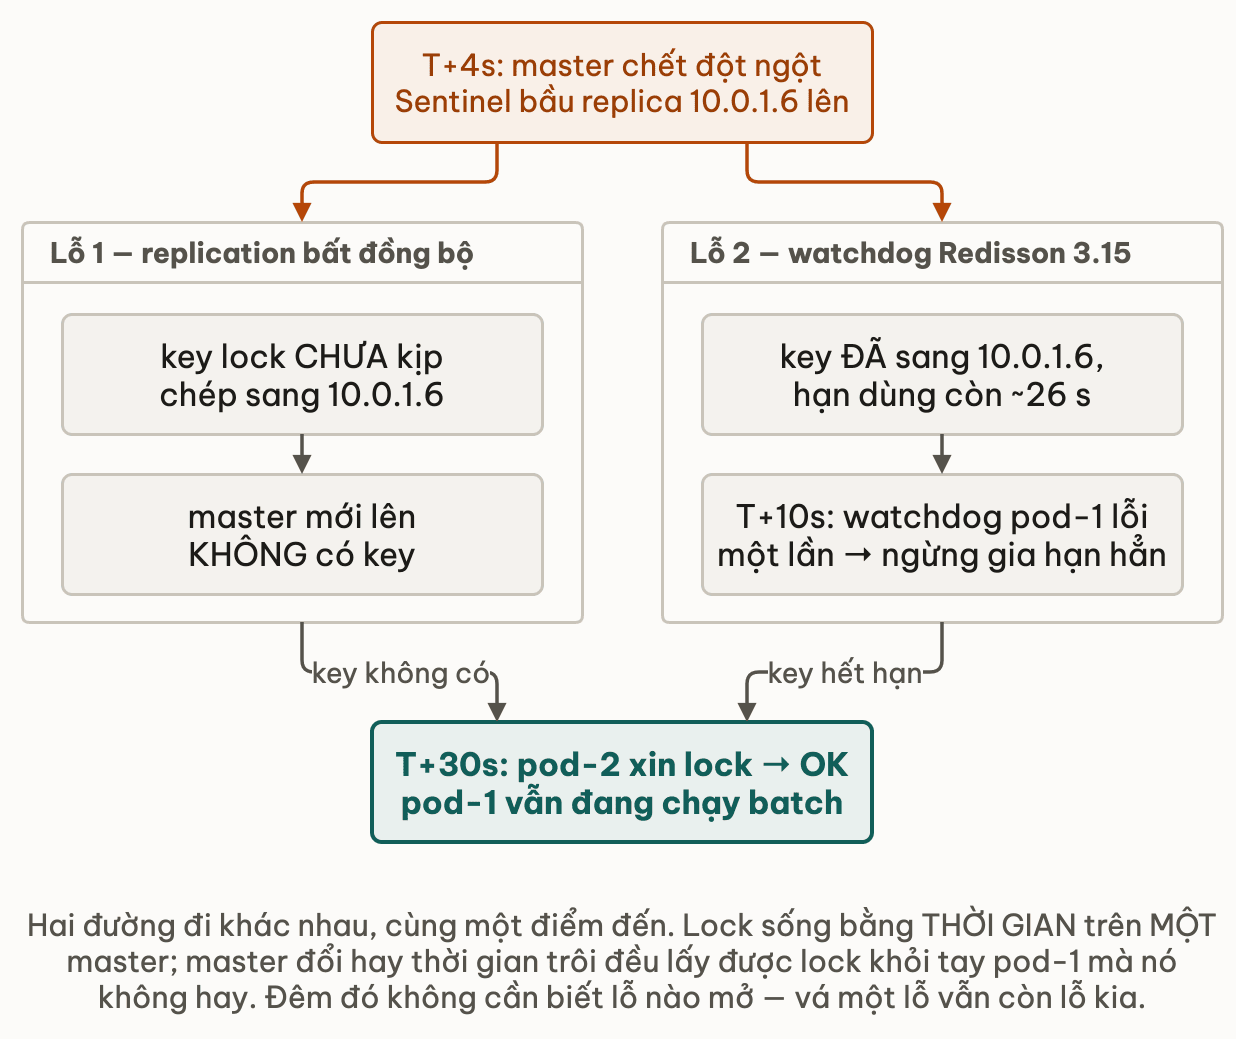
Đêm đó tôi không có cách nào biết lỗ nào nuốt cái lock, và hoá ra điều đó không quan trọng. Cả hai cùng một bản chất: lock sống bằng thời gian trên một master, và cả hai thứ đó đều đổi được dưới chân nó mà nó không hay. Bản Redisson hiện tại đã sửa lỗi ngừng gia hạn, nhưng watchdog vẫn chỉ giữ được lock trên master nó nhìn thấy, và không thể biết đó còn là master thật hay không.
Tự tái hiện bằng Docker
Bạn không cần Sentinel để thấy lỗi này. Một master, một replica, cắt mạng replica để kéo giãn khoảng trống vài mili-giây thành vài giây cho kịp bấm lệnh, giết master, đưa replica lên. Image redis:7-alpine (lúc tôi chạy là 7.4.11):
docker network create rl-net
docker run -d --name rl-master  --network rl-net redis:7-alpine
docker run -d --name rl-replica --network rl-net redis:7-alpine \
  redis-server --replicaof rl-master 6379
# doi INFO replication tren master bao slave0 state=online

docker network disconnect rl-net rl-replica        # replica "cham" - mo phong lag

# Client A lay lock, roi hoi WAIT: da co bao nhieu replica nhan duoc key?
printf 'SET lock:eod-batch client-A NX PX 30000\r\nWAIT 1 1000\r\n' \
  | docker exec -i rl-master redis-cli
# OK
# 0            <-- KHONG replica nao co key

docker kill rl-master                               # SIGKILL: chet dot ngot, khong cho ai
docker network connect rl-net rl-replica
docker exec rl-replica redis-cli REPLICAOF NO ONE   # dong vai Sentinel: bau replica len

docker exec rl-replica redis-cli GET lock:eod-batch
# (nil)        <-- master moi khong biet gi ve lock cua A

docker exec rl-replica redis-cli SET lock:eod-batch client-B NX PX 30000
# OK           <-- client B cung giu lock, A van dang chay
Một replica đang bận, hay một node chết rơi trúng nhịp, cho cùng một kết cục như đoạn cắt mạng ở trên.
SET NX ở trên là bản rút gọn. Tôi chạy lại đúng kịch bản với RLock của Redisson 3.15.6, để chắc là mình đang tái hiện đúng thứ đã hỏng:
master cu:   TYPE lock:eod-interest  -> hash          (Redisson ghi hash {uuid:threadId -> 1})
             PTTL lock:eod-interest  -> 25042         (30 s, watchdog gia han moi 10 s)
master moi:  EXISTS lock:eod-interest -> 0
T+00s [B] tryLock on redis://rl-replica:6379 -> true
T+60s [A] unlock -> IllegalMonitorStateException: attempt to unlock lock,
                    not locked by current thread by node id: 81d190ac-... thread-id: 1
Cùng một cửa sổ, cùng một kết cục. RLock chỉ là một script ghi một hash lên master, và Redis chép nó sang replica không khác gì SET. Thêm một chi tiết: trong bản tái hiện này, watchdog của A không in ra dòng lỗi nào suốt 60 giây. Lệnh gia hạn treo chờ một kết nối tới master không bao giờ quay lại. Nó không biết mình đã mất lock, và cũng không có cách nào để biết.
Bắt replica xác nhận trước có cứu được không?
Câu trả lời thật thà: chưa đủ. Lệnh WAIT bắt replica xác nhận đã nhận key trước khi coi lock là an toàn, nhưng Sentinel chọn master mới theo replica-priority, không theo replica nào đang có key.
Cụ thể, WAIT numreplicas timeout nghĩa là "chờ tới khi ít nhất chừng này replica xác nhận đã nhận các lệnh ghi của tôi". Trong đoạn Docker ở trên, WAIT 1 1000 trả về 0, và một client tử tế sẽ coi là chưa lấy được lock. Redisson cũng có công tắc tương tự, checkLockSyncedSlaves. Nhưng WAIT chỉ đảm bảo một replica nào đó đã có key, còn replica được Sentinel chọn chưa chắc là replica đó.
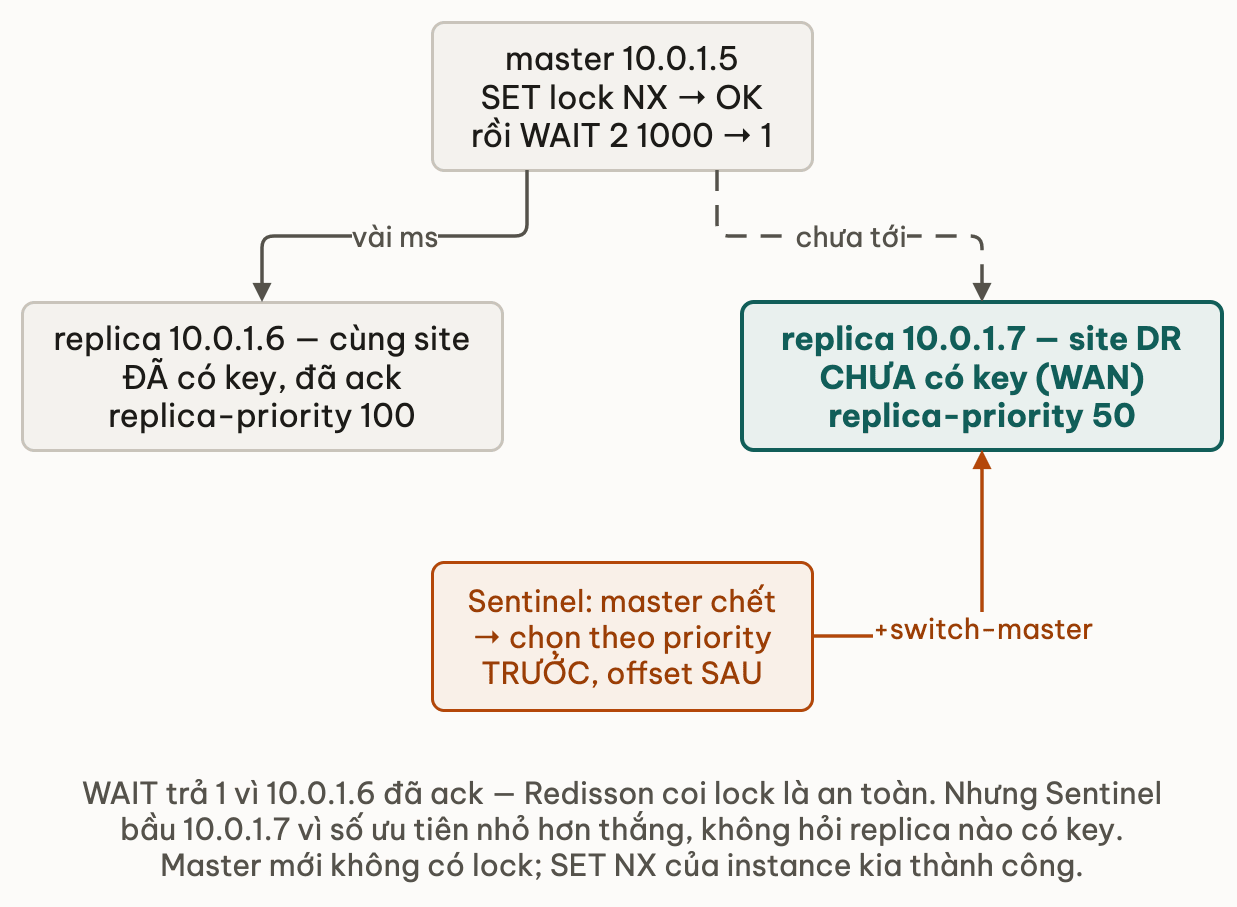
Tài liệu Sentinel ghi thứ tự chọn: replica-priority nhỏ hơn thắng trước, cùng priority mới so xem ai có dữ liệu mới hơn. Đặt replica ở site dự phòng (DR) priority thấp để "site chính chết thì site DR lên" là cấu hình rất bình thường. Và đúng thứ tự đó, replica có key thua replica không có key. Tài liệu WAIT cũng viết trước: it is possible to still lose a write synchronously replicated to multiple replicas. Redis tự gọi cơ chế này là best-effort.
Còn đòi mọi replica phải xác nhận thì chỉ cần một replica chậm là không ai lấy được lock. Redisson từng đi đúng con đường đó rồi phải lùi lại.
Đọc source theo từng tag và đối chiếu changelog: từ 3.13.0 mọi lệnh ghi của RLock đã kèm WAIT <số replica> 1000 nhưng kết quả bị bỏ qua. 3.16.7 mới kiểm, và kiểm nghiêm: thiếu một replica là ném lỗi. 3.17.0 thêm công tắc checkLockSyncedSlaves. 3.17.5 nới còn "ít nhất một replica ack". 3.22.0 mới có slavesSyncTimeout (mặc định 1.000 ms).
Nghĩa là đêm đó pod-1 đã gửi WAIT 2 1000, và Redis trả về một con số mà Redisson 3.15 không thèm nhìn. Nếu con số đó là 2, key đã ở cả hai replica và lock chết bằng lỗ watchdog. Nếu là 1, replica được Sentinel chọn là replica chưa có key, và Sentinel không hỏi replica nào đang có key.
Tôi đã vá bằng gì: hai tầng khoá, tầng nào làm việc của tầng đó
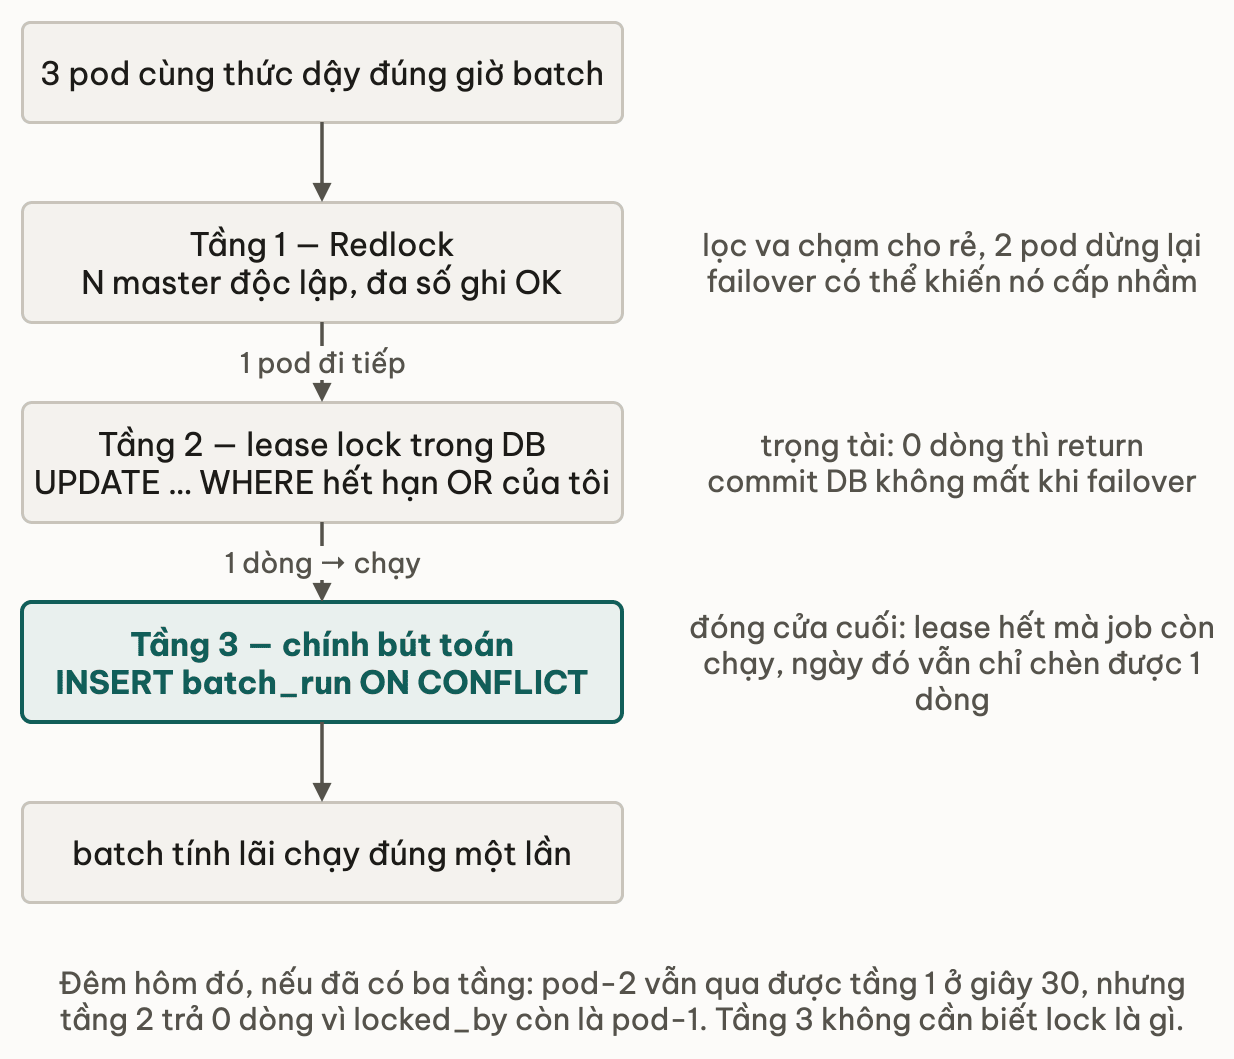
Cách tôi chọn là hai tầng: Redlock (nhiều master độc lập, không replica) lọc va chạm cho rẻ, còn lease lock trong database (một câu UPDATE có điều kiện) là trọng tài cuối, vì commit của database không mất khi Redis failover.
Tầng một vẫn là Redis, nhưng đổi sang Redlock: một nhóm master độc lập, không replica, không Sentinel. RedissonRedLock gom nhiều RLock, lock chỉ tính là lấy được khi ghi thành công trên đa số. Không còn replica thì không còn chặng "chép sau" để mất key.
Tầng hai là một lease lock trong database, cùng database ghi bút toán. "Lease" nghĩa là thuê có hạn: giữ được một khoảng thời gian, muốn giữ tiếp thì gia hạn, không gia hạn thì người khác được vào. Cách làm theo đúng ShedLock: một dòng cho mỗi tên lock, ai xin thì thử UPDATE có điều kiện.
CREATE TABLE batch_lock (
  name          text PRIMARY KEY,   -- 'eod-interest'
  locked_until  timestamptz NOT NULL,
  locked_by     text NOT NULL       -- nodeId cua pod dang giu
);
// commit rieng, ngan - KHONG nhap vao transaction cua batch
@Transactional(propagation = Propagation.REQUIRES_NEW)
@Modifying
@Query(value = """
    update batch_lock
    set locked_until = now() + make_interval(secs => :leaseSeconds), locked_by = :nodeId
    where name = :name
      and (locked_until < now() or locked_by = :nodeId)
    """, nativeQuery = true)
int tryLock(@Param("name") String name, @Param("nodeId") String nodeId,
            @Param("leaseSeconds") long leaseSeconds);
Câu lệnh đọc bằng lời thường là: "cho tôi giữ lock này thêm leaseSeconds giây, nếu lock đã hết hạn hoặc chính tôi đang giữ". Sửa được một dòng nghĩa là bạn giữ lock; không dòng nào nghĩa là pod khác đang giữ và chưa hết hạn. Pod giữ lock gọi lại tryLock định kỳ để gia hạn; pod đó chết thì lease tự hết, pod khác vào được. Một câu lệnh, database phán. REQUIRES_NEW là bắt buộc: nếu để mặc định, câu UPDATE này nhập vào transaction của service gọi nó và chỉ commit khi batch xong, nghĩa là pod khác không thấy lock suốt lúc batch chạy.
Vì sao cần cả hai? Vì hai tầng trả lời hai câu hỏi khác nhau. Tầng Redis trả lời "ai được đi tiếp" cho rẻ: ba pod cùng thức dậy, hai pod đứng chờ ở Redis, chỉ một pod chạm tới database. Tầng database trả lời "ai thật sự được chạy": một câu UPDATE đã commit thì không failover nào của Redis xoá được. Ghép vào đêm hôm đó: pod-2 vẫn lấy được lock Redis ở giây thứ 30, nhưng tryLock ở database trả về 0 dòng vì locked_by vẫn là pod-1 và chưa hết hạn. Nó bỏ qua. Batch chạy một lần.
Có ba điều tôi biết rõ về cấu hình này, và không giấu.
Một, tầng Redlock mang theo giới hạn của chính nó. Redisson đánh dấu RedLock deprecated từ 3.12.5, trước cả bản tôi đang dùng; tài liệu hiện tại ghi superseded by RLock and RFencedLock. Redis docs mục Crash Recovery and fsync còn đòi fsync=always hoặc khởi động lại chậm hơn TTL, vì master restart mà không ghi đĩa sẽ quên key đang giữ. Tôi chấp nhận, vì tầng này chỉ còn là bộ lọc; nó sai thì database vẫn đỡ.
Hai, tầng database vẫn là một lock sống bằng thời gian. Lease hết mà batch chưa xong (pod bị process pause dài hơn leaseSeconds, hoặc quên gia hạn) thì pod khác vào được, đúng như bài phân tích của Martin Kleppmann mô tả. Cái tôi mua được ở tầng này là một nguồn sự thật không mất key khi failover; cái chưa mua được là fencing.
Ba, và đây là tầng đóng nốt cửa cuối: không phải lock. Đó là làm cho chính bút toán biết từ chối chạy hai lần, điều bài partial failure & fencing token trong khoá Hệ thống Dữ liệu Phân tán gọi là đặt điểm kiểm tra ở chính tài nguyên bị ghi. Với batch tính lãi, nó rẻ bất ngờ: một bảng batch_run(batch_date PRIMARY KEY) và một INSERT … ON CONFLICT DO NOTHING trước khi ghi lãi, giống cách UNIQUE làm trọng tài thay cho exists trên app. Lock có nói dối cũng không sao, vì ngày đó chỉ chèn được một dòng. Bài @Scheduled nhiều instance gọi đây là job idempotent và đặt nó trên mọi cơ chế khoá. Tôi đến kết luận đó muộn hơn bài, sau khi đã dựng cả hai tầng lock.
// SAI - lock Redis la trong tai duy nhat
RLock lock = redisson.getLock("lock:eod-interest");
lock.lock();
try {
    runInterestBatch(today);          // failover chen vao day -> chay hai lan
} finally {
    lock.unlock();
}

// DUNG - Redis loc va cham, DB lease lock phan, but toan tu chong trung
RLock lock = redisson.getRedLock(lockA, lockB, lockC);   // N master doc lap
lock.lock();
try {
    if (batchLockRepo.tryLock("eod-interest", nodeId, 300) == 0) {
        return;                       // pod khac dang giu lease trong DB
    }
    // ben trong: INSERT batch_run ON CONFLICT DO NOTHING
    runInterestBatch(today);
} finally {
    lock.unlock();
}
"Dùng cái gì" là câu hỏi sai. Câu đúng là cứu được gì?, và bảng dưới trả lời theo câu đó:
| Phương án | Cứu được failover? | Cứu được pause / hết hạn? | Giá phải trả |
|---|---|---|---|
SET NX PX một master + replica | Không | Không | Rẻ nhất, và đúng bug bài này |
Thêm WAIT / checkLockSyncedSlaves | Chỉ thu hẹp cửa sổ, docs nói rõ best-effort | Không | Chậm thêm tới slavesSyncTimeout mỗi lần xin lock |
| Redlock (N master độc lập) | Có, nếu đa số master còn sống | Không | Vận hành N master; Redisson deprecate từ 3.12.5 |
| Lease lock trong DB (kiểu ShedLock) | Có: một nguồn sự thật, commit bền | Không (vẫn là lease) | Mỗi lần xin lock là một UPDATE; cần tầng lọc phía trước nếu nhiều instance |
| Hai tầng Redlock + DB lease (fix của tôi) | Có | Không | Vận hành cả hai; DB chỉ chịu tải của pod thắng Redis |
Bút toán tự chống trùng (batch_date PK / fencing token) | Có | Có | Phải sửa chỗ ghi để nó biết từ chối |
Hai tầng khoá đó vẫn chạy tới giờ, và chưa để batch tính lãi chạy hai lần thêm lần nào. Nhưng mỗi lần thấy lại dòng Can't update lock lock:eod-interest expiration trong log staging, giờ là của một master lẻ chết theo kịch bản diễn tập, tôi vẫn thấy đúng thứ đã thấy sáng hôm đó: một cái lock đang báo là nó không chắc về chính nó. Tầng Redis làm nó ít nói dối hơn. Tầng database làm nó nói dối cũng không sao. Còn cái làm tôi ngủ yên là một dòng PRIMARY KEY (batch_date), thứ chẳng cần biết lock là gì.
Bài viết này đáng chia sẻ?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Sẵn sàng học sâu hơn?
Biến những gì vừa đọc thành kỹ năng thật với khoá học của OLHub, hoặc mang câu hỏi của bạn ra thảo luận cùng cộng đồng.
Đọc tiếp
Bài viết liên quan
Vì sao check trùng bằng SELECT trên nhiều pod vẫn lệch dữ liệu?
Hai pod cùng SELECT check trùng rồi INSERT vẫn lệch. UNIQUE chốt tạo mới; số dư nên cộng/trừ atomic hoặc FOR UPDATE — @Version không phải lựa chọn đầu cho tiền.
Bọc transaction vẫn lệch số: bẫy isolation level READ COMMITTED
Báo cáo bọc trong BEGIN/COMMIT vẫn in ba dòng không cộng được: ở READ COMMITTED mỗi câu lệnh lấy một ảnh chụp mới, transaction không đóng băng dữ liệu.
@Component, @Service, @Repository khác gì, thay được nhau không?
@Service, @Repository, @Controller đều là @Component bên dưới — nhưng chỉ @Repository dịch exception, nên đổi nhầm annotation có thể lặng lẽ làm hỏng app.
N+1 query: vì sao một lần xuất sao kê bắn ra 5.001 câu SQL?
Xuất sao kê treo chục giây vì Hibernate bắn 5.001 câu SQL thay vì 1 — còn màn danh sách phân trang thì che giấu bug. Cơ chế N+1 query trong JPA và 4 cách fix.