Representation: lớp ẩn tự học ra đặc trưng của dữ liệu
Lớp ẩn không giữ dữ liệu thô mà giữ một cách mô tả có ích cho nhiệm vụ. Đó là gốc chung của embedding trong search và attention trong transformer.
TL;DR: Khi mạng nơ-ron học một nhiệm vụ, thứ đáng giá nhất thường không nằm ở đầu ra mà ở giữa: những vector ở lớp ẩn mà mạng tự dựng để mô tả dữ liệu theo cách có ích cho nhiệm vụ đang tối ưu. Đó là representation học được (biểu diễn học được). Mạng tự quyết định giữ lại gì qua quá trình giảm loss, không cần người thiết kế từng đặc trưng. Vì representation phản ánh cấu trúc chung của dữ liệu chứ không gắn chặt với một đầu ra, nó dùng lại được, và đó là nền chung của embedding trong semantic search lẫn attention trong transformer.
1. Học task A thì task B được lợi gì?
Một nhóm kỹ sư train mạng phân loại 1.000 loại ảnh (hoa, xe, đồ ăn...) trên hàng triệu ảnh. Xong, họ bỏ lớp phân loại cuối, gắn một lớp ra mới, rồi fine-tune với vài trăm ảnh X-quang phổi để chẩn đoán bệnh. Nhiệm vụ khác hẳn, dữ liệu ít hơn hàng nghìn lần, vậy mà kết quả thường tốt hơn hẳn so với train từ đầu trên chừng đó ảnh. Kỹ thuật này gọi là transfer learning.
Lớp cuối (lớp phân loại) chứa quyết định "đây là hoa hay xe", và nó đã bị bỏ đi. Vậy phần kiến thức nào của mạng đã được chuyển sang bài toán X-quang, và nó nằm ở đâu?
Kiến thức đó nằm ở các lớp ẩn. Sau huấn luyện, mỗi lớp ẩn đã học cách biến dữ liệu đầu vào thành một representation phản ánh cấu trúc của dữ liệu theo cách có ích cho nhiệm vụ. Cạnh, hình khối, kết cấu bề mặt: những đặc điểm này có trong ảnh hoa cũng như ảnh phổi. Representation học từ task A vì thế vẫn có ích cho task B.
Thứ đáng giá nhất không nằm ở đầu ra, mà ở giữa.
2. Vector ở lớp ẩn là gì?
Mỗi lớp áp một phép biến đổi tuyến tính rồi cho qua hàm phi tuyến. Nhờ phi tuyến mà nhiều lớp chồng nhau không gộp được thành một lớp, và mỗi lớp học được thứ khác nhau.
Theo dõi vector dữ liệu qua từng lớp. Đầu vào là một vector thô: các pixel của ảnh, hay các con số đại diện cho từng từ trong câu. Qua lớp thứ nhất, vector đó biến thành một vector khác. Qua lớp thứ hai, biến đổi tiếp. Tới lớp ẩn cuối, vector ở đó là thứ mạng "thấy" khi nhìn dữ liệu.
Vector này không phải pixel gốc, cũng không phải nhãn phân loại. Nó là một representation trung gian: cách mạng mã hoá thông tin về dữ liệu ở dạng có ích nhất cho nhiệm vụ đang tối ưu.
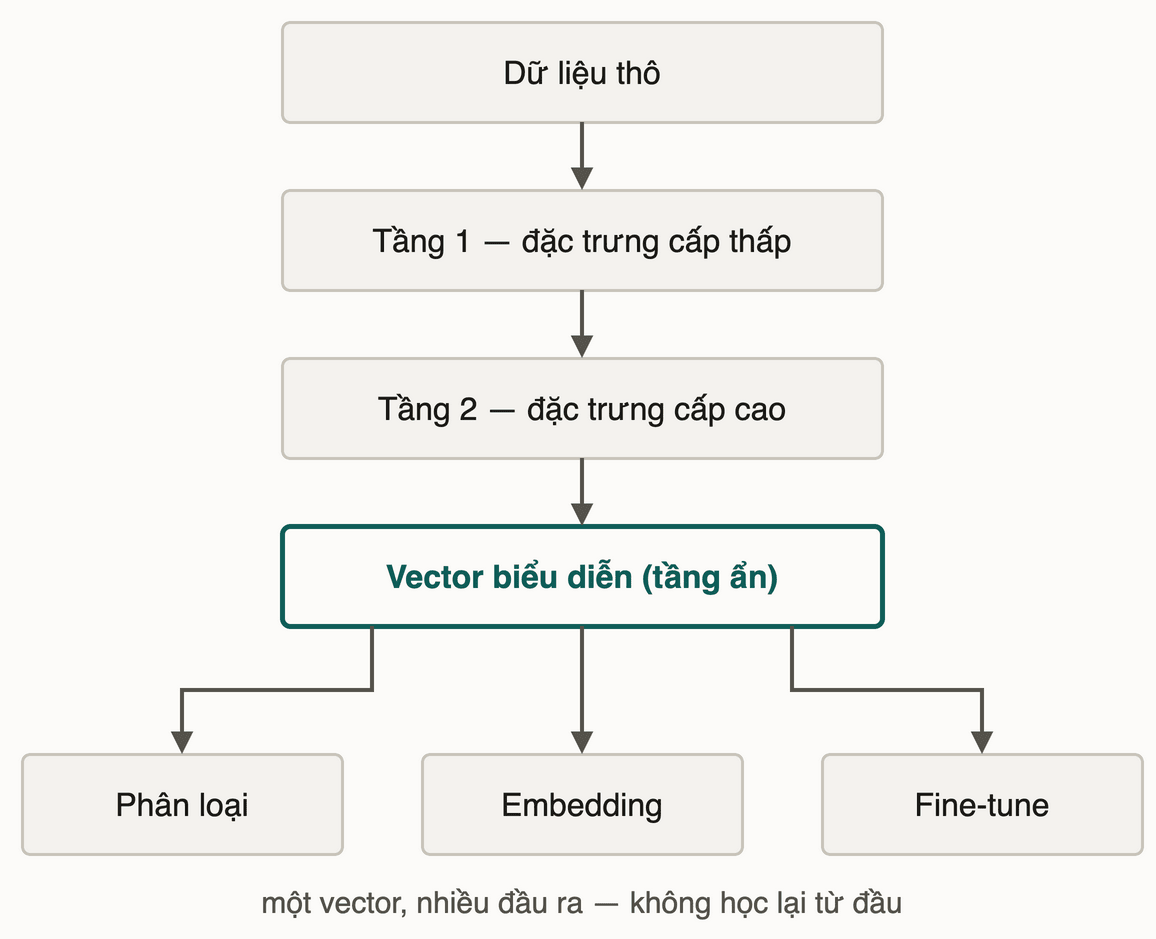
Điểm cốt lõi của hình: cùng một vector representation phục vụ được nhiều đầu ra mà không phải học lại từ đầu. Transfer learning chạy được là nhờ vậy, và embedding lẫn attention cũng dựng trên cùng nền này.
Representation ở các lớp khác nhau có độ trừu tượng khác nhau: lớp đầu bắt những đặc điểm bề mặt, lớp sâu hơn tổ hợp chúng thành khái niệm cấp cao hơn. Cấu trúc phân cấp này nổi lên từ quá trình tối ưu, không ai thiết kế tường minh.
3. Feature do người thiết kế và feature mạng tự học khác nhau thế nào?
Trước khi deep learning phổ biến, "đặc trưng" (feature) là thứ kỹ sư phải tự thiết kế. Phân loại email spam: kỹ sư đếm từ khoá đáng ngờ, tỉ lệ chữ hoa, số link. Phân loại văn bản: kỹ sư dựng bảng TF-IDF. Feature phản ánh hiểu biết của con người về bài toán: dễ giải thích, nhưng bỏ sót những pattern phức tạp mà con người không đặt được tên.
Deep learning đảo ngược chuyện này. Thay vì bảo mạng "hãy nhìn tỉ lệ chữ hoa", bạn chỉ bảo "phân biệt cho đúng, tự tìm cách nhìn dữ liệu". Qua quá trình giảm loss, mạng tự khám phá ra đặc trưng có ích. Những đặc trưng này không nhất thiết có tên trong từ điển của con người; chúng tồn tại như những hướng trong một không gian vector nhiều chiều. Đó là khác biệt về bản chất giữa deep learning và machine learning cổ điển.
Với mỗi lớp trong một mạng phân loại ticket hỗ trợ, dự đoán loại thông tin nào có thể được bắt ở đó. Ghi ra trước, rồi đọc mục 4 để đối chiếu.
layer_1_output = transform(raw_text)        // bắt: ???
layer_2_output = transform(layer_1_output)  // bắt: ???
hidden_repr    = transform(layer_2_output)  // tổng hợp: ???
4. Ví dụ: phân loại ticket hỗ trợ nội bộ
Một công ty phần mềm phân loại ticket hỗ trợ. Đầu vào là văn bản ticket, đầu ra là nhãn billing (thanh toán) hoặc usage (cách dùng). Mạng có ba lớp ẩn, và sau khi huấn luyện:
Lớp 1, đặc điểm bề mặt: vector ở lớp đầu phân biệt các từ khoá hay gặp ("hoá đơn", "lỗi", "cách dùng"), độ dài câu, có chứa số tiền hay không. Đây là những thứ gần dữ liệu gốc, cũng là thứ kỹ sư sẽ tự thiết kế nếu làm tay.
Lớp 2, tổ hợp khái niệm: vector ở lớp hai bắt đầu gộp: "câu ngắn + từ 'lỗi' + có số tiền" thành một dấu hiệu "có vẻ là khiếu nại thanh toán". Mạng tự dựng những tổ hợp này vì chúng giúp giảm loss.
Lớp ẩn cuối, representation tổng hợp: vector ở đây đã mã hoá "cách mạng hiểu ticket này" theo những trục chính của bài toán. Đây là representation học được, thứ dùng lại được cho nhiệm vụ khác mà không phải train lại từ đầu.
Đáp án cho bài tự điền ở mục 3:
layer_1_output = transform(raw_text)        // bắt: từ khoá, độ dài, số tiền
layer_2_output = transform(layer_1_output)  // bắt: tổ hợp dấu hiệu (kiểu vấn đề)
hidden_repr    = transform(layer_2_output)  // tổng hợp: representation theo trục billing/usage
5. Representation mở ra những gì?
Representation học được không chỉ là chuyện bên trong mạng. Nó là nền chung của hai thứ bạn sẽ gặp ở các module sau.
5.1 Representation dùng lại được: nền của embedding
Nếu vector ở lớp ẩn đã mã hoá đủ thông tin, bạn không cần lớp ra nữa, chỉ cần chính vector đó. So hai vector bằng cosine similarity là biết hai mẫu "giống nhau" tới đâu theo tiêu chí mạng đã học.
Đó chính xác là việc embedding làm: đưa dữ liệu thô vào mạng, lấy vector ở lớp ẩn làm đầu ra, rồi dùng vector để tìm kiếm, gom nhóm hay so sánh. "Hoá đơn tháng 3 chưa được xử lý" và "Tôi vẫn chưa nhận được thanh toán" có thể cho hai vector rất gần nhau nếu mạng đã học rằng cả hai nói về cùng một loại vấn đề.
Module 5, bài 01: Embedding và không gian nghĩa đi sâu cơ chế này: văn bản thành vector, các vector nằm chung một không gian, và "khoảng cách" trong không gian đó phản ánh độ giống nhau theo tiêu chí mạng đã học.
5.2 "Gần nhau" là gần theo tiêu chí của mạng, không phải theo cảm nhận người đọc
Đây là chỗ tinh tế, cũng là chỗ gây hiểu lầm nhiều nhất khi dùng embedding thật.
"Hai văn bản có embedding gần nhau" không có nghĩa tuyệt đối; nó có nghĩa gần theo tiêu chí model đó đã tối ưu. Model train để phân loại chủ đề sẽ coi "Hợp đồng ký tháng trước" và "Hoá đơn cần thanh toán" là gần nhau (cùng nhóm tài chính). Model train để phân tích cảm xúc lại coi "Sản phẩm tuyệt vời" và "Dịch vụ xuất sắc" là gần nhau, dù hai câu nói về hai thứ khác hẳn.
Cùng hai câu, hai model cho hai khoảng cách khác nhau. Đây là gốc của nhiều hiểu lầm về semantic search: người dùng tìm "câu cùng nghĩa", còn model trả về "câu gần theo tiêu chí huấn luyện của model". Module 5 quay lại điểm này khi phân tích cosine similarity và những ca semantic search trả kết quả sai.
5.3 Attention làm việc trên chính các vector representation
Trong transformer, mỗi token không tồn tại dưới dạng chữ gốc mà dưới dạng một vector representation. Attention là cơ chế trộn các vector đó theo ngữ cảnh: representation của một token được cập nhật dựa trên representation của các token khác trong cùng câu.
Attention không thao tác trên chữ "hoá" hay "đơn" mà trên vector representation của chúng. Hiểu representation là gì thì module 4: Transformer & attention mới có nghĩa cơ chế, không chỉ là công thức toán.
6. Cảnh báo: representation không phải là "hiểu"
Module 1, bài 06: pretraining là self-supervised, nhãn tự sinh từ chính văn bản, không cần người gán. Mọi thứ model biết nằm trong trọng số, được tối ưu để giảm một loss cụ thể trên một tập dữ liệu cụ thể.
Representation là thứ mạng học ra để làm tốt nhiệm vụ huấn luyện, không hơn không kém. Nhiệm vụ đổi thì thứ được giữ lại cũng đổi: model train để phân loại chủ đề không học ra representation tốt cho phân tích cảm xúc, dù cả hai xử lý cùng loại văn bản.
LLM được tối ưu cho việc đoán token kế tiếp. Representation của nó có ích để viết tiếp văn bản cho trôi chảy, không phải để lưu sự thật. Khi model sinh ra một câu nghe hợp lý nhưng sai sự thật, đó là hệ quả trực tiếp của nhiệm vụ huấn luyện chứ không phải lỗi ngẫu nhiên.
Thử ngẫmmột diễn viên đóng vai bác sĩ, thoại nghe rất chuyên môn và tự tin. Diễn viên đó có "hiểu y khoa" không, và một LLM trả lời nghe hợp lý thì sao?
7. Ba cái bẫy thường gặp
Bẫy 1: đọc nghĩa từng chiều của vector. Người mới hay hỏi "chiều thứ 42 của vector nghĩa là gì?". Không có tương ứng một-một giữa một chiều và một khái niệm con người đặt tên. Representation phân tán trên cả không gian vector; một khái niệm tồn tại như một hướng trong không gian nhiều chiều, không phải một ô riêng đọc được.
Bẫy 2: coi mỗi neuron ứng với một khái niệm. Đơn giản hoá quá mức. Một neuron thường phản ứng với nhiều thứ tuỳ ngữ cảnh, và một khái niệm thường kích hoạt nhiều neuron cùng lúc (hiện tượng superposition). Soi từng neuron riêng lẻ không cho biết mạng đang dùng khái niệm gì.
Bẫy 3: so vector giữa hai model khác nhau. Mỗi model học một không gian representation riêng, và các trục, các hướng của hai không gian không tương ứng nhau. Lấy embedding từ model A đi tìm trong index do model B tạo sẽ ra kết quả vô nghĩa, dù hai vector cùng số chiều. Module 5 quay lại bẫy này khi bàn về những ca semantic search hỏng.
8. Đào sâu
- Bengio, Courville & Vincent (2013), Representation Learning: A Review and New Perspectives, arXiv:1206.5538. Tổng quan kinh điển về học representation: vì sao representation quan trọng, các cách học không nhãn, và câu hỏi disentanglement (tách rời các nhân tố ẩn sinh ra dữ liệu). Phần abstract và mục 1 đủ cho bức tranh tổng thể.
- Mikolov et al. (2013), Efficient Estimation of Word Representations in Vector Space, arXiv:1301.3781. Paper giới thiệu Word2Vec, học word embedding từ văn bản quy mô lớn, kèm minh chứng phép tính trên vector ("king" trừ "man" cộng "woman" gần "queen"). Ví dụ kinh điển cho thấy representation học được mang cấu trúc có nghĩa.
9. Liên hệ các bài khác
- Bài 02: Xếp lớp và phi tuyến: không có phi tuyến thì nhiều lớp vẫn chỉ là một phép biến đổi tuyến tính, và representation không phân cấp được.
- Module 5, bài 01: Embedding và không gian nghĩa: representation học được là nền của embedding; bài đó giải thích vector ở lớp ẩn phục vụ semantic search ra sao.
- Module 5, bài 02: Cosine similarity: cách đo "gần nhau" trong không gian representation, áp thẳng điểm ở mục 5.2.
- Module 4, bài 02: Attention: attention trộn các vector representation của token, bài này là điều kiện để đọc nó.
10. Tóm tắt
- Ảnh hoa và ảnh phổi chung cạnh, hình khối, kết cấu, nên representation học từ ảnh hoa giúp được bài X-quang.
- Lớp 1 bắt từ khoá và số tiền; lớp 2 gộp thành "có vẻ là khiếu nại thanh toán"; lớp cuối mã hoá trục billing/usage.
- Model phân loại chủ đề và model phân tích cảm xúc cho hai khoảng cách khác nhau với cùng hai câu.
- Embedding từ model A không dùng được với index do model B tạo, dù cùng số chiều.
11. Tự kiểm tra
- Q1Vì sao vector ở lớp ẩn cuối thường có ích hơn dữ liệu thô cho nhiều nhiệm vụ khác nhau?
- Q2Khác biệt cốt lõi giữa feature engineering thủ công và representation học được là gì?
- Q3Vì sao hai mẫu có embedding gần nhau không có nghĩa là chúng 'giống nhau' theo cách người dùng hiểu?
- Q4Vì sao không thể lấy embedding từ model A rồi tìm trong index do model B tạo, dù hai bên cùng số chiều vector?
- Q5Representation của LLM được tối ưu cho nhiệm vụ gì? Điều đó giải thích hallucination ra sao?
Bài tiếp theo: Mini-challenge: chẩn đoán ba đường cong huấn luyện hỏng
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tham số và siêu tham số: 7 tỷ tham số nghĩa là gì
Bài tiếpMini-challenge: chẩn đoán ba đường cong huấn luyện hỏng
Thảo luận & góp ý
Hỏi đáp về bài này