Loss: gom cái sai của model về một con số duy nhất
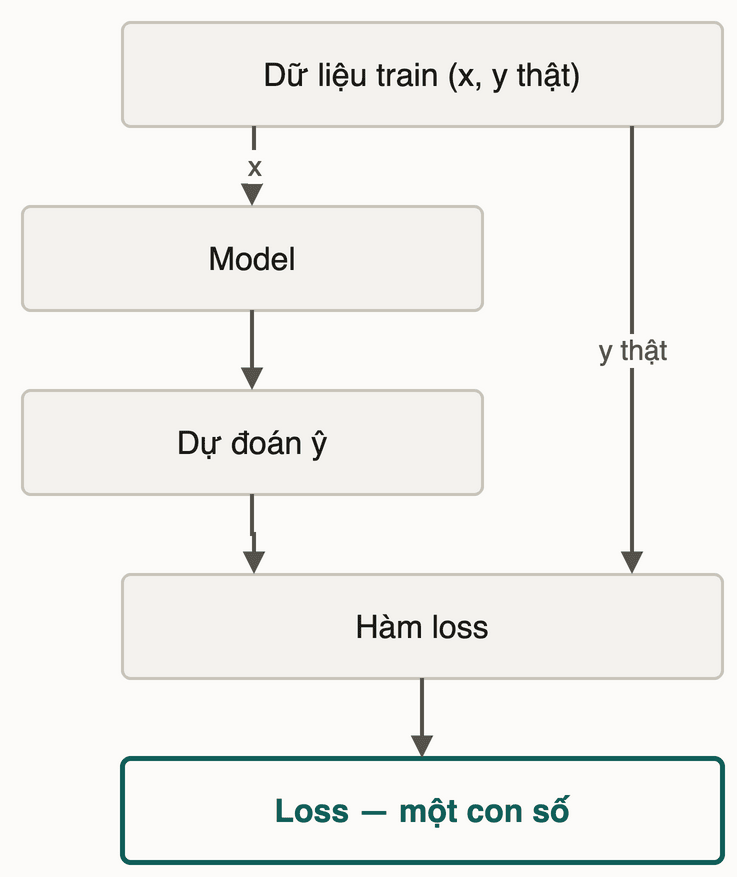
Loss biến toàn bộ sai lệch giữa dự đoán và nhãn thành một con số để tối ưu. Chọn loss nào là quyết định thiết kế, vì nó định nghĩa thế nào là sai.
TL;DR: Một neural net có thể có hàng triệu trọng số. Muốn tự chỉnh, nó cần biết "mình đang sai bao nhiêu" dưới dạng đúng một con số, và con số đó là loss. Loss nhận dự đoán và nhãn thật của cả tập rồi trả về một số không âm: gần 0 là gần đúng, càng lớn càng sai. Bài này đi qua cơ chế, hai họ loss phổ biến (MSE cho bài đoán số, cross-entropy cho phân loại), và điểm quan trọng nhất: chọn loss không phải chi tiết vặt. Loss định nghĩa "sai" là gì, và model sẽ tối ưu đúng định nghĩa đó.
1. "Model này sai": nhận xét định tính thì thiếu gì?
Bạn build một service phân loại email spam. Chạy model lần đầu, nhìn vài kết quả, thấy sai kha khá. Bạn nói: "Model này sai." Câu đó đúng, nhưng máy tính không làm được gì với nó.
Muốn model tự cải thiện, tức chỉnh hàng triệu trọng số để dự đoán tốt hơn, nó cần một mục tiêu bằng số: sai bao nhiêu, đang giảm hay đang tăng? Không có số thì không có hướng để đi.
Loss (hàm mất mát, loss function) biến nhận xét "model này sai" thành một con số cụ thể mà quá trình học tối ưu được. Mọi vòng cập nhật trọng số đều bắt đầu từ đây.
Analogy: loss như bản tóm tắt build. Chạy CI xong, bạn không muốn đọc 2.000 dòng log lẻ rồi tự đoán "đang tốt lên hay tệ đi". Bạn muốn một con số, kiểu "3 errors, 0 warnings", rồi push tiếp và xem nó giảm không. Loss làm đúng việc đó cho neural net: thay vì "mẫu 1 sai 0.3, mẫu 2 sai 0.8, mẫu 3 đúng...", bạn có một con số tổng cho cả tập, và sau mỗi epoch (một lượt học hết tập) bạn nhìn xem nó giảm hay tăng.
| Trong lập trình | Trong ML |
|---|---|
| Code đang build | Bộ trọng số hiện tại của model |
| Test suite chạy trên code | Tập huấn luyện chạy qua model |
| "3 errors" từ CI | Loss: sai lệch gộp lại |
| Sửa lỗi, commit, push | Cập nhật trọng số (gradient descent) |
| Build xanh | Loss về gần mức thấp nhất đạt được |
2. Loss được tính ra sao từ dự đoán và nhãn?
Loss nhận hai thứ: dự đoán của model và nhãn thật từ dữ liệu, rồi trả về một số không âm. Dự đoán đúng hoàn toàn thì loss gần 0; sai nhiều thì loss lớn.
Loss của cả model không tính riêng từng mẫu mà lấy trung bình trên cả tập (hoặc trên một batch, bài 04), gộp thành một con số:
// Tính loss của model trên tập huấn luyện
total_loss <- 0
for each (prediction, label) in training_set:
    sample_loss <- loss_fn(prediction, label)   // lỗi của riêng mẫu này
    total_loss <- total_loss + sample_loss

model_loss <- total_loss / size(training_set)
// model_loss: một số không âm; càng nhỏ, dự đoán càng sát nhãn
Ví dụ: với bộ trọng số hiện tại, model đoán sai nhiều email, loss = 0.85. Sau một vòng chỉnh trọng số, loss = 0.82. Loss giảm nghĩa là lần chỉnh vừa rồi đi đúng hướng.
Thử ngẫmmột quán ăn chấm điểm mỗi ngày bằng trung bình số sao của mọi khách, không nhìn riêng bàn nào. Loss tính theo kiểu đó thì điều gì bị che khuất khi gộp mọi sai lệch vào một con số?
3. Hai họ loss phổ biến nhất
Loss không phải một hàm duy nhất; tuỳ bài toán mà chọn. Hai họ quan trọng nhất:
3.1 MSE: khi model phải đoán một con số
MSE (Mean Squared Error, sai số bình phương trung bình) dùng cho bài toán đoán số (regression): đoán giá nhà, đoán thời gian deploy, đoán nhiệt độ.
MSE = average( (prediction - label) ^ 2 )
Bình phương có hai tác dụng. Một, kết quả luôn dương dù dự đoán thừa hay thiếu, nên sai số hai chiều không triệt tiêu nhau. Hai, lỗi lớn bị phạt nặng hơn hẳn: sai 2 đơn vị tính là 4, sai 3 đơn vị tính là 9. Model vì thế ưu tiên tránh lỗi to hơn là san đều lỗi nhỏ.
Ví dụ tính tay (đoán thời gian deploy, đơn vị phút):
| Lần deploy | Dự đoán | Thực tế | Hiệu | Bình phương |
|---|---|---|---|---|
| 1 | 3.0 | 5.0 | -2.0 | 4.0 |
| 2 | 7.0 | 6.0 | +1.0 | 1.0 |
| 3 | 2.0 | 4.0 | -2.0 | 4.0 |
| MSE | (4+1+4)/3 = 3.0 |
3.2 Cross-entropy: khi model phải chọn nhãn
Cross-entropy dùng cho bài toán phân loại (classification): spam hay không, giao dịch bất thường hay bình thường, chữ số nào trong ảnh.
Model trả về một xác suất (từ 0 đến 1) cho mỗi lớp. Cross-entropy phạt theo độ tự tin: model càng tự tin mà càng sai thì phạt càng nặng.
cross_entropy_one_sample = - ln(prob_of_correct_class)
// ln: logarit tự nhiên
// prob_of_correct_class: xác suất model gán cho nhãn đúng
Vì sao dùng -ln(p) chứ không dùng (1 - p)? Theo lý thuyết thông tin, -ln(p) đo "độ bất ngờ" khi một sự kiện xảy ra. Với p = 1.0 (model chắc chắn và đúng), -ln(1) = 0, chẳng có gì bất ngờ. Với p = 0.01 (model gần như chắc chắn là sai), -ln(0.01) ≈ 4.6, rất bất ngờ. Khi p tiến về 0, mức phạt tiến ra vô cực. Nhờ vậy model không bao giờ dám đặt cược 100% vào một đáp án sai: cái giá của nó là vô hạn.
| p (xác suất lớp đúng) | (1 - p) | -ln(p) |
|---|---|---|
| 0.99 | 0.01 | 0.010 |
| 0.70 | 0.30 | 0.357 |
| 0.50 | 0.50 | 0.693 |
| 0.10 | 0.90 | 2.303 |
| 0.01 | 0.99 | 4.605 |
Khi p giảm từ 0.5 xuống 0.1, (1 - p) chỉ tăng từ 0.5 lên 0.9, còn -ln(p) tăng từ 0.69 lên 2.30. Cross-entropy nhạy hơn nhiều với những lần model tự tin mà sai, và đó đúng là đặc tính bạn muốn.
Ví dụ tính tay (phân loại spam; cột "p lớp đúng" là xác suất model gán cho nhãn thật):
| Nhãn thật | p lớp đúng | Cross-entropy | |
|---|---|---|---|
| 1 | Spam | 0.90 (tự tin, đúng) | -ln(0.90) ≈ 0.105 |
| 2 | Spam | 0.10 (tự tin đoán không-spam, sai) | -ln(0.10) ≈ 2.303 |
| 3 | Spam | 0.70 (đúng, kém chắc hơn) | -ln(0.70) ≈ 0.357 |
| Trung bình | (0.105 + 2.303 + 0.357) / 3 ≈ 0.922 |
Một mình email 2 gánh 2.303 trên tổng 2.765, khoảng 83%. Cross-entropy không đếm số lần sai; nó phạt nặng sự tự tin đặt nhầm chỗ.
4. Vì sao chọn loss là quyết định thiết kế?
Loss không chỉ là công cụ đo. Nó định nghĩa thế nào là sai, và model sẽ tối ưu đúng định nghĩa đó, kể cả khi định nghĩa lệch với điều bạn thật sự cần.
Bạn build model phát hiện giao dịch bất thường (fraud detection). Tập huấn luyện có 10.000 giao dịch: 9.900 bình thường, 100 gian lận, dữ liệu lệch nặng.
Có một model đơn giản, gọi là model A, chỉ làm một việc: đoán "bình thường" cho mọi giao dịch.
Hỏi: model A có accuracy bao nhiêu? Loss của nó trên tập này cao hay thấp? Từ hai con số đó, bạn kết luận gì về chất lượng thật của model?
Viết ra câu trả lời rồi mới đọc tiếp.
Kết quả: model A đoán đúng 9.900/10.000 mẫu, accuracy 99%. Loss của nó cũng thấp. Nếu dùng MSE thì loss chỉ 0.01 (100 mẫu gian lận × (0 - 1)² / 10.000). Nếu model xuất p(bình thường) = 0.99 cho mọi mẫu, cross-entropy trung bình ≈ 0.056: thấp hơn nhiều so với đoán bừa (0.693), dù 100 mẫu gian lận bị phạt nặng (-ln(0.01) ≈ 4.6 mỗi mẫu). Nhìn con số nào cũng thấy model "giỏi". Vậy mà nó không bắt được một giao dịch gian lận nào.
Vấn đề không nằm ở chỗ loss "đếm phần trăm đúng" như accuracy; nó không đếm. Vấn đề là cả hai loss đều lấy trung bình trên mọi mẫu với trọng số ngang nhau. 9.900 mẫu bình thường được đoán gần đúng kéo trung bình xuống thấp, còn 100 mẫu gian lận, dù mỗi mẫu bị phạt nặng, chỉ chiếm 1% mẫu số. Loss mặc định vì thế trả lời câu hỏi "trung bình trên toàn tập model sai bao nhiêu", trong khi bạn cần câu hỏi "model bắt được bao nhiêu ca gian lận". Model tối ưu đúng câu hỏi đầu.
Gốc của vấn đề: dữ liệu lệch lớp (class imbalance) khiến lớp đa số chi phối loss mặc định. Model tối ưu đúng thứ bạn viết vào loss, không phải thứ bạn nghĩ trong đầu lúc code.
Cách thoát: chỉnh loss để phạt nặng hơn khi bỏ sót gian lận (weighted loss, focal loss), và theo dõi metric như recall/F1 khi chọn cấu hình. Điều cần nhớ ở bài này là chọn loss là lúc bạn nói với model "thế này mới là sai", không phải việc diễn ra tự động.
5. Loss khác metric thế nào?
Loss và metric (accuracy, precision, recall, F1) đều nói về chất lượng model, nhưng phục vụ hai mục đích và có hai yêu cầu kỹ thuật khác nhau:
| Loss | Metric | |
|---|---|---|
| Ai dùng | Máy, để tối ưu trọng số | Người, để đọc và ra quyết định |
| Yêu cầu kỹ thuật | Liên tục, mượt: đổi trọng số một chút thì loss đổi tương ứng | Không cần mượt; accuracy là phép đếm |
| Ví dụ | MSE, cross-entropy | Accuracy, precision, recall, F1 |
Vì sao loss phải mượt: bài 04 sẽ cho thấy trọng số được cập nhật dựa trên độ dốc (gradient) của loss theo từng trọng số. Nếu loss nhảy bậc, đổi trọng số một chút thường không làm loss đổi chút nào, gradient bằng 0, và không có hướng nào để cập nhật.
Hệ quả thực tế: loss và metric không phải lúc nào cũng đi cùng nhịp. Loss có thể giảm đều qua từng epoch trong khi accuracy đứng yên, vì accuracy chỉ nhảy khi model vượt ngưỡng đổi quyết định ở một mẫu nào đó. Thấy loss giảm mà accuracy đứng yên vài epoch thường là bình thường, không phải dấu hiệu model hỏng.
6. Ba pitfall phổ biến
Pitfall 1: nhầm loss với accuracy. Hai thứ đo khác nhau. Loss nói "sai bao nhiêu theo thang của hàm loss"; accuracy nói "đúng bao nhiêu phần trăm theo phép đếm". Loss thấp không bảo đảm accuracy cao, và ngược lại, nhất là khi dữ liệu lệch.
Pitfall 2: so loss giữa hai model dùng hai hàm loss khác nhau. MSE của model A và cross-entropy của model B là hai thang đo khác hẳn. "Model A loss = 0.3 thấp hơn model B loss = 2.1" không nói được model nào tốt hơn với bài toán gốc.
Pitfall 3: loss thấp nghĩa là sản phẩm tốt. Loss đo theo hàm bạn chọn trên dữ liệu bạn có. Dữ liệu lệch, hoặc hàm loss không phản ánh use case thật (như ví dụ gian lận ở trên), thì loss thấp vẫn che được một thất bại hoàn toàn. Luôn đọc metric nghiệp vụ (recall, precision, F1) cùng với loss.
7. Đào sâu
Nền toán của loss: cross-entropy xuất phát từ lý thuyết thông tin và ước lượng hợp lý cực đại (Maximum Likelihood Estimation, MLE). Cực tiểu hoá cross-entropy trên tập huấn luyện tương đương với tìm bộ tham số khiến dữ liệu quan sát được có xác suất cao nhất, nên nó là lựa chọn có cơ sở cho bài toán phân loại. Sách Deep Learning (Goodfellow, Bengio, Courville), chương 5 "Machine Learning Basics", mục 5.5 "Maximum Likelihood Estimation" giải thích chi tiết mối liên hệ này; sách đọc miễn phí tại deeplearningbook.org.
8. Liên hệ các bài khác
- Module 1, bài 03: Dữ liệu, nhãn và chia tập: nhãn đóng vai
expectedtrong mỗi mẫu. Loss là phép soactual(dự đoán) vớiexpected(nhãn), gộp trên cả tập thành một con số. - Bài 01: Neuron và trọng số: trọng số là thứ model chỉnh khi học; loss cho biết lần chỉnh đó đúng hướng không.
- Bài 04: Gradient descent dùng loss để tính gradient, tức hướng chỉnh trọng số.
- Bài 07: Mini-challenge đọc đường cong loss: hiểu loss rồi thì chẩn đoán ba đường cong loss hỏng.
9. Tóm tắt
- Đoán thời gian deploy lệch 2, 1, 2 phút cho MSE = 3.0: lỗi 2 phút nặng gấp bốn lỗi 1 phút.
- Email 2 tự tin mà sai gánh khoảng 83% tổng cross-entropy của ba email.
- Model "đoán bình thường cho tất cả" đạt 99% accuracy và loss thấp mà không bắt được ca gian lận nào.
- So loss chỉ có nghĩa khi cùng một hàm loss; so model thì dùng cùng metric trên cùng tập validation.
10. Tự kiểm tra
- Q1Loss trả về một con số hay một mảng giá trị? Vì sao cần đúng một con số để huấn luyện?
- Q2MSE bình phương hiệu số thay vì lấy giá trị tuyệt đối. Hai tác dụng của bình phương là gì?
- Q3Model fraud detection đoán 'bình thường' cho mọi giao dịch, đạt accuracy 99% và loss thấp. Gốc của vấn đề là gì?
- Q4Vì sao loss phải mượt (đổi trọng số một chút thì loss đổi một chút), còn metric như accuracy thì không cần?
- Q5Hai email đều là spam: model gán xác suất lớp đúng là 0.5 cho email thứ nhất và 0.9 cho email thứ hai. Email nào cho cross-entropy cao hơn, và vì sao cách phạt đó hợp lý?
- Q6Hai model: model A dùng MSE, loss = 0.3; model B dùng cross-entropy, loss = 1.4. Có kết luận được model A tốt hơn không?
Bài tiếp theo: Gradient descent: vòng lặp chỉnh trọng số cho bớt sai
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Xếp lớp và hàm phi tuyến: vì sao một lớp không đủ
Bài tiếpGradient descent: vòng lặp chỉnh trọng số cho bớt sai
Thảo luận & góp ý
Hỏi đáp về bài này