Tổng quan: Não nhân tạo vừa đủ
Bản đồ module: từ một neuron tính tổng có trọng số tới vòng lặp huấn luyện và representation, vừa đủ để bước vào transformer mà không cần backprop.
TL;DR: Module 1 dựng bản đồ AI/ML/DL và cố ý chưa mở hộp đen bên trong mạng nơ-ron. Module này mở nó ra từ đơn vị nhỏ nhất: một neuron tính gì, vòng lặp huấn luyện chạy thế nào, và lớp ẩn tự học ra đặc trưng ra sao. Mọi thứ dựng từ trực giác và pseudocode: không tính backprop bằng tay, không chứng minh toán, không PyTorch. Vừa đủ để hai module LLM và transformer phía sau có chỗ bám.
1. Vì sao module này tồn tại
Cuối module 1, bạn đã biết machine learning là học luật từ dữ liệu thay vì viết luật tay, deep learning xếp nhiều lớp học được, và LLM nằm ở vùng generative AI trên bản đồ. Module 1 dừng ở một câu hỏi bỏ ngỏ: bên trong mạng nơ-ron học bằng cách nào?
Module 2 trả lời câu hỏi đó theo đúng thứ tự cần để hiểu transformer: neuron tính gì, vì sao nhiều lớp cần phi tuyến, loss đo cái gì, vòng lặp chỉnh trọng số chạy ra sao, và lớp ẩn tự học ra đặc trưng thế nào.
Mục đích là trực giác, không phải kỹ thuật ML. Học xong module này, bạn đủ nền để hiểu vì sao transformer cần attention, vì sao fine-tune đổi trọng số chứ không đổi code, và vì sao model to hơn chưa chắc tốt hơn nếu dữ liệu không đủ.
2. Sau module này bạn sẽ
- Giải thích được neural net như một chuỗi biến đổi có tham số: neuron tính tổng có trọng số, hàm phi tuyến làm nhiều lớp khác hẳn một lớp
- Giải thích được loss gom toàn bộ sai lệch của model về một con số, và vì sao chọn loss là quyết định thiết kế
- Lần theo được vòng lặp huấn luyện: forward, loss, gradient, cập nhật trọng số, và vai trò của learning rate
- Phân biệt được tham số model học ra với siêu tham số do người chọn, kể cả ước lượng bộ nhớ từ số tham số
- Giải thích được representation học được ở lớp ẩn, và vì sao nó là nền chung của embedding lẫn attention
- Chẩn đoán được ba kiểu huấn luyện hỏng từ đường cong loss: learning rate sai, model thiếu sức chứa, overfit
3. Lộ trình module
| Bài | Nội dung | Phút |
|---|---|---|
| 01: Neuron và trọng số | Neuron tính gì; w và b là thứ duy nhất học được | 11 |
| 02: Xếp lớp và phi tuyến | Vì sao chồng lớp tuyến tính không mạnh thêm; ReLU đổi điều đó | 10 |
| 03: Loss | Loss gom sai lệch về một con số; MSE và cross-entropy; chọn loss là thiết kế | 12 |
| 04: Gradient descent | Forward, loss, gradient, cập nhật; learning rate; batch và epoch | 13 |
| 05: Tham số và siêu tham số | Đếm tham số; phân biệt với siêu tham số; ước lượng bộ nhớ | 11 |
| 06: Representation | Lớp ẩn tự học đặc trưng; nền chung của embedding và attention | 11 |
| 07: Mini-challenge: đọc đường cong loss | Chẩn đoán ba ca huấn luyện hỏng, tổng hợp bài 02 đến 04 | 15 |
| 08: Tổng kết | Cheat sheet và tự đánh giá | 6 |
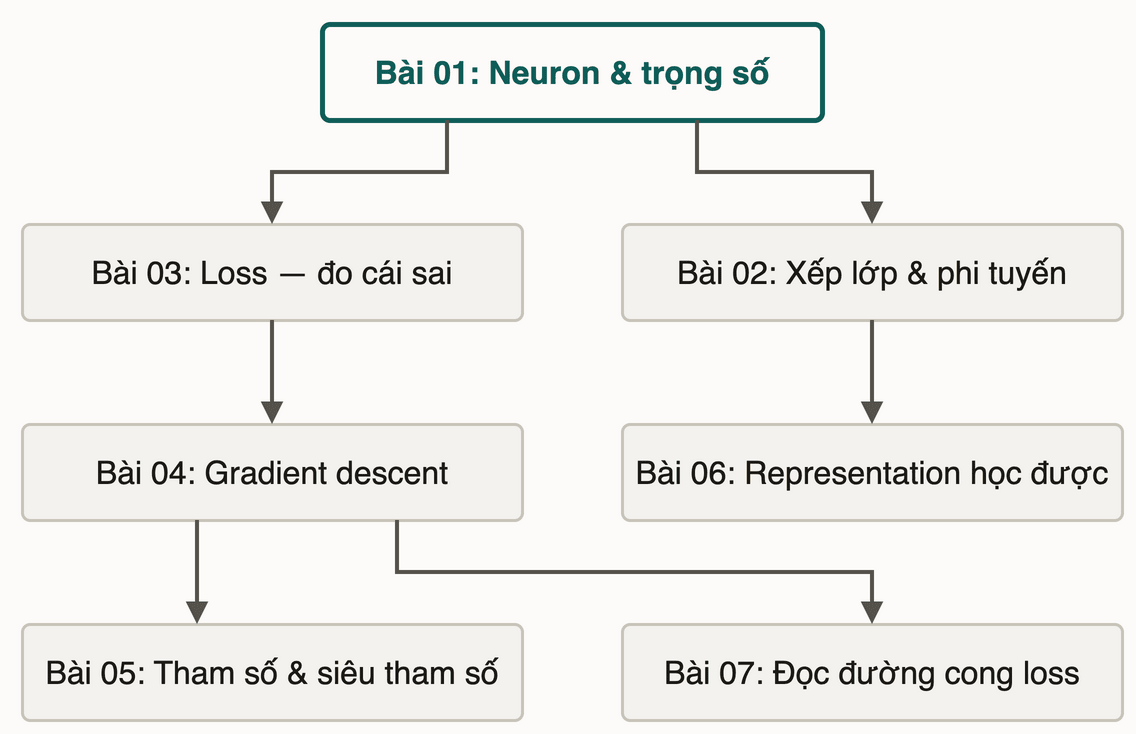
Thứ tự có chủ ý: bài 01–02 dựng khối cơ bản (neuron và lớp), bài 03–04 dựng vòng lặp học (loss và gradient), bài 05–06 mở rộng hiểu biết thực dụng (bộ nhớ và representation). Bài 07 là mini-challenge, đọc được ngay sau bài 04.
4. Ngoài phạm vi module này
Module dừng lại có chủ ý, để giữ đúng mục tiêu "vừa đủ cho transformer":
- Không tính đạo hàm tay hay chứng minh chain rule
- Không đi sâu thuật toán tối ưu nâng cao (Adam, momentum, lr scheduler); bài 07 chỉ nhắc tên Adam như một lựa chọn cấu hình
- Không dạy PyTorch, TensorFlow hay framework ML nào
- Không kể lịch sử CNN hay RNN
- Kiến trúc transformer (attention, multi-head) thuộc Module 4: Transformer & attention; module này chỉ dựng nền
5. Yêu cầu trước khi bắt đầu
- Đã học Module 1: Bản đồ AI, nhất là phần phân biệt train với inference và khái niệm overfitting
- Đọc được pseudocode cơ bản (không gắn với ngôn ngữ nào)
- Không cần nền toán hay kinh nghiệm ML
Bài tiếp theo: Neuron nhân tạo: trọng số mới là thứ model học được
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng kết: Bản đồ AI & học từ dữ liệu
Bài tiếpNeuron nhân tạo: trọng số mới là thứ model học được
Thảo luận & góp ý
Hỏi đáp về bài này