Tham số và siêu tham số: 7 tỷ tham số nghĩa là gì
Tham số là những con số model tự chỉnh khi học; siêu tham số là thứ người chọn trước khi học. Từ số tham số ước lượng được bộ nhớ cần để nạp model.
TL;DR: Đọc thông báo ra mắt một model "7 tỷ tham số", dev thường hỏi hai câu: con số đó đếm cái gì, và máy mình có nạp nổi không? Tham số là toàn bộ trọng số w và bias b mà model tự chỉnh trong lúc train; kiến thức của model nằm ở đó. Siêu tham số là thứ khác hẳn: learning rate, số lớp, batch size, do người chọn trước khi train, và gradient descent không đụng tới. Từ số tham số ước lượng được bộ nhớ tối thiểu để nạp model lúc inference: 7 tỷ × 2 byte ≈ 14 GB trọng số ở độ chính xác 16-bit.
1. "7 tỷ tham số" trong thông báo ra mắt là con số gì?
Mỗi lần có model mới, bạn thấy những cái tên kiểu "Llama 3 8B", "Mistral 7B", "Phi-3 Mini 3.8B". Con số đi kèm chữ "B" (billion, tỷ) đếm cái gì, và máy bạn có đủ RAM/VRAM để nạp không? Bài này trả lời cả hai câu hỏi thực dụng đó.
Trước hết cần gỡ một cái bẫy thuật ngữ: "tham số" trong ML khác hẳn "tham số hàm" trong lập trình. Trong Java hay Python, int x là tham số của hàm, bạn truyền giá trị vào lúc gọi. Trong ML, "tham số" là những con số mà model TỰ học ra trong lúc train: không ai đặt tay, gradient descent đặt. Cùng một chữ, hai nghĩa khác nhau.
2. Tham số: những con số model tự học ra
Bài 01: mỗi neuron tính tổng có trọng số z = w₁x₁ + w₂x₂ + ... + wₙxₙ + b. Các giá trị w (trọng số) và b (bias) là thứ model TỰ chỉnh qua mỗi bước train. Trước khi train chúng được khởi tạo ngẫu nhiên; train xong, chúng mang những gì model học được từ dữ liệu.
Tham số (parameter) của một neural net là tất cả các w và b trong mạng (và trọng số của các khối khác như attention, về bản chất cũng là những con số học được). "Model 7 tỷ tham số" nghĩa là có 7.000.000.000 con số kiểu này, 7 tỷ "núm vặn" mà quá trình train đã chỉnh để model khớp dữ liệu tốt nhất có thể.
Tham số là phần "đã học" của model. Tải một model về máy (file .gguf, .safetensors hay .pth), bạn đang tải đúng file chứa các giá trị w và b đã train. Mất file đó là mất toàn bộ thứ model đã học: code kiến trúc vẫn còn, nhưng muốn có lại model thì phải khởi tạo ngẫu nhiên và train lại từ đầu.
Tham số chỉ đổi trong lúc train. Khi model đã deploy và đang trả lời câu hỏi của bạn qua API, mọi tham số đóng băng; model chỉ đọc chúng để tính đầu ra.
Module 1, bài 04: train là lúc model "học", tham số đổi theo từng batch; inference là lúc model "làm việc", tham số đóng băng, chỉ đọc. Hai pha khác nhau cả về chi phí tính toán lẫn quyền ghi vào tham số.
3. Một lớp fully-connected có bao nhiêu tham số?
Muốn đếm tham số của cả mạng thì cần công thức cho từng lớp. Xét một lớp fully-connected (mỗi neuron ra nối với mọi đầu vào), nhận m đầu vào và có n neuron ra. Mỗi neuron ra có m trọng số riêng, nên lớp có m × n trọng số. Mỗi neuron ra có thêm một bias, nên có n bias. Tổng tham số của lớp là m × n + n.
Xét mạng nhỏ 3 đầu vào → lớp ẩn 4 neuron → 1 đầu ra (hai lớp fully-connected). Trước khi đọc tiếp, tự tính: cả mạng có bao nhiêu tham số? Ghi con số ra rồi mới so với đáp án.
Đáp án: lớp 1 (3 → 4) có 3 × 4 = 12 trọng số + 4 bias = 16 tham số. Lớp 2 (4 → 1) có 4 × 1 = 4 trọng số + 1 bias = 5 tham số. Cả mạng: 16 + 5 = 21 tham số.
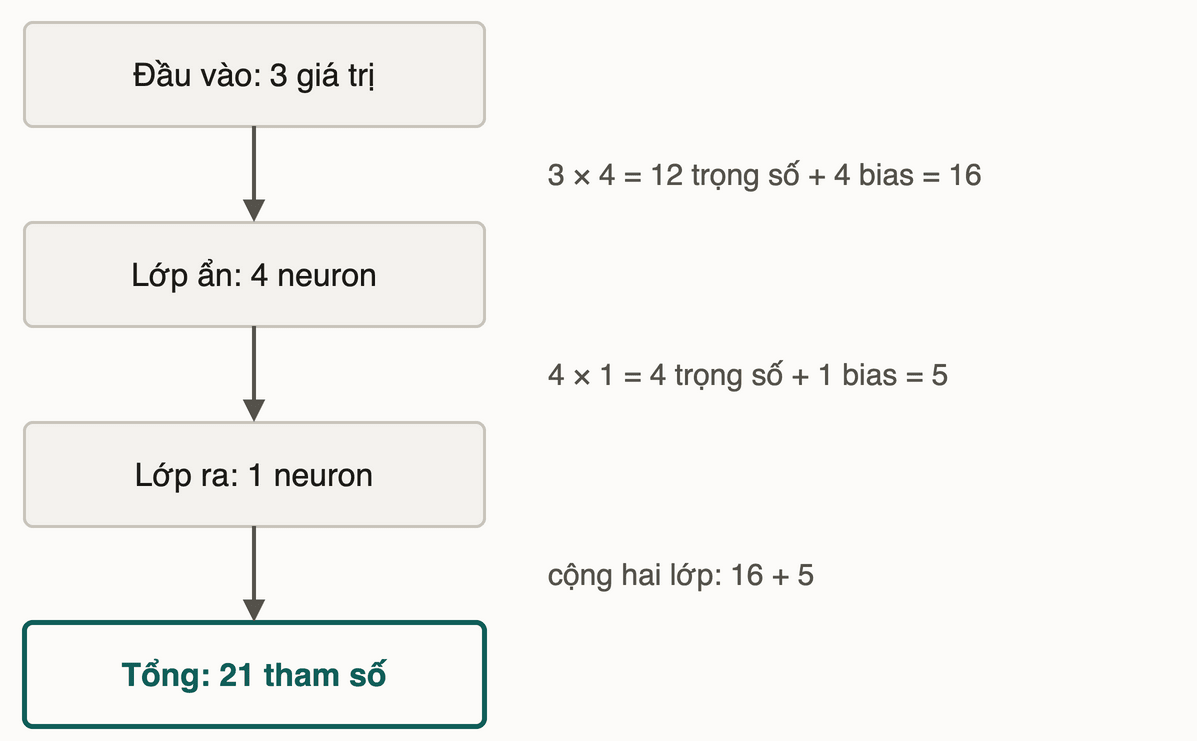
21 tham số cho một mạng đồ chơi. Transformer thật có hàng chục tới hàng trăm lớp, mỗi lớp rộng hàng nghìn neuron, nên nhân theo công thức trên thì số tham số leo lên hàng tỷ.
Thử ngẫmmột lớp fully-connected nhận 768 đầu vào và có 768 neuron ra, cỡ phổ biến trong transformer nhỏ. Không bấm máy, số tham số của lớp đó cỡ hàng nghìn hay hàng trăm nghìn?
4. Siêu tham số: người chọn, gradient không đụng tới
Ngoài tham số, khi dựng model bạn phải chốt hàng loạt thứ trước khi train: bao nhiêu lớp? mỗi lớp rộng bao nhiêu neuron? learning rate bao nhiêu? mỗi bước xử lý bao nhiêu mẫu? train bao nhiêu epoch?
Những lựa chọn đó là siêu tham số (hyperparameter): người chọn, không phải model học ra.
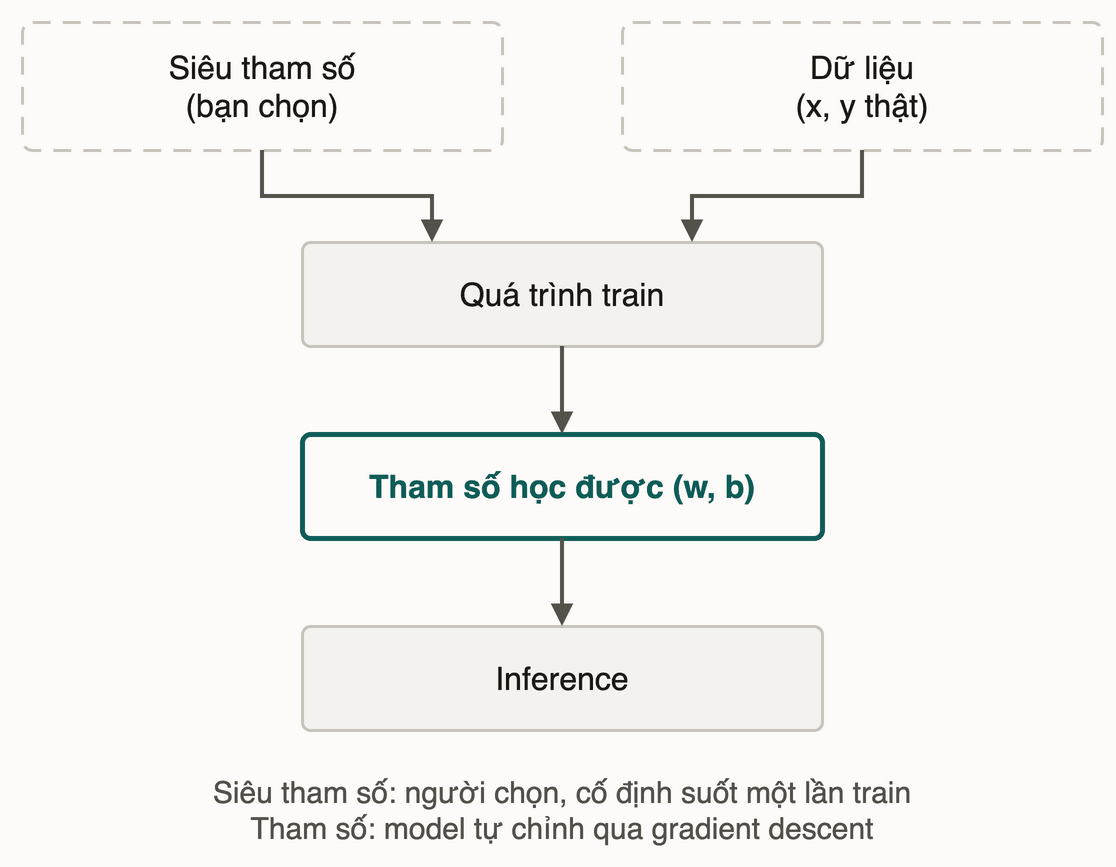
Vì sao gradient descent không học luôn siêu tham số? Có hai lý do, tuỳ loại siêu tham số. Số lớp hay số neuron là lựa chọn rời rạc, và chính chúng quyết định cái hàm mà gradient descent đang lấy đạo hàm; đổi số lớp là đổi luôn bài toán tối ưu, nên không có đạo hàm nào để tính. Learning rate thì là số thực liên tục, nhưng nó điều khiển chính bước cập nhật và ảnh hưởng tới loss qua cả quá trình train dài, chứ không qua một phép tính mượt trong một bước. Vì vậy người ta chọn siêu tham số bằng cách thử nhiều cấu hình rồi so kết quả trên validation set. (Có những kỹ thuật tự dò siêu tham số, nhưng chúng chạy bên ngoài vòng gradient descent thông thường.)
| Tham số | Siêu tham số | |
|---|---|---|
| Ví dụ | trọng số w, bias b | learning rate, số lớp, số neuron mỗi lớp, batch size, số epoch |
| Ai quyết định | Model, tự chỉnh qua gradient descent | Người, đặt trước khi train |
| Khi nào đổi | Liên tục trong lúc train | Cố định suốt một lần train; đổi giữa các lần thử |
| Chọn sai thì thấy gì | (không ai chọn tay) | Learning rate quá cao: loss tăng vọt; quá ít lớp: thiếu sức chứa; quá nhiều epoch: overfit |
5. Biết số tham số, cần bao nhiêu bộ nhớ để nạp model?
Tham số là số thực, mỗi số chiếm một lượng bộ nhớ tuỳ kiểu dữ liệu (dtype). Hai mức phổ biến: float32 (4 byte mỗi tham số), hay dùng khi train; float16 / bfloat16 (2 byte mỗi tham số), hay dùng khi inference để tiết kiệm bộ nhớ.
Bạn muốn chạy một model "7 tỷ tham số" ở độ chính xác 16-bit (2 byte mỗi tham số). Cần bao nhiêu GB chỉ để nạp trọng số vào bộ nhớ? Ghi con số ra rồi mới đọc tiếp.
Đáp án: 7.000.000.000 tham số × 2 byte = 14.000.000.000 byte ≈ 14 GB. Cùng model đó ở float32 cần 28 GB.
Mẹo nhẩm nhanh: ở 16-bit, mỗi tỷ tham số tốn khoảng 2 GB. Đọc thông báo model "13B" là nhẩm ra ngay khoảng 26 GB chỉ riêng trọng số.
Đó là mức sàn cho trọng số, không phải tổng bộ nhớ cần dùng. Còn phải cộng KV cache (tăng theo độ dài context), activation trung gian và phần của framework, nên tổng thực tế thường cao hơn đáng kể.
Lượng tử hoá (quantization) là kỹ thuật giảm số byte mỗi tham số xuống 8-bit hoặc 4-bit. Ở 4-bit, trọng số của model 7B còn khoảng 3,5 GB, đủ chạy trên máy cá nhân 8 GB RAM. Bài này chỉ nhắc tên; quantization là chủ đề riêng.
6. Chọn siêu tham số bằng validation set, không bằng test set
Quy trình đúng dùng ba tập tách biệt: train set để model học, validation set để bạn đo và chọn siêu tham số, test set chỉ dùng đúng một lần ở cuối để đánh giá chất lượng thật.
Bạn thử learning rate 0.01, đo test accuracy 87%. Thử 0.001, được 91%. Bạn chọn 0.001 vì "test cao hơn", rồi báo cáo "model đạt 91%". Con số đó không đáng tin: test set đã bị dùng để ra quyết định nên không còn là tập "chưa từng thấy". 91% phản ánh độ khớp với đúng tập test đó, không phải khả năng tổng quát ra dữ liệu mới.
Quy tắc đơn giản: validation để chỉnh, test để chốt. Chỉ đụng test set một lần, sau khi đã cố định mọi quyết định về kiến trúc và siêu tham số.
7. Ba cái bẫy thường gặp
Bẫy 1: nhầm "tham số" ML với tham số hàm. Đồng nghiệp nói "model này 7B params" thì đừng nghĩ tới function arguments. Trong ML, "params" luôn là trọng số học được từ dữ liệu. Cùng một chữ, ngữ cảnh quyết định nghĩa.
Bẫy 2: nhiều tham số hơn là thông minh hơn. Model lớn có sức chứa cao hơn, nhưng dữ liệu không theo kịp thì cái lớn đó phí. Với model nhỏ và dữ liệu ít, hệ quả hay gặp là overfit (bài 07). Với LLM, nghiên cứu Chinchilla (Hoffmann et al., 2022) chỉ ra một kiểu lãng phí khác: nhiều model lớn thời đó được train quá ít token so với kích thước (undertrained), nên với cùng ngân sách tính toán, một model nhỏ hơn train trên nhiều dữ liệu hơn lại tốt hơn. Kích thước model và lượng dữ liệu phải tăng cùng nhau.
Bẫy 3: nhầm "14 GB trọng số" với "14 GB là chạy được". KV cache, activation, hệ điều hành và các process khác đẩy tổng tiêu thụ lên đáng kể. Ngoài ra, chạy nhanh bằng GPU thì trọng số phải nằm trong VRAM chứ không phải RAM thường: máy 16 GB RAM với GPU 8 GB VRAM không nạp được model 7B ở 16-bit lên GPU. Tính trên giấy xong vẫn phải chạy thử.
8. Đào sâu
- Kaplan et al. (2020), "Scaling Laws for Neural Language Models" · arXiv:2001.08361: nhóm OpenAI đo thực nghiệm thấy hiệu năng LLM theo quy luật luỹ thừa khi tăng kích thước model, lượng dữ liệu và lượng tính toán, và các quan hệ này ổn định qua nhiều bậc độ lớn, nên đoán được hiệu năng model lớn từ thí nghiệm trên model nhỏ.
- Hoffmann et al. (2022), "Training Compute-Optimal Large Language Models" · arXiv:2203.15556: paper Chinchilla (DeepMind). Kết luận chính: để dùng ngân sách tính toán tối ưu, kích thước model và số token train phải tăng cùng tỉ lệ; gấp đôi model thì cũng cần gấp đôi token. Paper sửa lại tỉ lệ mà Kaplan et al. đề xuất trước đó.
9. Liên hệ các bài khác
- Bài 01: Neuron và trọng số:
wvàbxuất hiện lần đầu ở đó; tham số của cả mạng chỉ là tất cả cácwvàbgộp lại. - Bài 02: Xếp lớp và phi tuyến: số lớp và số neuron mỗi lớp là siêu tham số kiến trúc quyết định sức chứa.
- Bài 04: Gradient descent: cơ chế model tự chỉnh tham số; learning rate là siêu tham số điều khiển bước chỉnh.
- Bài 06: Representation học được: tham số thật sự học ra cái gì bên trong các lớp ẩn.
10. Tóm tắt
- Mạng 3-4-1 có 21 tham số; mạng 10-20-5-1 có 331.
- 7B ở 16-bit cần khoảng 14 GB cho trọng số, ở 4-bit còn khoảng 3,5 GB.
- Learning rate liên tục mà vẫn là siêu tham số: nó điều khiển chính bước cập nhật, nên được chọn bằng thử trên validation.
- Chinchilla nói về model lớn bị train thiếu token so với ngân sách tính toán, không phải về overfit.
11. Tự kiểm tra
- Q1Vì sao gọi là 'siêu tham số', và chúng liên quan thế nào với tham số thông thường?
- Q2Một mạng có ba lớp fully-connected: 10→20→5→1. Lớp 20→5 đóng góp bao nhiêu tham số, và cả mạng có bao nhiêu?
- Q3Vì sao tham số của model không đổi khi bạn gửi một câu hỏi tới LLM qua API?
- Q4Vì sao gradient descent không tự học ra số lớp tối ưu của mạng, và vì sao learning rate, dù là số liên tục, cũng không được học theo cách đó?
- Q5Bạn fine-tune một model, thử 5 giá trị learning rate, chọn giá trị cho test accuracy cao nhất rồi báo cáo con số đó. Sai ở đâu?
- Q6Bạn đọc 'model 7B chạy được trên 16 GB RAM'. Nêu ít nhất hai lý do một máy 16 GB RAM vẫn có thể không chạy được model đó.
Bài tiếp theo: Representation: lớp ẩn tự học ra đặc trưng dữ liệu
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Gradient descent: vòng lặp chỉnh trọng số cho bớt sai
Bài tiếpRepresentation: lớp ẩn tự học ra đặc trưng của dữ liệu
Thảo luận & góp ý
Hỏi đáp về bài này