Train vs inference: hai pha, hai loại hoá đơn
Train là lúc trọng số còn đổi; inference là lúc chúng đóng băng và bạn trả tiền mỗi request. Nhầm hai pha này là gốc của nhiều hiểu lầm về chi phí AI.
TL;DR: Vòng đời của một model thông thường có hai pha tách biệt. Train là lúc trọng số còn đổi: chạy theo đợt, hoá đơn tính bằng giờ GPU. Inference là lúc trọng số đã đóng băng: chạy mỗi lần có request, hoá đơn tăng theo lưu lượng. Chỗ dễ nhầm nhất là trong pha inference không trọng số nào bị ghi đè. Model không "học" từ prompt hay cuộc trò chuyện, dù chatbot trông như đang nhớ bạn; trí nhớ đó là ứng dụng tự gửi lại lịch sử vào mỗi request. Muốn hành vi đổi lâu dài thì có hai đường: train lại (kể cả fine-tune), hoặc gửi kèm thông tin đó vào mọi request về sau.
Đội bạn build một chatbot tra cứu tài liệu nội bộ và ước lượng ngân sách bằng cách gộp chung: "model tốn X giờ GPU để train, cứ thế mà tính chi phí vận hành." Tháng đầu production, hoá đơn không khớp. Train chỉ trả một lần, còn inference tăng theo số người hỏi bot mỗi ngày; hai đường chi phí chẳng liên quan gì nhau. Cùng lúc, một nhân viên phàn nàn: hôm qua đã gõ hẳn hoi "tôi là kỹ sư team Payments", hôm nay hỏi lại thì bot không biết mình là ai.
Hai sự cố, một về tiền, một về "trí nhớ", chung một gốc: đội bạn coi train và inference như một pha liên tục. Bài này tách hai pha đó ra cho rõ, và chỉ ra vì sao nhầm chỗ này tốn tiền.
1. Analogy: ôn thi và ngồi phòng thi
Bạn ôn thi trong nhiều tuần: đọc tài liệu, luyện đề, sai chỗ nào sửa lại cách hiểu chỗ đó. Kiến thức trong đầu còn đổi suốt quá trình này. Bước vào phòng thi thì luật chơi đổi hẳn: bạn làm bài chỉ với những gì đã có trong đầu lúc bước vào phòng. Đề bài viết gì, giám thị nói gì cũng không dạy thêm cho bạn kiến thức mới của môn đó. Bạn đang áp dụng thứ đã học, không học thêm.
| Đời thường | Train vs inference |
|---|---|
| Ôn thi: đọc, luyện, sửa cách hiểu | Train: trọng số còn đổi theo dữ liệu |
| Ngồi phòng thi: làm bài bằng kiến thức đã có | Inference: trọng số đóng băng, chỉ input/output đổi theo lượt |
| Ôn thi diễn ra một đợt dài, trước kỳ thi | Train chạy theo đợt, trước khi model được đưa vào dùng |
| Mỗi buổi thi tính riêng | Mỗi request tốn tài nguyên riêng, cộng dồn theo lưu lượng |
| Đề bài không sửa được kiến thức bạn mang vào phòng | Prompt không sửa được trọng số model |
Ôn thi là lúc bạn còn "sai và sửa". Phòng thi là lúc chỉ còn "dùng thứ đã có". Train và inference khác nhau đúng ở chỗ đó.
Thử ngẫmmột đầu bếp nấu hỏng một món trong ca làm, khách góp ý ngay tại bàn. Món ăn tối đó có ngon hơn không, và đầu bếp học được gì cho ngày mai?
2. Hai pha khác nhau ở chỗ nào?
Một model là một hàm số khổng lồ với hàng triệu tới hàng tỷ con số bên trong, gọi là trọng số (weights). Mọi thứ model "biết" nằm ở các con số này, không phải ở một database nào đó bên cạnh để tra cứu.
Train là quá trình chỉnh dần các con số đó theo dữ liệu huấn luyện, để hàm số dự đoán ngày càng khớp kết quả mong muốn (cơ chế chỉnh cụ thể nằm ở module Não nhân tạo vừa đủ). Quá trình này chạy theo đợt, lặp tới khi đạt tiêu chí dừng. Hết đợt, trọng số được đóng băng và xuất ra thành một file.
Inference là chạy hàm số đó, với đúng bộ trọng số đã đóng băng, trên một input mới để lấy output. Mỗi request là một lần chạy hàm, và trọng số không đổi giữa các lần chạy.
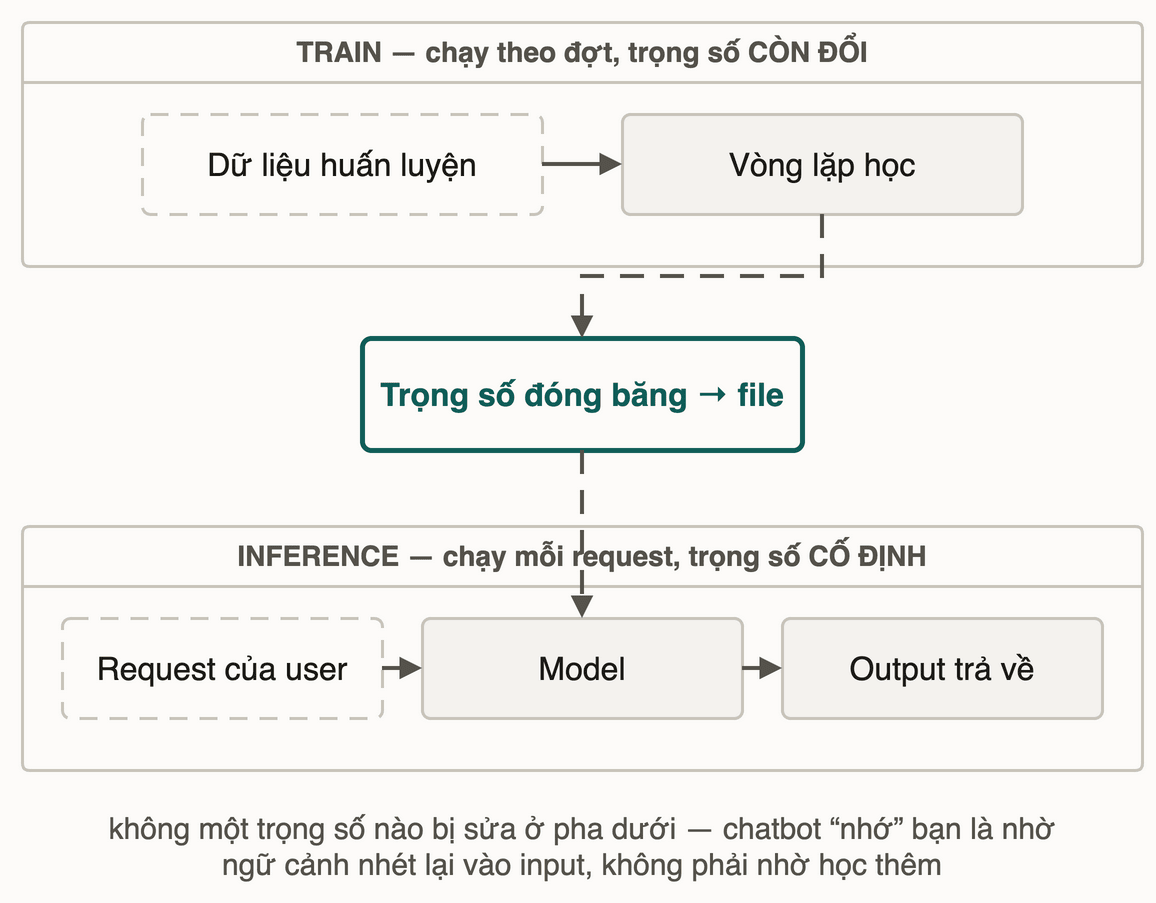
Nhìn bằng pseudocode thì càng rõ: chỉ hàm train có bước chỉnh trọng số, hàm inference không có bước đó ở đâu cả.
function train(du_lieu, trong_so_ban_dau):
    trong_so <- trong_so_ban_dau
    while not converged:
        sai_so <- tinh_sai_so(model(trong_so), du_lieu)   -- trọng số CÒN đổi ở mỗi vòng lặp
        trong_so <- chinh(trong_so, sai_so)
    return trong_so                                        -- đóng băng tại đây, xuất ra file trọng số

function inference(trong_so_dong_bang, input):
    output <- model(trong_so_dong_bang, input)             -- trọng số KHÔNG đổi
    return output                                          -- không có bước chỉnh trọng số nào
Hàm inference nhận trong_so_dong_bang làm tham số đầu vào cố định: nó chỉ đọc, không bao giờ ghi lại. Qua dấu return cuối hàm train, không dòng code inference nào được sửa giá trị đó.
Có một ngoại lệ đáng biết: online learning, nơi hệ thống vừa phục vụ vừa cập nhật trọng số theo dữ liệu mới liên tục. Cách này có thật trong một số hệ gợi ý hay chấm quảng cáo, nhưng đó là một thiết kế riêng có vòng train chạy song song. Chatbot hay API LLM bạn gọi hằng ngày không làm vậy.
3. Vì sao chatbot "nhớ" bạn dù model không học gì mới?
Hôm qua bạn gõ vào chatbot: "Tôi là kỹ sư team Payments." Hôm nay bạn mở lại đúng ứng dụng đó, hỏi "Tôi làm ở team nào?" và bot trả lời không biết.
Điền vào chỗ trống trước khi đọc tiếp: "Bot không nhớ vì ___." Thử áp khái niệm "trọng số đóng băng" ở mục 2 vào tình huống này rồi mới xem đáp án.
Đáp án: bot không nhớ vì không có chỗ nào để nhớ. Trọng số đã đóng băng từ lúc train xong; request hôm qua chỉ là một lần chạy inference rồi kết thúc, không để lại gì bên trong model.
Vậy vì sao trong cùng một cuộc trò chuyện, chatbot vẫn "nhớ" bạn vừa nói gì hai phút trước? Vì phía ứng dụng, không phải model, lưu lịch sử hội thoại rồi gửi lại toàn bộ lịch sử đó làm một phần input mỗi lần bạn gõ câu mới. Với model, đó vẫn là một lần chạy inference độc lập, chỉ là input dài hơn. Sang phiên mới, ứng dụng ngừng gửi lịch sử, và model coi như chưa từng thấy nó. (Một số ứng dụng có tính năng "memory" lưu ghi chú về bạn; cơ chế vẫn thế, ghi chú nằm ở phía ứng dụng và được chèn vào input.)
Nói "tôi đã dạy nó rồi" ở đây là gán sai cơ chế. Bot chỉ đang đọc lại thứ ứng dụng gửi kèm; "dạy" đúng nghĩa, tức sửa trọng số, chỉ xảy ra khi train.
Bài 01: luật ứng xử của chương trình không viết tay bằng if-else mà học từ dữ liệu trong pha train. Bài này thêm vế còn thiếu: luật đó, học xong, đóng băng vào trọng số ngay khi train kết thúc. Sang pha inference, chương trình không học luật mới từ input nào nữa, kể cả một cuộc trò chuyện dài đầy thông tin bạn vừa cho nó biết.
4. Hệ quả vận hành: artifact bạn deploy là gì?
Vì trọng số đóng băng ngay khi train xong, thứ bạn thật sự deploy là hai thứ cụ thể: file trọng số và code chạy inference, đóng gói và gắn version như một bản build phần mềm bình thường. Từ đó kéo theo hai hệ quả.
Thứ nhất, version và rollback được. Phiên bản model là một mốc cụ thể (file trọng số nào). Hành vi sai lệch thì đổi lại đúng file trọng số của phiên bản cũ, giống rollback một bản build binary.
Thứ hai, không có đường tắt để sửa hành vi. Muốn model trả lời khác đi lâu dài, bạn chỉ có hai lựa chọn: train lại (tốn kém, đổi trọng số thật; fine-tune cũng thuộc nhóm này), hoặc đổi input mỗi lần gọi (rẻ hơn, nhưng phải lặp lại ở mọi request).
5. Train và inference khác nhau thế nào về tần suất, độ trễ và tiền?
| Trục | Train | Inference |
|---|---|---|
| Thứ gì thay đổi | Trọng số, chỉnh dần theo dữ liệu huấn luyện | Không gì trong model đổi; chỉ input/output đổi theo từng lượt |
| Tần suất chạy | Theo đợt: một lần, hoặc vài lần khi ra bản cập nhật | Mỗi lần có request, có thể hàng nghìn tới hàng triệu lượt một ngày |
| Độ trễ mỗi lần chạy | Từ vài giờ tới vài tuần cho cả đợt (LLM lớn có khi hàng tháng) | Từ mili-giây tới vài giây mỗi request |
| Tính tiền theo gì | Giờ thuê GPU cho cả đợt: khoản chi một lần cho một phiên bản | Gọi API thì trả theo lượt (thường theo lượng input/output); tự host thì trả giờ GPU của server luôn bật. Cả hai đều cộng dồn theo lưu lượng |
6. Pitfall tổng hợp
❌ Nhầm 1: coi hội thoại dài là "đang dạy" model.
✅ Cuộc trò chuyện dài chỉ là input dài đưa vào một hoặc nhiều lần chạy inference; không trọng số nào bị sửa. Đóng ứng dụng, mất lịch sử, model vẫn đúng như cũ.
❌ Nhầm 2: gộp chung chi phí train và inference khi lập ngân sách.
✅ Đây là hai kiểu chi phí độc lập (mục 5): train trả một lần cho một phiên bản, inference tăng theo lưu lượng. Ngân sách vận hành phải dựa trên dự phóng lưu lượng inference, không phải chi phí train.
❌ Nhầm 3: nghĩ có cách "chỉnh nhẹ" model ngay lúc inference mà không cần train lại.
✅ Không tham số nào ở pha inference sửa được trọng số. Mọi cách làm model "cư xử khác" lúc chạy chỉ tác động tới input của lần gọi đó, và hết tác dụng khi request kết thúc.
7. 📚 Deep Dive
Tài liệu chính chủ:
- Google ML Crash Course, Static vs. dynamic inference: inference còn chia hai kiểu chạy (tính trước theo lô, hay tính theo từng request), cả hai đều dùng trọng số đã đóng băng như mục 2.
- Google, Rules of Machine Learning, mục Training-Serving Skew: một lớp lỗi khác sinh ra ở chỗ nối hai pha, khi model đo tốt lúc train nhưng kém lúc phục vụ thật vì pipeline dữ liệu hai pha khác nhau hoặc dữ liệu thật trôi theo thời gian.
8. Liên hệ các bài khác
- Bài 02: Ba kiểu học: dù học theo kiểu nào, model thông thường vẫn đi qua đúng hai pha ở bài này.
- Bài 05: Overfitting: một lỗi khác nảy sinh ngay trong pha train, nhưng chỉ lộ khi model sang pha inference.
- Bài 06: LLM trên bản đồ: LLM tuân đúng hai pha này, chỉ khác quy mô.
- Cỗ máy LLM: Từ base model đến chat: vì sao chat "trông như nhớ" ở tầng token, đọc khi tới module 3.
9. Tóm tắt
- Hàm
inferencechỉ đọc trọng số; online learning là thiết kế riêng có vòng train chạy song song, không phải chatbot thường. - Chatbot "nhớ" trong một phiên vì ứng dụng gửi lại lịch sử, và quên sang phiên mới vì ứng dụng thôi gửi.
- Thứ đem deploy là file trọng số + code inference, nên version và rollback được như một bản build.
- Hoá đơn train đứng yên giữa các phiên bản; hoá đơn inference tăng theo số người dùng, dù gọi API hay tự host.
10. Tự kiểm tra
- Q1Vì sao chatbot trả lời đúng ngữ cảnh bạn vừa nói hai phút trước, nhưng đó không phải bằng chứng model đã 'học' được gì?
- Q2Trọng số đã đóng băng ở cuối pha train, và bạn muốn model đổi hành vi lâu dài. Có bao nhiêu con đường, là những đường nào?
- Q3Vì sao artifact đem deploy production chỉ là 'file trọng số + code inference', và điều đó có ý nghĩa gì khi cần rollback một phiên bản model lỗi?
- Q4Team bạn thấy hoá đơn inference tăng đều theo số người dùng mỗi tháng, trong khi hoá đơn train đứng yên suốt quý dù model được dùng liên tục. Giải thích bằng chi phí của hai pha.
- Q5Một đồng nghiệp nói: 'Tôi đã dạy con bot nhớ tên khách hàng rồi, từ giờ nó sẽ nhớ mãi.' Bạn sửa lại phát biểu này thế nào cho đúng cơ chế?
Bài tiếp theo: Overfitting & data leakage: demo đẹp mà production hỏng
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Dữ liệu, nhãn và ba tập không được trộn
Bài tiếpOverfitting & data leakage: demo đẹp mà production hỏng
Thảo luận & góp ý
Hỏi đáp về bài này