Dữ liệu, nhãn và ba tập không được trộn
Model không biết gì ngoài thứ đã thấy. Nhãn quyết định model học được gì, còn cách chia train/validation/test quyết định bạn có tin nổi con số đo hay không.
TL;DR: Nhãn (label) là đáp án đúng gắn với mỗi ví dụ dữ liệu. Nó là spec thật mà model học theo, và nhãn sai thì model cứ thế học sai mà không compiler hay test suite nào báo. Ba tập dữ liệu có ba vai: train để chỉnh trọng số, validation được xem đi xem lại để chọn cấu hình, test chỉ đo đúng một lần ở cuối. Xem test rồi quay lại chỉnh là tập test mất giá trị. Luật quan trọng nhất: tách ba tập TRƯỚC khi đụng vào dữ liệu, kể cả bước chuẩn hoá tưởng vô hại. Dữ liệu có yếu tố thời gian thì chia theo mốc thời gian, không chia ngẫu nhiên.
Một team xây model chấm điểm rủi ro gian lận thẻ (ví dụ minh hoạ, không phải số liệu kiểm toán thật). Họ có bảng giao dịch với nhãn is_fraud do đội vận hành gắn tay trong sáu tháng. Quy trình nghe rất chuẩn: chuẩn hoá mọi cột số trên toàn bảng, xáo dữ liệu, rồi cắt 80% train, 10% validation, 10% test. Model báo AUC 0.97 trên tập test nội bộ. Ba tuần sau khi lên production, tỉ lệ gian lận lọt qua tăng vọt, và điều tra cho thấy gần một phần tư nhãn is_fraud của sáu tháng đó bị gắn nhầm vì một bug ở hệ thống chấm điểm cũ.
Không bước nào trong pipeline báo lỗi. Code chạy trơn tru, review không thấy gì sai. Có hai vấn đề độc lập ở đây. Nhãn sai làm model học sai (mục 1). Cách chia tập làm con số 0.97 không đáng tin ngay cả khi nhãn đúng (mục 3 đến 5). Bài này trả lời lần lượt: nhãn quyết định model học được gì, và cách chia ba tập quyết định con số đo có đáng tin hay không.
Bài 01: machine learning thay luật if-else viết tay bằng luật suy ra từ dữ liệu. Bạn kiểm soát hành vi chương trình bằng cách kiểm soát dữ liệu chứ không còn bằng đọc code. Câu hỏi còn bỏ ngỏ: luật suy ra bằng cách nào? Câu trả lời nằm ở nhãn, thứ nói cho model biết "luật đúng" trông ra sao. Nhãn sai thì luật suy ra cũng sai, giống một dòng if-else viết sai mà chẳng ai review lại.
1. Analogy: nhãn là expected output không ai review lại
Bạn quen viết test: mỗi test case có một expected để so với actual mà code trả về. Nếu ai đó gõ nhầm expected (viết 4 thay vì 5), test suite không hề biết đó là gõ nhầm, nó chỉ so. Code bị chỉnh cho tới khi ra đúng 4 vẫn được CI báo xanh, dù logic đó sai với nghiệp vụ thật.
Nhãn trong machine learning đóng đúng vai expected, chỉ là ở quy mô hàng nghìn tới hàng triệu ví dụ. Loss function so actual (output của model) với expected (nhãn), và train chỉnh trọng số cho tới khi hai bên khớp nhau nhiều nhất có thể.
| Test suite (bạn đã quen) | Machine learning |
|---|---|
expected viết tay trong file test | Nhãn gắn với mỗi ví dụ dữ liệu |
So actual với expected | Loss function so output model với nhãn |
Test pass nghĩa là khớp expected, dù expected có thể sai | Model "học đúng" nghĩa là khớp nhãn, dù nhãn có thể sai |
CI xanh không phát hiện expected sai | Không phép đo tự động nào lúc train phát hiện nhãn sai |
| Chỉ người đọc lại file test mới bắt được lỗi | Chỉ audit dữ liệu, hoặc theo dõi hành vi thật, mới bắt được nhãn sai |
Nhãn là "đáp án mẫu" model học theo, không phải dữ liệu mô tả. Đáp án mẫu sai thì học giỏi đến đâu cũng ra thứ sai, và bài tự chấm bằng chính đáp án sai đó vẫn báo điểm mười.
2. Ba tập, ba vai khác nhau
Chia dữ liệu không phải thủ tục cho có. Mỗi tập trả lời một câu hỏi riêng, và trộn vai của chúng là nguồn lỗi phổ biến nhất khi đánh giá model.
| Tập | Câu hỏi nó trả lời | Được xem bao nhiêu lần |
|---|---|---|
| Train | Trọng số nên là bao nhiêu để khớp nhãn? | Liên tục suốt quá trình train |
| Validation | Cấu hình nào (kiến trúc, hyperparameter, ngưỡng) tốt hơn? | Nhiều lần, mỗi phương án thử là một lần xem |
| Test | Model thật sự làm tốt tới đâu với dữ liệu chưa từng thấy? | Đúng một lần, ở cuối cùng |
Validation được xem nhiều lần vì nó là công cụ ra quyết định: thử cấu hình A, đo, thử cấu hình B, đo lại, chọn cái tốt hơn. Nhưng "thử rồi chỉnh theo điểm đo" là con dao hai lưỡi. Càng lặp nhiều vòng trên cùng một tập, quyết định của bạn càng khớp theo đặc thù riêng của tập đó, và con số validation không còn phản ánh khả năng tổng quát hoá.
Vì vậy mới cần tập thứ ba. Nếu chỉ có train và test, bạn buộc phải dùng test để chọn cấu hình; ngay lúc đó test thành một validation trá hình, và bạn hết công cụ để biết model tổng quát tới đâu. Test chỉ còn là "tấm gương chưa soi" khi được cất kỹ tới đúng một lần dùng cuối cùng.
3. Thử đoán: quy trình chia dữ liệu này hỏng ở đâu?
Quay lại team gian lận thẻ ở đầu bài. Quy trình của họ trông rất hợp lý, đúng những gì nhiều tutorial hướng dẫn:
-- Bước 1: chuẩn hoá mỗi cột số, tính trên TOÀN BỘ bảng giao dịch
for each cot_so trong bảng:
    mean <- trung_binh của cot_so, tính trên toàn bộ dữ liệu
    std  <- do_lech_chuan của cot_so, tính trên toàn bộ dữ liệu
    cot_so <- (cot_so - mean) / std

-- Bước 2: xáo dữ liệu rồi cắt theo tỷ lệ
shuffle(du_lieu)
train      <- 80% đầu
validation <- 10% tiếp theo
test       <- 10% còn lại
Đọc lại hai bước trên. Một bước trong đó phá nguyên tắc tách ba tập mà không dòng nào báo lỗi, không con số nào trông bất thường. Viết ra bước bạn nghi nhất kèm lý do, rồi mới đọc tiếp.
4. Đáp án: vì sao phải tách trước rồi mới tính?
Bước 1 phá nguyên tắc. mean và std được tính trên toàn bảng, kể cả những dòng sau này rơi vào validation và test. Chuẩn hoá tập train bằng mean/std đó thì mỗi giá trị train đã mang dấu vết thống kê của dữ liệu mà train lẽ ra không được biết. Nhãn is_fraud không tham gia bước này; thứ rò rỉ là thống kê của các cột feature. Đây là rò rỉ dữ liệu (data leakage): thông tin từ tập lẽ ra "chưa từng thấy" lọt vào huấn luyện qua đường gián tiếp.
Nói cho công bằng: với riêng chuẩn hoá mean/std, độ lệch điểm thường nhỏ. Cùng lỗi thứ tự đó ở bước chọn feature hay điền giá trị thiếu thì điểm có thể phồng lên nhiều. Và trong pipeline này, bước 2 mới là thủ phạm lớn hơn (mục 5). Nhưng luật thì chỉ có một: tách ba tập TRƯỚC khi làm bất cứ điều gì với dữ liệu, rồi mới tính toán. Bài sau (Overfitting & data leakage) chẩn đoán triệu chứng khi rò rỉ đã xảy ra.
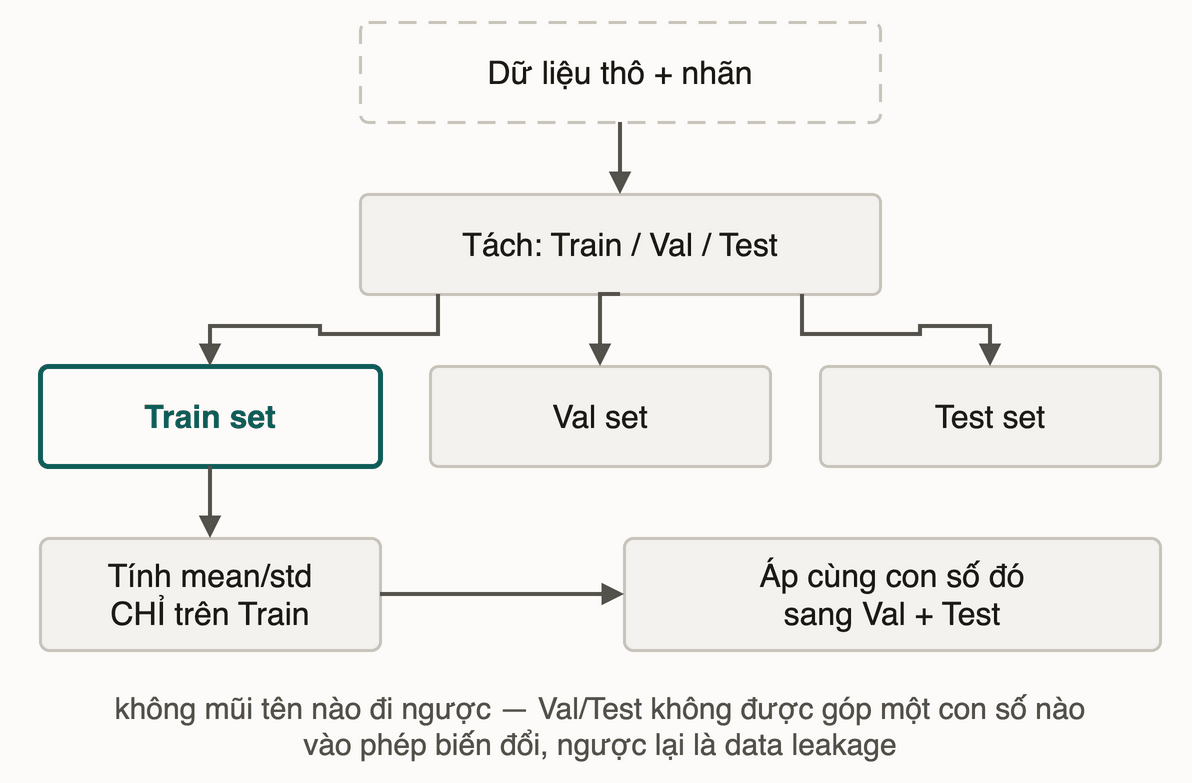
Quy trình đúng tách theo mốc thời gian ngay từ đầu (giao dịch thẻ có trục thời gian nên shuffle sai từ bước này, lý do ở mục 5):
-- Bước 1: tách TRƯỚC theo mốc thời gian, chưa đụng vào giá trị nào
train      <- giao dịch trước mốc X
validation <- giao dịch từ mốc X đến mốc Y
test       <- giao dịch từ mốc Y trở đi   -- luôn đứng sau cùng trên trục thời gian

-- Bước 2: tính thống kê CHỈ trên train
mean <- trung_binh của cot_so, tính trên train
std  <- do_lech_chuan của cot_so, tính trên train

-- Bước 3: dùng ĐÚNG mean/std đó để chuẩn hoá cả ba tập
train      <- (train - mean) / std
validation <- (validation - mean) / std
test       <- (test - mean) / std        -- test chỉ bị đụng tới ở đây, đúng một lần
Luật này không chỉ áp cho chuẩn hoá. Điền giá trị thiếu, chọn feature, giảm chiều: phép biến đổi nào "học" tham số từ dữ liệu thì đều phải fit trên train rồi mới áp sang validation/test, không bao giờ ngược lại.
5. Vì sao dữ liệu có yếu tố thời gian phải chia theo thời gian?
shuffle rồi cắt ngẫu nhiên là mặc định hợp lý khi các dòng dữ liệu độc lập nhau. Giao dịch thẻ, log request, hay bất kỳ dữ liệu nào có cột thời gian thì không như vậy: dòng nào cũng gắn với một mốc thời gian, và xáo lên là mất thứ tự đó.
Ví dụ: sáu tháng giao dịch bị shuffle rồi cắt ngẫu nhiên 80/10/10. Rất có thể giao dịch tháng 3 rơi vào train còn giao dịch tháng 1 rơi vào test. Model được huấn luyện trên dữ liệu đến sau một số điểm dùng để chấm nó, điều production không bao giờ có: production chỉ có quá khứ trong tay để đoán tương lai. Điểm đo kiểu này bị thổi phồng, vì model đang "nội suy" giữa hai khoảng thời gian nó đã thấy cả hai phía, chứ không dự đoán thật.
-- SAI: chia ngẫu nhiên dữ liệu có yếu tố thời gian
shuffle(giao_dich)                    -- trộn tháng 1 và tháng 3 vào chung một rổ
train, test <- cắt tỷ lệ trên dữ liệu đã trộn

-- ĐÚNG: chia theo mốc thời gian
train <- giao_dich trước mốc X        -- ví dụ: tháng 1 đến tháng 2
test  <- giao_dich từ mốc X trở đi    -- ví dụ: tháng 3
Nguyên tắc chung: train luôn đứng trước validation, validation luôn đứng trước test trên trục thời gian. Dữ liệu có thứ tự thì không có ngoại lệ "xáo cho đều".
Thử ngẫmmột kỳ thi cho học sinh xem trước đề thật lúc ôn tập, rồi chấm điểm cuối kỳ bằng đúng đề đó. Điểm cao đó đang đo thứ gì?
6. Pitfall tổng hợp
❌ Nhầm 1: chuẩn hoá, điền thiếu, chọn feature trên toàn bộ dữ liệu rồi mới tách. ✅ Luôn tách ba tập trước, fit mọi phép biến đổi trên train, rồi áp sang validation/test (mục 4).
❌ Nhầm 2: xem test nhiều lần, thấy điểm thấp lại quay về chỉnh model rồi đo lại. ✅ Test chỉ đo đúng một lần ở cuối. Muốn thử nhiều phương án thì dùng validation.
❌ Nhầm 3: shuffle ngẫu nhiên dữ liệu có cột thời gian trước khi chia.
✅ Cắt theo mốc thời gian: train luôn nằm trước, test luôn nằm sau.
7. 📚 Deep Dive
Tài liệu chính chủ:
- Google ML Crash Course, Dividing datasets: vì sao validation "mòn" dần khi dùng lại nhiều lần, và test chỉ giữ giá trị cho đúng một lần.
- scikit-learn, Cross-validation: dùng test để chọn hyperparameter thì rò rỉ thế nào, và vì sao phải tách riêng một tập validation.
- scikit-learn, TimeSeriesSplit: cách chia tôn trọng thứ tự thời gian, thay cho chia ngẫu nhiên.
Hai link scikit-learn dùng để đọc cơ chế, không phải để học API; khoá này không dạy triển khai bằng thư viện cụ thể.
8. Liên hệ các bài khác
- Bài 01: Khi nào cần học từ dữ liệu: luật dời từ code sang dữ liệu; bài này chỉ ra chính xác phần dữ liệu nào (nhãn) mang luật đó.
- Bài 02: Ba kiểu học: supervised learning cần nhãn để so.
- Bài 04: Train vs inference: ba tập dữ liệu ở bài này chỉ tồn tại trong pha train.
- Bài 05: Overfitting & data leakage chẩn đoán triệu chứng khi rò rỉ đã xảy ra.
- Mini-challenge: đọc mô tả hệ AI: dùng luật tách trước để bắt lỗi chia dữ liệu.
9. Tóm tắt
- Một phần tư nhãn sai mà pipeline vẫn xanh: chỉ audit dữ liệu hoặc theo dõi hành vi thật mới bắt được.
- Cần ba tập vì test không thể vừa "chưa từng thấy" vừa được dùng để chọn cấu hình.
- Chuẩn hoá trên cả bảng rồi mới tách là rò rỉ; tác động nhỏ hay lớn tuỳ phép biến đổi, nhưng luật tách trước thì không đổi.
- Với dữ liệu giao dịch,
shufflemới là thứ thổi phồng điểm nhiều nhất: model được thấy tương lai.
10. Tự kiểm tra
- Q1Vì sao nhãn sai không bị công cụ tự động nào (compiler, test suite, hay chính quá trình train) phát hiện?
- Q2Vì sao validation được phép xem lại nhiều lần để chọn cấu hình, còn test thì không?
- Q3Trong pseudocode ở mục 3, bước tính mean/std gây rò rỉ theo cơ chế nào, và vì sao đảo thứ tự hai bước lại giải quyết được?
- Q4Một tập giao dịch sáu tháng bị shuffle ngẫu nhiên rồi cắt 80/10/10. Vì sao cách này cho model 'nhìn thấy tương lai', và hệ quả gì khi chạy thật ở production?
- Q5Team dùng chung một tập test để so năm cấu hình model, rồi chọn cấu hình có điểm test cao nhất. Vì sao con số test cuối cùng không còn đáng tin?
Bài tiếp theo: Train vs inference: hai pha, hai loại hoá đơn
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ba kiểu học: phân biệt bằng tín hiệu dạy model
Bài tiếpTrain vs inference: hai pha, hai loại hoá đơn
Thảo luận & góp ý
Hỏi đáp về bài này