LLM nằm ở đâu trên bản đồ AI, deep learning, generative AI
AI chứa machine learning, chứa deep learning, chứa generative AI; LLM ở ô trong cùng. Pretraining vẫn so với đáp án, chỉ là đáp án lấy từ chính văn bản.
TL;DR: AI là vòng ngoài cùng: mọi chương trình giải bài toán cần trí thông minh, kể cả rule-based không học gì từ dữ liệu. Bên trong lần lượt là machine learning (học từ dữ liệu), deep learning (mạng nơ-ron nhiều lớp), rồi generative AI (sinh nội dung mới). LLM ở ô trong cùng: generative AI cho văn bản. Pretraining một LLM không có ai gán nhãn, nhưng nó vẫn học bằng cách đoán rồi so với đáp án đúng, y như supervised; chỉ là đáp án được lấy từ chính văn bản. Cách học này gọi là self-supervised. Toàn bộ thứ model biết nằm trong trọng số đã đóng băng lúc huấn luyện, nên chuyện xảy ra sau đó không có chỗ nào để tra.
Feed tin công nghệ của bạn xen kẽ hai loại bài khác hẳn nhau. Một bài nói bệnh viện dùng AI đọc phim X-quang, phát hiện bất thường mà mắt người dễ bỏ sót. Bài kế tiếp nói một trợ lý AI viết xong bản nháp email trong vài giây. Cả hai được gọi chung một chữ "AI", nên phản xạ tự nhiên là nghĩ chúng chạy cùng một công nghệ.
Không phải vậy. Hai hệ đó đứng ở hai chỗ khác hẳn nhau trên cùng một bản đồ, và gộp tất cả thành "AI" là cách nhanh nhất để đọc sai mọi tài liệu dùng AI, machine learning, deep learning, generative AI như thể chúng đồng nghĩa. Bài này vẽ lại bản đồ đó, đặt LLM vào đúng chỗ, rồi xem kỹ bước pretraining, bước tốn kém nhất khi làm ra một LLM.
1. Analogy: búp bê Nga lồng nhau
Búp bê Nga (matryoshka) là bộ búp bê gỗ lồng nhau: mở con to nhất thấy con nhỏ hơn bên trong, mở tiếp thấy con nhỏ hơn nữa. Bản đồ AI y hệt vậy: mỗi vòng bên trong là một tập con nằm trọn trong vòng ngoài, không phải nhánh song song.
| Búp bê matryoshka | Bản đồ AI |
|---|---|
| Con ngoài cùng, to nhất | AI: mọi chương trình giải bài toán cần trí thông minh, kể cả rule-based |
| Con thứ hai | Machine learning: học pattern từ dữ liệu thay vì luật viết tay |
| Con thứ ba | Deep learning: mạng nơ-ron nhiều lớp tự học đặc trưng |
| Con thứ tư | Generative AI: sinh nội dung mới |
| Con trong cùng | LLM: generative AI cho văn bản |
Mở từng lớp búp bê là thu hẹp dần. LLM chỉ là một điểm rất cụ thể ở lớp trong cùng, không đại diện cho cả bộ búp bê.
2. Bốn vòng trên bản đồ: LLM đứng ở đâu?
Vòng ngoài cùng, AI, không đòi hỏi học từ dữ liệu. Hệ luật viết tay (rule-based) ở bài 01 vẫn là AI đúng nghĩa, chỉ không nằm trong vòng kế tiếp. Vòng thứ hai, machine learning, là tập con của AI: học pattern từ ví dụ thay vì luật gõ tay. Vòng thứ ba, deep learning, là tập con của machine learning: dùng mạng nơ-ron nhiều lớp tự học đặc trưng từ dữ liệu thô. Vòng thứ tư, generative AI, nằm trong deep learning theo cách dùng từ hiện nay: sinh nội dung mới thay vì chỉ gán nhãn hay dự đoán một con số.
Cách xếp vòng thứ tư này là quy ước của thời nay. Tài liệu học thuật dùng "generative model" rộng hơn, có từ trước deep learning và không bắt buộc mạng nơ-ron (Naive Bayes, model n-gram). LLM đứng ở ô trong cùng: generative AI cho văn bản, sinh chữ bằng cách đoán token kế tiếp, lặp đi lặp lại (cơ chế chi tiết ở bài đầu module 3).
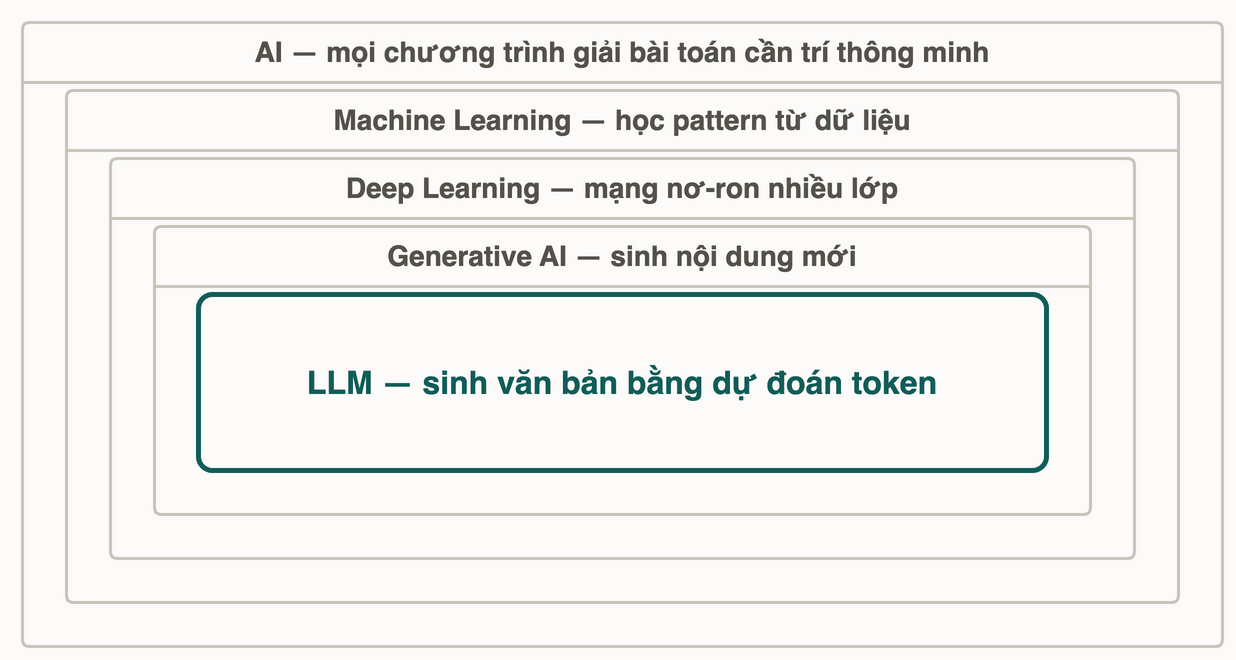
Hệ đọc phim X-quang làm bài toán phân loại, gán một nhãn có sẵn cho một ảnh, nên dừng ở vòng deep learning và chưa chạm generative AI. Trợ lý viết email sinh ra văn bản chưa từng tồn tại, nên nằm ở vòng generative AI, cụ thể là LLM.
Khi một LLM được pretrain trên hàng tỷ trang văn bản, nó học theo kiểu nào trong ba kiểu bài 02 đã dạy? Viết ra dự đoán kèm lý do trước khi cuộn xuống.
3. Không ai gán nhãn, vậy pretraining học bằng cách nào?
Bài 02: supervised có đáp án đúng để so, unsupervised không có đáp án nào để đối chiếu, reinforcement không có đáp án cho từng bước, chỉ có điểm thưởng chấm kết quả, thường đến thưa và trễ.
Phản xạ thường gặp là xếp LLM vào unsupervised, vì chẳng ai gán nhãn hàng tỷ trang văn bản. Nhưng hãy xem pretraining chạy thế nào: lấy một câu có thật, che phần cuối, bắt model đoán phần bị che, rồi so với phần thật. Phần thật không cần ai gán, nó nằm sẵn trong câu gốc. Đoán đúng hay sai lộ ra ngay, và sai lệch được dùng để chỉnh trọng số, y hệt quy trình của supervised.
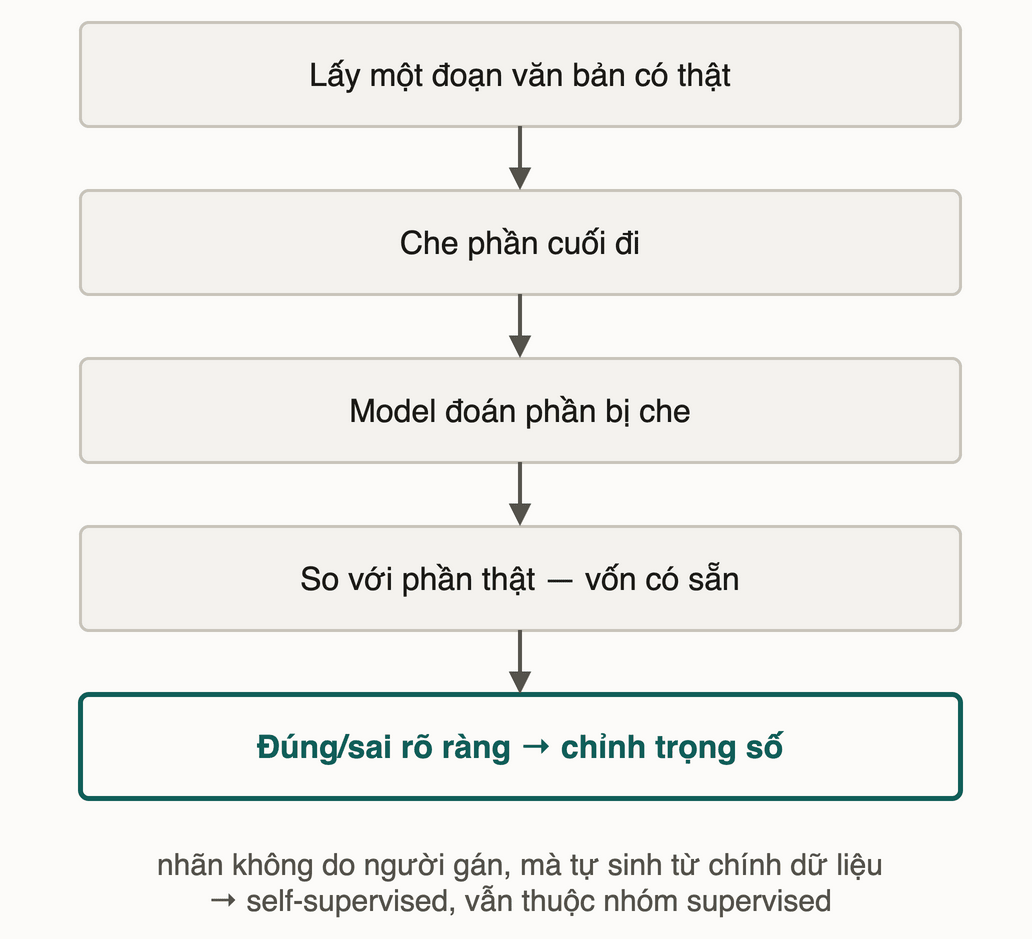
Tên kỹ thuật của cách học này là self-supervised learning (học tự giám sát): nhãn tự sinh từ chính dữ liệu thay vì do người gán. Tài liệu xếp nó chỗ này chỗ kia; có nơi coi là một nhánh của unsupervised vì dữ liệu đầu vào không có nhãn, có nơi đứng riêng thành nhóm thứ tư. Thứ bạn cần nắm là cơ chế: mỗi lần đoán đều có một đáp án đúng để so, và điều đó giống supervised chứ không giống unsupervised thuần, nơi chẳng có gì để so.
| Kiểu học | Nhãn đến từ đâu |
|---|---|
| Supervised cổ điển | Con người gán tay từng mẫu |
| Unsupervised | Không có nhãn nào |
| Pretraining LLM (self-supervised) | Tự sinh: che một phần, phần bị che là nhãn |
Chi tiết này giải thích vì sao LLM đạt được quy mô mà supervised cổ điển không theo kịp. Supervised cổ điển tắc ở chi phí gán nhãn: muốn một triệu mẫu có nhãn thì phải trả tiền cho người ngồi gán. Self-supervised xoá khoản đó, nên tập huấn luyện có thể lớn tới mức gần hết văn bản công khai sẵn có mà không ai phải gán một nhãn nào.
4. Hệ quả: không có database nào để tra
Bài 04: trọng số chỉ đổi ở pha train; inference chỉ tính toán trên trọng số đã đóng băng, không học thêm từ request đang xử lý.
Ghép hai mảnh lại: model biết gì hoàn toàn do văn bản nó đã thấy lúc pretraining (và các bước train sau đó), và pha đó dừng ở một thời điểm cụ thể. Văn bản ra đời sau mốc đó chưa từng đi qua bước "che, đoán, so, chỉnh trọng số". Mọi thứ model biết nằm gọn trong trọng số, không nằm trong một cơ sở dữ liệu để tra như công cụ tìm kiếm.
Vì vậy "model không biết chuyện mới" không phải lỗi chờ vá mà là hệ quả kiến trúc: trọng số đóng băng cuối pha train, mọi lần gọi API sau đó chỉ tính toán trên bộ trọng số cố định ấy. Prompt khéo tới đâu cũng không thêm được một byte kiến thức vào trọng số. Muốn model dùng thông tin mới thì thông tin phải đi kèm ngay trong lúc gọi.
Thử ngẫmmột cuốn sách đã in và phát hành thì sự kiện xảy ra sau ngày in không thể có trong sách. Trọng số của LLM giống cuốn sách đó ở điểm nào, và khác ở điểm nào?
5. Pitfall tổng hợp
❌ Nhầm 1: coi "AI" và "LLM" là một, đọc tin AI nào cũng tưởng đang nói về chatbot.
✅ AI là vòng ngoài cùng, bao cả rule-based lẫn những hệ machine learning không sinh nội dung gì. LLM chỉ là một điểm rất hẹp ở vòng trong cùng.
❌ Nhầm 2: nghĩ pretraining "không có gì để so" vì chẳng ai gán nhãn hàng tỷ trang văn bản.
✅ Mỗi bước đều có đáp án đúng để so: phần văn bản bị che. Khác biệt duy nhất so với supervised là nhãn tự sinh từ văn bản, chứ không phải thiếu đáp án như unsupervised thuần.
❌ Nhầm 3: hỏi model về sự kiện mới và nghĩ "prompt rõ hơn thì nó cập nhật được".
✅ Prompt không cập nhật được gì. Model chỉ có trọng số đóng băng; muốn dùng thông tin sau mốc đó thì thông tin phải đi kèm trong request.
6. 📚 Deep Dive
Nguồn gốc:
- Radford, Narasimhan, Salimans & Sutskever, Improving Language Understanding by Generative Pre-Training (OpenAI, 2018): paper đặt nền cho "pretrain trên văn bản chưa gán nhãn rồi fine-tune" mà dòng LLM hiện đại kế thừa. Chính paper này gọi bước pretraining là "unsupervised", dù mục tiêu huấn luyện (language modeling, đoán từ kế tiếp) là kiểu nhãn tự sinh mà sau này người ta gọi là self-supervised. Hai cách gọi cùng tồn tại, cơ chế thì chỉ có một.
Ghi chú: paper được dẫn để chỉ nơi ý tưởng pretrain rồi fine-tune xuất hiện trong dòng LLM hiện đại, không tóm tắt kết quả thực nghiệm. Kiến trúc và các bước huấn luyện tiếp theo (SFT, RLHF) thuộc module 3.
7. Liên hệ các bài khác
- Bài 02: Ba kiểu học: tín hiệu dạy là trục dùng lại xuyên suốt bài này.
- Bài 04: Train vs inference: trọng số đóng băng lúc inference là nền của mục 4.
- Module 3, bài 01: Dự đoán token kế tiếp: vòng lặp sinh văn bản mà bài này mới nhắc một câu.
- Bài 07: Mini-challenge: đọc mô tả hệ AI: dùng bản đồ bốn vòng để phân loại một hệ AI từ mô tả bằng lời.
8. Tóm tắt
- Hệ đọc X-quang dừng ở deep learning vì nó phân loại; trợ lý viết email ở generative AI vì nó sinh văn bản mới.
- Xếp generative AI vào trong deep learning là cách gọi thời nay; "generative model" trong sách giáo khoa rộng hơn.
- Self-supervised bỏ được chi phí gán nhãn, nên dữ liệu pretraining lớn được tới mức gần hết văn bản công khai.
- Thông tin sau mốc train chỉ tới được model qua input của request.
9. Tự kiểm tra
- Q1Vì sao nói "AI = LLM" là hiểu sai? Mô tả LLM nằm ở đâu trên bốn vòng của bản đồ.
- Q2Đồng nghiệp nói: "Pretraining chắc là unsupervised hoàn toàn, vì chẳng ai gán nhãn hàng tỷ trang văn bản." Chỗ nào cần sửa?
- Q3Giải thích cơ chế tự sinh nhãn trong pretraining bằng lời của bạn, và vì sao nó né được chỗ tắc của supervised cổ điển.
- Q4Vì sao "model không biết chuyện xảy ra sau ngày X" là hệ quả kiến trúc, không phải lỗi sửa được bằng prompt khéo hơn?
- Q5Một tin tuyển dụng ghi "yêu cầu kinh nghiệm AI, Machine Learning và Deep Learning" như ba kỹ năng ngang hàng. Cách viết đó bỏ qua điều gì?
Bài tiếp theo: Mini-challenge: đọc ba mô tả hệ thống
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Overfitting & data leakage: demo đẹp mà production hỏng
Bài tiếpMini-challenge: đọc ba mô tả hệ thống
Thảo luận & góp ý
Hỏi đáp về bài này