Overfitting & data leakage: demo đẹp mà production hỏng
Model thuộc lòng tập huấn luyện thì đo rất đẹp trên chính tập đó. Cộng thêm data leakage, bạn có một con số vô nghĩa mà không ai phát hiện tới lúc lên production.
TL;DR: Model đo đẹp trên tập huấn luyện nhưng tệ trên dữ liệu mới là đang overfitting: nó thuộc lòng thay vì học quy luật chung. Tệ hơn: nếu cả train lẫn validation đều đẹp mà production vẫn hỏng, nghi phạm số một là data leakage. Một feature vô tình mang thông tin chỉ có sau khi đã biết đáp án, nên đo nội bộ đẹp giả, còn lúc chạy thật thông tin đó luôn trống. Cách chẩn đoán: đọc cả bộ ba train/validation/production, không nhìn một con số đơn lẻ. Điểm càng đẹp bất thường càng đáng soát lại pipeline dữ liệu trước khi ăn mừng.
Đội bạn build model chặn giao dịch gian lận. Trên tập test giữ lại, model bắt được gần hết ca gian lận, và team deploy production ngay tuần đó. Một tháng sau, khi chargeback của tháng đầu về đủ, đội gian lận báo cáo model bỏ lọt phần lớn ca gian lận thật, còn chặn nhầm hàng loạt giao dịch bình thường, dù không ai đổi code hay hạ tầng. Chuyện gì đã sai giữa lúc đo và lúc chạy thật?
Bài này cho bạn một quy trình chẩn đoán: đọc ba con số train/validation/production để phân biệt hai nguyên nhân phổ biến nhất khiến "đo đẹp mà chạy hỏng": overfitting và data leakage.
Train và validation được đo ngay trong hoặc sát pha train. Production là lần đầu model chạy inference thật, trên dữ liệu chưa ai chuẩn bị sẵn. Overfitting và leakage sinh ra ở pha train, nhưng như bài 04 đã nói, hậu quả chỉ lộ khi model sang pha inference.
1. Analogy: học thuộc đề thi cũ và hiểu bài
Có hai cách ôn thi: học thuộc lòng đúng đề năm ngoái (làm lại đề đó được điểm tuyệt đối), hoặc hiểu bản chất bài học. Khác biệt chỉ lộ ra khi gặp đề mới: người học thuộc trượt thảm, người hiểu bài vẫn làm được.
Model overfitting làm đúng việc của người học thuộc đề. Nó không học quy luật sinh ra nhãn mà học thuộc từng điểm dữ liệu trong tập train, kể cả nhiễu vô nghĩa. Đề cũ và đề mới, với model, chính là tập train và dữ liệu thật lúc chạy production.
| Đời thường | Model học |
|---|---|
| Học thuộc đúng đề năm ngoái | Model khớp gần như hoàn hảo với tập train |
| Làm lại đúng đề đó, điểm tuyệt đối | Đo trên tập train, điểm rất cao |
| Gặp đề mới thì trượt | Gặp dữ liệu production chưa từng thấy thì sai nhiều |
| Người hiểu bài làm tốt cả đề cũ lẫn đề mới | Model generalize tốt: đo ổn trên cả train lẫn dữ liệu mới |
Overfitting là học thuộc chứ không phải học hiểu. Điểm cao trên những gì đã thấy không chứng minh được gì về những gì chưa thấy.
2. Thử đoán trước khi đọc tiếp
Quay lại model chặn gian lận. Con số đo là recall: trong các giao dịch gian lận thật, model bắt được bao nhiêu phần trăm. Ở production, recall chỉ tính được sau khi chargeback về, thường là vài tuần. Giả sử đội đo được ba scenario dưới đây (số liệu giả định, không phải benchmark thật):
| Scenario | Recall train | Recall validation | Recall production |
|---|---|---|---|
| A | 98% | 61% | 58% |
| B | 96% | 95% | 52% |
| C | 54% | 52% | 50% |
Gian lận thường chiếm khoảng 1% giao dịch. Một model đoán "hợp lệ" cho mọi giao dịch đạt 99% accuracy mà không bắt được ca nào. Với bài toán lệch lớp như vậy, accuracy che mất đúng thứ bạn cần đo; recall (kèm precision, để biết chặn nhầm bao nhiêu) mới nói thật.
Với mỗi scenario, bạn chẩn đoán model đang gặp vấn đề gì, dựa vào đâu trong ba con số? Viết ra cho cả ba rồi mới đọc phần chẩn đoán.
3. Đọc ba con số thế nào để ra chẩn đoán?
Ba con số, đọc đúng thứ tự, cho ra ba chẩn đoán khác nhau tuỳ tổ hợp cao/thấp:
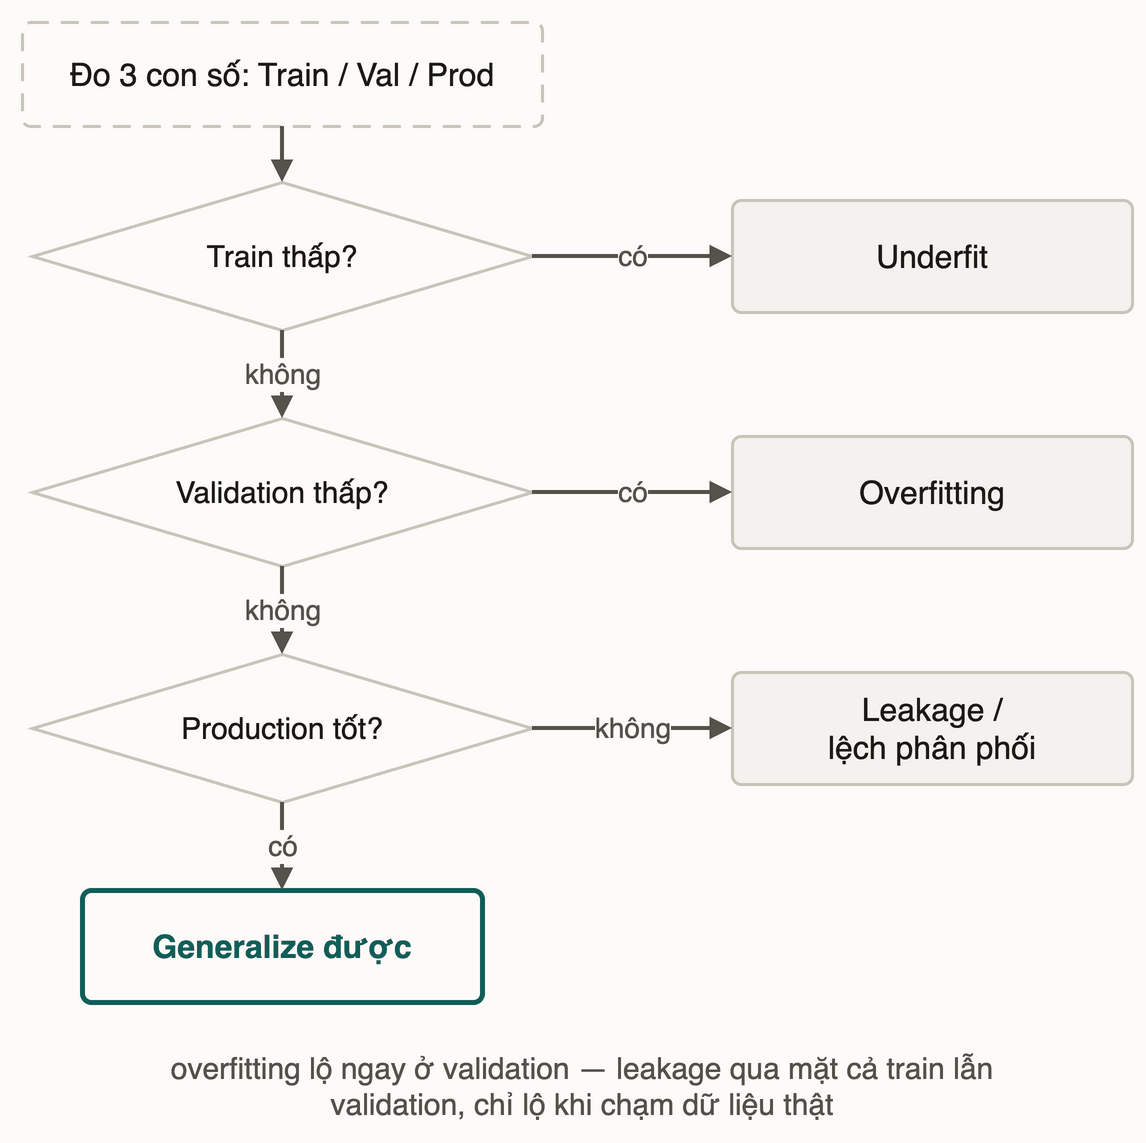
Đối chiếu với ba scenario ở mục 2:
- Scenario A (98% / 61% / 58%): train cao, validation thấp, đúng khuôn overfitting. Model khớp gần hoàn hảo tập train nhưng rớt mạnh ngay khi gặp dữ liệu validation chưa thấy.
- Scenario B (96% / 95% / 52%): train cao, validation cũng cao, nhưng production tệ. Đây là ca đáng ngại nhất, vì validation không báo động gì. Mục 4 và 5 đi vào nguyên nhân.
- Scenario C (54% / 52% / 50%): train đã thấp ngay từ đầu, model chưa học được quy luật nào. Đây là underfit; nguyên nhân và cách sửa khác hẳn overfitting. Bài này không đi sâu, chỉ cần nhận diện đúng để khỏi áp nhầm cách sửa.
Overfitting lộ ngay ở bước validation. Data leakage thì không: nó qua mặt cả hai lớp kiểm tra nội bộ, chỉ lộ khi gặp dữ liệu thật.
4. Data leakage: vì sao validation cũng bị lừa?
Data leakage (rò rỉ dữ liệu) là khi một feature vô tình mang thông tin chỉ có sau khi đáp án đã biết. Model không cố ý "gian lận". Nó chỉ tìm quy luật thống kê mạnh nhất trong các feature được đưa vào, kể cả khi đó là một lối tắt không dùng được lúc chạy thật.
Giả sử bảng feature có cột "trạng thái tranh chấp", chỉ được điền sau khi khách khiếu nại, tức sau khi đã biết chắc giao dịch có gian lận hay không. Model học được một quy luật gần như hoàn hảo: "có trạng thái tranh chấp thì gần chắc là gian lận". Trong dữ liệu lịch sử quy luật đó đúng tuyệt đối, vì kết quả có trước rồi cột đó mới được điền. Nhưng lúc chạy thật, giao dịch vừa xảy ra thì cột này luôn rỗng: thông tin model dựa vào không tồn tại đúng lúc cần dự đoán.
Cột leak có mặt đều trong cả train lẫn validation (cùng lấy từ một kho dữ liệu lịch sử), nên validation không phát hiện gì. Đó chính là scenario B. Production là nơi duy nhất cột đó trống, cũng là nơi vấn đề lộ ra.
5. Data leakage còn lọt vào qua đường nào?
Leakage còn len vào qua thứ tự làm việc với dữ liệu, không chỉ qua một cột "biết trước tương lai". Tính bất cứ thống kê nào trên toàn bộ dữ liệu (chuẩn hoá, điền thiếu, chọn feature) trước khi tách train/validation/test là đã trộn ngược thông tin từ phần "chưa từng thấy" vào phần train. Chia ngẫu nhiên dữ liệu có thời gian cũng vậy: model được thấy tương lai.
Bài 03 đã nêu luật cốt lõi: train, validation và test phải được tách trước khi đụng vào dữ liệu, trước cả bước chuẩn hoá hay xử lý sơ bộ, và chia theo mốc thời gian nếu dữ liệu có thứ tự. Tách đúng thứ tự thì validation và test giữ được vai "dữ liệu chưa từng thấy".
Vi phạm kiểu này khó thấy hơn cột "trạng thái tranh chấp" ở mục 4, vì lỗi nằm ở quy trình chứ không ở feature. Câu hỏi dùng chung cho cả hai kiểu leakage: "thông tin này có sẵn đúng vào lúc cần dự đoán ở production không?" Không thì là leakage.
Thử ngẫmmột quán cà phê tính giá trung bình nguyên liệu bằng cách gộp cả đơn hàng tuần sau lẫn tuần này. Con số đó còn đúng cho riêng tuần này không, và vì sao?
6. Vì sao điểm số đẹp bất thường là dấu hiệu đáng ngờ?
Thấy điểm cao thì phản xạ tự nhiên là ăn mừng. Với model thì nên làm ngược lại: một con số cao hơn hẳn kỳ vọng là lý do đi soát pipeline dữ liệu trước, ăn mừng sau. So với một baseline đơn giản, bài toán này có thật "dễ" cỡ đó không? Điểm cao hơn hẳn mức hợp lý thường là leakage đang cho model một lối tắt, chứ không phải model tự dưng giỏi lên.
7. Pitfall tổng hợp
❌ Nhầm 1: train và validation đều cao là yên tâm deploy.
✅ Đó là điều kiện cần, chưa phải điều kiện đủ (mục 6). Hai con số đo trên cùng một kho lịch sử; kho đó chứa leakage thì cả hai bị lừa như nhau.
❌ Nhầm 2: validation thấp thì luôn kết luận overfitting.
✅ Chỉ đúng khi train cao. Train cũng thấp là underfit, bệnh khác, cách sửa khác. Đọc cả ba con số theo thứ tự, đừng nhìn validation một mình.
❌ Nhầm 3: nghĩ đã tách train/validation/test là miễn nhiễm với leakage.
✅ Tách tập chỉ chặn leakage nếu làm đúng thứ tự: trước mọi bước tiền xử lý, và theo thời gian khi dữ liệu có thứ tự (mục 5). Tách sai thứ tự, hoặc có feature "biết trước tương lai" (mục 4), vẫn leak dù ba tập đã chia riêng.
8. 📚 Deep Dive
Tài liệu chính chủ:
- Google ML Crash Course, Overfitting: overfitting là khi model khớp tập train chặt tới mức dự đoán sai trên dữ liệu mới; trang này cũng mô tả cặp đường loss train/validation tách nhau, dấu hiệu chẩn đoán dùng ở mục 3.
- Kaufman, Rosset, Perlich, "Leakage in Data Mining: Formulation, Detection, and Avoidance": paper kinh điển (KDD 2011, bản mở rộng ở ACM TKDD 2012) xếp leakage vào nhóm mười lỗi data mining phổ biến nhất và đề xuất "learn-predict separation", chính là luật tách trước ở bài 03.
- Google ML Crash Course, Classification: accuracy, recall, precision: vì sao accuracy đánh lừa với dữ liệu lệch lớp.
9. Liên hệ các bài khác
- Bài 03: Dữ liệu, nhãn và ba tập không được trộn: hàng rào chính chặn leakage qua tiền xử lý (mục 5).
- Bài 04: Train vs inference: vì sao lỗi này chỉ lộ khi model chạy thật.
- Mini-challenge: đọc mô tả một hệ AI: luyện chẩn đoán đúng loại lỗi bằng cây ở mục 3.
10. Tóm tắt
- Train thấp là underfit: model chưa học được gì, kể cả trên dữ liệu đã thấy.
- Leakage có hai dạng: feature chỉ có sau khi biết đáp án, hoặc tiền xử lý và cách chia tập làm sai thứ tự.
- Recall production chỉ đo được khi chargeback về, nên leakage thường lộ ra muộn vài tuần.
- Điểm cao hơn hẳn baseline đơn giản là lý do soát pipeline, không phải lý do deploy.
11. Tự kiểm tra
- Q1Vì sao train cao đi kèm validation thấp là dấu hiệu overfitting chứ không phải dấu hiệu tốt?
- Q2Một model đạt recall cao gần như nhau trên train lẫn validation, nhưng production tệ hẳn. Vì sao đây không phải overfitting, và bạn nghi gì trước tiên?
- Q3Vì sao cột 'trạng thái tranh chấp' là một ca leakage, dù về mặt thống kê nó dự đoán rất chính xác?
- Q4Luật 'tách train/validation/test trước khi đụng vào dữ liệu' chặn được kiểu leakage nào, và vì sao chỉ tách tập thôi chưa đủ?
- Q5Một model có recall thấp trên cả train lẫn validation. Đây là lỗi gì, và vì sao áp cách sửa overfitting (thu nhỏ model, thêm regularization) vào đây là sai hướng?
- Q6Model chặn gian lận báo accuracy 99% trên tập test. Vì sao con số này chưa nói được gì, và bạn cần hỏi thêm con số nào?
Bài tiếp theo: LLM nằm ở đâu trên bản đồ AI
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Train vs inference: hai pha, hai loại hoá đơn
Bài tiếpLLM nằm ở đâu trên bản đồ AI, deep learning, generative AI
Thảo luận & góp ý
Hỏi đáp về bài này