Mini-challenge: đọc ba mô tả hệ thống
Ba mô tả feature nghe đều 'cần AI'. Tự phân loại kiểu học, chỉ ra chỗ phép đo không đáng tin, và quyết định có nên học từ dữ liệu. Một bài không cần chạy model.
TL;DR: Ba mô tả dưới đây đều mở đầu bằng một câu quen thuộc: "cần AI để...". Nhưng một cái không cần model nào: luật đã có sẵn, cố định, phải giải thích được. Một cái đo rất đẹp trên tập test rồi sụp ở production, vì hai lỗi độc lập trong cách chọn feature và cách chia dữ liệu. Một cái không có nhãn nào để so đúng sai, nên cách nghiệm thu phải đổi hẳn. Bài này không dạy khái niệm mới; nó bắt bạn tự áp những gì đã học vào ba tình huống, trước khi đọc lời giải.
Ba scenario dưới đây đều được gói trong một câu quen thuộc trên backlog: "làm cái model dự đoán X". Nghe giống nhau không có nghĩa là có cùng một câu trả lời đúng. Bài này luyện cho bạn phân biệt lúc nào "cần model" là đúng, lúc nào là phản xạ sai, và khi model đã chạy rồi thì làm sao biết con số đo có đáng tin.
Học từ dữ liệu chỉ đáng giá khi luật từ input ra output KHÔNG viết ra tường minh được, hoặc có quá nhiều biến thể để liệt kê bằng tay. Khi luật đã có sẵn, đứng yên, và cần giải thích được cho người ngoài, rule-based vẫn là lựa chọn đúng; thêm model vào chỉ tốn thêm chi phí mà không được gì.
Ba kiểu học không khác nhau ở thuật toán, mà ở loại phản hồi model nhận để biết mình đúng hay sai. Có đáp án đúng cho từng mẫu là một loại; không có nhãn nào, chỉ có cấu trúc trong dữ liệu, là loại khác, và nó đổi hẳn cách "chấm điểm" kết quả sau này.
Model chỉ học đúng khi nhãn đúng, và con số đo trên tập test chỉ đáng tin nếu tập đó thật sự tách biệt với những gì model đã thấy lúc train. "Tách biệt" không chỉ là không trùng dòng; còn phải hỏi tập test có đại diện đúng cho điều kiện lúc model chạy thật hay không.
Model đo đẹp trên tập test nhưng hỏng khi chạy thật thường không phải vì thuật toán tệ, mà vì phép đo đã hỏng từ trước: hoặc model học vẹt đặc điểm riêng của tập train (overfitting), hoặc trong feature có thông tin lẽ ra chưa được biết lúc dự đoán (data leakage).
🎯 Đề bài: ba ticket nghe giống nhau
Bạn là kỹ sư data ở một ngân hàng số phát hành thẻ tín dụng. Ba ticket cùng rơi vào backlog trong một tuần.
Scenario 1: Miễn phí thường niên thẻ tín dụng
Phòng sản phẩm đã ban hành và công bố chính sách: khách được miễn phí thường niên năm sau nếu tổng chi tiêu qua thẻ trong năm đạt một ngưỡng cụ thể theo hạng thẻ, và vẫn giữ đúng hạng thẻ đó tới cuối năm. Ngưỡng và hạng thẻ ghi rõ trong văn bản chính sách nội bộ; đội Compliance dùng đúng văn bản đó để trả lời khiếu nại và phục vụ kiểm toán hằng năm.
Trưởng phòng Data mở ticket: "Bên mình có sẵn dữ liệu giao dịch nhiều năm, làm cái model dự đoán khách nào sẽ được miễn phí năm sau, để CSKH chủ động báo trước cho khách."
Scenario 2: Model chấm điểm rủi ro giao dịch
Một đội khác đã xây xong model risk-scoring. Với mỗi giao dịch thẻ, tại thời điểm xin cấp phép (authorization), model trả một điểm rủi ro để hệ thống quyết định approve, decline, hay bắt xác thực thêm. Đánh giá offline trên tập test giữ lại 20% dữ liệu lịch sử, model đạt AUC 0.94. AUC là điểm từ 0 đến 1 đo khả năng model xếp giao dịch gian lận có điểm rủi ro cao hơn giao dịch hợp lệ, càng gần 1 càng tốt (đây là dữ kiện giả định của scenario, không phải benchmark thật). Team tự tin deploy.
Hai tháng sau khi lên production, catch rate (tỉ lệ giao dịch gian lận thật bị chặn đúng lúc) thấp hơn hẳn mức AUC offline hứa hẹn. Nhiều giao dịch gian lận vẫn lọt qua, kể cả những kiểu gian lận từng xuất hiện nhiều trong dữ liệu lịch sử. Bạn được kéo vào chẩn đoán, và được đưa danh sách feature cùng cách chia tập:
-- Danh sách feature dùng để train model risk-scoring
FEATURES = [
    so_tien_giao_dich,
    loai_the,
    so_giao_dich_trong_24h_gan_nhat,
    khoang_cach_dia_ly_so_voi_giao_dich_truoc_do,
    trang_thai_tranh_chap,       -- có trong kho dữ liệu lịch sử
]
LABEL = nhan_gian_lan            -- 1 nếu là gian lận, 0 nếu không

-- Cách chia tập để train và đánh giá
function chiaTapDuLieu(danhSachGiaoDich):
    xaoTronNgauNhien(danhSachGiaoDich)      -- shuffle toàn bộ trước khi cắt
    train <- danhSachGiaoDich[0 : 80%]
    test  <- danhSachGiaoDich[80% : 100%]
    return train, test
Scenario 3: Chia nhóm khách hàng
Đội marketing muốn chia toàn bộ khách hàng thẻ tín dụng thành các nhóm để thiết kế ưu đãi riêng cho từng nhóm, nhưng chưa ai định nghĩa trước các nhóm đó là gì. Không có cột "khách cao cấp" hay "khách thường" gán sẵn, không có nhãn nào. Thứ duy nhất có là hành vi: tần suất giao dịch mỗi tháng, giá trị trung bình một giao dịch, danh mục chi tiêu chính, số năm mở tài khoản.
Ticket ghi: "Dùng dữ liệu hành vi, tự động chia khách hàng thành các nhóm có ý nghĩa để mỗi nhóm nhận một chiến dịch khác nhau."
✍️ Phần việc của bạn
Trước khi cuộn xuống, viết ra cho cả ba scenario, trên giấy hay trong đầu cũng được, nhưng phải thành câu:
- Scenario 1: Có nên xây model không? Trả lời có/không kèm đúng một lý do kỹ thuật (không phải "tôi thấy không cần"). Nếu không xây model, đề xuất cách làm thay thế.
- Scenario 2: Chỉ ra hai lỗi độc lập trong hai đoạn pseudocode trên, một ở phần khai báo feature, một ở hàm chia tập. Với mỗi lỗi, giải thích cơ chế: vì sao nó làm AUC đo trên tập test cao hơn thực tế, và vì sao catch rate ở production lại thấp hơn nhiều.
- Scenario 3: Đây là kiểu học nào trong ba kiểu? Giả sử thuật toán chia khách hàng thành 4 nhóm; làm sao bạn biết kết quả đó "đúng"? Nêu cụ thể thứ gì thay cho "so với nhãn thật" mà scenario 2 có còn scenario này không có.
💡 Gợi ý
Phần này không có kết luận, chỉ có câu hỏi để bạn tự lần ra đáp án. Chưa viết xong phần việc ở trên thì quay lại làm trước.
- Scenario 1: Nếu liệt kê hết mọi trường hợp input (ngưỡng chi tiêu, hạng thẻ), bạn có viết được toàn bộ ánh xạ sang output bằng vài dòng điều kiện không? Nếu viết được thì "học" ở đây còn học cái gì mà luật chưa có?
- Scenario 2, feature: Cột
trang_thai_tranh_chapcó giá trị ngay lúc hệ thống cần quyết định approve/decline, hay chỉ có sau khi một quy trình khác (điều tra khiếu nại) chạy xong? - Scenario 2, chia tập:
xaoTronNgauNhientrộn giao dịch mà không quan tâm thứ tự thời gian. Nếu hai giao dịch của cùng một đường dây gian lận rơi vào cả train lẫn test, model cần tổng quát hoá hay chỉ cần nhớ lại? - Scenario 3: Không có nhãn để so thì con số nào bạn CÓ THỂ tính từ chính cách các nhóm được chia? Con số đó trả lời được câu "các nhóm tách nhau rõ về mặt toán học", nhưng có trả lời được câu "các nhóm này có ích cho marketing" không?
✅ Lời giải
Scenario 1: Rule-based, không cần model
Đây là cái bẫy có chủ đích: scenario này không cần model nào. Luật miễn phí do phòng sản phẩm viết và đã công bố; ánh xạ từ input (tổng chi tiêu, hạng thẻ) sang output (miễn hay không) là một điều kiện viết được trong vài dòng. Không có pattern ẩn nào cần tìm trong dữ liệu, vì bản thân luật đã LÀ đáp án đầy đủ.
Có ba lý do rule-based thắng tuyệt đối ở đây.
Phải giải thích được là ràng buộc cứng. Compliance cần trả lời khách dựa trên đúng điều khoản nào, kiểm toán cần đối chiếu quyết định với văn bản chính sách. Một model, kể cả model chính xác gần tuyệt đối, vẫn có thể lệch khỏi văn bản ở vài trường hợp biên, và khi lệch thì không ai giải thích được "vì sao model nói vậy" bằng điều khoản đã ký. Rule-based khớp 100% với văn bản vì nó chính là văn bản viết lại thành code.
Không có gì để học. Học từ dữ liệu có giá trị khi ánh xạ input sang output không viết ra được. Ở đây luật có sẵn; train một model để nó "đoán lại" thứ một câu truy vấn trả lời chính xác là phí công, và tệ hơn, model có thể học sai một phần luật mà không ai biết cho tới khi kiểm toán phát hiện.
Chi phí vòng đời không đổi lấy được gì. Model cần retrain khi dữ liệu trôi, cần giám sát liên tục. Rule-based chỉ cần sửa một điều kiện khi chính sách đổi, mà chính sách thì ít đổi và có quy trình duyệt.
Đề xuất thay thế: viết truy vấn hoặc rule engine thẳng từ văn bản chính sách. Nếu sếp thật sự muốn "chủ động báo trước cho khách", bài toán đáng làm bằng model là một bài toán khác: dự đoán khách nào sẽ chạm ngưỡng chi tiêu vào cuối năm nếu xu hướng hiện tại tiếp diễn. Đó là dự đoán một tương lai chưa biết, khác hẳn việc áp một luật đã biết lên dữ liệu đã có.
Bài học ở đây dùng lại được cho mọi module sau: nghe "cần AI" không có nghĩa là cần AI. Mini-challenge của module Embedding & RAG sẽ gặp lại đúng cái bẫy này, ở dạng "có tài liệu thì tưởng phải làm RAG".
Scenario 2: hai lỗi độc lập, leakage ở feature và sai trục thời gian khi chia tập
Lỗi 1: data leakage ở cột trang_thai_tranh_chap. Cột này chỉ được điền SAU KHI giao dịch đã bị khiếu nại và đội điều tra xử lý xong. Ngay lúc hệ thống cần quyết định (lúc authorization, real-time) thì cột này chưa có, luôn rỗng. Nhưng lúc train, cột này gần như trùng khớp với nhãn nhan_gian_lan, nên model học được một lối tắt: chỉ cần nhìn cột này là đoán đúng gần hết, khỏi học pattern hành vi thật. Vì vậy AUC offline cao vọt: model không dự đoán gì cả, nó đọc trước một đáp án đã lọt vào tập feature. Lên production, cột này luôn rỗng, thứ model dựa vào nhiều nhất biến mất, và catch rate rơi tự do.
Lỗi 2: chia tập ngẫu nhiên thay vì theo thời gian. xaoTronNgauNhien trộn toàn bộ giao dịch rồi mới cắt 80/20, bất kể giao dịch xảy ra lúc nào. Gian lận thẻ không đứng yên: một đường dây gian lận (fraud ring) đổi chiêu liên tục, và giao dịch của cùng một đường dây thường xảy ra sát nhau về thời gian. Trộn ngẫu nhiên thì giao dịch của cùng một đường dây có thể rơi cả vào train lẫn test. Model khỏi cần tổng quát hoá, chỉ cần nhớ lại đặc điểm của đường dây đó vì đã thấy một phần "anh em" của nó lúc train. Tập test vì thế không còn giống điều kiện thật của production, nơi model luôn phải đoán những đường dây chưa từng thấy.
Vì sao phải sửa cả hai. Hai lỗi cộng dồn theo hai cơ chế khác nhau. Leakage làm model dựa vào một feature không có lúc production (lỗi ở CÁI GÌ được học). Chia ngẫu nhiên làm phép đo không phản ánh việc dự đoán tương lai (lỗi ở CÁCH ĐO). Sửa leakage mà vẫn chia ngẫu nhiên thì AUC vẫn phồng vì các giao dịch cùng đường dây nằm hai bên. Chia theo thời gian mà vẫn giữ cột leak thì phép đo trung thực hơn về thời gian, nhưng model production vẫn sụp vì thiếu đúng feature nó dựa vào.
Cách sửa: (1) audit toàn bộ feature theo tiêu chí point-in-time: với mỗi cột, hỏi giá trị của nó có tồn tại đúng lúc cần dự đoán thật không, và loại mọi cột chỉ có sau một quy trình phía sau (điều tra, khiếu nại, chargeback); (2) chia tập theo thời gian: train trên một khoảng quá khứ, test trên một khoảng sau đó, tách biệt hoàn toàn, đúng như việc model production luôn phải đoán tương lai chưa thấy.
Scenario 3: Unsupervised, và nghiệm thu không còn là "so với nhãn thật"
Đây là unsupervised: không nhóm nào được gán nhãn trước, input chỉ có các đặc trưng hành vi, không có cột target để so đúng sai. Thứ duy nhất thuật toán dựa vào là độ giống nhau giữa các khách hàng: ai có hành vi gần nhau thì gom chung một nhóm. Đối chiếu với ba kiểu học: supervised học từ cặp (input, nhãn); ở đây không có vế nhãn.
Phần khó nhất, cũng là phần hay bị bỏ qua: nghiệm thu bài này không giống nghiệm thu một classifier như scenario 2. Không có ground truth khách quan để so, nên cũng không có một con số accuracy hay AUC để chốt đúng sai. Chia 4 nhóm hay 6 nhóm thì thuật toán đều chạy xong được; chẳng có đáp số nào để phân định cách nào đúng hơn.
Ba thứ thay cho "so với nhãn thật":
- Đánh giá nội tại (thống kê thuần): đo các nhóm có tách nhau rõ về mặt toán học không, kết quả có ổn định khi chạy lại nhiều lần không. Kiểu đo này chỉ cho biết cấu trúc gọn về mặt toán, không cho biết cấu trúc đó có ý nghĩa với kinh doanh.
- Đánh giá bởi người hiểu nghiệp vụ: đưa các nhóm cho đội marketing xem, hỏi chúng có khớp với hiểu biết thực tế về khách hàng không, có khác nhau đủ để làm chiến dịch riêng không. Đây mới là bước quyết định, và nó là một phán đoán có cơ sở chứ không phải một con số.
- Đo hiệu quả thật ở khâu sau: chạy thử chiến dịch theo từng nhóm rồi đo phản hồi của khách. Cách này chậm, chỉ có kết quả sau khi đã triển khai.
Đối lập với scenario 2: model risk-scoring có nhãn thật (giao dịch có phải gian lận không, biết chắc sau điều tra), nên nghiệm thu là so với ground truth và ra được một con số. Chia nhóm khách hàng không có ground truth, nên nghiệm thu chuyển từ "đo" sang "thuyết phục người có chuyên môn".
Khung một hình
Hai câu hỏi lọc cho mọi ticket "nghe cần AI", áp lần lượt, dẫn ra ba nhánh (lần lượt là lời giải scenario 1, 3, 2):
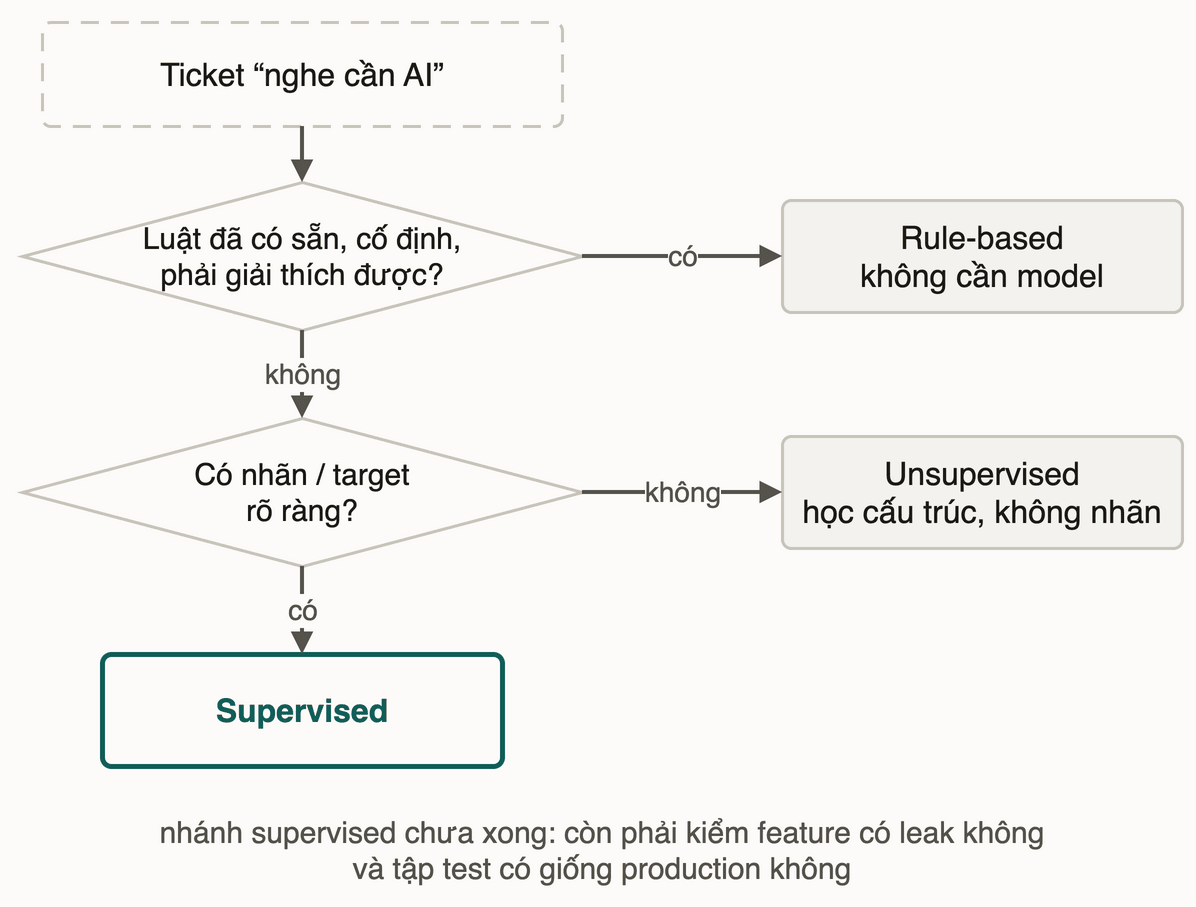
Ở nhánh supervised, "AUC đẹp trên tập test" chỉ đáng tin khi feature không leak và tập test đi đúng điều kiện production. Vì vậy scenario 2 không dừng ở chuyện chọn kiểu học mà phải chẩn đoán tiếp phép đo.
🎓 Mở rộng
- Ba scenario này không hiếm. Chúng là ba câu hỏi lặp lại ở gần như mọi ticket "làm AI cho X": có luật cố định sẵn không, phép đo có đang hỏng mà không ai hay không, và có nhãn nào để so không.
- Leakage và chia ngẫu nhiên thay vì theo thời gian là hai lỗi rất phổ biến, không riêng gì gian lận thẻ mà ở mọi bài toán dự đoán trên dữ liệu có thời gian (churn, giá, nhu cầu). Thói quen tự hỏi "cột này, tập test này có tồn tại đúng lúc cần dự đoán thật không" dùng được cho hầu hết pipeline kiểu này.
- "Không có nhãn thì nghiệm thu bằng phán đoán chuyên môn" không phải điểm yếu của unsupervised, đó là bản chất bài toán. Nhầm lẫn phổ biến là cố ép một con số đơn lẻ để "chứng minh" một kết quả chia nhóm, trong khi câu hỏi thật luôn cần người hiểu nghiệp vụ trả lời.
Thử ngẫmsếp đưa ticket mới "dùng AI dự đoán khách nào sẽ rời bỏ dịch vụ". Áp khung hai câu hỏi ở bài này, bạn hỏi điều gì trước tiên?
✨ Điều bạn vừa làm được
- Nhận ra lúc một ticket "cần AI" thật ra không cần model nào, một kỹ năng hiếm và đáng giá hơn biết xây model.
- Chẩn đoán được hai lỗi độc lập (leakage ở feature, sai trục thời gian khi chia tập) từ mô tả một pipeline, và giải thích được mỗi lỗi thổi phồng con số offline bằng cơ chế nào.
- Nhận ra lúc bài toán là unsupervised, và vì sao nghiệm thu một kết quả không nhãn phải đổi hẳn cách nhìn so với nghiệm thu một classifier.
Bài tiếp theo: Tổng kết module: cheat sheet và tự đánh giá
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
LLM nằm ở đâu trên bản đồ AI, deep learning, generative AI
Bài tiếpTổng kết: Bản đồ AI & học từ dữ liệu
Thảo luận & góp ý
Hỏi đáp về bài này