Ba kiểu học: phân biệt bằng tín hiệu dạy model
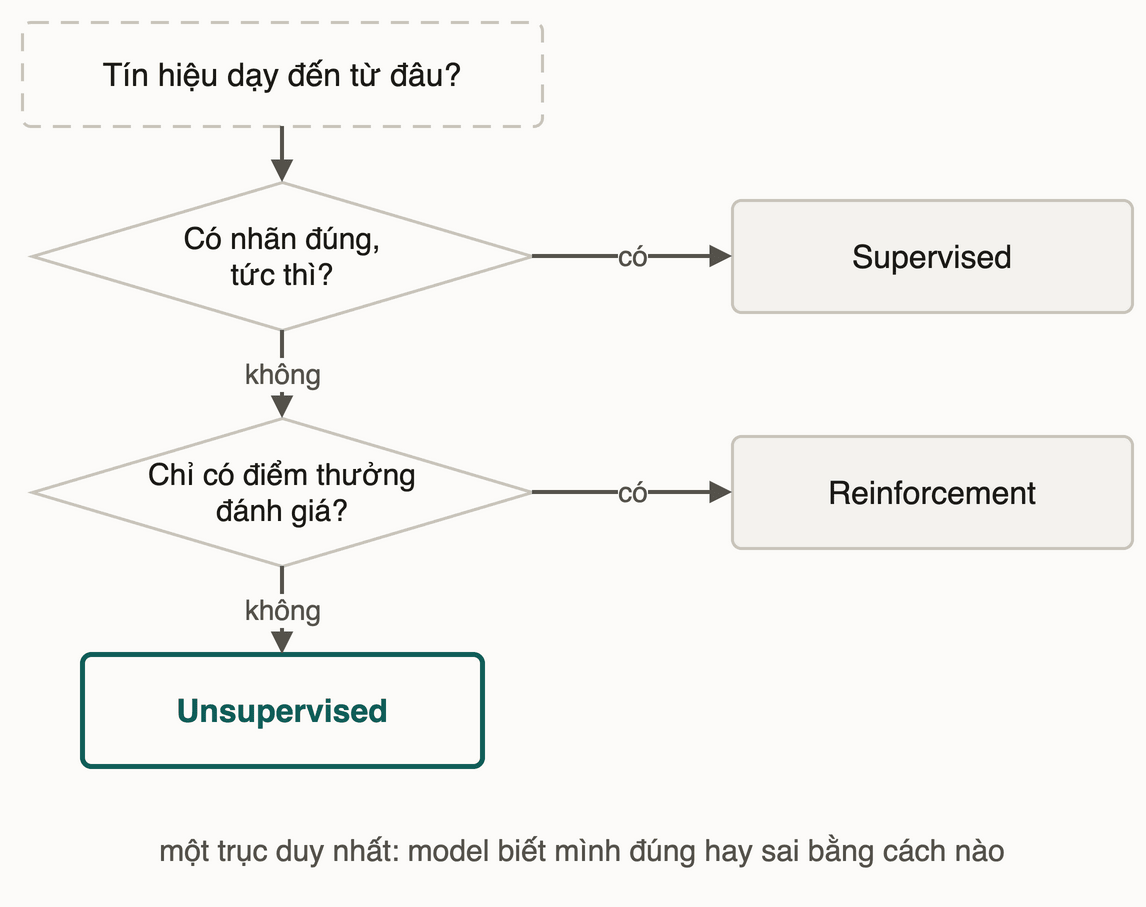
Supervised, unsupervised, reinforcement khác nhau ở một thứ: model nhận phản hồi gì để biết đúng hay sai. Nắm trục này thì đọc tài liệu nào cũng xếp đúng chỗ.
TL;DR: Ba kiểu học của machine learning (supervised, unsupervised, reinforcement) không khác nhau ở thuật toán. Chúng khác nhau ở đúng một thứ: tín hiệu dạy, tức phản hồi model nhận để biết mình đúng hay sai. Supervised có đáp án đúng đi kèm từng mẫu. Unsupervised không có đáp án nào, chỉ có cấu trúc sẵn trong dữ liệu. Reinforcement không có đáp án cho từng bước, chỉ có điểm thưởng chấm kết quả, thường đến thưa và trễ sau cả chuỗi hành động. Cái đắt của supervised nằm ở nhãn chứ không ở thuật toán; còn unsupervised không có đáp án thì cũng không có thước đo đúng sai khách quan.
Team bạn chạy song song ba dự án "AI" trong một hệ thống fintech nội bộ: model chặn giao dịch gian lận, model gom nhóm khách hàng theo hành vi, và hệ thống tự tối ưu lịch nhắc nợ. Cả ba đều bị gọi chung là "machine learning", nhưng lúc review thiết kế thì ba câu hỏi khác hẳn nhau hiện ra. Model gian lận cần bao nhiêu ca đã xác nhận mới đủ train? Model gom nhóm "đúng" hay "sai" thì lấy gì đo? Hệ thống nhắc nợ học từ đâu khi không ai gắn nhãn cho từng tin nhắn gửi đi?
Ba câu hỏi đó lộ ra ba kiểu học đang dùng chung một cái tên. Bài này chỉ ra trục duy nhất tách chúng.
Bài trước: khi luật ngầm hoặc trôi theo thời gian, machine learning thay việc viết luật bằng việc cho model xem ví dụ, và luật được suy ra từ dữ liệu. Nhưng "suy ra từ dữ liệu" chưa nói model biết mình suy đúng hay sai bằng cách nào. Câu hỏi đó chính là trục phân biệt ba kiểu học ở bài này.
1. Analogy: ba thực tập sinh nhận phản hồi
Hình dung ba thực tập sinh nhận phản hồi theo ba cách. Người thứ nhất làm bài có đáp án mẫu, mentor chấm từng câu. Người thứ hai nhận một chồng hồ sơ khách hàng chưa ai phân loại; không ai chấm, cậu tự nhận ra vài nhóm hành vi lặp lại. Người thứ ba vận hành một quy trình nhiều bước suốt cả tháng; không ai chỉnh từng bước, cuối tháng chỉ biết một con số: đạt KPI hay không.
| Thực tập sinh | Kiểu học tương ứng |
|---|---|
| Làm bài có đáp án mẫu, chấm đúng sai từng câu | Supervised: đáp án đúng cho từng mẫu |
| Xem hồ sơ chưa phân loại, tự nhận ra nhóm lặp lại | Unsupervised: không đáp án, chỉ có cấu trúc trong dữ liệu |
| Vận hành quy trình nhiều bước, chỉ biết kết quả cuối tháng | Reinforcement: không ai chỉ từng bước, chỉ có điểm thưởng, thường đến thưa |
Đừng nhớ theo thuật toán. Nhớ một câu hỏi: model biết mình sai nhờ đâu? Có đáp án để so, không có gì để so, hay chỉ có một điểm chấm tốt/xấu?
2. Trục nào phân biệt ba kiểu học?
Model nào cũng cần một cách biết mình đang làm tốt hay tệ, rồi tự chỉnh theo hướng tốt hơn. Ba kiểu học khác nhau đúng ở nguồn của phản hồi đó.
Supervised có đáp án đúng cho từng mẫu. Model đưa ra dự đoán, so với nhãn thật, biết mình sai bao nhiêu, rồi chỉnh theo hướng giảm sai số.
Unsupervised không có đáp án nào. Dữ liệu không đi kèm nhãn; thứ duy nhất model có là cấu trúc sẵn trong chính dữ liệu: mẫu nào giống mẫu nào, mẫu nào lệch khỏi số đông.
Reinforcement không có ai chỉ hành động đúng cho từng bước. Model (thường gọi là agent) thực hiện một chuỗi hành động, và phản hồi duy nhất là điểm thưởng: một con số chấm hành động tốt hay xấu bao nhiêu, chứ không nói đáng lẽ phải làm gì. Trong nhiều bài toán thật, điểm thưởng bằng 0 ở hầu hết các bước và chỉ khác 0 ở cuối chuỗi, nên rất khó biết bước nào có công.
Nhìn qua pseudocode, khác biệt nằm ở đúng một dòng, dòng so sánh để tính ra phản hồi:
-- Supervised: mỗi mẫu có sẵn nhãn đúng
for each (dau_vao, nhan_dung) in du_lieu_huan_luyen:
    du_doan <- model(dau_vao)
    sai_so <- so_sanh(du_doan, nhan_dung)        -- so ra là biết sai bao nhiêu
    model.chinh(sai_so)

-- Unsupervised: không có nhan_dung nào
for each dau_vao in du_lieu_huan_luyen:
    model.tim_cau_truc(dau_vao)                  -- không có gì để so
-- kết quả là các nhóm tự phát hiện, không phải dự đoán đúng/sai

-- Reinforcement: không ai chỉ hành động đúng cho từng bước
trang_thai <- trang_thai_ban_dau
while chua_ket_thuc_chuoi:
    hanh_dong <- chinh_sach(trang_thai)
    trang_thai, thuong <- moi_truong.thuc_hien(hanh_dong)  -- chấm điểm, không chỉ đáp án; nhiều bước thuong = 0
-- thưởng thưa thì khó biết bước nào có công, phải chỉnh chính sách theo tổng thưởng cả chuỗi
Dòng so_sanh(du_doan, nhan_dung) chỉ có ở nhánh supervised. Nhánh unsupervised không có biến nhan_dung để so, nên "không có đáp án" là một khác biệt cụ thể trong code chứ không phải mô tả mơ hồ. Nhánh reinforcement có thuong ở mỗi bước, nhưng thuong chỉ chấm điểm; nó không nói đáp án như nhan_dung. Khi thuong thưa, việc chia công cho từng hanh_dong là một bài toán riêng (tiếng Anh gọi là credit assignment).
Thử ngẫmmột huấn luyện viên chỉ nói "thắng" hay "thua" sau cả trận, không chỉnh từng pha bóng. Cầu thủ đang học theo kiểu nào trong ba kiểu, và vì sao khó biết pha nào có công?
3. Ba kiểu học qua ba hệ thống fintech
3.1 Supervised: phân loại giao dịch gian lận
Hệ thống chặn gian lận cần nhãn "gian lận" hoặc "hợp lệ" cho từng giao dịch lịch sử. Nhãn đó đến từ khiếu nại đã xác nhận và chargeback đã xử lý xong, tức một quy trình nghiệp vụ thật đã kết luận giao dịch đó có gian lận. Model học ánh xạ từ đặc trưng giao dịch (số tiền, giờ, thiết bị, vị trí) sang nhãn đó.
3.2 Unsupervised: chia khách hàng thành những nhóm chưa ai định nghĩa
Đội growth muốn biết khách hàng chia thành những nhóm hành vi nào: tần suất giao dịch, số dư trung bình, kênh hay dùng. Không ai gắn nhãn "khách VIP" hay "khách sắp rời bỏ" từ trước. Nếu có tên nhóm, người ta đặt tên sau khi nhìn thấy nhóm model tự tìm ra. Model chỉ nhận dữ liệu hành vi thô, không có đáp án nào để đối chiếu.
3.3 Reinforcement: tối ưu chính sách nhắc nợ
Hệ thống quyết định gửi nhắc nợ lúc nào, qua kênh nào, bao nhiêu lần. Không có đáp án đúng cho từng lần gửi riêng lẻ. Chỉ có điểm thưởng, và ở đây nó đến thưa: phải sau cả chuỗi quyết định, khi biết khách có trả tiền hay không, thường là sau vài lần nhắc. Model học chính sách bằng cách thử nhiều chuỗi hành động rồi chỉnh dần theo tổng điểm thưởng.
Ba hệ thống trên là minh hoạ giả định cho mục đích giải thích, không mô tả quy trình vận hành thật của một tổ chức cụ thể.
4. Supervised đắt ở đâu, unsupervised đắt ở đâu?
Ngộ nhận phổ biến: supervised khó triển khai vì thuật toán phức tạp. Thực tế ngược lại, cái đắt là nhãn, không phải thuật toán học từ nhãn.
Nhãn "gian lận" ở mục 3.1 chỉ đáng tin sau khi khiếu nại và chargeback xử lý xong, một quy trình tính bằng tháng. Còn dữ liệu hành vi ở mục 3.2 đã nằm sẵn trong log giao dịch, không phải chờ ai gắn nhãn, nên rẻ hơn để bắt đầu.
Cái rẻ đó có giá riêng. Unsupervised không có đáp án nên cũng không có thước đo đúng sai khách quan. Với model gian lận, "đúng" là khớp nhãn thật, đo được như so expected trong một test: pass hay fail rõ ràng. Với gom nhóm khách hàng thì chẳng có expected nào để so. Nhóm tìm ra "đúng" hay không là một câu hỏi mở, chỉ trả lời được bằng heuristic hoặc bằng đánh giá của người hiểu nghiệp vụ.
5. Bảng so sánh theo tín hiệu dạy
| Trục | Supervised | Unsupervised | Reinforcement |
|---|---|---|---|
| Tín hiệu dạy | Đáp án đúng cho từng mẫu | Không có nhãn, chỉ có cấu trúc trong dữ liệu | Điểm thưởng chấm kết quả, thường thưa và trễ |
| Ví dụ fintech | Phân loại giao dịch gian lận | Chia nhóm khách hàng theo hành vi | Chính sách gửi nhắc nợ |
| Chi phí chính | Gắn nhãn: chờ sự kiện thật + người xác nhận | Thu thập dữ liệu: rẻ hơn, không chờ nhãn | Thiết kế điểm thưởng + đủ số chuỗi để thử |
| Đánh giá kết quả | Đối chiếu nhãn thật: khách quan, đo được | Không có đáp án: câu hỏi mở, cần heuristic hoặc domain review | So tổng điểm thưởng; thưởng thưa thì khó tách công từng bước |
6. Pitfall tổng hợp
❌ Nhầm 1: nghĩ reinforcement "khó nhất" nên hiếm khi là lựa chọn đúng.
✅ Ranh giới giữa ba kiểu học nằm ở loại phản hồi có sẵn, không ở độ khó thuật toán. Nhắc nợ chỉ có điểm chấm cuối chuỗi, không có đáp án cho từng lần gửi, nên nó là bài toán reinforcement dù khó hay dễ.
❌ Nhầm 2: nghĩ unsupervised "kém tin cậy" nên tránh dùng khi có thể.
✅ Đây là đánh đổi, không phải thứ hạng. Unsupervised rẻ hơn để bắt đầu nhưng đắt hơn để đánh giá. Chọn theo bài toán có nhãn sẵn hay không, không theo cảm giác cái nào chắc hơn.
❌ Nhầm 3: coi reinforcement là supervised với nhãn đến muộn.
✅ Nhãn supervised nói thẳng đáp án cho từng mẫu. Điểm thưởng reinforcement chỉ chấm tốt hay xấu, không nói đáng lẽ phải làm gì, và có thể đến thưa. Khác biệt là loại phản hồi, không phải tốc độ nhận.
7. Đào sâu
Tài liệu chính chủ:
- OpenAI Spinning Up, Part 1: Key Concepts in RL: agent học bằng thử sai khi tương tác với môi trường, nhận reward dạng số ở mỗi bước, không có nhãn hành động đúng cho bước nào. Khớp mục 3.3.
- scikit-learn, Clustering: clustering chạy trên dữ liệu không nhãn, và đánh giá nó không đơn giản như đếm lỗi hay đo precision/recall của bài toán supervised. Khớp mục 4.
8. Liên hệ các bài khác
- Bài 01: Khi nào cần học từ dữ liệu, khi nào if-else vẫn thắng: câu hỏi "có cần học không" đứng trước câu hỏi của bài này.
- Bài 03: Dữ liệu, nhãn và chia tập đi tiếp chuyện "nhãn đến từ đâu, tốn kém ra sao" mới mở ở mục 4.
- Bài 06: LLM trên bản đồ: LLM dùng nhiều kiểu học ở các giai đoạn khác nhau, nên ba định nghĩa ở đây là điều kiện để đọc bài đó.
- Mini-challenge: đọc mô tả một hệ AI: luyện đọc mô tả hệ thống và xác định nó học theo kiểu nào.
9. Tóm tắt
- Nhãn gian lận chỉ đáng tin sau khiếu nại và chargeback, tính bằng tháng: đó là chi phí thật của supervised.
- Không có
expectedđể so thì kết quả gom nhóm không có con số "độ chính xác", chỉ có heuristic và người hiểu nghiệp vụ. - Điểm thưởng thưa sinh ra bài toán chia công: biết cả chuỗi tốt hay xấu, không biết bước nào góp phần.
- Chọn kiểu học theo loại phản hồi bài toán có sẵn, không theo độ khó hay độ phổ biến của thuật toán.
10. Tự kiểm tra
- Q1Hệ thống chấm điểm tín dụng dùng lịch sử vay đã biết ai trả đúng hạn, ai không, để dự đoán khách mới. Đây là kiểu học nào, và vì sao?
- Q2Vì sao một hệ unsupervised chia nhóm khách hàng không thể tự báo cáo một con số 'độ chính xác' như model supervised?
- Q3Vì sao gắn nhãn thường là phần tốn kém nhất của một dự án supervised, tốn hơn cả việc chọn thuật toán?
- Q4Hệ thống nhắc nợ chỉ biết 'khách có trả tiền hay không' sau cả chuỗi vài lần nhắc. Vì sao không thể coi đơn giản là supervised với nhãn đến muộn?
- Q5Một đồng nghiệp đề xuất dùng unsupervised để tự động phát hiện gian lận, lý do là 'không tốn công gắn nhãn'. Bạn phản biện điểm nào?
Bài tiếp theo: Dữ liệu, nhãn và ba tập không được trộn
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Khi nào cần học từ dữ liệu, khi nào if-else vẫn thắng
Bài tiếpDữ liệu, nhãn và ba tập không được trộn
Thảo luận & góp ý
Hỏi đáp về bài này