Tổng quan: Bản đồ AI & học từ dữ liệu
Bản đồ module: từ câu hỏi 'bài toán này có cần AI không' tới chỗ LLM đứng trên bản đồ. Không cần nền toán hay ML, chỉ cần đã biết code.
TL;DR: Module này trả lời câu hỏi đứng trước mọi câu hỏi khác về AI: bài toán này có thật sự cần học từ dữ liệu không, hay if-else viết tay vẫn thắng? Nếu cần, model học theo kiểu phản hồi nào: nhãn có sẵn, cấu trúc trong dữ liệu, hay điểm thưởng chỉ chấm chứ không chỉ đáp án. Nhãn và cách chia dữ liệu quyết định hành vi thật của model. Module tách bạch lúc model còn học (train) với lúc chỉ chạy (inference), dạy cách đọc ba con số train/validation/production để bắt overfitting và data leakage, rồi đặt LLM lên bản đồ AI ⊃ machine learning ⊃ deep learning ⊃ generative AI. Module không dạy xây model; nó dạy đọc đúng tài liệu AI mà không lạc thuật ngữ.
Vì sao module này tồn tại
Bạn là kỹ sư phần mềm, biết code, chưa từng học máy. Sếp giao một ticket: "thêm AI vào tính năng X." Trước khi viết được dòng nào liên quan tới AI, có cả một lớp câu hỏi phải trả lời trước. Bài toán này có thật sự cần học từ dữ liệu không, hay nó chỉ là if-else viết chưa xong? Nếu cần, model học theo cách nào trong ba cách khác hẳn nhau? Dữ liệu và nhãn nó dùng có đáng tin không? Con số đo đẹp trên máy bạn có còn đúng khi chạy thật? Và khi đồng nghiệp nhắc tới GPT hay Claude, nó khác gì một model chấm điểm rủi ro tín dụng?
Không câu nào trong số đó cần bạn hiểu lan truyền ngược hay kiến trúc transformer. Vì vậy module này là bản đồ, không phải bản vẽ kỹ thuật. Mạng nơ-ron học ra sao thuộc module Não nhân tạo vừa đủ; cỗ máy bên trong LLM (tokenization, attention, sinh văn bản) thuộc module Cỗ máy LLM. Ở đây bạn chỉ cần biết lúc nào phải đi sâu vào những module đó, và khi một tài liệu nhắc tới train, nhãn, overfitting hay LLM thì nó đang nói về cái gì.
Sau module này bạn sẽ
- Lập luận được khi nào một bài toán thật sự cần học từ dữ liệu, và khi nào rule-based vẫn là lựa chọn đúng, thay vì phản xạ "cứ có dữ liệu là dùng AI"
- Phân biệt được ba kiểu học qua loại phản hồi model nhận để biết mình đúng hay sai, và đặt được LLM lên bản đồ AI/machine learning/deep learning/generative AI
- Giải thích được vì sao dữ liệu, nhãn và cách chia train/validation/test quyết định hành vi thật của model
- So sánh được hai pha train và inference theo chi phí, độ trễ, và thứ gì thay đổi được ở mỗi pha
- Chẩn đoán được overfitting và data leakage từ mô tả một hệ đo đẹp offline nhưng hỏng khi chạy thật
Lộ trình module
Tám bài chia thành ba khối. Ba bài đầu dựng nền. Bài 01 trả lời "có cần học từ dữ liệu không" bằng ba câu hỏi quyết định. Bài 02 tách "học từ dữ liệu" thành ba kiểu khác hẳn nhau: supervised, unsupervised, reinforcement. Bài 03 đi tiếp vào nhãn: nhãn là gì, vì sao nhãn sai không công cụ nào bắt được, và vì sao phải tách train/validation/test trước khi đụng vào dữ liệu.
Hai bài giữa đi qua vòng đời một model đã có. Bài 04 tách hẳn train (trọng số còn đổi) với inference (trọng số đóng băng), và giải thích luôn vì sao chatbot "nhớ" bạn dù không trọng số nào bị sửa. Bài 05 dùng bộ ba con số train/validation/production để chẩn đoán overfitting và data leakage, hai lý do phổ biến nhất khiến demo đẹp mà production hỏng.
Bài 06 đưa mọi thứ lên bản đồ lớn hơn: AI ⊃ machine learning ⊃ deep learning ⊃ generative AI, LLM ở ô trong cùng. Bài này cũng cho thấy pretraining một LLM vẫn học bằng cách so với đáp án, chỉ là đáp án lấy từ chính văn bản. Bài 07 là mini-challenge: ba ticket nghe giống hệt nhau "cần AI", bạn tự phân loại và chẩn đoán lỗi đo trước khi đọc lời giải. Bài 08 gom lại thành cheat sheet và tự đánh giá theo năm outcome ở trên.
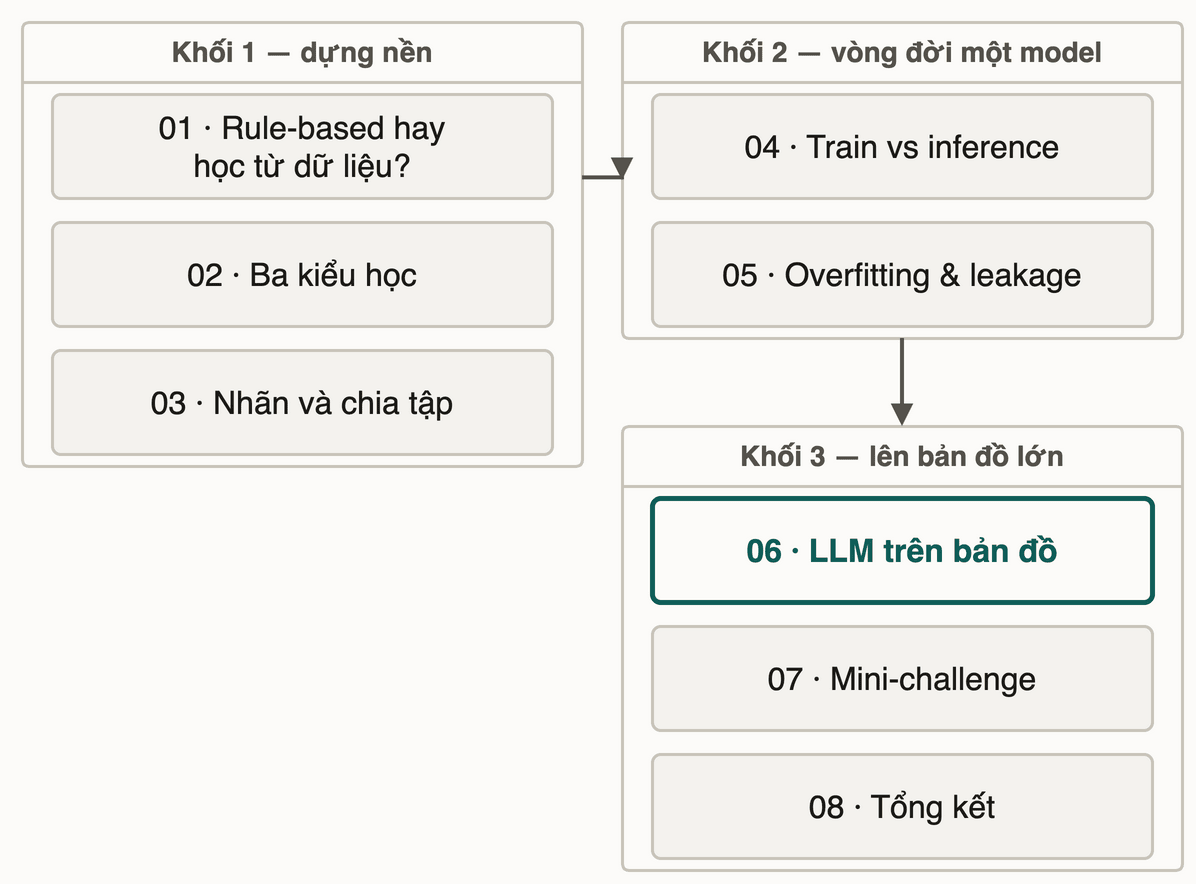
Đọc theo đúng thứ tự: 01 · Khi nào cần học từ dữ liệu, 02 · Ba kiểu học, 03 · Dữ liệu, nhãn và chia tập, 04 · Train vs inference, 05 · Overfitting & data leakage, 06 · LLM trên bản đồ, 07 · Mini-challenge: đọc mô tả hệ AI.
Yêu cầu trước khi bắt đầu
- Không cần nền toán hay ML. Đọc được if-else, hàm, vòng lặp là đủ để theo hết module.
- Không cần cài công cụ gì. Cả module chỉ dùng pseudocode để minh hoạ cơ chế, không có bài lab chạy code.
- Đây là module mở đầu của khoá, không có module nào phải đọc trước.
Time budget
| Bài | Nội dung | Thời gian |
|---|---|---|
| 01 | Khi nào cần học từ dữ liệu, khi nào if-else vẫn thắng | 13 phút |
| 02 | Ba kiểu học | 12 phút |
| 03 | Dữ liệu, nhãn và ba tập không được trộn | 13 phút |
| 04 | Train vs inference | 13 phút |
| 05 | Overfitting & data leakage | 12 phút |
| 06 | LLM trên bản đồ | 12 phút |
| 07 | Mini-challenge: đọc ba mô tả hệ thống | 15 phút |
| 08 | Tổng kết module | ~7 phút |
Tổng khoảng 1h40.
Cách học module này hiệu quả
- Đừng nhảy cóc: bài 03 dùng lại câu hỏi "đủ ví dụ chưa" của bài 01, bài 06 cần cả bài 02 (ba kiểu học) lẫn bài 04 (train/inference). Đọc lệch thứ tự thì phần lớn chữ "vì sao" trong bài sẽ trống.
- Gặp callout "Thử đoán" thì viết dự đoán ra trước khi đọc tiếp. Bài 03, 05, 06 đều dùng mẫu này, và phần giải thích ngay sau chỉ có tác dụng khi bạn đã tự đoán.
- Ở bài 07, viết hẳn câu trả lời cho cả ba scenario rồi mới cuộn xuống lời giải. Mini-challenge chấm bằng lập luận, không có một đáp án đúng tuyệt đối.
- Gặp khái niệm nghe quen quen (nhãn, train, kiểu học), mở khối
Recalltrong bài thay vì đoán. Vài dòng ôn thường quyết định bạn hiểu đúng hay hiểu lệch phần còn lại.
Bài tiếp theo: Khi nào cần học từ dữ liệu, khi nào if-else vẫn thắng
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này