Khi nào cần học từ dữ liệu, khi nào if-else vẫn thắng
Machine learning không phải bản nâng cấp của code thường: nó đổi việc viết luật lấy chi phí dữ liệu, và có cả một lớp bài toán rule-based vẫn thắng.
TL;DR: Machine learning (học máy) không phải bản nâng cấp của code thường. Nó là một cách khác để giải bài toán: thay vì viết luật, bạn đưa cho model training data (dữ liệu huấn luyện) đã có sẵn đáp án đúng để nó tự rút ra pattern. Cái giá là model thành hộp đen thống kê, khó giải thích từng quyết định. Rule-based thắng khi luật viết ra được, đứng yên và cần audit trail; học từ dữ liệu thắng khi luật ngầm, nhiều ngoại lệ, trôi theo thời gian. Hệ quả lớn nhất với engineer: bug giờ có thể nằm trong tập huấn luyện chứ không nằm trong code, và code review không bắt được nó.
Một đội backend ở fintech nhận nhiệm vụ phát hiện giao dịch thẻ bất thường trước khi tiền rời tài khoản. Cách làm quen tay là viết luật. Giao dịch trên 50 triệu thì gắn cờ; nửa đêm mà số tiền kha khá thì gắn cờ; quẹt ở quốc gia lạ so với thói quen chủ thẻ thì gắn cờ. Tuần đầu, 8 luật đã bắt được phần lớn ca gian lận lộ liễu.
Sáu tháng sau, con số đó là 200 luật chồng chéo. Luật mới vá từng ca lọt lưới, luật cũ không ai dám xoá vì không rõ nó đang che ca nào. Team không làm ẩu. Đây là triệu chứng của một lớp bài toán mà luật viết tay không bao giờ liệt kê hết được.
1. Analogy: bảo vệ mới vào nghề và thẩm định viên kỳ cựu
Nhân viên bảo vệ mới vào nghề được phát một checklist: túi to hơn cỡ X thì kiểm tra, khách đi một mình sau 11 giờ đêm thì hỏi giấy tờ. Checklist chạy tốt khi người viết đã lường trước gần hết tình huống.
Người thẩm định gian lận 15 năm thì không tra checklist nào. Họ nhìn một hồ sơ và thấy "có gì đó không ổn" dù hồ sơ không khớp quy tắc nào từng viết ra. Trực giác ấy đến từ hàng chục nghìn hồ sơ thật đã qua tay, hồ sơ nào cũng biết kết cục. Chẳng ai lập trình cho họ luật "nếu X thì gian lận"; họ tự rút ra pattern từ ví dụ.
| Đời thường | Machine learning |
|---|---|
| Checklist viết sẵn cho bảo vệ mới | Rule-based: luật do người viết tay, tường minh |
| Trực giác của thẩm định viên kỳ cựu | Model học pattern từ training data, tập ví dụ đã biết đáp án |
| Checklist đọc, sửa được từng dòng | Trực giác không tách được thành từng luật để đọc |
| Bảo vệ mới bó tay trước tình huống lạ | Thẩm định viên vẫn nhận ra ca lạ nhờ pattern đã học |
Checklist là luật viết tay: đọc được, sửa được, nhưng chỉ giỏi việc đã lường trước. Trực giác kỳ cựu là pattern học từ ví dụ: bắt được ca lạ, nhưng không đọc ra được "vì sao" như checklist.
2. Vì sao học từ dữ liệu là đánh đổi chứ không phải nâng cấp?
Dễ nghĩ machine learning là "code thông minh hơn", bản nâng cấp của if-else. Cách nghĩ đó sai từ gốc: rule-based và học từ dữ liệu là hai cách khác nhau để tạo ra hành vi cho chương trình, và chọn cái nào là một đánh đổi chứ không phải leo bậc thang.
Với rule-based, kỹ sư quan sát bài toán, rút ra luật, rồi gõ thành code:
function la_giao_dich_dang_ngo(giao_dich, tai_khoan):
    if giao_dich.so_tien > 50_000_000: return true            -- luật 1: tiền lớn
    if gio_dem(giao_dich.gio) and giao_dich.so_tien > 5_000_000:
        return true                                            -- luật 2: khuya + tiền khá
    if giao_dich.quoc_gia != tai_khoan.quoc_gia_thuong_dung:
        return true                                            -- luật 3: quốc gia lạ
    -- ... còn 197 luật nữa, mỗi luật vá một ca thật từng lọt lưới
    return false
Mỗi dòng luật là một quyết định con người đọc, giải thích, sửa được. Điểm mạnh thật của rule-based là minh bạch, nhưng minh bạch chỉ giữ được khi số luật còn nhỏ. Đến 200 luật chồng chéo không ai dám xoá thì chẳng còn gì minh bạch nữa.
Với học từ dữ liệu, kỹ sư thôi viết luật "gian lận là gì". Họ đưa model hàng chục nghìn giao dịch cũ đã gắn nhãn gian lận hay hợp lệ, để model tự tìm pattern phân biệt hai nhóm. Model suy ra luật từ ví dụ, và không dòng nào đọc được thành "nếu X thì Y" như code viết tay.
Cái giá nằm ở đó: bạn đổi luật minh bạch lấy một hộp đen thống kê. Nó đúng trên phân bố dữ liệu đã thấy, nhưng không ai chỉ ra được "quyết định này tới từ đâu" theo cách đọc một dòng if-else.
3. Ba câu hỏi nào quyết định có nên học từ dữ liệu?
Áp ba câu hỏi này vào bài toán gian lận thẻ ở đầu bài:
(a) Luật có viết ra được và đứng yên không? Không. Kẻ gian đổi chiêu liên tục, chiêu mới ra đời ngay khi chiêu cũ bị chặn. Chiêu phổ biến hôm nay có thể khác hẳn sáu tháng nữa, nên tập luật viết tay nào cũng sẽ lỗi thời, còn model thì học lại được khi có dữ liệu mới. Đây là câu duy nhất có thể đẩy thẳng bài toán về rule-based.
(b) Có đủ ví dụ đã biết đáp án không? Có. Hệ thống lâu năm đã tích luỹ hàng chục nghìn giao dịch được xác nhận gian lận hay hợp lệ qua khiếu nại, hoàn tiền, xác minh thủ công. Nếu câu trả lời là "chưa", bạn vẫn chưa thể học: chạy heuristic viết tay trước, vừa chạy vừa gom nhãn.
(c) Mỗi quyết định có phải truy về đúng một điều khoản không? Chỉ ở mức vừa phải. Khi khách khiếu nại cần giải thích được vì sao giao dịch bị chặn, nhưng không ai đòi truy từng quyết định về một điều khoản như khi tính lãi suất. Nếu có vài ca bắt buộc như vậy, đội thường xây hệ lai: model ra quyết định chính, cộng vài luật cứng cho đúng những ca đó.
Kết luận không phải "học từ dữ liệu luôn thắng". Chỉ câu (a) có quyền trả bài toán về rule-based; hai câu còn lại quyết định bạn học ngay, học sau, hay học kèm luật cứng.
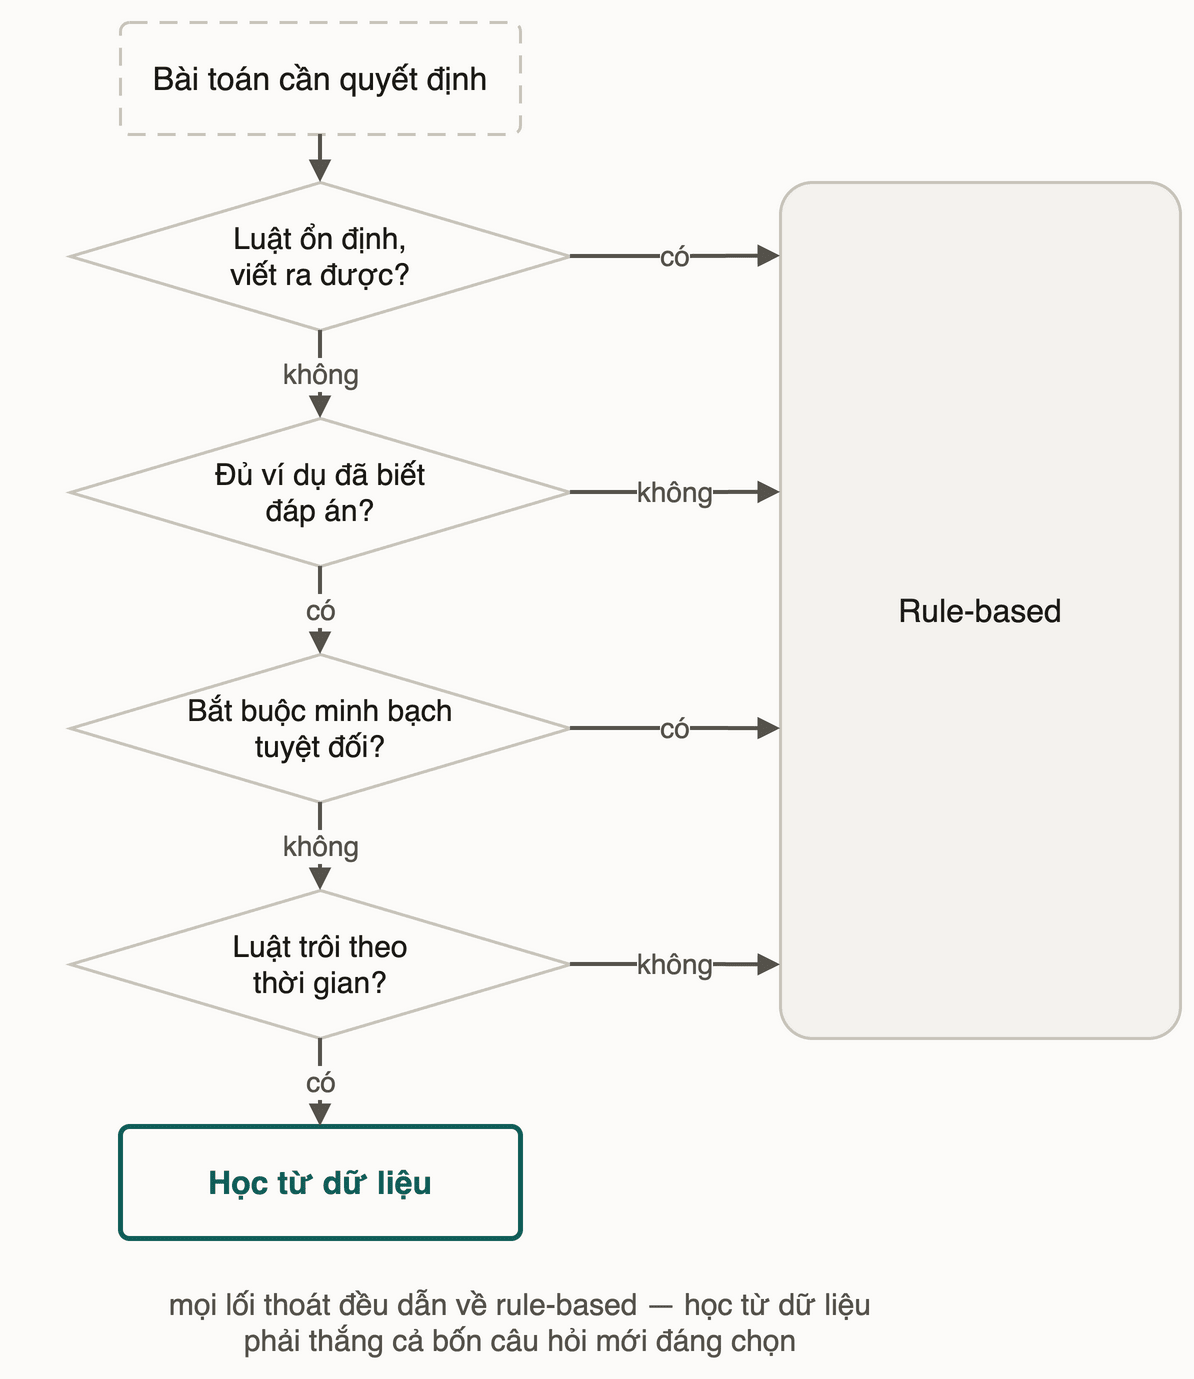
4. Bảng quyết định
| Tình huống | Nên dùng | Vì sao |
|---|---|---|
| Tính lãi suất, hạn mức vay, biểu phí, thuế | Rule-based | Luật do pháp luật/hợp đồng quy định sẵn, phải khớp chính xác điều khoản |
| Cần audit trail truy từng quyết định về đúng một điều khoản | Rule-based hoặc hệ lai | Model không tách được quyết định thành một điều khoản cụ thể |
| Dữ liệu lịch sử ít, chưa đủ ví dụ đáng tin | Heuristic tay, gom nhãn | Model học từ vài trăm ví dụ dễ nhầm nhiễu thành pattern |
| Lọc spam, phát hiện gian lận, gợi ý nội dung | Học từ dữ liệu | Luật ngầm, nhiều ngoại lệ, đối thủ đổi chiêu liên tục |
| Thế nào là "đúng" trôi theo thời gian hoặc theo hành vi người dùng | Học từ dữ liệu | Luật viết tay phải sửa mỗi lần lỗi thời; model học lại được khi có dữ liệu mới |
5. Luật không biến mất, nó chuyển nhà
Đây là chỗ dễ nghĩ sai nhất khi mới đụng tới machine learning: học từ dữ liệu không xoá luật đi, nó dời luật từ code sang dữ liệu.
Với rule-based, "luật" nằm tường minh trong code. Với học từ dữ liệu, "luật" nằm ẩn trong tập ví dụ đã gắn nhãn. Giả sử đa số ca "gian lận" trong tập đó tình cờ rơi vào cuối tuần, thuần tuý vì lịch làm việc của đội xác minh thủ công. Model sẽ học ra một luật ngầm sai: cuối tuần đáng ngờ hơn. Không ai viết luật đó; nó tự sinh ra từ cách dữ liệu được thu thập.
Hệ quả với engineer: bug giờ có thể nằm trong tập huấn luyện chứ không nằm trong code. Đọc lại mấy dòng gọi model không tìm ra gì, vì code không sai. Code review cũng không bắt được, vì reviewer đọc diff code chứ đâu đọc hàng chục nghìn dòng dữ liệu. Câu hỏi debug đúng lúc này là: dữ liệu huấn luyện có đại diện đúng thực tế không? Đó là một kỹ năng khác hẳn đọc code.
Thử ngẫmnếu phần lớn hồ sơ "đáng ngờ" trong dữ liệu huấn luyện tình cờ đều nộp vào cuối tuần, model học ra điều gì, và đọc lại code chấm điểm rủi ro có phát hiện ra không?
6. Pitfall tổng hợp
❌ Nhầm 1: coi machine learning là "code thông minh hơn if-else". ✅ Đó là một cách giải bài toán khác hẳn, đổi minh bạch lấy khả năng bắt pattern ngầm. Không hướng nào cao cấp hơn tuyệt đối.
❌ Nhầm 2: nghĩ rule-based lạc hậu, có dữ liệu là nên chuyển sang học. ✅ Bài toán mà luật do pháp luật/hợp đồng quy định hoặc cần audit trail tuyệt đối vẫn nên giữ rule-based, dù dữ liệu lịch sử nhiều cỡ nào.
❌ Nhầm 3: nghĩ bug trong hệ học từ dữ liệu vẫn nằm ở code như cũ. ✅ Bug có thể nằm trong tập huấn luyện: cách dữ liệu được thu thập, gắn nhãn, hoặc lệch so với thực tế. Đọc code không tìm ra.
7. Đào sâu
Tài liệu chính chủ:
- Google, Rules of Machine Learning, Rule #1 (Martin Zinkevich): đừng ngại ship sản phẩm chưa có machine learning, vì heuristic viết tay thường đạt khoảng nửa hiệu quả của một hệ học từ dữ liệu. Khớp với lối "heuristic tay, gom nhãn dần" ở mục 3.
- Sculley et al., "Hidden Technical Debt in Machine Learning Systems" (NeurIPS 2015): hệ học từ dữ liệu gánh nợ kỹ thuật của phần mềm thường, cộng thêm rủi ro riêng như entanglement và hidden feedback loop. Đây là cơ sở cho luận điểm "bug dời từ code sang dữ liệu" ở mục 5.
8. Liên hệ các bài khác
- Bài 02: Ba kiểu học tách "học từ dữ liệu" ở bài này thành ba kiểu phản hồi khác nhau.
- Bài 03: Dữ liệu, nhãn và cách chia tập đi tiếp câu hỏi (b): không chỉ đủ ví dụ, nhãn còn phải đúng và tập phải chia đúng.
- Bài 05: Overfitting là hệ quả xa hơn của "luật nằm trong dữ liệu": tập huấn luyện có vấn đề thì model học vẹt thay vì học đúng pattern.
- Bài 06: LLM trên bản đồ: LLM là trường hợp cực đoan của học từ dữ liệu, huấn luyện trên lượng văn bản khổng lồ.
- Mini-challenge: đọc mô tả một hệ AI áp thẳng ba câu hỏi quyết định vào hệ thống mô tả bằng lời.
9. Tóm tắt
- Chỉ câu "luật có viết ra được và đứng yên không" mới đẩy thẳng bài toán về rule-based; thiếu nhãn hay cần truy điều khoản chỉ đổi cách làm.
- 200 luật chồng chéo không ai dám xoá là triệu chứng, không phải lỗi của team: luật ngầm không liệt kê hết được.
- Chọn học từ dữ liệu là chấp nhận hộp đen thống kê; cần giải thích từng quyết định thì tính tới hệ lai.
- Tập huấn luyện lệch sinh ra luật ngầm sai (ví dụ "cuối tuần đáng ngờ") mà không dòng code nào chứa nó.
10. Tự kiểm tra
- Q1Vì sao gọi machine learning là 'đánh đổi' thay vì 'nâng cấp' so với rule-based lại chính xác hơn?
- Q2Trong bài toán gian lận thẻ, câu hỏi (c) về việc truy quyết định về điều khoản chỉ ở mức vừa phải. Vì sao nó không chặn việc chuyển sang học từ dữ liệu, và nó gợi ý thiết kế gì?
- Q3Một fintech khác định dùng model học từ dữ liệu để tự động tính phí phạt trả chậm theo hợp đồng vay. Bạn khuyên gì?
- Q4Vì sao câu 'model này đang phân biệt đối xử một nhóm khách hàng' có thể đúng dù không dòng code nào nhắc tới nhóm đó?
- Q5Vì sao 200 luật if-else chồng chéo (hook đầu bài) là dấu hiệu nên cân nhắc học từ dữ liệu, còn 10 luật tính biểu phí rõ ràng thì không?
Bài tiếp theo: Ba kiểu học: model biết mình đúng sai nhờ đâu
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng quan: Bản đồ AI & học từ dữ liệu
Bài tiếpBa kiểu học: phân biệt bằng tín hiệu dạy model
Thảo luận & góp ý
Hỏi đáp về bài này