Gradient descent: vòng lặp chỉnh trọng số cho bớt sai
Huấn luyện là vòng lặp forward, tính loss, lấy gradient rồi chỉnh trọng số ngược hướng dốc. Learning rate quyết định mỗi bước đi xa bao nhiêu.
TL;DR: Huấn luyện là một vòng lặp bốn bước chạy đi chạy lại: cho dữ liệu qua model để ra dự đoán (forward), tính loss để đo cái sai, tính gradient (mỗi trọng số nên chỉnh theo hướng nào để loss giảm), rồi cập nhật w = w - lr * gradient. Batch là một nhúm mẫu dùng cho một bước; epoch là một lượt đi hết tập train. Learning rate là siêu tham số quyết định mỗi bước dài bao nhiêu, chọn trước khi train. Train xong, trọng số đóng băng và model chuyển sang inference. Đường cong loss theo epoch là công cụ chính để biết vòng lặp có đang chạy đúng không.
Bài 03 đã cho bạn loss: một con số đo tổng sai lệch của model. Mục tiêu của train là làm con số đó nhỏ lại.
Nhưng bằng cách nào? Model có thể có hàng triệu trọng số, mỗi trọng số là một "núm vặn". Vặn nhầm núm thì loss tăng thay vì giảm. Vặn đúng núm nhưng quá tay thì lố qua đáy, sang sườn bên kia, có khi còn cao hơn chỗ xuất phát. Câu hỏi thật là: chỉnh núm nào, theo hướng nào, mỗi lần bao nhiêu?
Trả lời câu hỏi đó là toàn bộ công việc của "train", và thuật toán làm việc này tên là gradient descent.
Loss là một con số tóm tắt tổng sai lệch của model trên một batch dữ liệu. Gradient descent dùng con số này làm la bàn: mỗi bước cập nhật trọng số đều nhằm làm loss nhỏ đi.
Train là pha model còn chỉnh trọng số, tốn kém về tính toán. Inference là pha trọng số đã đóng băng; model chỉ chạy forward để dự đoán. Gradient descent thuộc hoàn toàn về pha train.
1. Xuống núi trong sương mù
Hình dung bạn đứng giữa vùng đồi núi, sương mù dày đặc. Mục tiêu là xuống thung lũng thấp nhất, nhưng bạn không thấy toàn cảnh, chỉ cảm được độ dốc ngay dưới bàn chân. Chiến lược hợp lý: bước ngược chiều dốc, từng bước một. Không cần biết thung lũng ở đâu; gradient descent làm y hệt vậy.
| Xuống núi trong sương mù | Gradient descent |
|---|---|
| Vùng đồi núi | Không gian trọng số của model |
| Độ cao tại mỗi điểm | Giá trị loss |
| Thung lũng thấp nhất | Loss nhỏ nhất, mục tiêu của train |
| Độ dốc dưới bàn chân | Gradient theo từng trọng số |
| Một bước đi | Một lần cập nhật trọng số |
| Độ dài bước chân | Learning rate |
Gradient là "độ dốc dưới chân" theo từng trọng số. Cập nhật là bước ngược chiều dốc. Learning rate là độ dài mỗi bước.
2. Bốn bước của vòng lặp huấn luyện là gì?
Mỗi lần cập nhật trọng số đi qua đúng bốn bước, rồi quay lại bước đầu với batch tiếp theo:
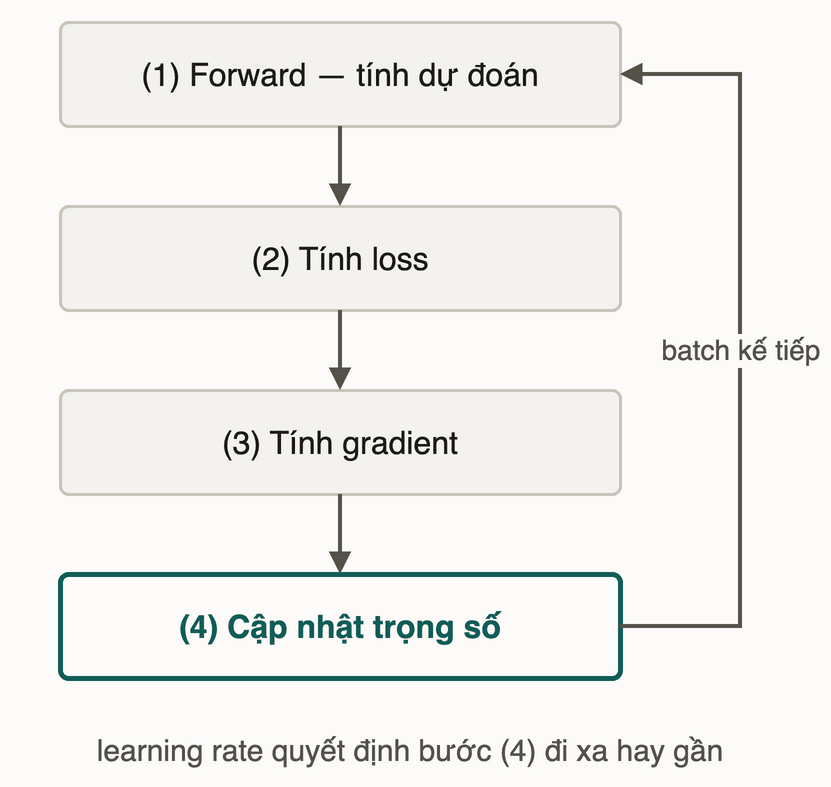
Bước 1, forward pass: cho một nhúm dữ liệu (batch) đi qua mạng từ lớp vào tới lớp ra, ra dự đoán của model. Đây là bước duy nhất trong bốn bước còn xuất hiện ở inference.
Bước 2, tính loss: so dự đoán với nhãn đúng bằng hàm loss đã chọn, ra một con số.
Bước 3, tính gradient: với mỗi trọng số, tính xem "tăng trọng số này một chút thì loss tăng hay giảm, bao nhiêu". Con số đó là gradient của trọng số.
Backpropagation là kỹ thuật tính gradient cho mọi trọng số trong một lượt đi ngược qua mạng, rẻ hơn nhiều so với tính riêng từng trọng số. Framework làm việc này cho bạn; chi tiết nằm ngoài phạm vi khoá.
Bước 4, cập nhật trọng số: áp công thức sau cho từng trọng số:
w <- w - lr * gradient(w)
Trọng số mới bằng trọng số cũ trừ đi learning rate nhân gradient. Vì đi ngược gradient (trừ, không cộng), loss có xu hướng giảm sau mỗi bước, miễn là learning rate hợp lý (mục 4). "Xuống dốc" nghĩa là vậy. Bốn bước lặp lại trên từng batch cho tới khi loss không còn giảm đáng kể.
3. Batch và epoch: vì sao không dùng cả tập mỗi bước?
Tập dữ liệu có hàng triệu mẫu thì tính gradient trên cả tập cho mỗi bước nghĩa là đọc và xử lý hàng triệu mẫu mới chỉnh được một lần, tốn kém vô ích. Gradient tính trên một nhúm nhỏ chọn ngẫu nhiên (batch) vẫn đủ chỉ đúng hướng xuống dốc, dù nhiễu hơn, và cho phép cập nhật nhiều lần trong một epoch thay vì một lần.
Hai khái niệm cần nắm trước khi đọc pseudocode. Batch là tập con mẫu dùng trong một bước cập nhật; số bước mỗi epoch bằng kích thước tập train chia kích thước batch. Epoch là một lượt đi hết tập huấn luyện, sau đó model đã thấy mỗi mẫu đúng một lần. Model nhỏ trên dữ liệu vừa phải thường chạy hàng chục tới hàng trăm epoch; LLM thì ngược lại, dữ liệu lớn tới mức pretraining thường chỉ đi qua phần lớn văn bản khoảng một lượt.
for epoch in 1..N_EPOCHS:
    shuffle(train_data)
    for batch in split(train_data, batch_size):
        preds = forward(model, batch.inputs)         // bước 1: chạy model
        loss  = compute_loss(preds, batch.labels)    // bước 2: đo cái sai
        grads = backprop(model, loss)                // bước 3: gradient theo từng trọng số
        update_weights(model, grads, lr)             // bước 4: w = w - lr * g
    val_loss = evaluate(model, validation_data)
    log("epoch", epoch, "val_loss", val_loss)        // ghi lại để vẽ đường cong loss
(shuffle ở đây là xáo thứ tự mẫu bên trong tập train giữa các epoch, không liên quan gì tới việc chia tập ở module 1.)
4. Learning rate quyết định mỗi bước dài ngắn thế nào?
Learning rate (lr) là một hằng số nhỏ bạn chọn trước khi train. Nó quyết định mỗi bước cập nhật đi xa bao nhiêu theo hướng gradient chỉ. Giá trị hay dùng nằm trong khoảng 0.0001 tới 0.1, tuỳ bài toán và thuật toán tối ưu.
Model đang train ổn, loss giảm đều qua từng epoch. Bạn tăng learning rate lên gấp 100 lần. Đường cong loss ở các epoch tiếp theo sẽ trông thế nào? Viết dự đoán ra rồi mới đọc tiếp.
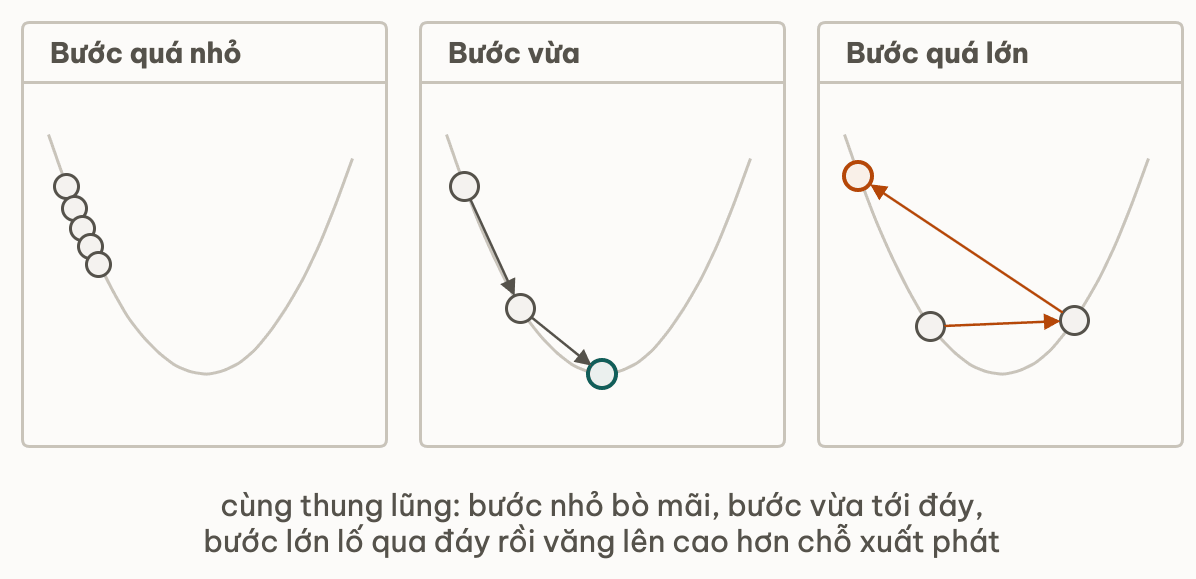
Learning rate quá lớn: mỗi bước chỉnh quá mạnh, nhảy lố qua đáy sang sườn bên kia, có khi lên cao hơn chỗ xuất phát. Loss dao động mạnh giữa các epoch, hoặc tăng vọt dần, đôi khi thành NaN. Vòng lặp vẫn chạy bình thường, không báo lỗi gì, nhưng model không hội tụ.
Learning rate quá nhỏ: mỗi bước chỉnh cực nhỏ. Loss vẫn giảm nhưng chậm tới mức trông như đứng yên, sau hàng trăm epoch vẫn còn cao. Tốn nhiều tính toán mà gần như không thu được gì.
Learning rate vừa: loss giảm khá nhanh ở những epoch đầu rồi phẳng dần khi model tới gần đáy. Đó là hình dạng bạn muốn thấy.
5. Đọc đường cong loss như thế nào?
Đường cong loss (learning curve) là biểu đồ đơn giản: trục ngang là epoch, trục dọc là giá trị loss. Nó là công cụ chính khi train, không phải để ngắm mà để chẩn đoán vòng lặp có đang khoẻ không.
Người ta thường vẽ hai đường trên cùng một biểu đồ: training loss tính trên dữ liệu model đang học, và validation loss tính trên tập không dùng để train, đo cuối mỗi epoch. Đường cong khoẻ trông như sau: cả hai giảm khá nhanh rồi phẳng dần, validation bám sát training.
Bài này chỉ bàn hai triệu chứng của learning rate sai. Quá lớn: loss dao động mạnh giữa các epoch hoặc tăng vọt, hai đường không hội tụ về đâu. Quá nhỏ: cả hai đường giảm rất chậm và đều, nhìn gần như nằm ngang dù chưa tới đáy.
Hai kiểu hỏng còn lại, model thiếu sức chứa (underfit) và model thuộc lòng tập train (overfit), có hình dạng khác. Bạn sẽ tự chẩn đoán cả ba ở bài mini-challenge.
Thử ngẫmbác sĩ đọc biểu đồ nhịp tim thay vì chỉ hỏi bệnh nhân "thấy sao rồi". Đường cong loss cho bạn biết điều gì mà câu hỏi "model học tốt không" không trả lời được?
6. Ba hiểu lầm phổ biến
❌ Nhầm 1: "Train là nạp dữ liệu vào và model tự nhớ."
✅ Model điều chỉnh trọng số qua rất nhiều bước gradient descent. Train xong, thứ còn lại là bộ trọng số chứ không phải một bản sao dữ liệu, dù model lớn vẫn có thể thuộc một số đoạn lặp lại nhiều lần (bài 01).
❌ Nhầm 2: "Loss không giảm thì chắc tại learning rate" (hoặc "chắc tại dữ liệu xấu").
✅ Kiểm theo thứ tự rẻ nhất trước. Đầu tiên, soát pipeline: nhãn có khớp đúng mẫu không, dữ liệu có được chuẩn hoá không, hàm loss có đúng loại bài toán không. Lỗi dữ liệu và bug pipeline là nguyên nhân rất hay gặp. Một phép thử nhanh là cho model train trên một batch nhỏ duy nhất: loss không về gần 0 thì bug nằm ở code hay dữ liệu, không phải ở learning rate. Qua được phép thử đó rồi mới dò learning rate, và dấu hiệu của nó rất đặc trưng: dao động hoặc tăng vọt là quá lớn, giảm rất chậm là quá nhỏ.
❌ Nhầm 3: "Mỗi bước cập nhật nhìn hết toàn bộ dữ liệu."
✅ Mỗi bước chỉ dùng một batch, thường vài chục tới vài trăm mẫu (LLM dùng batch lớn hơn nhiều). Toàn bộ dữ liệu được quét hết sau một epoch, và tổng số bước cập nhật lên tới hàng chục nghìn hay hàng triệu.
7. Đào sâu
Gradient descent có lịch sử lâu hơn deep learning nhiều thập kỷ:
- A Stochastic Approximation Method, Robbins & Monro, 1951: bài báo gốc đề xuất cách tìm nghiệm của phương trình khi chỉ quan sát được giá trị nhiễu, và chứng minh chuỗi cập nhật vẫn hội tụ về nghiệm đúng. "Stochastic" ở đây chỉ quan sát bị nhiễu, không phải mini-batch. Nối sang SGD: gradient tính trên một batch ngẫu nhiên chính là ước lượng nhiễu của gradient thật trên toàn bộ dữ liệu.
Deep learning ghép gradient descent với backpropagation (Rumelhart, Hinton & Williams, 1986, Nature) để tính gradient hiệu quả trên mạng nhiều lớp; đó là nền của mọi framework train hiện đại như PyTorch và JAX.
8. Liên hệ các bài khác
- Bài 03: Loss: gradient descent lấy loss làm la bàn; không có loss thì không có gì để chỉnh theo.
- Bài 02: Xếp lớp và phi tuyến: sức chứa của mạng quyết định loss xuống thấp được tới đâu; thiếu sức chứa là một trong ba ca hỏng ở bài 07.
- Bài 05: Tham số và siêu tham số: learning rate là siêu tham số do người chọn; bài đó đi sâu sự phân biệt này.
- Bài 07: Mini-challenge: đọc đường cong loss: tự chẩn đoán ba ca huấn luyện hỏng từ đường cong.
9. Tóm tắt
- Tập 50.000 mẫu, batch 500 cho 100 bước cập nhật mỗi epoch.
- Loss tăng vọt hay ra
NaNlà dấu hiệu kinh điển của learning rate quá lớn. - Train không hội tụ thì cho model học thuộc một batch trước: không làm được là bug pipeline, chưa phải lỗi learning rate.
- Model nhỏ train hàng chục tới hàng trăm epoch; pretraining LLM thường chỉ khoảng một lượt dữ liệu.
10. Tự kiểm tra
- Q1Vì sao mỗi bước cập nhật trọng số chỉ dùng một batch nhỏ thay vì cả tập huấn luyện?
- Q2Gradient là gì? Vì sao cập nhật trọng số theo hướng ngược gradient (trừ đi) chứ không cộng vào?
- Q3Loss của một model đang train bỗng tăng vọt qua từng epoch, có lúc ra NaN. Thủ phạm nào đáng nghi nhất, và bạn thử gì để xác nhận?
- Q4Epoch khác batch ở đâu? Tập train 50.000 mẫu, batch_size 500 thì một epoch có bao nhiêu bước cập nhật?
- Q5Loss không giảm ngay từ đầu. Đồng nghiệp muốn dò ngay learning rate. Bạn đề xuất kiểm gì trước, và vì sao?
- Q6Train xong, model có tiếp tục chỉnh trọng số khi xử lý yêu cầu người dùng không? Forward pass trong inference làm gì?
Bài tiếp theo: Tham số và siêu tham số: 7 tỷ tham số nghĩa là gì
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Loss: gom cái sai của model về một con số duy nhất
Bài tiếpTham số và siêu tham số: 7 tỷ tham số nghĩa là gì
Thảo luận & góp ý
Hỏi đáp về bài này